Apuntes · Capítulo 15Producción y evolución
Seguridad, privacidad, ética y accesibilidad
Seguridad, privacidad, ética y accesibilidad
La semana pasada construyeron una funcionalidad con un modelo de lenguaje y aprendieron a tratar su salida como entrada no confiable: el modelo propone, el programa valida. Esta semana esa idea se generaliza. Todo lo que llega del navegador es entrada no confiable, y Kallpa lleva quince semanas confiando en ella.
Hasta ahora evaluamos el software por si hace lo que debe. Esta semana lo evaluamos por lo que permite hacer a quien no debería, y por lo que no le permite hacer a quien sí debería. Un vecino que cancela la reserva de otro. Una página que muestra el celular de todos. Una persona que no puede reservar porque no usa mouse. Ninguno de esos problemas aparece en una prueba que comprueba el camino feliz, y ninguno se arregla al final con un parche: se deciden al diseñar.
El capítulo tiene dos partes, como la semana. En la primera estudiamos la seguridad y la privacidad desde el diseño: el modelo de amenazas, el OWASP Top 10, la diferencia entre autenticación y autorización, el XSS, la inyección y la Ley 29733 de protección de datos personales. En la segunda estudiamos las decisiones que afectan a personas que no están en la sala: ética, accesibilidad con WCAG 2.2, licencias y procedencia del código generado. Todo se comprueba sobre Kallpa, con ataques reales contra una copia propia.
Lectura. Para la primera parte: OWASP, Top 10:2025 (y la página del proyecto); y la Ley N.° 29733, Ley de Protección de Datos Personales, el título preliminar y el título I (arts. 4 a 12). Para la segunda: W3C, Pautas de Accesibilidad para el Contenido Web (WCAG) y la referencia rápida de WCAG 2.2; y Software Engineering at Google (SWEG), cap. 4, Engineering for Equity. Complementarias: Reglamento de la Ley N.° 29733 (Decreto Supremo N.° 016-2024-JUS) y las normas de la Autoridad Nacional de Protección de Datos Personales; OWASP Cheat Sheet Series, Cross Site Scripting Prevention y Authorization; OWASP, Application Security Verification Standard (ASVS); W3C, WCAG 2.2 y Easy Checks: A First Review of Web Accessibility; WebAIM, Contrast Checker; choosealicense.com y su apéndice comparativo; y la lista de licencias SPDX. El código del capítulo está en
code/week-15y se prueba conmake testdentro del contenedor del curso.
Antes de empezar. Todo lo que sigue se prueba solo contra su propia copia de Kallpa o de su proyecto. Probar estos ataques contra un sistema que no es suyo, sin autorización escrita, no es un ejercicio: es un problema, aunque no toquen nada.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Seguridad desde el diseño, Lo que se protege y El modelo de amenazas; de OWASP Top 10:2025, Qué es y qué no es; de Autenticación y autorización, Dos preguntas distintas; de XSS: cuando el texto se vuelve código, Qué es y La corrección: codificar la salida; de Privacidad y la Ley 29733, El vocabulario y Los principios rectores; de Ética: quién queda afuera, Las decisiones que no parecen decisiones; de Accesibilidad, Por qué, y con qué norma; y de Licencias, Sin licencia, nadie puede.
- En clase: Sesión A: Seguridad desde el diseño, OWASP Top 10:2025, Autenticación y autorización, XSS: cuando el texto se vuelve código, Inyección SQL y análisis estático, Condiciones excepcionales: un pedido apaga el servidor y Privacidad y la Ley 29733. Sesión B: Ética: quién queda afuera, Accesibilidad, Licencias y, si hay tiempo, Procedencia del código generado. Laboratorio: El laboratorio y el código.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Un inicio de sesión no basta, Una segunda capa: Content Security Policy, El inventario de Kallpa, Cómo se evalúa, y el puntaje que engaña y las lecturas del recuadro Lectura.
Seguridad desde el diseño
Lo que se protege
La seguridad suele resumirse en tres propiedades. Conviene decirlas con precisión, porque cada una falla de otra manera.
- Confidencialidad: la información solo la conocen quienes deben conocerla. Falla cuando cualquiera puede leer el celular de un vecino.
- Integridad: la información solo la cambian quienes deben cambiarla, de la forma debida. Falla cuando cualquiera puede cancelar la reserva de otra persona.
- Disponibilidad: el sistema responde cuando se lo necesita. Falla cuando un solo pedido apaga el servidor, o cuando alguien ocupa todas las horas de una cancha.
No pesan lo mismo en todos los sistemas. En un sitio de noticias, la confidencialidad casi no importa y la integridad, muchísimo. En Kallpa, el celular de un vecino pide confidencialidad; la lista de reservas pide integridad; una tarde de sábado pide disponibilidad. Decidir cuál importa en cada dato ya es parte del diseño.
Idea clave. Estas propiedades se deciden al diseñar. “Quién puede cancelar una reserva” no es un detalle de implementación que se agrega al final: si el sistema no sabe quién está llamando, ninguna revisión de código lo va a arreglar. OWASP lo dice así: un diseño inseguro no se corrige con una implementación perfecta, porque el control necesario nunca se creó.
El modelo de amenazas
Un modelo de amenazas es un análisis escrito de qué puede salir mal en un sistema, hecho por quienes lo construyen. No hace falta una herramienta ni un experto. El Threat Modeling Manifesto y la página de OWASP lo reducen a cuatro preguntas:
- ¿Qué estamos construyendo?
- ¿Qué puede salir mal?
- ¿Qué vamos a hacer al respecto?
- ¿Lo hicimos bien?
Se hace temprano, y se actualiza cuando cambia algo importante: una funcionalidad nueva, un incidente, un cambio de arquitectura. El resultado no tiene que ser perfecto. Tiene que existir, para que se pueda discutir y corregir, como un design doc.
Vamos a responderlas para Kallpa. Es lo mismo que harán en el paso 1 del laboratorio.
¿Qué estamos construyendo?
Se responde con cuatro listas: qué se protege, quién interviene, por dónde se entra y dónde está la frontera.
Los activos son lo que tiene valor para alguien, y se escriben junto con la propiedad que más importa:
| Activo | Dónde vive | Propiedad que más importa |
|---|---|---|
| Datos de los vecinos: nombre, celular, plan | Tabla members |
Confidencialidad |
| Reservas: quién, cuándo, cuánto pagó | Tabla bookings |
Integridad y confidencialidad |
| La caja del día | GET /api/reports/daily |
Confidencialidad e integridad |
| El servicio funcionando | El proceso de Node | Disponibilidad |
Los actores son quienes tocan el sistema. Algunos con buena intención, otros no, y otros por accidente:
| Actor | Qué debería poder hacer |
|---|---|
| Vecino | Ver las horas libres, reservar y cancelar lo suyo |
| Administración | Registrar vecinos, ver la caja y todas las reservas |
| Cualquiera en internet | Lo mismo que cualquier persona que no se identificó: como mucho, ver las horas libres |
Los puntos de entrada son cada ruta de la API y la página. Aquí es donde aparece la primera sorpresa. Compárenlos con lo que hemos dicho de cada actor:
| Ruta | Devuelve o modifica | Quién debería poder | Quién puede hoy |
|---|---|---|---|
GET /api/courts |
Las canchas | Cualquiera | Cualquiera |
GET /api/courts/:id/availability |
Horas libres y nombres de equipos | Cualquiera, según lo que diga el cliente | Cualquiera |
GET /api/members |
Nombre, celular y plan de todos | Administración | Cualquiera |
GET /api/members/:id/bookings |
Las reservas de esa persona | Esa persona y administración | Cualquiera |
POST /api/bookings |
Crea una reserva a nombre de memberId |
El propio vecino | Cualquiera, a nombre de cualquiera |
POST /api/bookings/:id/cancel |
Cancela una reserva | Su owner y administración | Cualquiera |
GET /api/reports/daily |
Ingresos del día | Administración | Cualquiera |
La última columna tiene un solo valor. Kallpa no tiene ningún control de acceso.
La frontera de confianza es la línea donde cambia quién controla el dato. En Kallpa, pasa entre el navegador y el servidor:
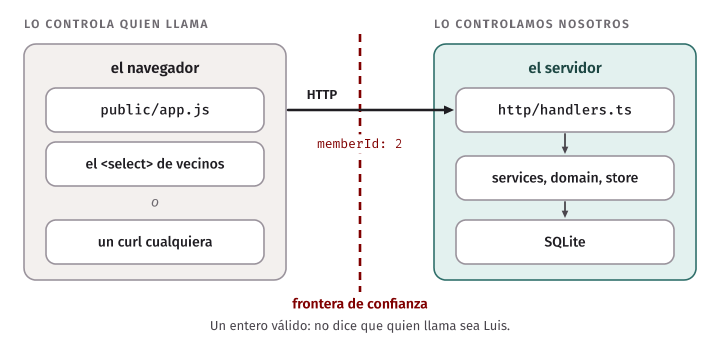
Del lado izquierdo, nada es confiable. Que public/app.js solo mande el
memberId del vecino elegido en el <select> no significa nada: nuestro
JavaScript corre en la computadora de quien llama, que puede cambiarlo, o no
usarlo y mandar el pedido con curl. Ya vieron en la semana 11
la misma idea para los tipos: lo que llega de afuera es unknown hasta que se
revisa. Aquí agregamos algo que los tipos no alcanzan a ver: un dato puede
tener la forma correcta y ser mentira. memberId: 2 es un entero válido. No
dice que quien llama sea Luis.
¿Qué puede salir mal?
La pregunta es más útil cuando se hace por cada entrada: ¿qué pasa si quien
llama miente? Para POST /api/bookings: ¿y si manda el memberId de otro?
¿Y si el nombre del equipo es HTML? ¿Y si manda mil pedidos? Para cancel: ¿y
si el número no es de una reserva suya?
Para no olvidar categorías, se usa una lista como ayuda de memoria. La más conocida es STRIDE, de Microsoft: hacerse pasar por otro (Spoofing), alterar datos (Tampering), negar haber hecho algo (Repudiation), revelar información (Information disclosure), dejar el servicio sin atender (Denial of service) y obtener más permisos (Elevation of privilege). No es una clasificación que haya que llenar; es una forma de no quedarse solo con lo primero que se ocurre.
¿Qué vamos a hacer, y lo hicimos bien?
Cada amenaza tiene cuatro respuestas posibles: corregirla, reducirla, aceptarla con una razón escrita o eliminarla quitando lo que la permite. La última se olvida con frecuencia, y a menudo es la mejor: un dato que no se guarda no se puede filtrar.
La cuarta pregunta se responde con evidencia: una prueba, un curl que antes
devolvía 200 y ahora devuelve 403, una auditoría. Un modelo de amenazas sin
esa comprobación es una lista de buenas intenciones. Por eso el template del
laboratorio pide el comando exacto y la respuesta real.
En la industria. El Threat Modeling Manifesto, escrito por gente que lo practica, lo plantea como un análisis para encontrar problemas de seguridad y privacidad al inicio o durante toda la vida del sistema, no como un trámite antes de salir. Una forma barata de empezar en su proyecto es agregar al design doc de P2, que no lo pedía, una sección con esas cuatro preguntas.
OWASP Top 10:2025
Qué es y qué no es
OWASP es una fundación sin fines de lucro que publica material abierto de seguridad de aplicaciones. Su Top 10 se define a sí mismo como un standard awareness document: un documento para crear conciencia entre quienes desarrollan, que representa un consenso amplio sobre los riesgos más críticos de las aplicaciones web.
Dos cosas se deducen de eso:
- No es un estándar de verificación. Pasar “las diez” no significa que la aplicación sea segura. Para verificar con requisitos concretos existe ASVS, que da una base para probar controles técnicos y una lista de requisitos para desarrollar. Es una lista mucho más larga, con niveles según lo que la aplicación protege.
- No es un ranking puramente estadístico. La edición 2025 lo dice: es informada por datos, pero no ciegamente guiada por ellos. Ordenaron 12 categorías con los datos aportados, y permitieron que dos se promovieran por las respuestas de una encuesta a la comunidad, porque esos datos miran al pasado: pueden pasar años hasta que una debilidad se pueda probar a escala, y algunas quizá nunca aparezcan en ellos.
Vale la pena mirar con cuidado los números. La página de A01 dice que el 100 % de las aplicaciones probadas tuvo alguna forma de control de acceso roto, y su tabla da una tasa de incidencia promedio de 3.74 % y una máxima de 20.15 %; la introducción dice que, en promedio, 3.73 % de las aplicaciones probadas tuvo una o más de las 40 debilidades (CWE) de la categoría. Esas páginas no explican cómo se relacionan esas cifras, así que no saquen conclusiones de una sola. Lo que sí queda claro es que ninguna es “el porcentaje de aplicaciones en el mundo con este problema”: salen de los datos que aportaron quienes prueban, con sus propias herramientas y sus propias muestras. Sirven para ordenar la atención, no para estimar su riesgo.
Las diez, aplicadas a Kallpa
Esta es la lista de 2025, con lo que encontramos en la Kallpa publicada. Usa el mismo formato que pide docs/seguridad.md de
P5: lo que se miró, el estado y la
evidencia.
| Categoría | Qué miramos en Kallpa | Estado | Evidencia |
|---|---|---|---|
| A01 Broken Access Control | Quién puede leer y cambiar qué | No cumple | Ninguna ruta revisa quién llama; más abajo |
| A02 Security Misconfiguration | Cabeceras, mensajes de error | Parcial | Sin cabeceras de seguridad; los errores no revelan detalles (INTERNAL_ERROR) |
| A03 Software Supply Chain Failures | Dependencias | Parcial | Sin dependencias de producción; las herramientas vienen en la imagen del curso, sin lockfile ni revisión de vulnerabilidades hasta la semana 12 |
| A04 Cryptographic Failures | Datos en tránsito y en reposo | Parcial | Sin TLS en el servidor: depende del despliegue (semana 13); el celular está en claro en SQLite |
| A05 Injection | SQL y HTML con texto del usuario | Parcial | SQL con parámetros; XSS almacenado en el nombre del equipo |
| A06 Insecure Design | Si existen los controles necesarios | No cumple | La identidad se elige de un <select>; nada limita cuánto reserva alguien |
| A07 Authentication Failures | Cómo se identifica a las personas | No cumple | No hay autenticación |
| A08 Software or Data Integrity Failures | Código de terceros en la página; el pipeline | Parcial | Sin scripts de CDN: app.js sale del propio servidor. El pipeline no existe hasta la semana 12: hay que revisarlo cuando llegue |
| A09 Security Logging and Alerting Failures | Qué registra, qué avisa | No cumple | Sin alertas; el log guarda el celular y el mensaje completo |
| A10 Mishandling of Exceptional Conditions | Qué pasa con lo inesperado | No cumple | Un solo pedido apaga el servidor |
Las categorías se solapan, y OWASP lo admite: es básicamente imposible crear diez sin algo de solapamiento. Que cualquiera pueda cancelar una reserva es A01 por su efecto, A06 porque el control nunca se diseñó, y A07 porque nadie se identificó. Regístrenlo donde ayude más a corregirlo, y no pierdan tiempo discutiendo la categoría exacta.
Qué cambió en 2025
Hay dos categorías nuevas y una consolidación, según la introducción de OWASP:
- A03 Software Supply Chain Failures. Es una expansión de A06:2021 (Vulnerable and Outdated Components): ya no son solo versiones con vulnerabilidades conocidas, sino también lo que puede fallar al construir, distribuir o actualizar el software. Lo vieron en la semana 12. Tiene pocos datos, porque es difícil de probar, y llegó al tercer lugar sobre todo por la encuesta.
- A10 Mishandling of Exceptional Conditions. Totalmente nueva: errores mal manejados, sistemas que fallan abiertos, excepciones que nadie atrapó. Antes muchos de estos casos estaban bajo “código de mala calidad”.
- La consolidación: Server-Side Request Forgery (SSRF) pasa a formar parte de A01.
A01 sigue primero. Inyección bajó al quinto lugar, y el XSS está dentro de Inyección: es la misma idea de mandar datos a un intérprete, solo que el intérprete es el navegador.
Error común. “Nadie va a encontrar esa ruta.” La página de Kallpa no tiene ningún enlace a
/api/reports/daily, y la caja del día sigue siendo pública: cualquiera la llama concurl, y las rutas de una API se leen en el JavaScript de la página, en la pestaña Network o se adivinan. Una ruta sin enlaces es tan pública como la página, y lo que una respuesta devuelve es lo que se publica, aunque la pantalla no lo muestre.
Autenticación y autorización
Dos preguntas distintas
- Autenticación: ¿quién eres? Comprobar la identidad de quien llama, con una contraseña, un enlace por correo o un token.
- Autorización: ¿qué puedes hacer? Decidir, sabiendo quién llama, si puede hacer esta acción sobre este dato.
La primera es un evento (se inicia sesión). La segunda ocurre en cada solicitud. Se confunden porque suelen aparecer juntas, y confundirlas es la causa de una de las fallas más comunes: creer que, como hay inicio de sesión, los datos están protegidos.
El control de acceso roto de Kallpa
Control de acceso roto es que alguien actúe fuera de sus permisos. En
Kallpa basta un curl. Estas salidas son de una corrida real en el contenedor
del curso, con make seed y D=2026-11-04. Primero, la lista de vecinos:
$ curl -s localhost:3000/api/members | jq -c '.members[:2]'
[{"id":3,"name":"Carmen Flores Rojas","phone":"945112233","plan":"regular"},{"id":10,"name":"Diego Ramírez Soto","phone":"991234567","plan":"socio"}]
La ruta existe para llenar un <select>, que solo usa el id y el name. La
respuesta trae además el celular y el plan de las diez personas: la pantalla
no los muestra, pero el navegador ya los recibió. Ahora las reservas de otra
persona, con el historial de dónde estuvo y cuánto pagó:
$ curl -s localhost:3000/api/members/1/bookings | jq -c '.[0]'
{"id":1,"courtId":1,"memberId":1,"date":"2026-10-30","startHour":19,"hours":2,"teamName":"Los Pumas de Comas","priceCents":22500,"status":"confirmed","createdAt":"2026-10-29T14:00:00.000Z","cancelledAt":null}
Después, reservamos a nombre de Luis, que es socio, y cancelamos con solo el número:
$ curl -s -X POST localhost:3000/api/bookings -H 'content-type: application/json' -d '{"courtId":1,"memberId":2,"date":"2026-11-04","startHour":8,"teamName":"Prueba"}' | jq -c .
{"booking":{"id":16,"courtId":1,"memberId":2,"date":"2026-11-04","startHour":8,"hours":1,"teamName":"Prueba","priceCents":8100,"status":"confirmed","createdAt":"2026-11-02T06:07:26.669Z","cancelledAt":null}}

$ curl -s -X POST localhost:3000/api/bookings/16/cancel | jq -c .
{"booking":{"id":16,"courtId":1,"memberId":2,"date":"2026-11-04","startHour":8,"hours":1,"teamName":"Prueba","priceCents":8100,"status":"cancelled","createdAt":"2026-11-02T06:07:26.669Z","cancelledAt":"2026-11-02T06:07:26.678Z"}}
Cada línea tiene su propio daño. Los S/ 81.00 son los S/ 90 de la hora con el 10 % de descuento de Luis: cualquiera se lleva el descuento de un socio cambiando un número. Además, en la consola del servidor quedó escrito el aviso a su celular, así que Luis recibiría un mensaje por una reserva que no hizo:
[whatsapp] para 912345678: Hola Luis Huamán Torres, tu reserva de Fulbito 1 el 2026-11-04 de 8:00 a 9:00 está confirmada. Total: S/ 81.00.Y la cancelación tiene otro problema: id es un entero correlativo. Una
reserva tiene el 16, la siguiente tiene el 17. Basta sumar uno para llegar a
lo de otra persona. A esto se le llama IDOR (insecure direct object
reference): el servidor recibe el identificador de un objeto y actúa sobre él
sin comprobar si quien llama tiene derecho.
La caja del día tampoco pide nada:
$ curl -s "localhost:3000/api/reports/daily?date=$D" | jq -c '{date,bookings,revenueCents}'
{"date":"2026-11-04","bookings":2,"revenueCents":22125}
Y la disponibilidad se cae por otro lado. Reservar quince horas seguidas de una misma cancha, una por una, funciona sin ningún límite:
$ for h in 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21; do curl -s -o /dev/null -w '%{http_code} ' -X POST localhost:3000/api/bookings -H 'content-type: application/json' -d "{\"courtId\":3,\"memberId\":1,\"date\":\"$D\",\"startHour\":$h,\"teamName\":\"Nadie\"}"; done
200 200 200 200 200 200 200 200 200 200 200 200 200 200 200
Después de eso, la cancha no tiene ninguna hora libre ese día, y el “owner” es quien el atacante haya querido.
Error común. “Usemos UUID en vez de números y listo.” Identificadores difíciles de adivinar ayudan, y el cheat sheet de IDOR de OWASP los recomienda como defensa adicional, porque quitan la enumeración fácil. Pero no autorizan nada: un identificador se filtra en un log, un enlace o una captura de pantalla, y el problema vuelve entero. Lo que cierra el IDOR es comprobar en el servidor, en cada solicitud, si quien llama es el owner.
Un inicio de sesión no basta
La primera idea para arreglar esto es agregar un inicio de sesión. Es
necesario, y no es suficiente. Para verlo sin reescribir Kallpa,
ejemplos/acceso.ts pone un servidor delante de sus rutas, con dos modos: uno
que solo autentica y otro que además autoriza. Los tokens son fijos porque es
un ejemplo; un inicio de sesión de verdad emite uno aleatorio al comprobar la
identidad.
Con solo autenticación, cada solicitud tiene que traer un token válido, y
el servidor sabe perfectamente quién llama. Pero no usa ese dato para nada
más. Esto prueba acceso.test.ts:
$ node --test acceso.test.ts
▶ solo autenticación: hay sesión, pero el problema sigue
  ✔ sin token, 401 (13.934209ms)
  ✔ con la sesión de Rosa se cancela una reserva de Luis (7.375875ms)
  ✔ con la sesión de Rosa se reserva a nombre de Luis y se usa su descuento (4.280667ms)
  ✔ con la sesión de Rosa se leen los celulares de todos (2.622208ms)
✔ solo autenticación: hay sesión, pero el problema sigue (32.991708ms)
Hay un candado en la puerta, y una vez adentro cada vecino puede abrir todos los casilleros. Lo único que cambió es que ahora el atacante tiene que registrarse antes.
La autorización es la decisión de cada solicitud. En el ejemplo es una función pura:
export function isAllowed(session: Session, method: string, path: string, ownerOf: BookingOwner): boolean {
  const parts = path.split('/').filter(Boolean);
  const route = `${method} /${parts.join('/')}`;
  if (session.role === 'administracion') return true;
  if (route === 'GET /api/courts') return true;
  if (method === 'GET' && /^\/api\/courts\/\d+\/availability$/.test(path)) return true;
  if (route === 'POST /api/bookings') return true;
  if (method === 'GET' && /^\/api\/members\/\d+\/bookings$/.test(path)) {
    return Number(parts[2]) === session.memberId;
  }
  if (method === 'POST' && /^\/api\/bookings\/\d+\/cancel$/.test(path)) {
    return ownerOf(Number(parts[2])) === session.memberId;
  }
  return false;
}
Fíjense en tres decisiones de este código:
- La última línea niega. Lo que no está en la lista no se permite, también las rutas que alguien agregue mañana y olvide proteger. Es la negación por defecto, y es la diferencia entre un olvido que deja una ruta sin servicio (se nota en minutos) y uno que deja una ruta abierta (se nota cuando ya es tarde).
- El owner lo dice la base de datos.
ownerOfbusca la reserva y compara. Una reserva que no existe no tiene owner, así que se niega. - La identidad sale de la sesión. En
POST /api/bookings, el servidor reemplazamemberIdpor el de la sesión antes de llamar a Kallpa. El campo del cuerpo deja de importar: no es que se valide, es que no se le cree.
▶ autenticación y autorización
  ✔ Rosa no cancela la reserva de Luis; Luis sí (6.712292ms)
  ✔ el memberId que manda el navegador no cuenta: la reserva queda a nombre de la sesión (1.741667ms)
  ✔ Rosa ve sus reservas, no las de Luis (1.405625ms)
  ✔ la lista de vecinos y la caja del día, solo para la administración (1.661041ms)
✔ autenticación y autorización (12.562333ms)
▶ isAllowed niega por defecto
  ✔ una ruta que nadie listó se niega (0.096375ms)
  ✔ una reserva que no existe no tiene owner: se niega (0.103167ms)
✔ isAllowed niega por defecto (0.290958ms)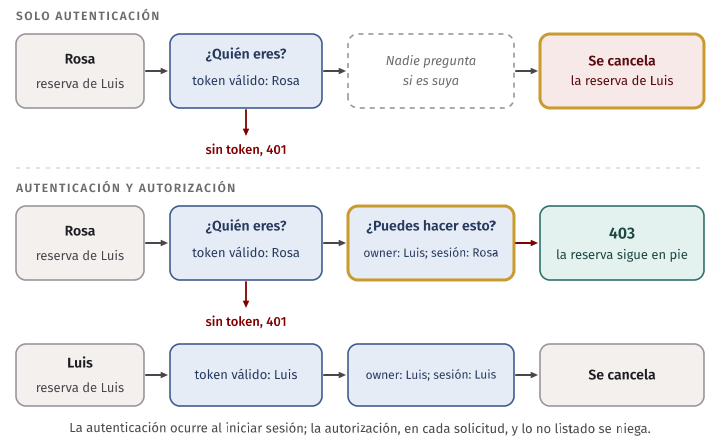
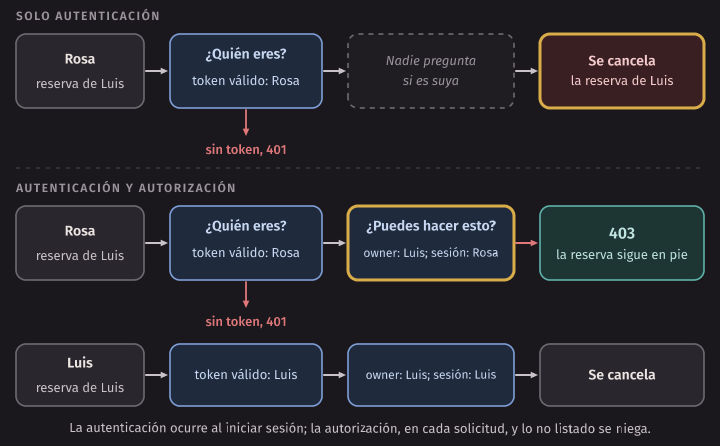
Idea clave. Cada solicitud se autoriza en el servidor, contra la identidad de la sesión, y por defecto se niega. Ocultar un botón en la página no es autorización: es comodidad para quien usa la página de buena fe. Y que una prueba de autorización solo compruebe el camino permitido no prueba nada: hay que escribir la que comprueba que Rosa recibe 403.
El Authorization Cheat Sheet de OWASP tiene estas mismas recomendaciones: negar por defecto y validar los permisos en cada solicitud. Dos detalles que conviene tener presentes cuando lo implementen en su proyecto:
- 401 o 403. 401 significa “no sé quién eres”; 403, “sé quién eres, y no puedes”. Con identificadores correlativos, responder 403 a lo ajeno y 404 a lo inexistente le dice al atacante qué existe. Si eso importa, se responde 404 a ambos. Es una decisión, y se escribe.
- CSRF (cross-site request forgery). OWASP lo incluye en A01. Si su sesión va en una cookie, el navegador la manda sola, y otra página puede hacer que el navegador de la víctima envíe un pedido. Hoy Kallpa no tiene cookies, así que no aplica; en cuanto agreguen una, sí. Lean el cheat sheet de CSRF de OWASP antes de inventar algo.
Y no escriban su propio sistema de contraseñas si pueden evitarlo. A07 existe porque es muy fácil equivocarse: guardar contraseñas sin un hash adecuado, permitir intentos sin límite, recuperar la cuenta con una pregunta que cualquiera puede responder.
XSS: cuando el texto se vuelve código
Qué es
XSS (cross-site scripting) es que un texto controlado por una persona termine interpretado como HTML o JavaScript en la página de otra. Corre con los permisos de esa página: puede leer lo que la página ve, y hacer pedidos como si fuera esa persona.
Hay tres formas, según por dónde viaja el texto:
- Almacenado: se guarda en el servidor y se muestra a quien abra la página.
- Reflejado: vuelve en la misma respuesta, como un parámetro de la URL que aparece en la página. El atacante necesita que la víctima abra un enlace preparado.
- Basado en el DOM: todo pasa en el navegador: un script toma texto de la URL y lo mete en la página, sin que el servidor intervenga.
El mecanismo es uno solo: un dato cruza al lado del código. En un intérprete que mezcla instrucciones y datos, todo depende de quién marca dónde termina uno y empieza el otro. Lo mismo vale para SQL, para un shell y, como vieron la semana pasada, para un prompt.
Cómo llega a Kallpa
En Kallpa, el nombre del equipo lo escribe quien reserva, y la página lo muestra a todos. Este es el camino completo, y conviene seguirlo paso a paso:
- Alguien reserva con
<img src=x onerror=alert(1)>como nombre del equipo. parseBookingRequestcomprueba que sea un texto de hasta 40 caracteres. Lo es (tiene 28), así que el servidor lo guarda tal cual.- Otra persona abre la disponibilidad de esa cancha ese día.
GET /api/courts/3/availabilitydevuelve el texto en JSON, correctamente. public/app.jsarma HTML pegando ese texto y lo asigna ainnerHTML.- El navegador lo interpreta como HTML. Crea una imagen, falla al cargar
xy corre el atributoonerror. El código de quien reservó está corriendo en la computadora de quien miró la página.
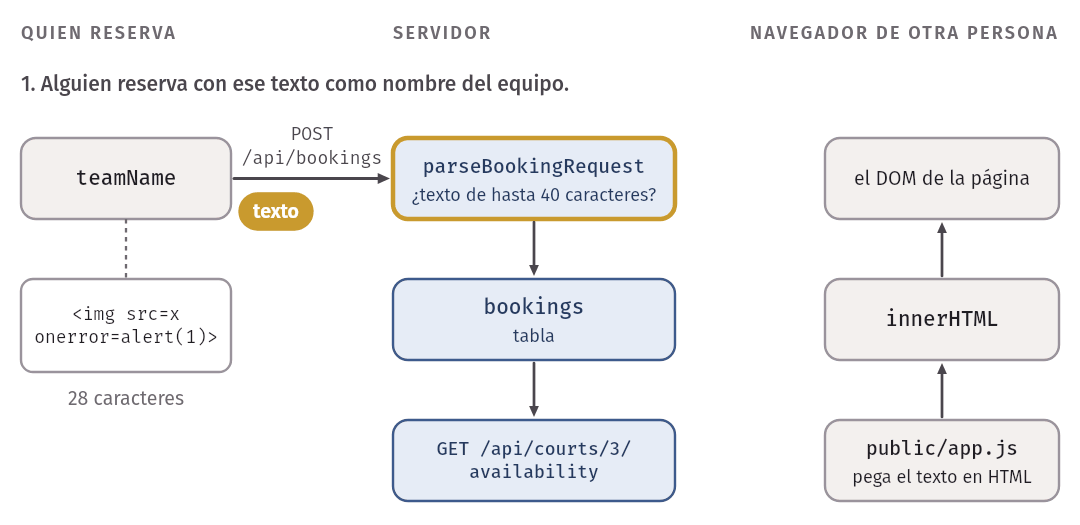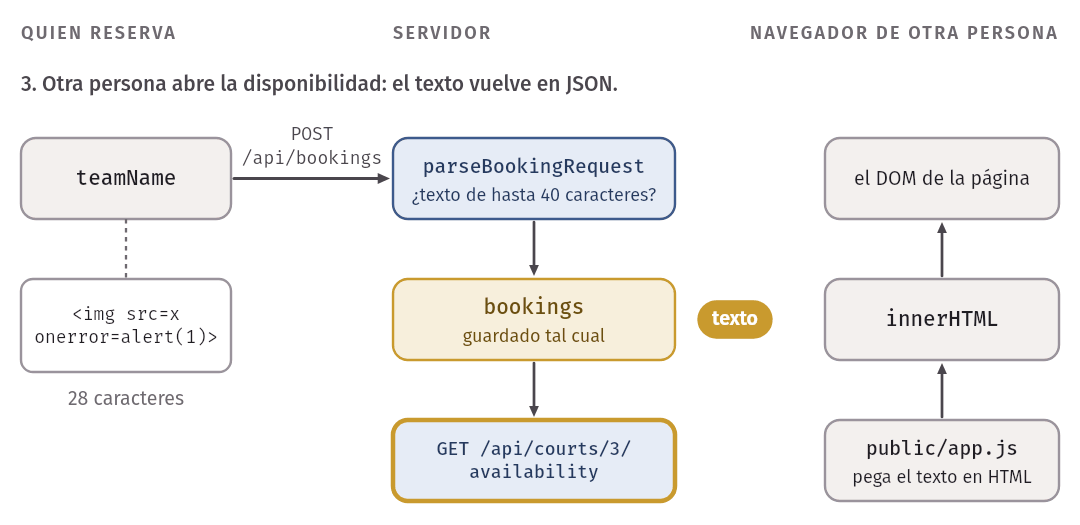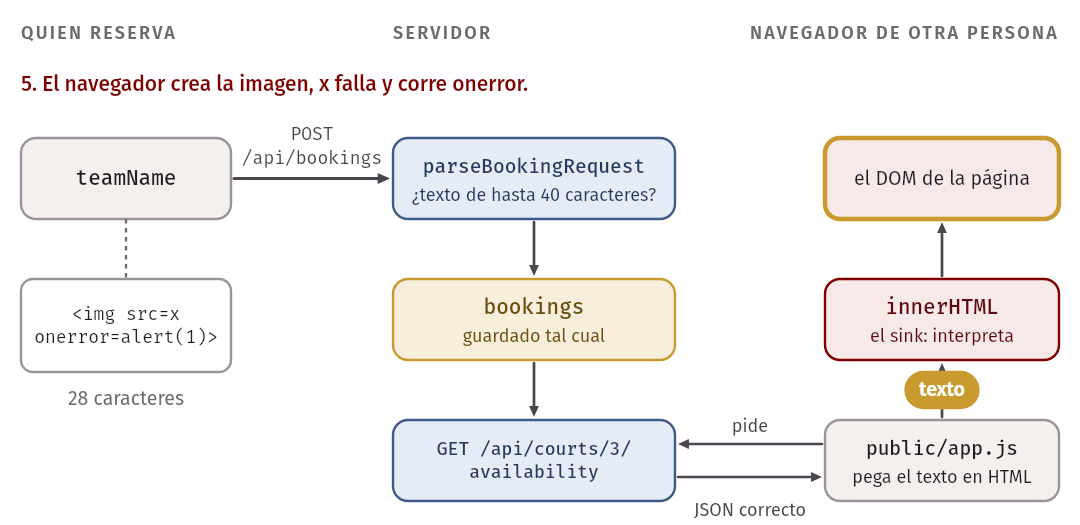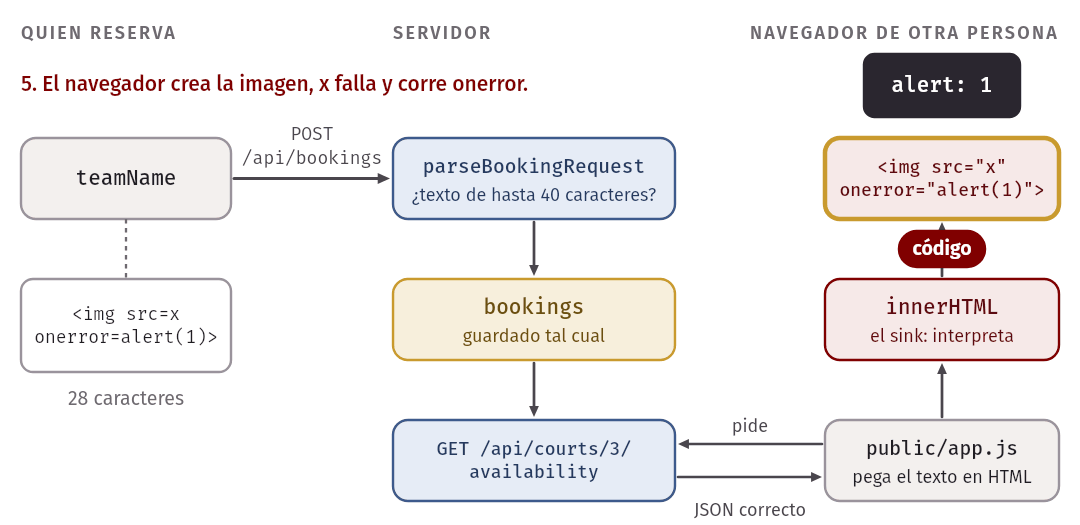
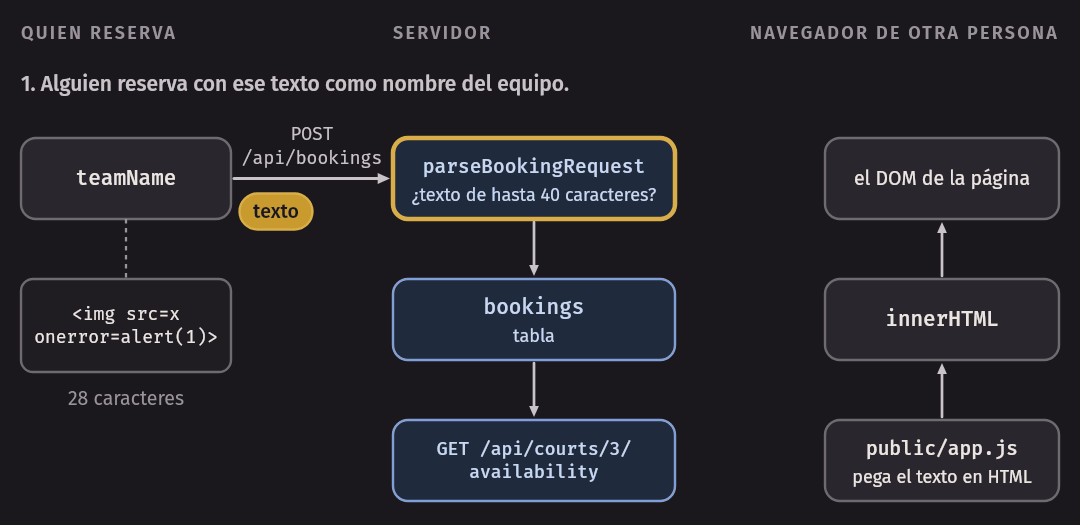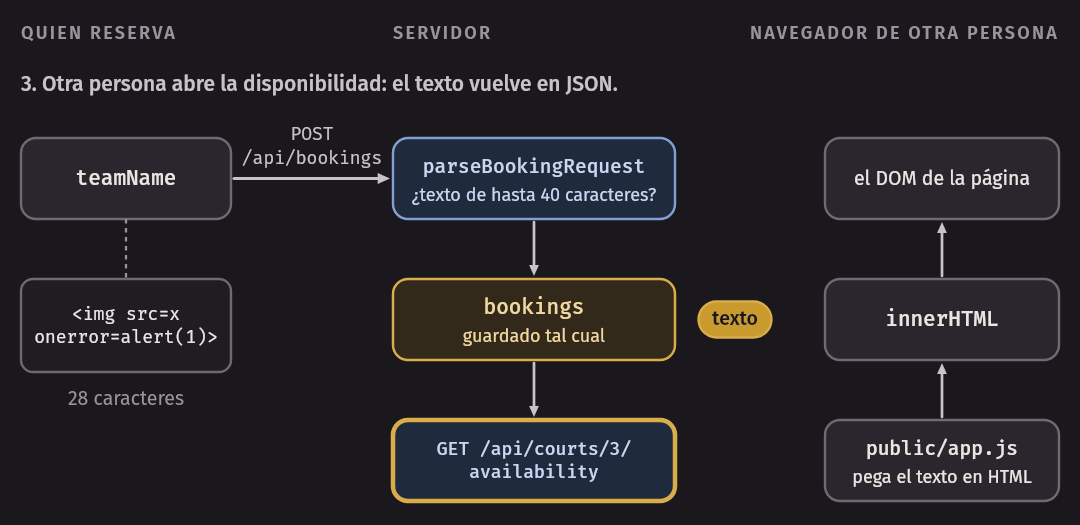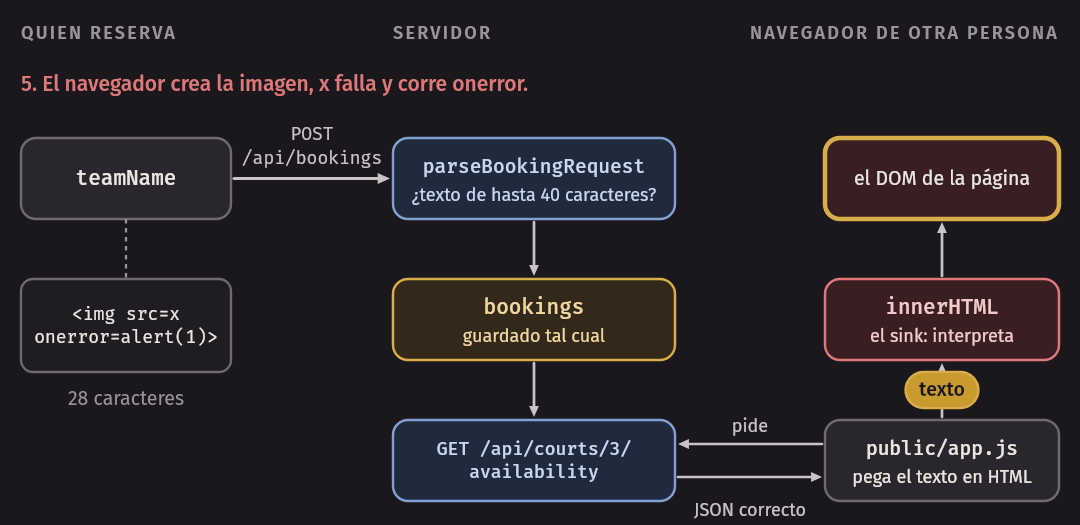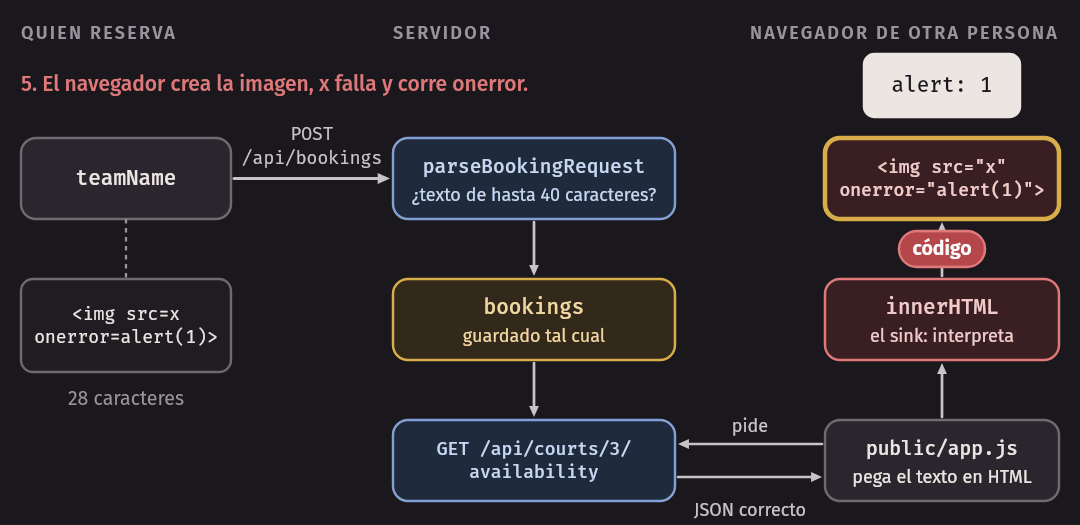
La corrida real, en el contenedor:
$ curl -s -X POST localhost:3000/api/bookings -H 'content-type: application/json' -d '{"courtId":3,"memberId":1,"date":"2026-11-04","startHour":8,"teamName":"<img src=x onerror=alert(1)>"}' | jq -c .
{"booking":{"id":17,"courtId":3,"memberId":1,"date":"2026-11-04","startHour":8,"hours":1,"teamName":"<img src=x onerror=alert(1)>","priceCents":5000,"status":"confirmed","createdAt":"2026-11-02T06:07:26.685Z","cancelledAt":null}}

$ curl -s "localhost:3000/api/courts/3/availability?date=2026-11-04" | jq -c '.slots[:2]'
[{"hour":7,"available":true},{"hour":8,"available":false,"teamName":"<img src=x onerror=alert(1)>"}]
Y el código de la página, donde el texto pasa a ser HTML:
slotsBox.innerHTML = slots
  .map((slot) =>
    slot.available
      ? `<div class="slot free" data-hour="${slot.hour}">${slot.hour}:00</div>`
      : `<div class="slot taken">${slot.hour}:00<small>${slot.teamName}</small></div>`,
  )
  .join('');
Lo comprobamos abriendo la página en Chrome 156 (en una computadora con macOS,
con el servidor en el contenedor del curso), con tres reservas de la misma
cancha y el mismo día (es otra corrida: ahora el <img> está a las 9:00). Esto es lo que quedó
en el DOM:
<div class="slot taken">8:00<small><b>prueba</b></small></div>
<div class="slot taken">9:00<small><img src="x" onerror="alert(1)"></small></div>
<div class="slot taken">10:00<small><script>alert(2)</script></small></div>
Y un solo cuadro de alert, con el 1. Las tres filas enseñan algo:
<b>prueba</b>se ve en negrita. Es la prueba inofensiva: si el nombre aparece en negrita en vez de mostrar los signos, el texto se está interpretando.<img ... onerror>se ejecutó.<script>no se ejecutó. Los navegadores no corren un<script>insertado coninnerHTML(lo explica la página de MDN, en Security considerations). Es lo primero que la gente prueba y, al no ver nada, concluye que la página es segura. No lo es: el atributoonerrory muchos otros sí corren.
Error común. Confiar en el límite de 40 caracteres. Hay espacio de sobra: la carga de arriba usa 28, y un atacante no necesita que todo el código quepa, porque puede usar esos caracteres para traer el resto de otro lugar. Un límite de longitud es una regla del negocio, no una defensa.
En la consola del navegador van a ver dos errores 404 al hacer esta prueba.
No son parte del ataque ni los causa una política de seguridad: uno es /x,
la imagen que el ataque pide a propósito, y otro es /favicon.ico, que Kallpa
no tiene. Una violación de CSP se ve distinta, como veremos abajo.
Qué puede hacer de verdad
alert(1) es solo una prueba de que el código corre. Con el mismo acceso, ese
código puede llamar a /api/members, tomar los celulares y mandarlos a otro
servidor. Hoy, en Kallpa, eso casi no agrega daño, porque esa ruta ya es
pública. Pero el día que Kallpa tenga sesiones, el código correría con la
sesión de quien miró la página: podría cancelar sus reservas y ver sus datos
sin que se dé cuenta. También puede cambiar la página para pedir una
contraseña o un pago por Yape. Por eso, al agregar un inicio de sesión, un XSS
que hoy parece menor se vuelve mucho más grave.
Además, no es un solo lugar. El nombre del equipo también aparece en “Mis
reservas”, y una regla de eslint.sinks.js (de análisis estático, de la
semana 11) encuentra todos los lugares donde se asigna HTML. A
estos lugares se les llama sinks: donde un dato termina interpretado.
$ make sinks

/work/code/week-15/build/kallpa/public/app.js
  36:3  error  innerHTML interpreta HTML: de dónde viene el texto?  no-restricted-syntax
  41:3  error  innerHTML interpreta HTML: de dónde viene el texto?  no-restricted-syntax
  47:3  error  innerHTML interpreta HTML: de dónde viene el texto?  no-restricted-syntax
  58:3  error  innerHTML interpreta HTML: de dónde viene el texto?  no-restricted-syntax

/work/code/week-15/build/kallpa/src/seed.ts
  18:46  error  SQL armado con un template: de dónde viene cada ${...}?  no-restricted-syntax

/work/code/week-15/build/kallpa/src/store/database.ts
  54:15  error  SQL armado con un template: de dónde viene cada ${...}?  no-restricted-syntax

✖ 6 problems (6 errors, 0 warnings)
Cuatro innerHTML, y cuidado con el juicio sobre cada uno. Las líneas 47
(disponibilidad) y 58 (Mis reservas) reciben el nombre del equipo: los escribe
cualquiera. Las líneas 36 y 41 reciben nombres de canchas y de vecinos, que
hoy solo escribe la administración: son menos urgentes, pero el mismo código
tampoco resistiría a un administrador con una cuenta robada. Y, como revisar
cuatro es lo mismo que cambiar cuatro, lo razonable es no dejar ninguno. Una
corrección que solo cubra la disponibilidad deja el ataque vivo en “Mis
reservas”.
La corrección: codificar la salida
La defensa principal no es filtrar la entrada. Es codificar la salida según
el contexto donde se pone. El cheat sheet de
OWASP
lo dice de forma concreta para JavaScript: al mostrar texto, asígnenlo a
textContent, que crea un nodo de texto sin interpretar HTML, y traten de
quitar innerHTML. Para la disponibilidad, queda así:
// Crea un elemento con su texto. textContent nunca interpreta HTML.
function element(tag, className, text) {
  const node = document.createElement(tag);
  if (className) node.className = className;
  if (text !== undefined) node.textContent = text;
  return node;
}

function slotElement(slot) {
  const label = `${slot.hour}:00`;
  if (slot.available) {
    const free = element('div', 'slot free', label);
    free.dataset.hour = slot.hour;
    return free;
  }
  const taken = element('div', 'slot taken', label);
  taken.append(element('small', '', slot.teamName));
  return taken;
}

slotsBox.replaceChildren(...slots.map(slotElement));
Faltan los otros tres innerHTML: ese es parte del laboratorio. Con todos
corregidos, el DOM real de las mismas tres reservas tiene los signos
codificados y no hay ningún cuadro de alert:
<div class="slot taken">8:00<small><b>prueba</b></small></div>
<div class="slot taken">9:00<small><img src=x onerror=alert(1)></small></div>
<div class="slot taken">10:00<small><script>alert(2)</script></small></div>¿Por qué funciona? innerHTML le da al navegador un texto y le pide que lo
interprete. textContent le dice que es texto, punto. No hay nada que escapar
porque no hay interpretación: el navegador nunca llega a preguntarse si <img
es una etiqueta.
Fíjense en lo que no se corrigió: el servidor sigue guardando <img src=x onerror=alert(1)>. Está bien. El nombre “Los Pumas <3” o “O’Higgins” son
legítimos, y además el servidor no puede saber en qué contexto se va a mostrar
cada dato: en HTML, en una URL, en un CSV, en un mensaje de WhatsApp. Cada
contexto tiene sus caracteres peligrosos, por eso la codificación se hace al
mostrar.
Error común. Filtrar la entrada buscando
<script>, o reemplazar<a mano. Los filtros por lista negra se saltan: ya vimos que<script>ni siquiera era el problema, y hay muchísimas otras formas. Validar la entrada está bien, y sirve para rechazar lo que no tiene sentido en el negocio (más de 40 caracteres). Pero no es la defensa contra XSS.
Una vez corregido, tienen que dejarlo probado. Esta prueba no se puede hacer
con node --test sin un navegador, y está bien: el laboratorio acepta un
procedimiento manual escrito, con los pasos exactos para que otra persona lo
repita.
Una segunda capa: Content Security Policy
Una Content Security Policy (CSP) es una cabecera con la que el servidor
le dice al navegador de dónde puede cargar cada cosa. Si no permite scripts en
línea, los atributos como onerror no corren, aunque el HTML llegue a la
página.
Kallpa no manda ninguna cabecera de seguridad:
$ curl -s -D - -o /dev/null localhost:3000/
HTTP/1.1 200 OK
content-type: text/html; charset=utf-8
content-length: 1254
Date: Mon, 02 Nov 2026 06:07:26 GMT
Connection: keep-alive
Keep-Alive: timeout=5
La página solo usa recursos propios, en archivos separados, sin scripts en línea. Eso la deja en una situación ideal para una política estricta. El HTTP Headers Cheat Sheet da las recomendaciones; para esta página, algo así funciona:
Content-Security-Policy: default-src 'none'; script-src 'self'; style-src 'self'; connect-src 'self'; img-src 'self'; base-uri 'none'; form-action 'none'; frame-ancestors 'none'
X-Content-Type-Options: nosniff
Referrer-Policy: no-referrer
Lo probamos sin corregir el innerHTML, solo con la cabecera. El alert
ya no aparece, y la consola de Chrome avisa:
Executing inline event handler violates the following Content Security Policy directive 'script-src 'self''. Either the 'unsafe-inline' keyword, a hash ('sha256-...'), or a nonce ('nonce-...') is required to enable inline execution. [...]Pero miren el DOM en esa misma prueba: <b>prueba</b> se sigue viendo en
negrita, y la etiqueta <img> sigue en la página. La CSP detuvo el script,
no la inyección. Un atacante todavía puede cambiar lo que se ve: agregar un
aviso falso, un enlace, un formulario. Por eso es una segunda capa, no un
reemplazo. Además, las políticas tienden a aflojarse con el tiempo: basta un
'unsafe-inline' que alguien agregó para que funcione una biblioteca, y la
capa desaparece sin que nadie lo note.
Y una política se prueba en el navegador, no solo con curl. Una CSP
demasiado estricta rompe la página en silencio: la consola es la que dice qué
se bloqueó.
Idea clave. Un XSS se corrige en el sink: donde el dato se vuelve HTML. La CSP limita el daño de los que se le escapen a uno. Con solo la CSP, el HTML sigue entrando; con solo la corrección, un descuido futuro corre sin freno. Se usan las dos.
¿Hay XSS reflejado en Kallpa?
Una auditoría también dice lo que no encontró, y por qué. La ruta 404 de Kallpa repite en su mensaje lo que recibió, que es el patrón típico de un XSS reflejado:
$ curl -s -i -g 'localhost:3000/%3Cimg%20src=x%20onerror=alert(1)%3E'
HTTP/1.1 404 Not Found
content-type: application/json; charset=utf-8
...
{"error":{"code":"NOT_FOUND","message":"No existe la ruta /%3Cimg%20src=x%20onerror=alert(1)%3E."}}
Se salva por dos razones: la respuesta declara application/json, así que el
navegador no la interpreta como HTML, y en la página los mensajes de error
pasan por showMessage, que usa textContent. El mismo mensaje en una
respuesta text/html sería otra historia. Por eso importa también
X-Content-Type-Options: nosniff: le pide al navegador que respete el tipo
declarado en vez de adivinarlo.
Inyección SQL y análisis estático
La inyección SQL es el mismo problema con otro intérprete: texto del usuario pegado dentro de una consulta. En la semana 11 vieron un caso con un cambio escrito para la clase, y la regla no cambia: sentencias preparadas con parámetros, siempre. El parámetro viaja aparte de la consulta, así que nunca se interpreta como SQL.
Kallpa lo hace bien, y se puede comprobar. Reservamos con un nombre que sería desastroso si se pegara en una consulta, y después pedimos los datos:
$ curl -s -X POST localhost:3000/api/bookings -H 'content-type: application/json' -d '{"courtId":1,"memberId":1,"date":"2026-11-04","startHour":9,"teamName":"x'\'' OR 1=1; DROP TABLE bookings; --"}' | jq -c .booking.teamName
"x' OR 1=1; DROP TABLE bookings; --"

$ curl -s localhost:3000/api/courts | jq -c '.courts|length'
4
El nombre quedó guardado como texto, y las tablas siguen ahí. Hay una lección
en la salida de make sinks de arriba: la regla también marca dos
templates de SQL en Kallpa.
// src/seed.ts:17-18
const count = (table: string) => (db.prepare(`SELECT COUNT(*) AS n FROM ${table}`).get() as { n: number }).n;

// src/store/database.ts:54
db.exec(`PRAGMA user_version = ${version + 1}`);
¿Son inyectables? Hay que seguir el dato. En seed.ts, table solo recibe
'courts', 'members' y 'bookings', escritos en el programa. En
database.ts, version es un entero de un bucle. Ninguno viene de fuera de
la frontera, así que son falsos positivos: la herramienta mira la forma
del código, no a dónde llega el dato.
Decidirlo es parte de la auditoría, y se escribe la razón. No se responde al aviso “arreglando” el código sin entenderlo, ni se concluye que la herramienta no sirve. Ya vieron en la semana 11 por qué toda herramienta de análisis estático se equivoca para un lado o para el otro.
Condiciones excepcionales: un pedido apaga el servidor
A10 es la categoría nueva y Kallpa tiene un ejemplo perfecto. Un pedido con la
ruta //:
$ curl -s --path-as-is -m 3 -i localhost:3000// ; echo exit=$?
exit=52

$ curl -s -m 3 localhost:3000/api/courts ; echo exit=$?
exit=7
El código 52 de curl es “el servidor no respondió nada”, y el 7 es “no me
pude conectar”. El proceso murió. En su log:
...
TypeError: Invalid URL
    at new URL (node:internal/url:911:25)
    at Server.<anonymous> (file:///tmp/k/src/http/server.ts:49:17)
    at Server.emit (node:events:514:20)
    at parserOnIncoming (node:_http_server:1464:12)
    at HTTPParser.parserOnHeadersComplete (node:_http_common:125:17) {
  code: 'ERR_INVALID_URL',
  input: '//',
  base: 'http://localhost'
}

Node.js v26.13.0
La causa es de una línea. El manejador de errores está bien pensado, pero new URL(...) quedó antes del try:
return http.createServer(async (req, res) => {
  const url = new URL(req.url ?? '/', 'http://localhost');
  try {
Para //, new URL lanza, nadie atrapa, y la promesa del callback queda
rechazada sin manejar. Node termina el proceso. Es una denegación de
servicio que cabe en un comando, sin autenticación, y que cualquiera en
internet podría repetir cada vez que el servidor vuelve. Compárenlo con una
ruta mal codificada, cuyo error sí ocurre dentro del try: responde 500 con
un mensaje que no revela nada, y el servidor sigue:
{ "error": { "code": "INTERNAL_ERROR", "message": "Ocurrió un error inesperado." } }Esa segunda respuesta es exactamente lo que A10 y A02 piden: el detalle queda en el log, quien llama no se entera de nada interno.
Idea clave. OWASP resume A10 en tres fallas: no prevenir la situación inusual, no identificarla cuando ocurre, y responder mal o no responder después. Este caso tiene las tres. Y la semana 13 enseña la otra mitad: un proceso que muere solo sin que nadie reciba una alerta es también A09. Fuente: A10:2025.
Con IA. El código generado repite los patrones más comunes de lo que aprendió, incluidos los inseguros. Pearce y otros (Asleep at the Keyboard?, IEEE S&P 2022) pidieron a GitHub Copilot completar 89 escenarios relacionados con debilidades de alto riesgo (como las de la lista CWE Top 25), obtuvieron 1 689 programas y encontraron que cerca de 40 % eran vulnerables. Los límites importan: es una herramienta de 2021, ya muy distinta, y los escenarios se eligieron donde el error es posible, así que ese número no es “el 40 % del código generado”. Lo que sí queda es la conclusión práctica. Un cambio como los que suele proponer un agente para “mostrar el nombre del equipo” puede traer
innerHTMLporque es lo más corto y lo más común; para “buscar reservas”, SQL con un template, como vieron en la semana 11; para “conectar con WhatsApp”, un token en el código. Y una funcionalidad con LLM agrega su propia superficie: el nombre del equipo que aquí es un XSS, en el asistente de la semana 14 es una inyección de prompts indirecta. La revisión es la misma en todos los casos: busquen por dónde entra el texto no confiable y a dónde llega. La salida de un modelo también cuenta como texto no confiable, así que tampoco va ainnerHTML.
Privacidad y la Ley 29733
Esto no es asesoría legal. Esta sección es una introducción técnica para ingenieros, en un curso de ingeniería de software. Resume y cita normas para que sepan qué preguntar, no para que decidan solos cómo se aplican a un caso. Quien tiene que decidir es el titular del negocio, con su abogado o con la Autoridad Nacional de Protección de Datos Personales. Las normas cambian: antes de usar algo en un proyecto real, lean el texto vigente.
Las fuentes
Hay tres textos, y es importante no mezclarlos:
- La Ley N.° 29733, de Protección de Datos Personales (2011). Citamos la versión actualizada que publica el Estado en gob.pe, con las modificaciones del Decreto Legislativo N.° 1353 (2017).
- Su reglamento vigente, aprobado por el Decreto Supremo N.° 016-2024-JUS, publicado en El Peruano el 30 de noviembre de 2024. Su primera disposición complementaria final dice que entra en vigencia “a partir de los 120 días calendario siguientes de su publicación”, con plazos más largos para algunas obligaciones. Derogó expresamente el reglamento anterior.
- El reglamento anterior, Decreto Supremo N.° 003-2013-JUS, ya derogado.
Error común. Citar el reglamento derogado. El PDF de la ley que aparece en gob.pe es una compilación que trae, después de la ley, el reglamento de 2013. Si buscan un artículo en ese archivo y siguen bajando, pueden terminar citando una norma que ya no rige, con otra numeración. Para el reglamento, usen siempre el de 2024.
El vocabulario
La ley tiene definiciones precisas, y una de sus palabras clave engaña: titular se usa para dos personas distintas.
- Datos personales (art. 2.4): “Toda información sobre una persona natural que la identifica o la hace identificable a través de medios que pueden ser razonablemente utilizados”. El reglamento (art. III.4) aclara que incluye información “sobre hábitos personales, de localización, identificadores en línea o de cualquier otro tipo”, y que alguien es identificable también “a partir de la combinación de datos”.
- Datos sensibles (art. 2.5): los biométricos que por sí mismos pueden identificar; origen racial y étnico; ingresos económicos; opiniones o convicciones políticas, religiosas, filosóficas o morales; afiliación sindical; información relacionada a la salud o a la vida sexual. El reglamento (art. III.6) tiene su propia lista, con diferencias: agrega, por ejemplo, datos genéticos y neuronales. Reciben protección especial (art. 3) y su consentimiento debe ser por escrito (art. 13.6).
- Titular de datos personales (art. 2.16): la persona a quien corresponden los datos. El vecino.
- Titular del banco de datos personales (art. 2.17): quien “determina la finalidad y contenido del banco de datos personales, el tratamiento de estos y las medidas de seguridad”. El reglamento agrega el responsable del tratamiento (art. III.22), quien decide sobre la finalidad y los medios. En su proyecto, muy probablemente, el cliente.
- Encargado de tratamiento (art. 2.7): quien trata los datos por encargo del titular del banco, en virtud de una relación jurídica. Quien construye u opera el sistema para otro puede estar en este lugar.
- Banco de datos personales (art. 2.1): un conjunto organizado de datos personales, “automatizado o no”. Una hoja de cálculo cuenta. Una tabla de SQLite, también.
- Tratamiento (art. 2.19): cualquier operación sobre los datos, desde recopilarlos hasta suprimirlos, pasando por la consulta o la “comunicación por transferencia”. Leer una tabla es tratamiento. Copiarla a su laptop, también.
¿Y un celular, o un nombre de equipo? El celular identifica a una persona: es dato personal. El DNI, el celular y el nombre no figuran en las listas de datos sensibles del art. 2.5 de la ley ni del art. III.6 del reglamento; una foto del DNI es otra conversación (ver el ejercicio 8), porque un dato biométrico sí figura. Un nombre de equipo como “Fulbito de las 7” probablemente no identifica a nadie, y uno como “Familia Quispe de Comas” probablemente sí, o lo hace en combinación con otros datos. No se decide por el nombre del campo, sino por lo que contiene.
Los principios rectores
El título I de la ley enumera ocho principios. El art. 12 agrega algo que a veces se olvida: esa lista “es enunciativa”, no cerrada, y los principios sirven además para interpretar la ley y llenar sus vacíos. El reglamento (art. IX) agrega dos específicos: transparencia y responsabilidad proactiva. Este último importa mucho a quien construye: se deben aplicar medidas para cumplir, y quien responde “debe ser capaz de demostrar tal cumplimiento”. Otra vez, evidencia.
La tabla cita la norma y la lleva a Kallpa. La columna de la derecha es una lectura de ingeniería para discutir, no una conclusión legal.
| Principio (art.) | Qué dice | En Kallpa, para discutir |
|---|---|---|
| Legalidad (4) | El tratamiento se hace conforme a la ley; “se prohíbe la recopilación de los datos personales por medios fraudulentos, desleales o ilícitos” | Los datos se recogen en la administración, cara a cara |
| Consentimiento (5) | “Para el tratamiento de los datos personales debe mediar el consentimiento de su titular”. Con excepciones (art. 14) | ¿Qué parte es necesaria para la reserva, y qué parte es otra cosa? Ver abajo |
| Finalidad (6) | Una “finalidad determinada, explícita y lícita”; el tratamiento “no debe extenderse a otra finalidad” que no se haya establecido al recopilarlos | El celular se pidió para avisar de la reserva. Mandar promociones por ahí sería otra finalidad |
| Proporcionalidad (7) | “Todo tratamiento de datos personales debe ser adecuado, relevante y no excesivo a la finalidad” | GET /api/members entrega el celular de todos para llenar un <select> |
| Calidad (8) | Datos veraces, exactos y, en lo posible, actualizados; se conservan “solo por el tiempo necesario” | Las reservas no se borran nunca, tampoco las canceladas. ¿Cuánto tiempo hacen falta? |
| Seguridad (9) | Medidas “técnicas, organizativas y legales”, apropiadas al tratamiento y a la categoría de datos | No hay control de acceso, ni autenticación |
| Disposición de recurso (10) | El titular debe contar con vías “para reclamar y hacer valer sus derechos” | ¿A quién le escribe un vecino? Hoy, nada lo dice |
| Nivel de protección adecuado (11) | Para el flujo transfronterizo, un nivel suficiente de protección | ¿En qué país está el servidor de la semana 13? ¿Y el proveedor de WhatsApp? |
Consentimiento: no todo lo necesita, pero todo se informa
Es un error común creer que cualquier dato necesita una casilla que diga “acepto”. La ley es más precisa.
Cuando se necesita, el consentimiento “debe ser previo, informado, expreso e inequívoco” (art. 13.5). El reglamento agrega “libre” (art. 2) y define cada palabra:
- Previo (art. 4): antes de recopilar el dato.
- Expreso (art. 5): una acción concreta; hacer clic cuenta (art. 5.1.3).
- Libre (art. 3): condicionar un servicio a entregar datos que “no son indispensables” sí afecta la libertad de quien consiente (art. 3.2). Si un vecino no puede reservar sin aceptar recibir promociones, ese consentimiento tiene un problema.
- Quién lo prueba (art. 9): “la carga de la prueba recae en todos los casos” en el titular del banco o responsable. Si no hay registro de que aceptó, es como si no.
Cuando no se necesita. El art. 14 lista excepciones. Para una aplicación como Kallpa, la más relevante es la del numeral 5:
“Cuando los datos personales sean necesarios para la preparación, celebración y ejecución de una relación contractual en la que el titular de datos personales sea parte […]”
Alquilar una cancha es una relación contractual. Una lectura razonable es que el nombre de quien reserva, la hora y un medio para confirmarle la reserva caen ahí. Y otra lectura razonable de la misma frase es que no cubre usar ese celular para promociones, publicar sus datos o entregarlos a otra persona: para eso, el reglamento dice que “debe obtenerse el consentimiento” (art. 1.3). Cuál es el límite exacto en un caso concreto no lo decide un programador.
En cualquier caso, se informa. El art. 18 da derecho a saber, “de manera previa a su recopilación”, la finalidad, los destinatarios, el banco de datos y quién es su titular, si la transferencia ocurre, cuánto tiempo se conservan los datos y cómo se ejercen los derechos. El reglamento lo detalla en su art. 6.1. Si los datos se recogen en línea, se puede cumplir “mediante la publicación de políticas de privacidad, las que deben ser fácilmente accesibles e identificables” (art. 18). Pero esa publicación “no exonera del requisito de obtener el consentimiento” cuando este corresponde (art. 7 del reglamento).
Error común. Tratar la política de privacidad como un trámite que se copia de otro sitio. Se tiene que corresponder con lo que el sistema hace: qué datos, para qué, hasta cuándo. Eso solo lo sabe quien lo construyó. Y si el código y la política se contradicen, el problema no está en la redacción.
Los derechos de las personas
Se suele hablar de derechos ARCO (acceso, rectificación, cancelación, oposición), y es una abreviatura útil, pero el título III de la ley reconoce más:
| Derecho | Art. de la ley | Plazo de respuesta (reglamento, art. 69) | Qué le pide al software |
|---|---|---|---|
| Información | 18 | 8 días | Saber decir qué se hace con los datos |
| Acceso | 19 | 20 días | Poder sacar todo lo de una persona |
| Actualización, inclusión, rectificación y supresión | 20 | 10 días | Poder corregir y borrar sin romper |
| Impedir el suministro | 21 | 10 días | Saber a quién se entrega qué |
| Oposición | 22 | 10 días | Poder dejar de tratar los datos de alguien |
| Tratamiento objetivo | 23 | 10 días | Que una decisión importante no sea solo automática |
El art. 69.3 fija 10 días para “los otros derechos”, y nombra rectificación, cancelación y oposición. Los días son hábiles (art. 2.6 de la ley). El reglamento llama cancelación a lo que la ley llama supresión (art. III.3), así que van a ver las dos palabras para lo mismo. Y agrega la portabilidad (art. 76), que surte efecto seis meses después de la entrada en vigencia. Si el titular niega el derecho, la persona puede ir a la Autoridad o a un juez (art. 24).
Esto tiene consecuencias de diseño concretas, y son más baratas al inicio:
- Kallpa no tiene ninguna forma de borrar a un vecino.
bookings.member_idtiene una clave foránea amembers. ¿Qué pasa con la caja de hace un año si se borra a alguien? Se puede anonimizar la reserva (art. 2.14: es irreversible), y conservar el dinero sin la persona. Es una decisión de esquema. - La ley obliga a “almacenar los datos personales de manera que se posibilite el ejercicio de los derechos de su titular” (art. 28.5). Un dato copiado a diez planillas no se puede borrar.
Seguridad e incidentes: lo que depende
Esta parte es donde es más fácil exagerar o minimizar. Cada una de estas obligaciones tiene sus propias condiciones. Lean la condición antes de repetir la consecuencia.
- Control de acceso (reglamento, art. 46). Plataformas y sitios web “que son empleados para realizar tratamiento de datos personales” deben tener documentado e implementado el control de acceso: gestión de accesos, identificación y autenticación, privilegios. También registros de quién hizo qué, que “deben conservarse por un periodo mínimo de dos (2) años”. Noten la diferencia con el log de Kallpa: se pide la traza de las acciones, no copiar el celular y el mensaje entero en cada línea.
- Documento de seguridad (art. 47), con un inventario de datos personales (art. 47.3).
- Registro. Quien cree un banco de datos está obligado a tramitar su inscripción en el Registro Nacional de Protección de Datos Personales (art. 42).
- Incidentes. Un incidente de seguridad de datos personales es “toda vulneración de la seguridad que ocasione la destrucción, pérdida, alteración ilícita de los datos personales o la comunicación o exposición no autorizada a dichos datos” (art. III.16). Lo que se notifica a la Autoridad, como máximo en 48 horas, es solo el incidente que “genere exposición de grandes volúmenes”, que “pueda afectar a un gran número de personas”, con datos sensibles, o con “un perjuicio evidente a otros derechos o libertades” (art. 34.1). Y además se debe documentar cualquier incidente (art. 35): su postmortem de la semana 13 tiene casi esa forma.
- Oficial de Datos Personales (art. 37): se designa en entidades públicas, para grandes volúmenes o datos sensibles, o cuando los datos sensibles sean parte del giro. Para los dos últimos casos, entra en vigencia de modo progresivo según el tamaño de la empresa, hasta cuatro años después de la publicación para microempresas (primera disposición complementaria final).
- Evaluación de impacto (art. 40): “de manera facultativa”. No es obligatoria, y la norma dice cuándo conviene especialmente: datos sensibles, perfiles, niños, grandes volúmenes.
- Niños, niñas y adolescentes (art. 22). Se necesita el consentimiento de quien ejerce la patria potestad o tutela; los mayores de catorce y menores de dieciocho pueden darlo, “de acuerdo a su capacidad”, con información en lenguaje comprensible para ellos. Si su cliente atiende a menores, esto cambia el diseño.
- Sanciones (art. 39 de la ley): las infracciones leves se multan de 0.5 a 5 UIT; las graves, de más de 5 a 50 UIT, y las muy graves, de más de 50 a 100 UIT, sin exceder el 10 % de los ingresos brutos anuales. Entre las leves está tratar datos que “no sean necesarios, pertinentes ni adecuados” (reglamento, art. 132.1). Entre las graves, tratar datos incumpliendo medidas de seguridad y generando “una exposición no autorizada” (art. 133.4).
Idea clave. Para una persona que desarrolla, lo que más se traduce en código son cuatro palabras: qué se guarda, para qué, quién lo ve y hasta cuándo. Si su sistema responde esas cuatro preguntas para cada dato, ya tiene casi todo el material para que el cliente y un abogado hagan su parte.
El inventario de Kallpa
El paso 4 del laboratorio comienza con esto. Los datos de ejemplo son inventados; piensen en esta tabla como si fueran de personas reales.
| Dato | Dónde se guarda | Por dónde sale | Finalidad | Quién lo necesita |
|---|---|---|---|---|
| Nombre | members.name |
GET /api/members; <select> de la página; log de WhatsApp |
Saber quién reserva | Esa persona; administración |
| Celular | members.phone |
GET /api/members; log de WhatsApp |
Avisarle de su reserva | Administración, y quien envía el aviso |
| Plan | members.plan |
GET /api/members |
Calcular el descuento | El cálculo del precio; administración |
| Reservas: qué día, a qué hora y dónde | bookings |
GET /api/members/:id/bookings; caja del día (sin nombres); log de WhatsApp |
Administrar la cancha | Esa persona; administración |
| Lo pagado | bookings.price_cents |
Mis reservas; log de WhatsApp | Cobrar | Esa persona; administración |
| Nombre del equipo | bookings.team_name |
Disponibilidad (para todos); Mis reservas | “Que se sepa quién tiene la cancha” (README) | Según el cliente |
Y las salidas que no aparecen en la lista de rutas, que son las que se olvidan:
GET /api/members/1/bookings 200
[whatsapp] para 912345678: Hola Luis Huamán Torres, tu reserva de Fulbito 1 el 2026-11-04 de 8:00 a 9:00 está confirmada. Total: S/ 81.00.
Ese log dice quién va a estar, dónde y a qué hora, con su celular. Cualquiera con acceso a los logs lo ve, y los logs suelen guardarse más tiempo, y con menos cuidado, que la base de datos. OWASP incluye justamente este caso en A09: datos sensibles en los archivos de log. Si la semana 13 mandó los logs a un servicio externo, también los mandó ahí.
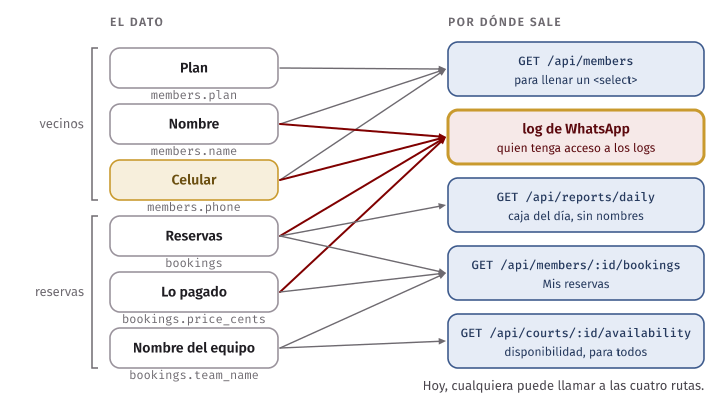
Una reserva es también un dato de localización y hábitos (art. III.4): “Rosa juega todos los jueves a las 7 en esa cancha”. Por sí solo no es dato sensible, pero a veces es justo lo que no se quiere que un desconocido sepa. Piensen en quién puede estar buscando a una persona. La proporcionalidad no es solo un tema de cumplimiento.
Finalidad y proporcionalidad: los cambios mínimos
Con ese inventario, las preguntas de proporcionalidad se responden casi solas. Otro vecino, para reservar, necesita saber qué horas están libres; no el celular, ni el plan, ni el nombre completo de nadie. Del nombre del equipo se puede discutir: es una regla del negocio del cliente (“que se sepa quién tiene la cancha”) que hay que informar, y se le puede preguntar si basta decir “ocupada”. La administración sí necesita nombre, celular y reservas para su trabajo, pero no hace falta mandarlos a cada navegador.
Los cambios mínimos, de menos a más trabajo:
GET /api/membersdevuelve soloidyname, porque es lo que usa el<select>. Es una línea, y quita los celulares de la respuesta.- El log deja de escribir el mensaje y el celular.
- Una política de privacidad que dice qué datos, para qué y hasta cuándo, y a quién escribirle.
- Un plazo de conservación, acordado con el cliente, y lo que pasa al cumplirse.
- Con sesiones: cada vecino solo ve lo suyo, y la lista de vecinos deja de ser pública.
Fíjense en que el primero no resuelve todo. La lista de nombres completos
sigue saliendo para que un <select> diga quién reserva, y ese diseño (elegir
de una lista quién eres) es el problema de fondo: A06. Un cambio pequeño
reduce el daño hoy y el arreglo de verdad es un issue con diseño.
Idea clave. Lo que más protege un dato es no recogerlo. Antes de agregar un campo de DNI o de dirección “por si acaso”, pregunten qué pasa si no está. Un dato que no se tiene no se filtra, no se pide en una auditoría y no hay que borrarlo.
Quién es quién en su proyecto
Su equipo tiene un cliente real y, probablemente, datos reales de sus clientes o vecinos. Estas preguntas valen para P5:
- ¿Quién es el titular del banco de datos? Probablemente su cliente, que decide para qué se usan. Ustedes podrían estar actuando como encargados. El art. 30 de la ley dice que, en ese caso, los datos “no pueden aplicarse o utilizarse con un fin distinto” ni “ser transferidos a otras personas, ni aun para su conservación”, y que al terminar el servicio “deben ser suprimidos”, salvo autorización. Eso incluye la copia en su laptop, y la base con datos reales que usaron para probar.
- ¿Hace falta un dato real para probar? Casi nunca. Usen datos inventados, como los de Kallpa, o anonimizados.
- ¿Quién más los recibe? Un servicio de hosting, un proveedor de correo, un servicio de logs. El reglamento trata estos medios tercerizados en sus arts. 28 y 29; si están en otro país, también puede haber flujo transfronterizo (art. 15 de la ley).
- ¿Y una herramienta de IA? Pegar en una herramienta un dump de la base del cliente puede ser una transferencia (art. 2.18: “toda transmisión, suministro o manifestación de datos personales […] a una persona jurídica de derecho privado, a una entidad pública o a una persona natural distinta del titular de datos personales”) y, si el proveedor está en otro país, un flujo transfronterizo (art. 2.10). No hace falta resolver la pregunta legal para tomar la decisión técnica: no se pegan datos personales reales en una herramienta sin permiso del cliente y sin revisar sus términos. Y se anota en el registro de uso.
Lo que no puedan responder, no lo inventen: anótenlo como pregunta para el cliente. Si su cliente es una asociación comunal, una entidad pública o una empresa pequeña, las respuestas sobre registro, oficial de datos y otras obligaciones pueden ser distintas, y no les toca a ustedes decidirlo. Sí les toca decir qué datos hay, dónde están y quién los ve, porque nadie más lo sabe.
Ética: quién queda afuera
Las decisiones que no parecen decisiones
Quien construye decide, aunque no lo note, quién puede usar el producto y a quién perjudica. “La reserva se hace por internet” es una decisión. “Hace falta un smartphone” también. Y “el campo DNI es obligatorio” también. Ninguna aparece en una reunión como una pregunta ética; casi todas aparecen como detalles.
El capítulo 4 de SWEG lo plantea con una frase: “Bias is the default”. El sesgo es lo que pasa si no se hace nada. Cuando los ingenieros no piensan en usuarios de otras nacionalidades, edades, condiciones económicas o capacidades, hasta el personal más talentoso les falla sin querer. Es una idea incómoda, porque quiere decir que las buenas intenciones no alcanzan.
El capítulo es notable porque habla de los errores de la propia empresa. Su caso principal es de 2015: el reconocimiento de imágenes de Google Photos etiquetó a personas negras con un insulto racista. Google analiza por qué: los datos con los que se entrenó no representaban a la población, las pruebas no lo detectaron, así que lo detectaron los usuarios. Según el libro, en 2018 Google todavía no había resuelto adecuadamente el problema de fondo. Esto hay que leerlo con el mismo cuidado que cualquier otra evidencia: es el relato de una empresa sobre sí misma, no un estudio. Lo valioso es el análisis de cómo pasó.
Sus otras ideas, para llevarse al proyecto:
- Desafiar los procesos establecidos. Un sistema de contratación iba a mostrar las evaluaciones bajas de quien pedía un traslado, porque eso quería su usuario principal: los reclutadores. Alguien preguntó si esas evaluaciones predecían algo. Al revisarlo, encontraron que quienes tenían una evaluación baja tenían tanta probabilidad de que les fuera bien en otro equipo como quienes nunca la tuvieron. El usuario más visible no era el único afectado.
- “Don’t build for everyone. Build with everyone.” No se construye para todos en abstracto; se construye con ellos. Diseñen para quien más dificultades va a tener: construir para esa persona suele mejorar el producto para todos.
- Mídanlo. “Don’t assume equity; measure equity.” La intención no se puede comprobar; el resultado, sí.
- Velocidad. “It’s better to slow down than to release a product that might cause harm to some users.” Mejor ir más lento que sacar algo que perjudique a una parte de los usuarios.
Tres preguntas para su proyecto
Las tres se responden con datos de su cliente, no desde el aula:
- ¿Quién no puede usar esto? ¿Alguien sin smartphone o sin datos? ¿Con una discapacidad? ¿Que lee con dificultad, o cuya lengua materna es otra? Para Kallpa: una persona mayor que reservaba por teléfono con la administración, ¿tiene cómo seguir haciéndolo? Si la nueva página reemplaza al teléfono, alguien acaba de quedar afuera, y nadie lo decidió.
- ¿Qué pasa con los datos si el cliente los pierde o los filtra? ¿Quién sufre? No el cliente: los vecinos, que no eligieron el sistema. ¿Hay copia de seguridad? ¿Quién tiene acceso? ¿Cómo se avisa?
- ¿Qué haría falta para que el cliente pueda seguir sin el equipo? El semestre termina y ustedes se van. Si el servidor lo paga una tarjeta suya, si el dominio está a su nombre, si solo ustedes saben desplegar, el cliente quedó en una situación peor que al inicio. Esta es una pregunta ética disfrazada de pregunta de entrega, y la semana 16 y P5 la toman en serio.
En la industria. Hay productos que no se deberían construir, o no de cierta forma, y el capítulo 4 de SWEG espera de los ingenieros la capacidad de identificar y rechazar funcionalidades o productos con resultados adversos. En un equipo real, eso empieza con algo más simple: decirlo por escrito en el design doc o en el pull request, con una alternativa. Fuente: SWEG, cap. 4.
Accesibilidad
Por qué, y con qué norma
Una página accesible es la que pueden usar personas con discapacidad: visual, auditiva, motora o cognitiva, permanente o temporal. Una persona con el brazo enyesado, una que no distingue bien el rojo del verde, otra que usa un lector de pantalla, un adulto mayor que ve poco, otra persona con el celular bajo el sol: todos usan su página. La accesibilidad se parece a la seguridad en algo: es mucho más barata si se piensa desde el inicio.
WCAG (Web Content Accessibility Guidelines), del W3C, es la referencia internacional. La versión actual, 2.2, organiza sus requisitos así:
- Cuatro principios. El contenido tiene que ser perceptible (se puede percibir con algún sentido), operable (se puede manejar), comprensible y robusto (funciona con distintas tecnologías, incluidos los lectores de pantalla).
- Pautas dentro de cada principio.
- Criterios de conformidad (success criteria), que son los comprobables, con número: 1.4.3 es del principio 1, pauta 4, criterio 3.
- Tres niveles: A, AA y AAA. Cada nivel incluye los anteriores. AA es el que suelen exigir las normas y los contratos. El propio W3C no recomienda exigir AAA como política para sitios enteros, porque no siempre se puede cumplir.
Los criterios que más se incumplen
No hace falta memorizar la norma: hace falta saber los que más se incumplen en una página pequeña, y cómo se comprueba cada uno. La referencia rápida trae cada criterio, con técnicas y ejemplos.
| Criterio | Nivel | Qué pide | Cómo se comprueba | ¿Lo detecta una herramienta? |
|---|---|---|---|---|
| 1.1.1 Contenido no textual | A | Las imágenes y otros contenidos tienen texto alternativo equivalente | Mirar el alt de cada imagen |
Que falte, sí. Que describa bien la imagen, no |
| 1.3.1 Información y relaciones | A | La estructura que se ve también está en el código: <label> unida a su campo, encabezados |
Clic en la etiqueta: ¿va al campo? | En parte |
| 1.4.1 Uso del color | A | El color no es el único medio de transmitir algo | Verlo en escala de grises | Casi nunca |
| 1.4.3 Contraste mínimo | AA | 4.5:1 en texto normal, 3:1 en texto grande (18 pt, o 14 pt en negrita) | Calcular la razón | Sí, en la mayoría de los casos |
| 2.1.1 Teclado | A | Todo se puede hacer con teclado | Hacer la tarea sin mouse | No |
| 4.1.2 Nombre, función y valor | A | Cada control dice qué es y qué estado tiene, para la tecnología de asistencia | Inspector de accesibilidad; lector de pantalla | En parte |
| 4.1.3 Mensajes de estado | AA | Un mensaje de estado se anuncia sin mover el foco | Lector de pantalla; role="status" |
Casi nunca |
El contraste de Kallpa
La razón de contraste tiene una fórmula pública en WCAG. Para cada color,
se calcula su luminancia relativa; la razón es (L1 + 0.05) / (L2 + 0.05),
con L1 la del más claro. Va de 1:1 (el mismo color) a 21:1 (negro sobre
blanco). contrast.ts la implementa y sus pruebas la comprueban con esos dos
extremos:
export function relativeLuminance(hex: string): number {
  const match = /^#([0-9a-f]{2})([0-9a-f]{2})([0-9a-f]{2})$/i.exec(hex);
  if (match === null) throw new Error(`Color inválido: ${hex}`);
  const [r, g, b] = match.slice(1).map((part) => {
    const channel = parseInt(part, 16) / 255;
    return channel <= 0.04045 ? channel / 12.92 : ((channel + 0.055) / 1.055) ** 2.4;
  });
  return 0.2126 * r + 0.7152 * g + 0.0722 * b;
}

export function contrastRatio(first: string, second: string): number {
  const [darker, lighter] = [relativeLuminance(first), relativeLuminance(second)].sort((a, b) => a - b);
  return (lighter + 0.05) / (darker + 0.05);
}
Con los colores de public/styles.css:
$ make contraste
body              #222222 sobre #ffffff  15.91:1  cumple
header h1         #0b6e4f sobre #ffffff   6.25:1  cumple
.hint             #b5b5b5 sobre #ffffff   2.05:1  NO cumple
.mine .cancelled  #b5b5b5 sobre #ffffff   2.05:1  NO cumple
.slot.free        #ffffff sobre #43a047   3.30:1  NO cumple
.slot.taken       #ffffff sobre #e53935   4.23:1  NO cumple
#message.ok       #43a047 sobre #ffffff   3.30:1  NO cumple
#message.error    #e53935 sobre #ffffff   4.23:1  NO cumple
Seis de ocho. Y se ve bien, si uno tiene buena vista y una buena pantalla: ese
es el problema. Ojo con .slot.taken: 4.23:1 está cerca, y “cerca” no cumple.
No se redondea. El texto de ayuda (#b5b5b5) es el caso más claro: es justo
el texto que dice cómo usar la página. En el laboratorio lo comprueban con el
Contrast Checker de WebAIM,
para no depender de nuestra implementación.
Error común. Revisar solo el color del texto. Hay que comparar pares: el mismo
#43a047aparece como fondo de una hora libre con texto blanco, y como texto del mensaje de confirmación con fondo blanco. También hay que mirar lo que no es texto: 1.4.11 pide 3:1 para los elementos de interfaz. El borde amarillo (#fdd835) de la hora elegida da 1.40:1 contra el blanco y 2.37:1 contra el verde.
Teclado: dónde se traba una reserva
Ahora, lo que ninguna fórmula ve. Abrimos la página en Chrome y apretamos Tab, varias veces. El foco recorre esto:
select#court. > input#date. > input#date. > input#date. > input#date. > select#member. > input#team. > select#hours. > button#book. > a#. > body > select#court.Cada elemento es etiqueta#id.clase. Los cuatro input#date son las partes
del campo de fecha, y a#. es el primer enlace “cancelar”. Pasa de la fecha a
“quién reserva” sin tocar ninguna hora. Eran 15 horas en pantalla, y el
foco no se detiene en una sola. Para el navegador no son controles: son
<div> con un listener de clic.
? `<div class="slot free" data-hour="${slot.hour}">${slot.hour}:00</div>`En la versión con innerHTML y en la que usa textContent es lo mismo: un
<div> no es un control.
Por lo tanto, no se puede elegir una hora con el teclado, y sin hora,
Reservar responde Primero elige una hora.. Una persona que no usa mouse
no puede hacer una reserva, que es la razón principal por la que existe esta
página. Es un incumplimiento de 2.1.1, nivel A, el más básico. Un <div>
tampoco le dice a un lector de pantalla que se trata de un control (4.1.2).
La corrección no es agregar tabindex y un manejador de teclas. Es usar el
elemento que ya hace eso:
const free = element('button', 'slot free', label);
free.type = 'button';
Un <button> se enfoca con Tab y se activa con Enter o Espacio, y un lector
de pantalla lo anuncia como botón, todo sin una línea más de código. En nuestra prueba, con todas las correcciones del laboratorio aplicadas, la primera
hora libre se alcanzó tras 6 Tab, y una reserva completa se pudo hacer solo con el
teclado.
Idea clave. Primero, HTML semántico:
<button>,<label>,<fieldset>, encabezados en orden. Dan gratis el foco, el teclado y el nombre. ARIA es para lo que el HTML no puede expresar, y un atributo ARIA no agrega ningún comportamiento:role="button"en un<div>lo anuncia como botón, pero sigue sin responder a Enter. Una mala ARIA es peor que ninguna.
Lo demás que se traba
- Etiquetas (1.3.1, 4.1.2, 3.3.2). La página tiene cinco campos y ninguna
<label>. Un lector de pantalla no tiene cómo decir para qué es cada lista. El campo del equipo tiene solo unplaceholder, que desaparece al escribir. La corrección es una<label for="team">, que además amplía el área en la que se puede hacer clic. - Mensajes de estado (4.1.3). “Reserva confirmada” aparece en un
<p id="message">sin ninguna marca. Quien ve la pantalla lo nota. Sin unroleniaria-live, un lector de pantalla no tiene por qué anunciarlo, porque el foco sigue en el botón, y quien reserva así no sabe si funcionó.role="status"es la forma de marcarlo; compruébenlo con NVDA o VoiceOver. - Uso del color (1.4.1). La hora elegida se distingue solo por un borde amarillo. Es el caso claro. Las horas libres y ocupadas son verdes y rojas, algo difícil de distinguir con daltonismo, aunque aquí no es solo color: las ocupadas también traen el nombre del equipo. Aun así, una palabra (“Libre”, “Ocupada: Real Barranco”) ayuda a todos.
- Lo que no se aplica. 1.1.1: Kallpa no tiene imágenes. Una auditoría también dice lo que miró y no encontró. El día que su proyecto agregue un logo, el criterio vuelve a aplicar.
- “cancelar” es un
<a href="#">que hace una acción. Se puede usar con teclado, así que no es un incumplimiento de 2.1.1. Pero un enlace lleva a otro lugar y un botón hace algo: quien usa lector de pantalla espera otra cosa. Es de los que se corrigen de paso.
Cómo se evalúa, y el puntaje que engaña
Las herramientas automáticas, como Lighthouse (en las DevTools de Chrome) o el inspector de accesibilidad del navegador, encuentran una parte de los problemas, como contrastes y campos sin nombre. El resto solo aparece usando la página: con el teclado, y con un lector de pantalla (NVDA en Windows, VoiceOver en macOS). Las Easy Checks del W3C son una buena primera revisión a mano.
Para ver qué tan parcial es, corrimos Lighthouse 12.8.2 (Chrome 156, en macOS, con el servidor en el contenedor del curso) sobre Kallpa. Dio 81 de 100, con tres avisos. Este es el resumen de su reporte, con la cantidad de elementos de cada aviso:
LH 12.8.2 score 0.81
  color-contrast [18]
  label [1]
  select-name [3]
Fíjense en lo que dicen y en lo que no. Dice que hay 18 elementos con mal
contraste, y 4 campos sin nombre. No dice nada de las horas. Y label
solo marca input#date: al campo del equipo lo acepta, porque un
placeholder le da un nombre accesible calculado.
Entonces hicimos un experimento: corregimos solo lo que Lighthouse dijo.
Etiquetas y colores (#595959, #2e7d32, #c62828), sin tocar los <div>.
Lighthouse:
LH 12.8.2 score 1100 de 100. Y la secuencia de Tab de esa misma página:
select#court. > input#date. > input#date. > input#date. > input#date. > select#member. > input#team. > select#hours. > button#book. > a#. > body > select#court.No cambió nada. Sigue sin haber forma de elegir una hora. Una página con puntaje perfecto en la que una persona sin mouse no puede hacer una reserva. (Y en el mismo reporte seguía sin aparecer nada sobre el XSS: no es su tema.)
Error común. Dar por accesible una página porque Lighthouse le da un puntaje alto. La herramienta no puede saber si el orden del foco tiene sentido, si un texto alternativo describe la imagen o si un control que se ve como botón se puede activar con el teclado. El puntaje le dice lo que está mal entre lo poco que puede medir, no que la página funcione. Eso solo se sabe usándola como la usaría esa persona. El puntaje de Lighthouse puede cambiar entre versiones; el problema, no.
Con IA. Una herramienta de IA puede leer el HTML y listar etiquetas faltantes: ve lo que está en el código. Eso no comprueba que una persona termine la tarea con el teclado o con un lector. Y cuando le pidan corregir, revisen el diff con cuidado: agregar
role="button"ytabindex="0"a un<div>puede hacer que una herramienta deje de avisar sin que nada funcione. Un cambio como los que suele proponer un agente para “hacer accesible” esta página puede terminar con más atributos y el mismo problema. Se comprueba de la misma forma: con Tab.
Licencias
Sin licencia, nadie puede
Toda obra nueva, incluido el código, tiene derechos de autor desde que se crea. Una licencia es el permiso que da quien tiene esos derechos. Por eso, según choosealicense, si no hay licencia, en general nadie más tiene permiso de copiar, distribuir ni modificar el código. Público no es lo mismo que libre.
Hay un matiz. Al publicar en GitHub, sus términos de servicio permiten a otros ver y hacer fork del repositorio. Eso no da derecho a usar el código en su propio proyecto. Pueden existir también excepciones legales según el país, pero no alcanzan para colaborar como en un proyecto abierto. Y cuando un proyecto tiene varios autores, cada uno tiene derechos sobre lo suyo: “nadie” empieza a incluir también a ustedes.
Kallpa todavía está en esa situación: su package.json no declara license,
y no hay archivo LICENSE. En P5 eso no puede quedarse así.
Permisivas y copyleft
Las licencias se agrupan según lo que le piden a quien redistribuye. Esto es un resumen de choosealicense, no el texto legal:
| Tipo | Ejemplos | Qué se puede hacer | Qué pide |
|---|---|---|---|
| Permisiva | MIT, BSD-2-Clause, BSD-3-Clause, ISC, BlueOak-1.0.0 | Usar, modificar y redistribuir, también en un producto cerrado | Conservar el aviso de copyright y la licencia |
| Permisiva con patentes | Apache-2.0 | Lo mismo, con una concesión expresa de patentes de quienes contribuyen | Conservar los avisos e indicar los cambios |
| Copyleft débil | MPL-2.0 | Lo mismo, en un producto mayor con otra licencia | Compartir los cambios a esos archivos |
| Copyleft | GPL-3.0 | Lo mismo | Si distribuye un trabajo derivado, distribuirlo completo con la misma licencia y con su código |
| Copyleft de red | AGPL-3.0 | Lo mismo | Además, si una versión modificada se ofrece como servicio por la red, dar su código a quienes la usan |
La palabra importante es distribuir. Si una empresa modifica un programa GPL y lo usa en sus propios servidores, no lo está distribuyendo, y GPL no le pide publicar nada. Por eso existe AGPL: cierra ese caso para aplicaciones web. Y una página web tiene un detalle: el JavaScript que llega al navegador sí se está entregando a alguien. Una biblioteca con GPL en el frontend se comporta distinto de una en el backend.
Error común. Decir que “GPL es viral, así que no se puede usar”. No prohíbe nada: pide compartir en ciertas condiciones. Si esas condiciones le sirven al proyecto, es una opción legítima y puede ser justo lo que quiere el cliente: que nadie convierta el trabajo de la comunidad en un producto cerrado. Lo que no se puede es ignorarlo: una dependencia GPL en un producto que se distribuye cambia las obligaciones del proyecto entero.
La licencia del proyecto se acuerda con el cliente
No la elige el equipo a solas, porque el cliente tiene que entender lo que permite. Preguntas que sirven:
- ¿Quiere el cliente que otros reutilicen el código? ¿Le importaría que una empresa lo venda?
- ¿El equipo lo va a mostrar en su portafolio? ¿Puede ser público el repositorio?
- ¿Se compartirá con otros complejos o asociaciones? Una licencia libre se lo permite sin trámites.
- ¿Hay datos, claves, nombres o documentos del cliente en el repositorio? Una licencia cubre lo que se publica: eso hay que sacarlo antes, también del historial de Git.
Y se declara con su identificador SPDX, una
lista estándar que las herramientas entienden, en package.json y en un
archivo LICENSE con el texto completo:
{ "name": "kallpa", "license": "MIT" }Dejen por escrito la conversación con el cliente. P5 pide el archivo
LICENSE, y en ## Licencia del README por qué se eligió. Si el cliente
quiere algo fuera de lo común, o si hay dinero o una institución de por medio,
el acuerdo necesita a alguien que sepa de derecho: ese tampoco es un consejo
legal de este curso.
Las licencias de las dependencias
El lockfile de la semana 12 registra la licencia de cada paquete. Con las seis herramientas que allí se fijan como devDependencies:
$ make licencias
     74 MIT
     13 Apache-2.0
      6 BSD-2-Clause
      5 ISC
      1 BlueOak-1.0.0
      1 BSD-3-Clause
Son 100 paquetes: seis directos y los demás, transitivos. Todas son
permisivas: ninguna pide más que conservar el aviso. Apache-2.0 pide además
indicar los cambios, si se modifican sus archivos. Y todas están marcadas como
dev: ninguna llega al producto, porque Kallpa no tiene dependencias de
producción. Eso importa menos para una herramienta que corre en su computadora
que para una biblioteca que se empaqueta y se entrega.
Dos advertencias. El campo license lo declara quien publica el paquete, y
ninguna herramienta comprueba que coincida con el código, así que para algo
importante se mira el archivo LICENSE del paquete. Y la cuenta se repite
cada vez que se agrega una dependencia: revisar la licencia es parte de
evaluarla, como vieron en la semana 12.
✂️ Procedencia del código generado
Una herramienta de IA da código sin decir de dónde salió. Esto plantea dos preguntas, y conviene separarlas.
¿Puede reproducir código ajeno? Sí es posible. Se ha demostrado que los modelos de lenguaje pueden reproducir fragmentos textuales de lo que vieron al entrenarse. Carlini y otros (Extracting Training Data from Large Language Models, USENIX Security 2021) recuperaron de GPT-2 cientos de secuencias textuales de sus datos de entrenamiento, entre ellas código y también nombres, teléfonos y correos públicos. Los límites: es un ataque hecho a propósito sobre un modelo de 2019, no el uso normal de una herramienta de programación, y no mide qué tan seguido pasa en la práctica. Sirve para descartar la frase “eso es imposible”, no para calcular un riesgo. Si un fragmento copiado tenía licencia GPL, el código sigue teniéndola, aunque nadie lo diga.
¿De quién es el código generado? Quién es titular, y en qué condiciones, depende de la ley de cada país y de los términos de la herramienta. Es una discusión abierta, y no hay una respuesta que este curso pueda darles. Esto tampoco es asesoría legal.
Lo que el equipo sí controla no depende de cómo se resuelva esa discusión:
- Registrar qué se generó y con qué: el registro de uso de IA que vienen
llevando (
docs/registro-ia.md). - Revisar y entender ese código como si fuera propio. Quien lo aprueba responde por él: lo vieron en la semana 11, y P5 lo pregunta en la defensa oral.
- Sospechar de bloques largos que parecen copiados: comentarios ajenos, un aviso de copyright, nombres de otro proyecto, un estilo que no se parece al resto. Busquen el fragmento: si aparece en otro repositorio, miren su licencia.
- No pegar en una herramienta código o datos del cliente sin su permiso, y revisar qué hace la herramienta con ellos.
Vean un caso. Una herramienta genera una función de 80 líneas con un comentario en inglés que menciona el nombre de otro proyecto. Antes de aceptarla: busquen ese nombre y algunas líneas distintivas. Si encuentran el origen, respeten su licencia (citen, cambien de licencia o descártenla), o escriban la función de nuevo entendiendo lo que hace. En el registro de uso, escriban qué se pidió, qué se aceptó y qué se rechazó y por qué:
| 2026-11-05 | (herramienta y versión) | Función para calcular cruces con turnos fijos | Reescrita a mano, con la idea del algoritmo | La función generada traía un comentario de otro proyecto: el origen está en <enlace>, con licencia GPL-3.0. |El laboratorio y el código
El laboratorio es una auditoría de seguridad y accesibilidad de su propia
copia de Kallpa, en parejas. La guía es
code/week-15/template-auditoria.md:
cópienla a docs/auditoria.md. Tiene una sección por cada paso de la guía de
la semana: modelo de amenazas, control de acceso, XSS,
datos personales, cabeceras, accesibilidad, licencias y priorización. Cada
hallazgo lleva qué es, cómo se reproduce, su categoría, su severidad y la
corrección propuesta. Al final, corrijan los dos más graves en pull requests
separados y dejen los demás como issues.
Dentro de code/week-15:
| Archivo | Qué es |
|---|---|
template-auditoria.md |
La guía del laboratorio |
auditoria.test.ts |
Cada debilidad de este capítulo, comprobada contra una Kallpa de verdad |
ejemplos/acceso.ts, acceso.test.ts |
Autenticación frente a autorización |
contrast.ts, contrast.test.ts |
La fórmula de contraste de WCAG 2.2 |
accesibilidad.test.ts |
Lo que el código de public/ dice sobre etiquetas, teclado y mensajes |
eslint.sinks.js |
Dos reglas de análisis estático: innerHTML y templates de SQL |
licencias/, licencias.test.ts |
Un lockfile real y la cuenta de sus licencias |
Con make test en el contenedor:
ℹ tests 42
ℹ suites 10
ℹ pass 42
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 2608.146126
Fíjense en un detalle de auditoria.test.ts: esas pruebas pasan porque las
debilidades están ahí, y comprueban lo que se afirma en este capítulo sobre
Kallpa tal como se publicó. En su copia, una corrección hace fallar la prueba
correspondiente. Es lo opuesto a una prueba normal, y por eso no se copian a
su repositorio. Lo que va en su repositorio es la prueba al revés: que Rosa
reciba 403.
Y un recordatorio de la guía: con el servidor corriendo (make start), los
curl van en otra shell del contenedor; el navegador, Lighthouse y el lector
de pantalla, en su computadora.
Con IA. Una herramienta puede ayudar a llenar una tabla como esta, y es tentador que la complete sola. Pero una auditoría vale por sus comandos reales. Si un hallazgo no tiene un comando que alguien corrió, con la respuesta que se obtuvo, es solo una hipótesis: el template lo dice, un hallazgo que otra persona no puede reproducir no sirve.
Resumen
- Confidencialidad, integridad y disponibilidad se deciden al diseñar. Un modelo de amenazas responde cuatro preguntas: qué estamos construyendo, qué puede salir mal, qué vamos a hacer, lo hicimos bien. Todo lo que cruza la frontera de confianza es entrada no confiable.
- El OWASP Top 10:2025 crea conciencia; no certifica nada. A01 Broken Access Control sigue primero, entran A03 Software Supply Chain Failures y A10 Mishandling of Exceptional Conditions, y SSRF pasa a A01. Para verificar está ASVS.
- Autenticación es saber quién eres; autorización, decidir qué puedes hacer. Agregar inicio de sesión no cierra un IDOR. Cada solicitud se autoriza en el servidor, contra la identidad de la sesión, y por defecto se niega.
- XSS: texto de un usuario que se interpreta en la página de otro. Se
corrige en el sink, con
textContenten lugar deinnerHTML. Una CSP sin scripts en línea es una segunda capa, no un reemplazo.<script>porinnerHTMLno se ejecuta, peroonerrorsí: no prueben solo con<script>. - Inyección SQL: sentencias preparadas, siempre. Un template string con texto fijo del programa no es inyectable, y decidirlo es parte de la auditoría.
- Un error fuera del
trypuede ser una denegación de servicio://apaga Kallpa. - La Ley 29733: un dato personal identifica o hace identificable a una persona. Principios de legalidad, consentimiento, finalidad, proporcionalidad, calidad, seguridad, disposición de recurso y nivel de protección adecuado, más transparencia y responsabilidad proactiva en el reglamento de 2024 (D.S. 016-2024-JUS). No todo requiere consentimiento (art. 14.5), pero se informa (art. 18). Muchas obligaciones dependen de condiciones: léanlas. Estos apuntes no son asesoría legal.
- Ética: el sesgo es lo que pasa por defecto (SWEG cap. 4). Pregunten quién no puede usarlo, qué pasa con los datos y si el cliente puede seguir sin ustedes.
- WCAG 2.2: cuatro principios, tres niveles, y AA como meta habitual. Primero, HTML semántico. Una herramienta automática solo ve una parte: una copia de Kallpa llegó a 100 en Lighthouse sin que se pudiera reservar con el teclado.
- Licencias: sin licencia, nadie tiene permiso. Permisivas (MIT, BSD, Apache-2.0 con patentes) y copyleft (GPL al distribuir, AGPL también por la red). Se acuerda con el cliente y se declara con su identificador SPDX. Las de las dependencias se revisan.
- Procedencia: un modelo puede reproducir código ajeno; de quién es lo generado es una discusión abierta. Lo que se controla: registrar, entender, sospechar y no pegar lo que no es suyo.
Ejercicios
- Expliquen la diferencia entre confidencialidad, integridad y disponibilidad con un ejemplo de Kallpa para cada una que no esté en este capítulo. Para cada ejemplo, digan qué dato o ruta está en juego.
- Rosa inicia sesión en una versión nueva de Kallpa, que guarda su identidad
en una cookie. La ruta sigue siendo
POST /api/bookings/:id/cancel, y solo comprueba que haya una sesión. Escriban (a) elcurlcon el que Rosa cancela la reserva de Luis, (b) la prueba que falla hasta que se corrige, y (c) el cambio mínimo. ¿Por qué este caso muestra que agregar un inicio de sesión no basta? - Tomen el nombre de equipo
<a href="https://ejemplo.pe">Pagar aquí</a>. ¿Se ejecuta algún script? ¿La CSP de este capítulo lo detiene? ¿textContent, sí? ¿Qué daño puede hacer aun sin script? Comprueben las respuestas en su copia, en el navegador. - Escriban, para
GET /api/members/:id/bookings, la columna “¿Qué pasa si quien llama miente?” de un modelo de amenazas. Propongan una decisión para cada amenaza: corregir, reducir, aceptar con una razón, o eliminar. make sinksmarcósrc/seed.ts:18ysrc/store/database.ts:54. Para cada una, muestren de dónde viene el valor. Escriban una función de Kallpa de ejemplo que la regla no marque y que sea inyectable, y comprueben coneslintque no la marca. ¿Qué tendría que hacer la herramienta para encontrarla?- Elijan un dato de su proyecto. Con citas de la Ley 29733 y su reglamento, escriban para qué finalidad se recoge (art. 6), por qué es proporcional (art. 7), por cuánto tiempo se guarda (art. 8) y qué se le informa a la persona (art. 18). Terminen con una pregunta para su cliente que no puedan responder. Recuerden: es un ejercicio, no una opinión legal.
- Según el principio de proporcionalidad, ¿qué datos de los vecinos necesita
ver otro vecino para reservar una cancha? ¿Y la administración? Diseñen la
respuesta JSON de
GET /api/courts/:id/availabilityy deGET /api/memberspara cada caso. ¿Qué decisión le dejarían al cliente, y cómo se la explicarían? - Decidan si cada caso necesita consentimiento o si puede estar cubierto por el art. 14.5, y digan qué más necesitarían saber: (a) el celular para confirmar la reserva, (b) el mismo celular para mandar promociones, (c) el nombre del equipo que se muestra a todos, (d) la foto del DNI “para verificar”. ¿Qué le preguntarían al cliente en cada uno?
- Calculen a mano, con la fórmula de WCAG, la razón de contraste de
#595959sobre blanco. Comprueben el resultado concontrast.tsy con el Contrast Checker. Busquen el color más claro que cumple 4.5:1 sobre blanco, y escriban una prueba que lo confirme. - Corrijan en su copia solo lo que Lighthouse dice y anoten el puntaje. Hagan una reserva con el teclado. Ahora corrijan lo que encontraron y usen la página con NVDA o VoiceOver, sin mirar la pantalla. ¿Qué encontraron que no les dijo ninguna de las dos pruebas anteriores?
- Su cliente, una asociación de vecinos, quiere que otras asociaciones
reutilicen el sistema, pero no que una empresa lo venda cerrado. Comparen
MIT, Apache-2.0, GPL-3.0 y AGPL-3.0 para este caso, y escriban el párrafo
## Licenciade su README. ¿Qué cambia si la aplicación solo corre en un servidor del cliente y nadie más recibe una copia? - Tomen la función más larga que hayan generado con una herramienta en su proyecto. Apliquen la lista de “Procedencia”: busquen fragmentos, revisen el registro de uso, y expliquen una decisión de esa función en voz alta a alguien de su equipo. ¿Qué escribirían en el registro si hubieran encontrado el origen?