Apuntes · Capítulo 11Calidad: pruebas, revisión e integración
Revisión de código y análisis estático
Revisión de código y análisis estático
La semana pasada buscaron errores con pruebas: propiedades que recorren miles de entradas, fuzzing y mutantes que miden si las pruebas ven algo. Esas técnicas ejecutan el programa. Esta semana estudiamos dos formas de encontrar problemas sin ejecutarlo: que otra persona lea el cambio, y que una herramienta razone sobre el código.
Las dos tienen la misma limitación y la misma virtud. Ninguna garantiza nada: una persona se cansa y deja pasar un error, y una herramienta avisa cosas que no son errores y calla cosas que sí lo son. A cambio, ven lo que las pruebas no ven: si otra persona entiende el código, si el cambio debería existir, si una consulta arma SQL con texto del usuario, si una promesa quedó sin esperar en un camino que ninguna prueba recorre.
El capítulo tiene dos partes, como la semana. En la primera estudiamos la revisión de código: para qué sirve, además de encontrar errores; qué estándar usa quien aprueba; qué mirar y en qué orden; y cómo escribir comentarios que sirvan. En la segunda estudiamos el análisis estático: por qué toda herramienta es una aproximación, qué aprendió Google sobre cuándo un equipo confía en una, y cómo endurecer TypeScript y ESLint en un proyecto que ya existe. Al final juntamos las dos cosas para revisar código escrito con una herramienta de IA, donde la lectura humana y las herramientas encuentran errores distintos.
Lectura. Para la primera parte: Software Engineering at Google (SWEG), cap. 9, Code Review, y Google Engineering Practices, How to do a code review, en especial The Standard of Code Review. Para la segunda: SWEG, cap. 20, Static Analysis; typescript-eslint, Linting with Type Information y Shared Configs; y TypeScript,
noUncheckedIndexedAccessyexactOptionalPropertyTypes. Complementarias: Caitlin Sadowski y otros, Modern Code Review: A Case Study at Google (ICSE SEIP 2018); Google Engineering Practices, The CL author’s guide y Small CLs; Conventional Comments; GitHub, About pull request reviews; SWEG, cap. 19, Critique y cap. 8, Style Guides and Rules; y University of Maryland, CMSC 398Z Coding with AI. El código del capítulo está encode/week-11y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Para qué se revisa el código, Qué es una revisión y Seis cosas que da una revisión; de El estándar para aprobar, La regla; de Qué mirar, de lo grande a lo chico, El orden importa; de Cambios pequeños y respuestas rápidas, Por qué chicos; de Comentarios que sirven, Cuatro reglas; de Análisis estático: razonar sin ejecutar, Qué es, De menos a más profundo y Por qué todas aproximan; de Lo que Google aprendió con Tricorder, Falso positivo efectivo; y de Revisar código escrito con IA, Dónde suele fallar.
- En clase: Sesión A: Para qué se revisa el código, El estándar para aprobar, Qué mirar, de lo grande a lo chico, Cambios pequeños y respuestas rápidas y Comentarios que sirven. Sesión B: Análisis estático: razonar sin ejecutar, Lo que Google aprendió con Tricorder, TypeScript como análisis estático, Linting con tipos, Las fronteras del programa, Adoptar reglas sin romper el proyecto y Revisar código escrito con IA. Laboratorio: El laboratorio: revisar y endurecer.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Lo que encontró un estudio en Google, Una regla, sus dos errores y lo que dicen sobre la profundidad,
noUncheckedIndexedAccess, Un ejemplo completo de revisión de código generado y las lecturas del recuadro Lectura.
Para qué se revisa el código
Qué es una revisión
Una revisión de código es la lectura de un cambio por una persona distinta de quien lo escribió, antes de que entre a la rama principal. El objeto que se revisa es un diff, la lista de líneas que cambian, junto con una descripción de qué cambia y por qué. En GitHub, ese paquete es un pull request; en Google, un CL (changelist). Los documentos de Google que leerán hablan de CL: cuando lo vean, piensen en un pull request.
La palabra importante es antes. Una revisión después del merge es una
auditoría: si encuentra algo, ya está en main y hay que abrir otro cambio.
La revisión antes del merge tiene poder de decisión, y por eso los equipos la
ponen como una condición del flujo de trabajo, no como una buena intención.
Seis cosas que da una revisión
SWEG, en el capítulo 9, enumera seis beneficios. Solo el primero es encontrar errores:
| Beneficio | Qué quiere decir |
|---|---|
| Corrección | El cambio hace lo que se pretendía y no introduce errores |
| Comprensión | Otra persona lo entiende. La revisión es la primera prueba de que el código se entiende fuera de la cabeza de quien lo escribió |
| Consistencia | Se parece al resto de la base de código, y por eso otras personas pueden leerlo y revisarlo |
| Ownership del equipo | El código no es “de alguien”: es parte de un trabajo común, y todos responden por él |
| Conocimiento compartido | Quien revisa enseña y aprende; dos personas conocen ahora esa parte del sistema |
| Registro histórico | Queda escrito por qué se decidió algo, y se puede buscar años después |
El de la comprensión merece detenerse. Si quien revisa no entiende una parte del cambio, eso ya es un hallazgo, aunque el código funcione: quien lo mantenga dentro de dos años tampoco lo va a entender, y no tendrá a quién preguntarle. SWEG recomienda tratar esas preguntas con la máxima “el cliente siempre tiene la razón”. Quien escribió el código no contesta “es que es obvio”: lo reescribe o lo explica en un comentario.
Idea clave. Un cambio puede ser correcto y aun así no estar listo. La pregunta de quien revisa no es solo “¿funciona?”, sino “¿lo voy a poder mantener yo, sin hablar con quien lo escribió?”.
Lo que encontró un estudio en Google
¿Es cierto que la revisión sirve para más que encontrar errores, o es lo que las empresas dicen de sí mismas? El estudio más citado es el de Caitlin Sadowski, Emma Söderberg, Luke Church, Michal Sipko y Alberto Bacchelli (ICSE SEIP 2018).
Qué midieron. Combinaron 12 entrevistas, una encuesta con 44 respuestas y el análisis de los registros de 9 millones de cambios revisados. De las entrevistas y la encuesta salieron las expectativas de quienes revisan: educación (enseñar y aprender), mantener las normas del equipo, control de acceso (gatekeeping: quién decide qué entra a cada parte del código) y prevención de accidentes (errores y defectos). También valoran el registro histórico.
Qué encontraron. Su primer hallazgo dice que la revisión se introdujo en Google para asegurar que el código fuera legible y mantenible, que hoy quienes desarrollan perciben además su valor educativo, y que encontrar defectos es bienvenido, pero no es el único foco. Su segundo hallazgo matiza el primero: lo que se espera de una revisión depende de la relación entre autor y revisor. Las normas aparecen más entre personas de distinta experiencia; entre pares o con otros equipos pesan más el control de acceso y la prevención de accidentes.
De los registros salen números que conviene conocer: la mediana es de 24 líneas modificadas por cambio y de un revisor; menos del 25 % de los cambios tienen más de un revisor; y la mediana de latencia de toda la revisión es menos de 4 horas.
Qué no dice. Es un estudio exploratorio de una sola empresa, con herramientas propias y décadas de cultura de revisión. Las expectativas vienen de entrevistas y de una encuesta pequeña: dicen qué valoran las personas, no cuánto aprenden de verdad. Los números de tamaño y de latencia son los de Google y no se trasladan sin más a un equipo de cuatro estudiantes. Sí sirve como evidencia de que una revisión con cambios pequeños y un solo revisor puede funcionar a gran escala.
Tres permisos en Google, y su equivalente en GitHub
SWEG describe que en Google un cambio necesita tres tipos de visto bueno:
- Un LGTM (looks good to me) de otra persona, que revisa si el código es correcto y se entiende.
- La aprobación de un owner del código (una persona de un archivo
OWNERSde esa carpeta): este cambio es apropiado para esta parte del sistema. - La aprobación de alguien con readability en el lenguaje, una certificación interna: el código sigue las prácticas de ese lenguaje.
Suena pesado, y SWEG lo admite, pero aclara dos cosas. Normalmente una sola persona cumple los tres papeles. Y quien escribe el cambio puede cubrir por sí mismo los dos últimos si ya es owner y tiene readability: en ese caso solo necesita el LGTM de otra persona. Lo que nunca desaparece es que otra persona lea el cambio.
GitHub no tiene readability, pero sí lo demás:
| En Google | En GitHub |
|---|---|
| LGTM de otra persona | Una revisión con Approve, exigida con una regla de protección de main |
OWNERS |
Archivo CODEOWNERS: pide la revisión de los owners de esos archivos, y puede ser obligatoria |
| Presubmit y análisis automáticos | Revisiones de estado obligatorias: el pipeline tiene que pasar antes del merge |
| Comentarios en Critique | Comentarios en líneas, sugerencias y conversaciones que hay que resolver |
Al terminar una revisión en GitHub se elige uno de tres estados: Comment
(comentar sin decidir), Approve o Request changes. En P3, todo pull
request integrado a main tiene que tener la revisión de alguien distinto de
quien lo abrió, y la revisión automática lo comprueba con gh.
El estándar para aprobar
La regla
¿Cuándo se aprueba? Hay dos formas de equivocarse. Quien revisa con demasiada exigencia detiene el trabajo y desanima a quien propone mejoras. Quien aprueba todo deja que el código se degrade de a pocos: cada cambio es solo un poco peor, y ninguno parece el culpable. Google Engineering Practices resuelve esa tensión con la regla que llama el principio superior de toda la guía:
In general, reviewers should favor approving a CL once it is in a state where it definitely improves the overall code health of the system being worked on, even if the CL isn’t perfect.
En español: se aprueba cuando el cambio mejora con seguridad la salud general del código, aunque no sea perfecto. Las palabras cuidadosas son definitely y overall. No basta con que “probablemente no haga daño”, y no se exige que cada línea quede como quien revisa la habría escrito. El mismo texto lo dice así: no existe el código perfecto, solo el código mejor. Lo que se busca es la mejora continua.
¿Qué se hace con lo que todavía se podría mejorar? Se comenta igual, con una
marca de que no bloquea. En Google, el prefijo Nit: (de nitpick, un
detalle menor). Quien escribió el cambio decide si lo atiende.
La regla tiene un límite en cada lado. Quien revisa puede negarse a aprobar una funcionalidad bien escrita que no quiere en el sistema: el código puede ser bueno y el cambio, innecesario. Y la guía aclara que nada de esto justifica integrar un cambio que empeora la salud del código, salvo en una emergencia.
Cómo se deciden los desacuerdos
La misma página da una jerarquía de criterios. Conviene aprenderla porque evita la mayoría de las discusiones largas:
- Los hechos técnicos y los datos pesan más que las opiniones y las
preferencias. “Esto da 500 con un apóstrofe; aquí está el
curl” gana contra “a mí me parece que está bien”. - En estilo, manda la guía de estilo. Lo que no está en la guía es preferencia personal. Debe ser consistente con lo que ya hay; si no hay precedente, se acepta el estilo de quien escribió el cambio.
- El diseño casi nunca es solo estilo o preferencia. Se decide con principios (los de la semana 5, por ejemplo). Si varias opciones son igual de válidas y quien escribió el cambio lo puede demostrar, se acepta la suya.
- Si nada de lo anterior aplica, se puede pedir que sea consistente con la base de código actual, siempre que eso no empeore su salud.
Casos en Kallpa
Apliquemos el estándar a cuatro pull requests imaginarios:
| El cambio | ¿Se aprueba? | Por qué |
|---|---|---|
Agrega GET /api/courts/:id con pruebas correctas. Un nombre de variable podría ser mejor |
Sí, con un Nit: |
Mejora el sistema; el nombre no bloquea |
| Corrige un error de precios y deja una función de 40 líneas que ya estaba así | Sí, y una tarea aparte | No empeoró; pedir que arregle todo lo cercano detiene una corrección |
Agrega el nuevo reporte copiando la lógica de dailySummary, con otra forma de redondear |
No | Dos versiones de una regla del negocio: empeora con seguridad (DRY, semana 5) |
| Funcionalidad que el cliente no pidió, bien escrita y con pruebas | No, por ahora | El código puede ser bueno y el cambio no deber existir. Primero se conversa en el backlog |
Error común. El LGTM de cortesía: aprobar sin haber corrido ni entendido el cambio, porque quien lo pidió es amigo, porque hay prisa o porque “seguro está bien”. Es peor que no revisar. Un pull request sin revisión se sabe que no está revisado; uno con un LGTM de cortesía da una seguridad que nadie ganó. Al aprobar, ustedes dicen “lo leí, lo entendí, y respondo por él junto con quien lo escribió”.
Qué mirar, de lo grande a lo chico
El orden importa
La guía de Google, en What to look for in a code review, recorre muchos aspectos. En este curso los agrupamos en cinco, en este orden:
- Diseño. ¿El cambio debe existir? ¿Está en el lugar correcto? ¿Las piezas interactúan bien con el resto del sistema?
- Funcionalidad. ¿Hace lo que dice? ¿También con los casos límite y con entradas malas? ¿Hay efectos que un usuario notaría?
- Pruebas. ¿Fallarían si el código estuviera mal? ¿Prueban lo que dicen?
- Complejidad. ¿Es más complejo de lo que hace falta? ¿Resuelve problemas que nadie tiene todavía?
- Nombres, comentarios y documentación. ¿Los nombres dicen lo que es? ¿Los comentarios explican el porqué? ¿Hay que actualizar el README?
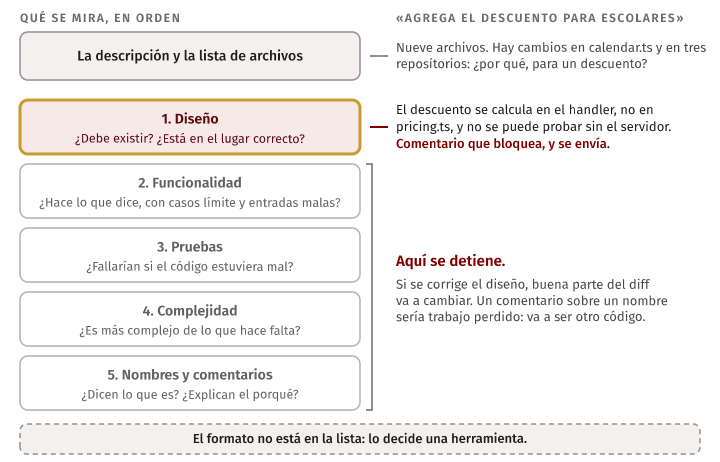
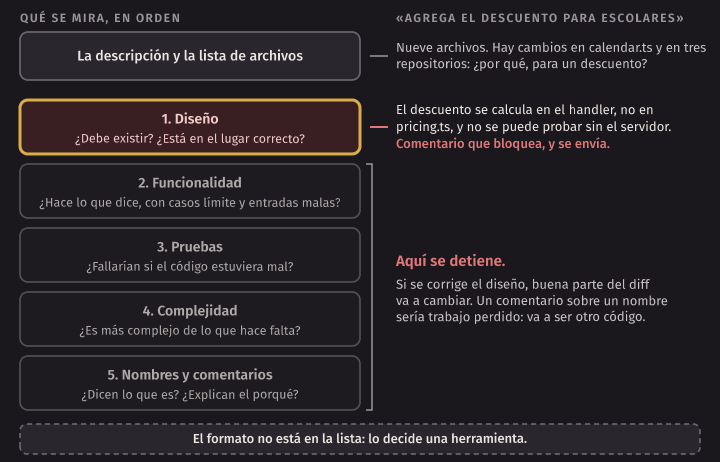
El orden existe por una razón económica. Si el diseño está mal, todo lo demás va a cambiar, y un comentario sobre un nombre habrá sido trabajo perdido, de quien lo escribe y de quien lo atiende. Por eso se empieza leyendo la descripción y mirando el conjunto: qué archivos toca y cuánto. Después, la parte principal. Recién al final, lo demás.
Lo que falta en la lista es a propósito: el formato no lo revisan las personas. Comillas, espacios y saltos de línea los decide una herramienta. SWEG, en el capítulo 20, lo dice de frente: señalar errores de formato no es un buen uso del tiempo de quien revisa.
Las preguntas de cada nivel
Diseño. ¿Esto pertenece a este módulo o a otro? ¿Esta nueva capa esconde algo o solo reenvía (semana 5)? ¿La ruta nueva sigue las convenciones de la API (semana 6)? ¿Hay una decisión que debería estar en un design doc o un ADR?
Funcionalidad. Aquí sirve leer con la especificación al lado, y buscar los
valores que se suelen olvidar: la lista vacía, el texto vacío, el apóstrofe,
el null, el id que no existe, dos solicitudes al mismo tiempo. Y sirve
correr el cambio. Quien revisa puede sacar la rama y probar con curl; a
veces eso toma menos tiempo que razonar.
Pruebas. Para cada prueba, hagan la pregunta de la semana 10: ¿qué mutante mataría? Una prueba que solo mira que la respuesta sea 200 no distingue entre un filtro correcto y uno que no filtra nada. Y fíjense en lo que cambió en las pruebas existentes. Una prueba borrada o aflojada en el mismo pull request que cambia el código es la señal más importante de todo el diff, porque es la que más fácil se pasa: el diff de una prueba eliminada se ve como una limpieza.
Complejidad. La semana 5 dio el vocabulario: amplificación de cambios, carga cognitiva, incógnitas desconocidas. La pregunta práctica es si alguien que llega nuevo entendería esto rápido. Otra señal es la sobreingeniería: un parámetro de configuración para un caso que no existe, una interfaz con una sola implementación “por si acaso”.
Nombres y comentarios. Un nombre bueno evita un comentario. Un comentario bueno dice por qué, no qué. Y si el cambio altera lo que hace la API, el README tiene que decirlo: en Kallpa, la tabla de rutas es un contrato con quienes la llaman.
Un ejemplo de lectura en orden
Imaginen un pull request que dice “Agrega el descuento para escolares” y toca nueve archivos. Una lectura en orden sería así:
- La descripción y la lista de archivos. Hay un cambio en
pricing.ts, esperable. Hay cambios encalendar.tsy en tres repositorios, inesperados. Primera pregunta: ¿por qué tocar el calendario para un descuento? - El diseño. El descuento se calcula dentro del handler, no en
pricing.ts. Eso ya merece un comentario que bloquea: una regla del negocio en la capa HTTP no se puede probar sin levantar el servidor. Si se corrige, buena parte del diff va a cambiar. - Aquí se detiene. Quien revisa deja ese comentario y lo envía. No sigue con los nombres de las variables: va a ser otro código. Google recomienda justamente esto: si la parte principal tiene un problema grande de diseño, se avisa de inmediato, porque quien escribió el cambio puede estar construyendo otro encima.
Error común. Discutir de estilo lo que una herramienta podría decidir, mientras pasa sin comentarios el
ifque tiene la condición al revés. Son doce comentarios sobre comillas y ninguno sobre lo que el código hace. Es natural: el estilo se ve sin pensar, y la lógica cuesta. Si en su equipo los comentarios de formato son frecuentes, no necesitan revisores más estrictos; necesitan un formateador en el pipeline.
Cambios pequeños y respuestas rápidas
Por qué chicos
Small CLs da un orden de magnitud, y aclara que no es una regla exacta: 100 líneas suele ser un tamaño razonable, y 1000 líneas suele ser demasiado, aunque la decisión es de quien revisa. Importa también cuán repartido está: un cambio de 200 líneas en un archivo puede estar bien, y las mismas 200 líneas en 50 archivos suelen ser demasiado.
Las razones son concretas:
- Un cambio pequeño se revisa mejor: quien revisa encuentra más problemas y no se rinde. Uno de 1000 líneas se aprueba sin leer, o espera días hasta que alguien tenga una tarde libre.
- Se integra antes, y por eso produce menos conflictos de merge.
- Es más fácil de revertir, y más fácil de entender cuando alguien mira la historia para saber por qué algo cambió.
Recuerden el dato del estudio: en Google, la mediana es de 24 líneas. Un equipo puede mover mucho código sin hacer nunca un cambio grande.
Cómo se divide
Se divide por lo que se puede revisar y dejar en main sin romper nada:
- Por capas. Primero el módulo de dominio con sus pruebas, después el
repositorio, después el endpoint. Cada uno pasa
make checksolo. - Por slices verticales. Un caso completo primero (reservar un turno fijo), y los demás después (cancelarlo, editarlo).
- Refactoring aparte. Si hace falta mover código, se mueve en un pull request que no cambia el comportamiento y se integra primero. Así quien revisa el segundo ve solo lo nuevo. La semana 5 vio por qué: un refactoring se comprueba con las pruebas sin cambios, y eso es imposible si se mezcla con una funcionalidad.
- Pruebas y código juntos. Dividir por archivos de prueba y de código no sirve de nada: la prueba es parte de lo que se revisa.
Lo que le toca a cada uno
Quien escribe el cambio:
- Lo mantiene chico y con un solo propósito.
- Escribe una descripción que dice qué cambia y por qué, porque el diff solo dice cómo. The CL author’s guide da el formato: una primera línea que se entiende sola, y un cuerpo con el contexto.
- Se revisa a sí mismo antes de pedir revisión: lee su propio diff en GitHub, como lo leería otra persona. Es sorprendente lo que se encuentra.
- Corre
make check. Pedirle a alguien que lea un cambio que no compila es gastarle el tiempo.
Comparen estas dos descripciones del mismo pull request:
Arreglos variosAgrega el total de horas a la caja del día por cancha
La administración cuenta las horas a mano para pagarle al personal de limpieza.
El dato ya se calculaba para todo el complejo; ahora GET /api/reports/daily lo
da también por cancha. No cambia nada de lo que ya respondía la ruta.
Cómo probarlo: test/report.test.ts, "cuenta las horas de cada cancha".Quien revisa responde rápido. La guía de Google pone un máximo de un día hábil para responder, porque un pull request esperando bloquea a alguien, y quien espera empieza otra cosa o junta más cambios en el mismo. Responder rápido no significa aprobar rápido: es dar la primera respuesta pronto. También significa no interrumpir lo que se está haciendo: se revisa en la siguiente pausa natural.
En la industria. En el estudio de Sadowski y otros, la mediana de latencia de toda la revisión en Google fue de menos de 4 horas. Los autores la comparan con las medianas de tiempo hasta la aprobación que Rigby y Bird reportaron para AMD, Chrome OS y proyectos de Microsoft, entre 14.7 y 19.8 horas. Aparte, la primera respuesta en Google tuvo una mediana de menos de una hora para los cambios pequeños y de unas 5 horas para los muy grandes. Son empresas y procesos distintos: sirven para ver un orden de magnitud, no para comparar con precisión. Un equipo de cuatro personas no necesita esa velocidad. Sí necesita que nadie espere una semana.
Comentarios que sirven
Cuatro reglas
La guía de Google, en How to write code review comments, y SWEG coinciden en lo esencial:
- Sobre el código, no sobre la persona. “Esta función no cierra la conexión” y no “te olvidaste de cerrar la conexión”. SWEG insiste en que el trato sea cortés y profesional, y en que recibir comentarios es parte normal del trabajo, no un juicio.
- Con el porqué. Un comentario sin razón obliga a obedecer o a preguntar, y no enseña nada para la próxima vez.
- Con una sugerencia concreta cuando se puede. No siempre: a veces lo mejor es señalar el problema y dejar que quien lo escribió elija la solución, porque conoce mejor el código.
- Con la severidad marcada. ¿Es un requisito para aprobar, o una idea? Si no se dice, quien lo lee tiene que adivinar, y suele asumir lo peor.
Conventional Comments
Conventional Comments es una convención para hacer explícita la intención. El formato es:
<etiqueta> [decoraciones]: <asunto>

[explicación]
Estas son las etiquetas que más se usan en el curso:
| Etiqueta | Qué dice |
|---|---|
issue: |
Un problema concreto. Se recomienda acompañarlo de una sugerencia |
suggestion: |
Propone una mejora, y dice por qué lo es |
question: |
Hay una duda, y quien pregunta no sabe si es un problema |
nitpick: |
Un detalle menor de preferencia; por naturaleza no bloquea |
praise: |
Algo bien hecho, de verdad. Sin elogios falsos |
todo: |
Un cambio pequeño y necesario |
Las decoraciones agregan contexto: (blocking) o (non-blocking) dicen si
impide el merge, y otras indican el tema, como (security) o (test).
Vean la diferencia con un comentario sobre Kallpa:
Esto está mal, así no se hace.issue (blocking): este SQL arma la consulta con el texto del usuario.
Con ?team=' UNION SELECT ... se puede leer cualquier tabla (lo probé con curl en
la rama). La guía del curso pide sentencias preparadas. Sugerencia:
.prepare("... WHERE team_name LIKE '%' || ? || '%'").all(team)El segundo dice dónde, qué pasa, cómo lo comprobó, qué regla aplica, qué hacer y que bloquea. El primero no dice nada de eso. Y estos dos no tienen nada malo:
nitpick (non-blocking): `result` no dice mucho aquí; `matches` se leería mejor.question: ¿esta consulta usa algún índice? Con pocas reservas da igual, pero no
sé cuántas espera tener el complejo en un año.praise: la prueba de la lista vacía encontró un caso en el que yo no había pensado.El praise: no es adorno. Una revisión que solo enumera defectos enseña menos
que una que también señala lo que vale la pena copiar. Y la herramienta da lo
mismo: en Google se usa Nit: y en su equipo pueden elegir otra convención.
Lo que importa es que sea siempre clara la severidad.
Cuando no se ponen de acuerdo
La guía de Google da un orden: primero intentar llegar a un consenso con la guía en la mano; si cuesta, una reunión o una videollamada; y si no se resuelve, escalar (al equipo, a quien lidera técnicamente, a quien mantiene ese código). Y el resultado de la conversación se escribe en el pull request, para quien lo lea después.
En este curso usamos una regla simple: si un desacuerdo no se resuelve en dos idas y vueltas, se conversa en persona o en una llamada. Es una regla práctica nuestra, no de Google. Una discusión escrita sobre una línea rara vez termina bien después de la tercera respuesta, y diez minutos de conversación suelen alcanzar. El peor resultado es el que la guía advierte: que el pull request se quede parado porque nadie cede.
Con IA. Hay herramientas que comentan pull requests automáticamente. Úsenlas como un revisor más: encuentran ciertos errores y producen también comentarios equivocados o irrelevantes, y su tasa de avisos útiles se mide igual que la de cualquier otro analizador (ver falsos positivos efectivos, más abajo). Traten cada comentario como una pregunta que hay que comprobar, no como una decisión. No reemplazan la aprobación: quien aprueba tiene que entender el cambio y responder por él, y una herramienta no responde por nada. En P3, la revisión que cuenta es la de una persona.
Análisis estático: razonar sin ejecutar
Qué es
SWEG define el análisis estático como programas que analizan el código fuente para encontrar problemas posibles, como errores, malas prácticas y otros que se pueden diagnosticar sin ejecutar el programa. Lo opuesto es el análisis dinámico: las pruebas, el fuzzing y los mutantes de la semana pasada, que sí ejecutan el código.
Hay una ventaja fundamental: el análisis estático mira todos los caminos, incluso los que ninguna prueba recorre. Y una desventaja igual de fundamental, que veremos en un momento: no sabe con certeza qué va a pasar al ejecutarlo.
De menos a más profundo
Las herramientas se pueden ordenar según cuánto entienden del programa:
| Nivel | Qué mira | Ejemplo | Qué encuentra |
|---|---|---|---|
| Formateador | El texto | Prettier | Nada: reescribe. Elimina las discusiones de formato |
| Linter | Patrones locales del árbol sintáctico | ESLint con reglas sin tipos | Una variable sin usar, un ==, un catch vacío |
| Type checker | Los tipos de todo el programa | tsc |
Un método que no existe, un undefined donde va un string |
| Linter con tipos | Los patrones más los tipos | typescript-eslint con strictTypeChecked |
Una promesa que nadie espera |
| Flujo de datos | Cómo viaja un valor por el programa | Analizadores de seguridad como CodeQL | Un texto del usuario que llega a una consulta SQL |
Cada nivel cuesta más tiempo y da más información. Un formateador tarda milisegundos; un análisis de flujo de datos de todo un repositorio puede tomar minutos. Por eso las herramientas de abajo suelen correr en el pipeline y las de arriba, también en el editor.
Por qué todas aproximan
Todo el mundo querría una herramienta que dijera exactamente qué programas tienen un error. No puede existir, y la razón es un resultado de teoría de la computación: el teorema de Rice (Henry Rice, 1953).
Teorema de Rice. Toda propiedad no trivial del comportamiento de los programas es indecidible. No trivial quiere decir que algunos programas la cumplen y otros no. Indecidible quiere decir que no existe un algoritmo que, para todo programa, termine y responda correctamente si la cumple.
Tres palabras importan aquí. Comportamiento: lo que el programa hace al
correr, no cómo está escrito. “Tiene una variable llamada x” se puede
decidir leyendo; “alguna vez divide entre cero” no. Todo: se puede
responder bien para muchos programas; lo imposible es responder bien para
todos. Termine: una herramienta que no termina no sirve de analizador.
La intuición se puede ver con un ejemplo. Supongan que tienen un analizador perfecto que decide si una función llega a lanzar un error. Denle esta:
function reaches(n: number): void {
  while (n !== 1) n = n % 2 === 0 ? n / 2 : 3 * n + 1;
  throw new Error('llegó');
}
Para responder si llega a lanzar el error con todo entero positivo n, el
analizador tendría que saber si este ciclo termina siempre. Esa es la
conjetura de Collatz, un problema abierto de la matemática. En general, el
mismo truco permite convertir cualquier pregunta “¿este programa termina?” en
una pregunta “¿llega a esta línea?”, y Alan Turing demostró en 1936 que la
primera no tiene solución general. Si la herramienta perfecta existiera,
también la tendría.
Eso no quiere decir que el análisis estático no sirva. Quiere decir que cada herramienta elige de qué lado equivocarse:
| La herramienta avisa | La herramienta no avisa | |
|---|---|---|
| Hay un error | Verdadero positivo | Falso negativo |
| No hay error | Falso positivo | Verdadero negativo |
- Falso positivo: avisa algo que no es un error.
- Falso negativo: no avisa un error que sí está.
Una herramienta que nunca da falsos negativos, para la propiedad que revisa, se llama sólida (sound). Una que nunca da falsos positivos se llama completa en la jerga de los analizadores. Rice dice que, para una propiedad no trivial de un lenguaje como TypeScript, una herramienta que siempre termina no puede ser las dos cosas a la vez. En la práctica, casi todas las herramientas dan los dos tipos de error, porque tratar de ser sólida a toda costa produce demasiados avisos falsos.
TypeScript es un caso interesante porque no es sólido a propósito: any y
as le dicen al compilador que no revise, y el sistema de tipos acepta
programas que fallan al correr, para poder describir el JavaScript que ya
existe. Si tsc no da errores, no se puede concluir que no hay errores de
tipos al ejecutar. Se puede concluir algo más modesto: no encontró ninguno de
los que busca, en el código en el que no se le pidió mirar a otro lado.
Los dos errores en un mismo archivo
code/week-11/ejemplos/first-item.ts tiene dos funciones que pasan strict:
type Slot = { date: string };

// Se cae con una lista vacía: sin la opción, un falso negativo.
export function firstDate(slots: readonly Slot[]): string {
  return slots[0].date;
}

// Nunca se cae, porque split siempre devuelve al menos un elemento: con la
// opción, un falso positivo.
export function firstPart(text: string): number {
  return text.split('-')[0].length;
}
Con strict, tsc no dice nada, y firstDate([]) lanza un TypeError al
correr: un falso negativo. Prendamos la opción noUncheckedIndexedAccess:
$ tsc --ignoreConfig --noEmit --strict --target es2024 --module nodenext --types node \
    --skipLibCheck --noUncheckedIndexedAccess ejemplos/first-item.ts
ejemplos/first-item.ts(7,10): error TS2532: Object is possibly 'undefined'.
ejemplos/first-item.ts(13,10): error TS2532: Object is possibly 'undefined'.(--ignoreConfig le dice a tsc que no use el tsconfig.json de la carpeta,
ya que aquí le pasamos un archivo). El error de la línea 7 es un acierto. El
de la línea 13 es un falso positivo: String.split con un separador
siempre devuelve al menos un elemento, pero el tipo string[] no lo dice. La
opción sacrificó precisión por seguridad: cambió un falso negativo por un
falso positivo, y a cambio ya no se le escapan las listas vacías. Decidir si
ese intercambio conviene es un juicio de ingeniería. Con esta opción, en
Kallpa conviene.
Una regla, sus dos errores y lo que dicen sobre la profundidad
Hagamos un analizador nosotros mismos. code/week-11/eslint.sql.js configura
la regla no-restricted-syntax de ESLint para que avise cuando prepare()
recibe un template string con ${...}:
{
  selector: "CallExpression[callee.property.name='prepare'] > TemplateLiteral[expressions.length>0]",
  message: 'SQL armado con un template: usen parámetros (?).',
}
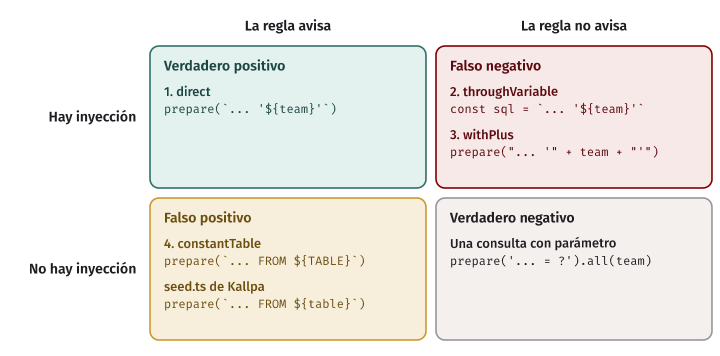
ejemplos/sql-shapes.ts tiene cuatro funciones: la 1 (direct, línea 9), la
2 (throughVariable) y la 3 (withPlus) son la misma inyección SQL escrita
de tres maneras; la 4 (constantTable, línea 26) es correcta, porque lo que
interpola es una constante del programa. El resultado:
$ eslint --no-config-lookup -c eslint.sql.js ejemplos/sql-shapes.ts

/work/code/week-11/ejemplos/sql-shapes.ts
   9:21  error  SQL armado con un template: usen parámetros (?)  no-restricted-syntax
  26:21  error  SQL armado con un template: usen parámetros (?)  no-restricted-syntax

✖ 2 problems (2 errors, 0 warnings)
Tiene dos falsos negativos (las funciones 2 y 3) y un falso positivo (la función 4). Y sobre Kallpa publicada da un solo aviso, que también es falso:
/work/code/week-11/build/medir/src/seed.ts
  18:46  error  SQL armado con un template: usen parámetros (?)  no-restricted-syntax
Es SELECT COUNT(*) AS n FROM ${table}, en el programa que carga los datos de
ejemplo. table siempre es 'courts', 'members' o 'bookings': nadie de
afuera llega ahí.
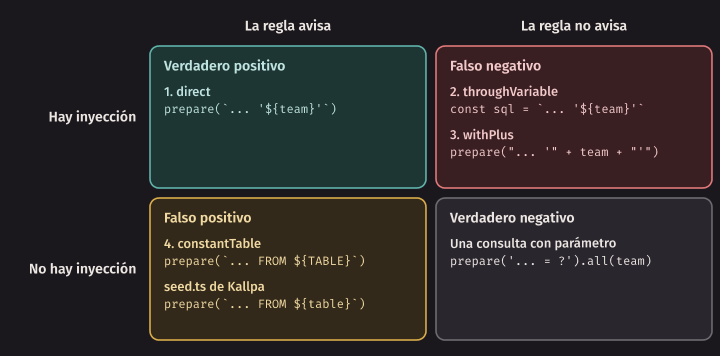
La regla mira la forma del código y no lo que pasa con los datos. Para no
tener esos errores habría que seguir el valor desde que entra por
url.searchParams hasta que llega a prepare, atravesando variables y
funciones. Eso hace un analizador de flujo de datos, como las consultas de
seguridad de CodeQL; y aun así, Rice sigue vigente: tiene que modelar qué
bibliotecas son fuentes y destinos de datos, y qué funciones limpian un valor.
Más profundidad reduce los errores; no los elimina.
¿La regla sirve, entonces? Sí: es barata y detecta la forma más común del problema, y su falso positivo en Kallpa se justifica en una línea. Pero no se puede concluir de su silencio que no hay inyección.
Idea clave. “La herramienta no dijo nada” no significa “no hay problema”. Significa “no encontró lo que sabe buscar, de la forma en que lo sabe buscar”. Antes de confiar en un resultado limpio, pregunten qué tipos de error está diseñada para ver.
Lo que Google aprendió con Tricorder
Si las herramientas se equivocan de las dos formas, ¿cómo se logra que un equipo las use? El capítulo 20 de SWEG, escrito por Caitlin Sadowski, cuenta lo que Google aprendió con Tricorder, su plataforma de análisis estático.
Falso positivo efectivo
La idea central cambia la pregunta. Un falso positivo técnico es un aviso que no corresponde a un error. Pero eso no es lo que le importa a quien desarrolla. Por eso Google usa otra medida:
Falso positivo efectivo. Un aviso es un falso positivo efectivo si quien desarrolla no hace nada después de verlo, cualquiera que sea el motivo.
La definición funciona en las dos direcciones:
- Si la herramienta reporta un error real, pero el mensaje es confuso o el problema no importa, y nadie hace nada: es un falso positivo efectivo. Técnicamente tenía razón; en la práctica, no sirvió.
- Si la herramienta se equivoca técnicamente, pero quien desarrolla lo arregla
de todas formas porque el código queda más claro: no es un falso
positivo efectivo. SWEG da un ejemplo: en Java,
containsen una tabla hash es lo mismo quecontainsValue, aunque casi siempre se queríacontainsKey. Aunque el código fuera correcto, escribircontainsValuelo aclara.
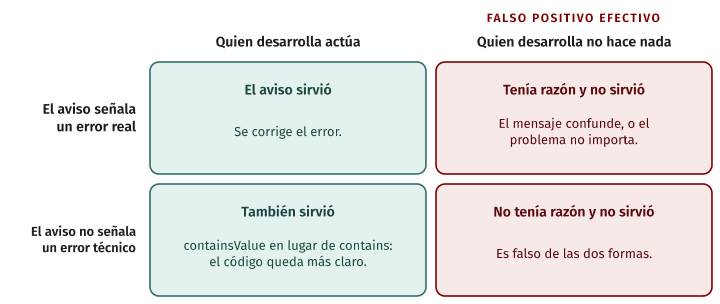
¿Por qué importa más que el técnico? Porque mide lo que decide si la herramienta sobrevive. Si la tasa es alta, quien desarrolla aprende que los avisos no valen el tiempo y deja de leerlos todos, incluidos los verdaderos. Un aviso ignorado no protege a nadie.
Las reglas de Tricorder
SWEG pide cuatro criterios para que un chequeo entre en Tricorder:
- Se entiende: cualquier persona entiende el mensaje.
- Se puede actuar y corregir con facilidad, con una guía de cómo hacerlo.
- Menos de 10 % de falsos positivos efectivos. Dicho al revés: quien desarrolla debe sentir que el chequeo señala un problema real al menos el 90 % de las veces.
- Puede tener un impacto significativo en la calidad del código.
Y agrega cuatro prácticas:
- Los resultados aparecen en la revisión de código, donde se puede actuar, y no en un reporte aparte que nadie abre. Mostrarlos ahí además obliga a convencer a quien revisa si se quiere ignorar un aviso.
- Se muestran los avisos nuevos, en las líneas que el cambio toca. Quien desarrolla tiene el contexto fresco, y no se le pide arreglar código viejo que funciona. Arreglar una advertencia también puede introducir un error; por eso los avisos antiguos solo valen la pena si son importantes.
- Una corrección sugerida cuando se puede. Lo que se puede arreglar automáticamente, se arregla automáticamente, en especial el estilo.
- Un botón de “no es útil” que llega a quien mantiene la regla. El equipo de Tricorder sigue las reglas con muchos clics y las desactiva si no mejoran. SWEG cuenta que, a veces, la solución es tan simple como cambiar el mensaje: una regla de Error Prone recibía reclamos semanales hasta que su texto explicó bien el problema, y entonces cesaron.
El mismo capítulo agrega algo sobre los compiladores: Google evita mostrar advertencias, porque comprobó una y otra vez que se ignoran. Un chequeo es un error que rompe el build o no se muestra en la salida del compilador. Y antes de activar uno que rompe el build, se limpian todos los casos existentes.
En la industria. SWEG reporta que Tricorder incluye más de 100 analizadores para más de 30 lenguajes, con una tasa global de falsos positivos efectivos de algo menos de 5 %, y que quienes revisan hacen clic en “Please fix” miles de veces al día, frente a unos 250 clics diarios en “Not useful”. Son cifras que Google reporta sobre sí mismo, medidas con sus clics, con su infraestructura y a su escala: no hay un experimento que compare contra otro enfoque. Lo que se traslada no es el 5 %, sino el método: medir si la gente actúa sobre los avisos, y retirar las reglas que no pasan esa prueba.
Lleven eso a un equipo de cuatro personas: no hay botón ni plataforma, pero sí
hay decisiones. Pocas reglas que valen la pena. Todo en el pipeline, para que
aparezca en el pull request. Sin advertencias que no fallan: si una regla no
merece romper el build, se apaga o se configura. P3 pide exactamente esto, con
eslint . --max-warnings 0.
TypeScript como análisis estático
Lo que strict activa y lo que no
"strict": true es un grupo de opciones. Entre ellas, strictNullChecks, que
hace que null y undefined no se puedan usar donde va otro tipo, y
noImplicitAny, que no deja que una variable sin tipo se vuelva any en
silencio. Kallpa y P3 las exigen.
Hay opciones más estrictas fuera de strict, que hay que pedir una por una.
Esta semana usamos dos.
noUncheckedIndexedAccess
Sin esta opción, items[0] tiene tipo T, aunque la lista esté vacía. Con
ella, tiene tipo T | undefined, y el compilador obliga a manejar ese caso.
Vale también para los objetos usados como diccionario (Record<string, string>) y para la desestructuración de arreglos.
En Kallpa publicada, agregar la opción da estos errores:
$ make typecheck
tsc -p .
src/domain/calendar.ts(15,19): error TS2769: No overload matches this call.
  Overload 1 of 2, '(year: number, monthIndex?: number | undefined, date?: number | undefined, hours?: number | undefined, minutes?: number | undefined, seconds?: number | undefined, ms?: number | undefined): number', gave the following error.
    Argument of type 'number | undefined' is not assignable to parameter of type 'number'.
      Type 'undefined' is not assignable to type 'number'.
  Overload 2 of 2, '(year: number, monthIndex: number, date?: number | undefined, hours?: number | undefined, minutes?: number | undefined, seconds?: number | undefined, ms?: number | undefined): number', gave the following error.
    Argument of type 'number | undefined' is not assignable to parameter of type 'number'.
      Type 'undefined' is not assignable to type 'number'.
src/domain/calendar.ts(15,25): error TS18048: 'month' is possibly 'undefined'.
src/http/router.ts(59,9): error TS18048: 'expected' is possibly 'undefined'.
src/http/router.ts(60,14): error TS18048: 'expected' is possibly 'undefined'.
src/http/router.ts(60,54): error TS2345: Argument of type 'string | undefined' is not assignable to parameter of type 'string'.
  Type 'undefined' is not assignable to type 'string'.
src/store/database.ts(53,15): error TS2345: Argument of type 'string | undefined' is not assignable to parameter of type 'string'.
  Type 'undefined' is not assignable to type 'string'.
src/store/seed.ts(85,45): error TS18048: 'court' is possibly 'undefined'.
src/store/seed.ts(85,116): error TS18048: 'member' is possibly 'undefined'.
test/http.test.ts(54,18): error TS2532: Object is possibly 'undefined'.
make: *** [Makefile:28: typecheck] Error 2
Son 9
errores en 5 archivos. ¿Hay algún error real ahí? Uno por uno, casi ninguno se
manifiesta hoy: date.split('-') recibe una fecha ya validada,
MIGRATIONS[version] está dentro de los límites del ciclo. Son falsos
positivos en este momento, y aun así vale la pena atenderlos, porque cada uno
es un lugar donde el código supone algo sin decirlo. Si mañana esa suposición
deja de ser cierta, el compilador ya no está mirando.
Cómo se corrige, y cómo no
Tomemos la función firstDate. Hay tres formas buenas de corregirla:
// 1. Una guarda: se decide qué pasa si no hay nada.
export function firstDate(slots: readonly Slot[]): string {
  const first = slots[0];
  if (first === undefined) throw new Error('No hay horarios.');
  return first.date;
}

// 2. Un valor por omisión, si existe uno razonable.
export function firstDateOrNone(slots: readonly Slot[]): string {
  return slots[0]?.date ?? 'sin fecha';
}

// 3. Un cambio de estructura: la indexación desaparece.
export function allDates(slots: readonly Slot[]): string[] {
  return slots.map((slot) => slot.date);
}
La tercera es, muchas veces, la mejor: un ciclo for (let i = 0; ...) con
items[i] se puede reescribir con for...of o .entries(), y ya no hay
índice que pueda quedar fuera de los límites. Queda de ejercicio para el
laboratorio ver dónde conviene cada una en Kallpa.
Y esta no es una forma de corregirla:
return slots[0]!.date;El ! no comprueba nada. Le dice al compilador “confía en mí, esto no es
undefined”, se borra al quitar los tipos, y firstDate([]) se sigue cayendo
igual. Es apagar el aviso y dejar el error. Si la suposición es cierta y se
puede explicar, una guarda con un mensaje la documenta y además la comprueba
al correr.
exactOptionalPropertyTypes
Con strict, una propiedad opcional note?: string acepta tanto que no esté
como que valga undefined. Pero esas dos cosas no son iguales.
ejemplos/optional.ts:
export type Options = { note?: string };

export const missing: Options = {};
export const explicit: Options = { note: undefined };

// Para quien lee el objeto no es lo mismo.
export function keys(options: Options): string[] {
  return Object.keys(options);
}
keys(missing) devuelve [] y keys(explicit) devuelve ['note']. Con la
opción, el segundo objeto no compila:
ejemplos/optional.ts(5,14): error TS2375: Type '{ note: undefined; }' is not assignable to type 'Options' with 'exactOptionalPropertyTypes: true'. Consider adding 'undefined' to the types of the target's properties.
  Types of property 'note' are incompatible.
    Type 'undefined' is not assignable to type 'string'.
Hay diferencias que se
notan al correr: JSON.stringify omite las dos, pero Object.keys, in y el
operador ... las distinguen; y al mezclar opciones con { ...defaults, ...options }, un undefined explícito pisa el valor por omisión. En
Kallpa, esta opción da un solo error, en test/helpers.ts, y está en el paso
3 del laboratorio.
Linting con tipos
Qué agrega
Un linter común ve la forma de cada archivo. No sabe qué devuelve una función
que está en otro archivo: para eso necesita los tipos. typescript-eslint tiene
configuraciones compartidas que los usan: recommendedTypeChecked y
strictTypeChecked. Se activan con un bloque de configuración:
{
  languageOptions: {
    parserOptions: { projectService: true, tsconfigRootDir: import.meta.dirname },
  },
}
projectService: true le pide al servicio de TypeScript el tipo de cada
archivo. La documentación avisa del costo: hay que hacer algo equivalente a un
build antes de correr las reglas, así que son más lentas. Y la página de
configuraciones advierte que strictTypeChecked no es estable según semver:
sus reglas pueden cambiar sin una versión mayor, y se recomienda para equipos
en los que una parte importante domina TypeScript. En un curso es un buen
ejercicio; en un equipo, es una decisión.
Lo que encuentra
ejemplos/promises.ts tiene dos errores clásicos que tsc acepta:
export async function saveAudit(line: string, saved: string[]): Promise<void> {
  await Promise.resolve();
  if (line === '') throw new Error('Línea vacía.');
  saved.push(line);
}

// forEach no espera a una función async: al volver, todavía no se guardó nada.
export function saveAll(lines: string[], saved: string[]): number {
  lines.forEach(async (line) => {
    await saveAudit(line, saved);
  });
  return saved.length;
}

// Nadie espera a saveAudit: un error ahí no pasa por este try/catch.
export function confirm(line: string, saved: string[]): string {
  try {
    saveAudit(line, saved);
    return 'confirmada';
  } catch {
    return 'falló';
  }
}
La configuración de Kallpa, sin tipos, no dice nada. Con tipos:
$ eslint -c eslint.estricto.js ejemplos/promises.ts

/work/code/week-11/ejemplos/promises.ts
  10:17  error  Promise returned in function argument where a void return was expected                                                                                              @typescript-eslint/no-misused-promises
  19:5   error  Promises must be awaited, end with a call to .catch, end with a call to .then with a rejection handler or be explicitly marked as ignored with the `void` operator  @typescript-eslint/no-floating-promises

✖ 2 problems (2 errors, 0 warnings)
No son manías de estilo. saveAll(['a', 'b'], saved) devuelve 0, porque
vuelve antes de guardar. Y confirm('', []) responde confirmada y después
el error, que nadie atrapa, termina todo el proceso:
$ node --input-type=module -e "import { confirm } from './ejemplos/promises.ts'; console.log(confirm('', []));"
confirmada
file:///work/code/week-11/ejemplos/promises.ts:4
  if (line === '') throw new Error('Línea vacía.');
                         ^

Error: Línea vacía.
    at saveAudit (file:///work/code/week-11/ejemplos/promises.ts:4:26)

Node.js v26.13.0
En un servidor, eso significa que una solicitud puede tumbar a todas las
demás. En Kallpa no pasa, porque server.ts envuelve el handler en un
try/catch con await.
Vale señalar que tsc no es del todo ciego a las promesas. Una promesa como
condición (isOpen() ? 'sí' : 'no', sin await) da error TS2801, porque el
compilador sabe que una promesa siempre es verdadera. La frontera entre lo que
revisa el compilador y lo que revisa el linter se mueve con cada versión. Lo
que no se mueve es comprobarlo en vez de suponerlo.
Las familias de reglas que más van a ver:
| Regla | Qué encuentra |
|---|---|
no-floating-promises |
Una promesa que nadie espera ni maneja |
no-misused-promises |
Una función async donde se espera una que no devuelve nada |
no-unsafe-* |
Un any que se propaga: se accede, se llama, se asigna o se devuelve |
no-unnecessary-condition |
Una condición que, según los tipos, siempre da lo mismo |
restrict-template-expressions |
Un template string con un valor que no debería convertirse a texto |
no-non-null-assertion |
Un ! |
Lo que da en Kallpa
Con strictTypeChecked, sin ajustar nada, Kallpa da 105 errores:
$ make medir
...
--- noUncheckedIndexedAccess
9
--- exactOptionalPropertyTypes
1
--- strictTypeChecked, por regla
     46 @typescript-eslint/no-floating-promises
     21 @typescript-eslint/restrict-template-expressions
     18 @typescript-eslint/no-unsafe-member-access
      8 @typescript-eslint/no-unsafe-assignment
      4 @typescript-eslint/no-unsafe-call
      2 @typescript-eslint/no-unnecessary-condition
      2 @typescript-eslint/no-non-null-assertion
      1 @typescript-eslint/restrict-plus-operands
      1 @typescript-eslint/no-unsafe-return
      1 @typescript-eslint/no-unsafe-argument
      1 @typescript-eslint/no-misused-promises
Un número así asusta, y por eso hay que agruparlo por regla antes de leerlo:
el laboratorio lo hace con eslint . -f json | jq .... Separados por carpeta,
el panorama cambia: 26 están en src/ y 79 en test/. Y los 46 de
no-floating-promises están todos en test/:
describe('precios', () => {        // error: Promises must be awaited...
  test('una hora de fulbito...', () => { ... });
test() y describe() de node:test devuelven promesas, y el runner ya las
maneja. Son falsos positivos, los 46: el ejemplo perfecto de por qué se
empieza mirando por regla. Si alguien abre la lista sin agrupar, ve una pared
de 46 errores falsos, concluye que la regla no sirve y la apaga también para
src/, donde sí sirve.
Las dos herramientas se alimentan
Un detalle que vale la pena ver. En src/http/static-files.ts, la regla dice:
/work/code/week-11/build/medir/src/http/static-files.ts
  17:7  error  Unnecessary conditional, the types have no overlap  @typescript-eslint/no-unnecessary-condition

✖ 1 problem (1 error, 0 warnings)
Es este código:
const entry = FILES[pathname];
if (entry === undefined) return false;
FILES es un Record<string, ...>, y sin noUncheckedIndexedAccess, el tipo
dice que indexar siempre da un valor. Según los tipos, la condición es inútil.
Pero pathname puede ser cualquier ruta, y serveStatic se llama en cada
GET: si le hacen caso a la regla y borran esa línea, entry.file lanza un
error con toda ruta que no sea un archivo, y la API entera responde 500. Es un
falso positivo causado por un tipo demasiado optimista.
Si se activa noUncheckedIndexedAccess, ese aviso desaparece, porque el tipo
ya dice la verdad. Pero aparecen 5 avisos nuevos de
restrict-template-expressions: los template strings que usan params.id (en
handlers.ts) y las partes de la fecha (en clock.ts), que ahora son string | undefined. En total, 109 avisos en vez de 105. Es razonable: al mentir
menos, los tipos muestran lugares nuevos que revisar.
Por eso el laboratorio hace primero los tipos y después el linter.
Una trampa en la configuración
strictTypeChecked prohíbe incluso números en un template string: 15 de los 19
avisos de restrict-template-expressions en src/ son cosas como No existe la cancha ${id}, o constantes como CLOSING_HOUR. Un número siempre se ve
bien en un texto, así que parece razonable permitirlos con allowNumber. Pero
miren lo que pasa:
| Configuración de la regla | Avisos en src/ |
|---|---|
La de strictTypeChecked |
19 |
{ allowNumber: true } |
0 |
{ allowNumber: true } y además allowAny, allowBoolean, allowNullish, allowRegExp y allowNever en false |
4 |
Las opciones que se pasan reemplazan a las de la configuración compartida,
y las demás vuelven a su valor por omisión, que es permisivo. Con { allowNumber: true }, también dejó de avisar sobre los string | undefined.
Los 4 que quedan son justamente valores que pueden ser undefined
(env.PORT, req.method, req.url). Quien mide cuántos avisos da una regla
después de configurarla lo ve; quien no mide, se queda con una regla casi
apagada y un comentario que dice otra cosa.
Las fronteras del programa
Lo que llega de afuera
Todo el análisis anterior depende de que los tipos digan la verdad. Dentro del programa, el compilador lo comprueba. Pero hay lugares donde el dato viene de afuera y el compilador no puede saber qué trae: un cuerpo JSON, una fila de la base de datos, una variable de entorno, un archivo. A esos lugares los llamamos las fronteras del programa.
La regla es: lo que llega de afuera se tipa como unknown y se revisa antes
de usarlo. unknown es lo contrario de any: acepta cualquier valor, y no
deja hacer nada con él hasta comprobar qué es. ejemplos/cast-lie.ts muestra
las dos formas:
export type Draft = { courtId: number; date: string };

export function parseWithCast(text: string): Draft {
  return JSON.parse(text) as Draft;
}

export function parseChecked(text: string): Draft {
  const value: unknown = JSON.parse(text);
  if (typeof value !== 'object' || value === null) throw new Error('Se esperaba un objeto.');
  if (!('courtId' in value) || typeof value.courtId !== 'number') throw new Error('Falta courtId.');
  if (!('date' in value) || typeof value.date !== 'string') throw new Error('Falta date.');
  return { courtId: value.courtId, date: value.date };
}
Con '{"courtId":"uno"}', parseWithCast devuelve un objeto cuyo courtId
es el texto "uno", aunque su tipo diga number. El error no aparece ahí:
aparece más lejos, cuando alguien use ese número. parseChecked lanza un
error en la frontera, y además descarta los campos que no pidió.
Un as o un ! no comprueba nada: le dicen al compilador “confía en mí”.
Cada uno es un lugar donde el tipo puede mentir. No siempre está mal, pero
siempre merece una mirada.
Las fronteras de Kallpa
Kallpa hace bien la frontera HTTP: readJson devuelve Promise<unknown>, y
parseBookingRequest revisa cada campo. La de la base de datos es otra historia. Hay 14 as en src/, sin contar
as const. Para contarlos usamos el árbol sintáctico (eslint.fronteras.js):
un grep de as confunde palabras, y uno más fino se pierde formas como
(SPORTS as readonly string[]).
$ make fronteras
      1 src/domain/court.ts
      2 src/http/handlers.ts
      1 src/seed.ts
      4 src/store/booking-repository.ts
      2 src/store/court-repository.ts
      1 src/store/database.ts
      2 src/store/member-repository.ts
      1 src/store/seed.ts
La mayoría tiene esta forma:
findById(id: number): BookingRow | undefined {
  return this.#db.prepare('SELECT * FROM bookings WHERE id = ?').get(id) as BookingRow | undefined;
}
¿Es un problema? Es un compromiso razonable. node:sqlite devuelve filas sin
un tipo preciso; el as en el repositorio dice “esta consulta devuelve estas
columnas”, y queda en un solo módulo. Si el esquema cambia y nadie actualiza
el tipo, el compilador no lo verá. Las pruebas de la API sí pueden verlo.
Compárenlo con row.status as BookingStatus en handlers.ts: ahí se está
diciendo algo sobre el contenido de la columna, que es texto libre según el
esquema. Si alguna vez entra un 'pending', el tipo mentirá en toda la
aplicación.
En una revisión, esto se traduce en un hábito: ante cada as, !, any o
eslint-disable nuevo, pregunten qué lo garantiza. Si la respuesta está
en un comentario o en una comprobación cercana, bien. Si no hay respuesta, es
un question:.
Error común. Silenciar el aviso en vez de entenderlo: un
!, unas, un// eslint-disable-next-linesin explicación. El aviso desaparece, el problema sigue ahí, y además ya nadie lo va a volver a señalar. Un bueneslint-disablelleva la razón al lado, y un revisor la puede discutir. Kallpa tiene uno solo, entest/helpers.ts, con su comentario. Y existe el error contrario: activar de golpe cien reglas en un proyecto existente. Nadie lee cien avisos con atención: se silencian en masa, o se abandona todo.
Adoptar reglas sin romper el proyecto
¿Cómo se pasa de 105 errores a cero sin echar a perder el código ni la semana? Por partes. SWEG recomienda lo mismo con los chequeos del compilador: primero se limpian los casos existentes, después se activa la regla para que no vuelva a pasar.
- Una opción o una regla a la vez, en una rama, en un pull request que no cambia el comportamiento: las pruebas no se tocan y siguen igual. Si tienen que cambiar, ya no es solo un cambio de tipos.
- Agrupar por regla. Empezar por las que tienen muchos casos: suelen ser una sola decisión.
- Por cada regla, una de tres decisiones, y por escrito:
| Decisión | Cuándo | Ejemplo en Kallpa |
|---|---|---|
| Corregir el código | El aviso señala algo real, o algo que vale la pena dejar explícito | no-misused-promises en server.ts: la función async pasada a createServer |
| Configurar la regla | Tiene sentido, pero no aquí o no en esta forma | no-floating-promises en test/: tiene una opción para declarar llamadas seguras (allowForKnownSafeCalls) |
| Desactivarla | Sus avisos no llevan a ninguna acción útil en este proyecto | Depende: discútanlo con su pareja, con el porqué |
Cada regla configurada o desactivada lleva un comentario con el porqué, en el
mismo eslint.config.js. El comentario no es para la herramienta: es para
quien en un año se pregunte si puede volver a encenderla.
Otro criterio: no todas las reglas valen lo mismo en cada lugar. Un any en
una prueba, donde el assert siguiente falla si la forma es otra, es muy
distinto de un any que entra al dominio. Y no-non-null-assertion en
findBooking(id)!, justo después de insertar ese id, tiene una suposición
razonable que igual vale la pena hacer explícita. Decidan cada caso con el
criterio de Tricorder: ¿este aviso lleva a alguien a hacer algo útil?
En la industria. Un equipo adopta un chequeo nuevo cuando vale la pena corregir todos los casos existentes, como dice SWEG: en Google, cada chequeo del compilador tiene que justificar la limpieza completa. El capítulo 8 del mismo libro agrega el complemento para las reglas de estilo: cada regla tiene que justificar su costo, y las que se pueden aplicar con una herramienta se aplican con una herramienta, sin pedirlo a las personas.
Revisar código escrito con IA
Dónde suele fallar
Una herramienta de IA escribe código que se ve bien. Ese es el problema: los errores que produce no son los que una persona que está aprendiendo suele cometer, y una lectura rápida no los detecta. Estas son las fallas típicas:
| Falla | Cómo se ve | Quién la detecta primero |
|---|---|---|
| Código plausible que no hace lo pedido | Compila, pasa sus pruebas, y resuelve otra tarea parecida | La lectura y las pruebas de aceptación |
| APIs inventadas | Un método, una función o un paquete que suenan bien y no existen | tsc, para los métodos; npm view, para los paquetes (semana 12) |
| Cambios fuera del alcance | Reformatea, renombra, “de paso” arregla algo | La lectura, si el diff es chico |
| Pruebas cambiadas para que pasen | Una prueba borrada, aflojada o con el valor esperado copiado del resultado | La lectura, y Stryker en parte |
| Consultas armadas con texto | SQL o comandos con un template string | La lectura, y un analizador de flujo de datos si lo tienen |
| Estilo ajeno | Otras comillas, otros patrones que el resto del proyecto | La lectura, y el formateador |
| Diffs grandes | Muchos archivos para una tarea chica | La lista de archivos del pull request |
| Afirmaciones sin comprobar | Una descripción que dice “probado” o “seguro” | Comprobarlo |
Noten la última columna. Las herramientas estáticas cubren poco de esta lista. Son indispensables y son el primer filtro; no alcanzan.
Un método inventado y por qué el orden importa
ejemplos/invented-method.ts usa getAll, un método que suena bien pero no
existe en StatementSync:
$ make errores
tsc --ignoreConfig --noEmit --strict --target es2024 --module nodenext --types node --skipLibCheck ejemplos/invented-method.ts
ejemplos/invented-method.ts(6,56): error TS2339: Property 'getAll' does not exist on type 'StatementSync'.
make: [Makefile:57: errores] Error 2 (ignored)
Es el error más fácil de encontrar, siempre que se corra tsc. Y hay un
detalle propio de este curso: Node solo quita los tipos, no los revisa.
Este archivo arranca; recién falla al llegar a esa línea:
$ node ejemplos/invented-method.ts
file:///work/code/week-11/ejemplos/invented-method.ts:6
export const rows = db.prepare('SELECT * FROM courts').getAll();
                                                       ^

TypeError: db.prepare(...).getAll is not a function
    at file:///work/code/week-11/ejemplos/invented-method.ts:6:56
...
Si ninguna prueba pasa por esa línea, las pruebas quedan en verde con un
método que no existe. Por eso make test no basta, y por eso make check
corre tsc antes que nada. Cuando una descripción dice “pasan las pruebas”,
todavía no sabemos si compila.
Un ejemplo completo
Veamos un pull request. Es una ilustración escrita para la clase: un
cambio como los que suele proponer un agente, no la salida de una herramienta
concreta. Está en code/week-11/busqueda-agente.diff.
Tarea: "Agreguen GET /api/bookings/search?team=texto: reservas cuyo nombre de equipo
contiene el texto."
Descripción del pull request: "Agrega la búsqueda de reservas por equipo, con su
prueba. make check pasa."
Lo primero es comprobar lo que dice. Y es cierto:
$ make busqueda
...
tsc -p .
eslint .
node --test "test/**/*.test.ts"
ℹ tests 41
ℹ suites 6
ℹ pass 41
ℹ fail 0
Antes de leer el código, lean las pruebas. Esta es toda la prueba nueva:
test('busca reservas por equipo', async () => {
  const { status } = await getJson(`${server.url}/api/bookings/search?team=Pumas`);
  assert.equal(status, 200);
});
No crea ninguna reserva, y no mira el resultado. Hagamos la pregunta de la
semana pasada: ¿qué mutante mataría? En busqueda.test.ts quitamos el WHERE
de la consulta, de modo que la búsqueda devuelve todas las reservas, y la
prueba sigue en verde. Esta prueba no prueba la búsqueda: prueba que la ruta
existe.
Ahora, el código:
+  searchByTeam(team: string): BookingRow[] {
+    return this.#db
+      .prepare(`SELECT * FROM bookings WHERE team_name LIKE '%${team}%' ORDER BY date, start_hour`)
+      .all() as BookingRow[];
+  }
El template string mete el texto del usuario dentro del SQL. Comprobémoslo, en vez de opinar, con el servidor corriendo y los datos de ejemplo. Primero con un texto normal:
$ curl -s "localhost:3000/api/bookings/search?team=Pumas" | jq -c '.[] | {teamName, memberId}'
{"teamName":"Los Pumas de Comas","memberId":1}
{"teamName":"Los Pumas de Comas","memberId":1}
Funciona. Ahora, un equipo con un apóstrofe en el nombre, algo perfectamente legítimo:
$ curl -s -G "localhost:3000/api/bookings/search" --data-urlencode "team=O'Higgins"
{"error":{"code":"INTERNAL_ERROR","message":"Ocurrió un error inesperado."}}
Ya tenemos un error que un vecino cualquiera puede encontrar sin querer. El apóstrofe cierra el texto dentro del SQL. Y alguien con malas intenciones puede seguir escribiendo SQL después de ese apóstrofe:
$ curl -s -G "localhost:3000/api/bookings/search" --data-urlencode \
    "team=' UNION SELECT id, 1, 1, name, 7, 1, phone, 0, plan, '', NULL FROM members -- " \
    | jq -c '.[] | select(.status != "confirmed" and .status != "cancelled")
                 | {nombre: .date, telefono: .teamName, plan: .status}'
{"nombre":"Rosa Quispe Mamani","telefono":"987654321","plan":"regular"}
{"nombre":"Luis Huamán Torres","telefono":"912345678","plan":"socio"}
{"nombre":"Carmen Flores Rojas","telefono":"945112233","plan":"regular"}
...
Salieron las filas de otra tabla por una ruta que debía buscar reservas. El
mismo truco sobre sqlite_master lista todas las tablas de la base. Son datos
de ejemplo, por supuesto.
Seamos precisos con lo que esto demuestra, porque la seguridad es un tema en el que es fácil exagerar:
GET /api/membersya devuelve esos teléfonos, y Kallpa no tiene autenticación. Hoy, la inyección no da un dato que no se pudiera pedir por otro camino. No es eso lo que bloquea el cambio. Lo que lo bloquea es que el texto del usuario se volvió código: toda tabla que se agregue mañana queda al alcance de esa línea.- No sirve para borrar la tabla, en este caso. Probamos con
'; DROP TABLE bookings; --: la respuesta fue 200 con las reservas y la tabla siguió ahí, porquepreparedenode:sqlitesolo compila la primera sentencia. Eso depende de la biblioteca, y no es una protección: otras bibliotecas sí ejecutan varias sentencias. Si leen en internet que toda inyección borra tablas, comprueben; en este caso, no.
¿Qué dijeron las herramientas de todo esto? Nada: make check pasó completo,
y strictTypeChecked no da ni un aviso en booking-repository.ts, porque
team es un string y el template string es válido. Solo la regla hecha a mano de
eslint.sql.js lo señala, y ya vimos cuántos casos se le escapan.
La revisión escrita
Con esos hechos, los comentarios se escriben casi solos:
issue (blocking, security): la consulta se arma con el texto del usuario.
Con ?team=O'Higgins responde 500, y con un UNION lee otras tablas (curl en la rama).
Usen un parámetro: LIKE '%' || ? || '%' con .all(team).

issue (blocking, test): la prueba no crea reservas ni mira el resultado. Sigue en verde si
se quita el WHERE. Pido una con dos equipos, comprobando que solo sale el que coincide, y
otra con un apóstrofe.

question: ¿qué debe pasar con ?team= vacío? Hoy devuelve todas las reservas. El README
define VALIDATION_ERROR para un dato que falta.

question (non-blocking): con parámetros, un % en el texto sigue siendo comodín de LIKE.
¿Se acepta? Para esta búsqueda, me parece que sí, pero quisiera que sea una decisión.

praise: la ruta y el servicio siguen la estructura del resto de los handlers.

todo: falta la ruta en la tabla de la API del README.
Y la decisión es pedir cambios. No por perfección: con el estándar de Google, este cambio empeora la salud del código, porque introduce una vía de inyección.
busqueda-corregida.diff es lo que queda después. La consulta usa un
parámetro, un texto vacío da 400, y hay cuatro pruebas que sí prueban algo:
-      .prepare(`SELECT * FROM bookings WHERE team_name LIKE '%${team}%' ORDER BY date, start_hour`)
-      .all() as BookingRow[];
+      .prepare("SELECT * FROM bookings WHERE team_name LIKE '%' || ? || '%' ORDER BY date, start_hour")
+      .all(team) as BookingRow[];
La misma inyección ahora devuelve [], un apóstrofe es un carácter más, y
quitar el WHERE hace fallar las pruebas. Eso lo comprueba
busqueda.test.ts, que también deja escrito que % sigue siendo un comodín,
para que sea una decisión y no un descuido.
Idea clave. Los tres problemas de este pull request los encontró la lectura: uno corriendo el cambio, otro haciendo la pregunta del mutante, otro leyendo el SQL. La herramienta de IA no es la que está en revisión. Es el cambio: da lo mismo quién lo escribió.
Qué hacer
Un procedimiento que funciona, en orden:
- Pedir cambios chicos. La unidad de trabajo es lo que ustedes pueden revisar, no lo que la herramienta puede escribir. Un diff de 900 líneas no se revisa: se le cree.
- Que pase
make checkantes de leer. Es gratis. No gasten atención en lo quetscpuede rechazar solo. Usenmake -k checkpara ver el resultado de los tres pasos aunque falle el primero:make checkse detiene en el primer error. - Leer primero lo que cambió en las pruebas. Si una prueba se borró o se aflojó, pregunten por qué antes de seguir. Después, lean las pruebas nuevas: ¿qué mutante matan?
- Mirar la lista de archivos. ¿Tiene sentido que este cambio toque esto? Todo lo que no es parte de la tarea se saca del pull request.
- Comprobar en la documentación cada API que no conozcan. No “suena bien”.
- Revisar cada dependencia nueva (lo veremos en la semana 12).
- Comprobar lo que dice la descripción. “Validado”, “seguro”, “probado”
son afirmaciones. Se comprueban como cualquier otra: con un
curl, con una prueba.
Con IA. La responsabilidad no cambia. Quien abre el pull request responde por todo el código, lo haya escrito a mano o con un agente, y tiene que poder explicarlo en la revisión. Si no lo puede explicar, el pull request no está listo. Decir “lo escribió el agente” no es una respuesta a un comentario de revisión, igual que “lo copié de Stack Overflow” nunca lo fue. El curso CMSC 398Z de la Universidad de Maryland trata justamente de esto, si quieren ir más lejos.
Lo que hace cada uno
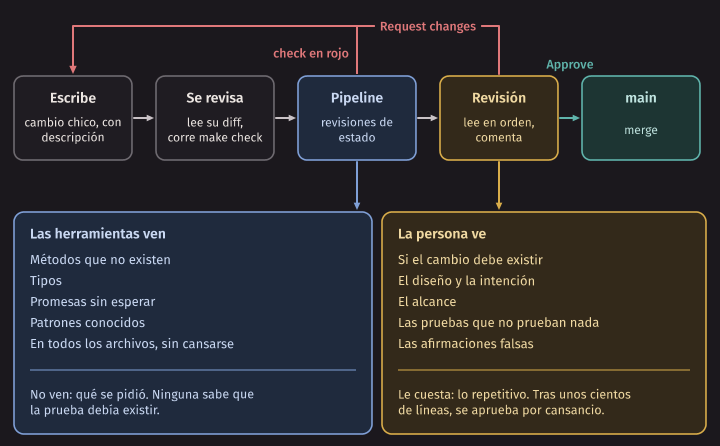
| La revisión humana | Las herramientas | |
|---|---|---|
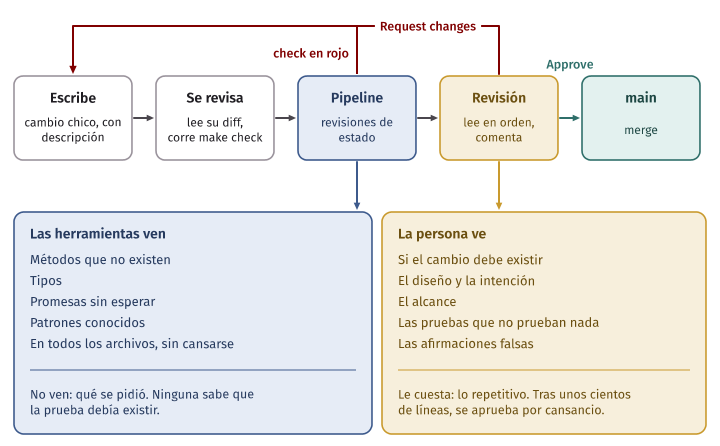
| Son buenas para | Si el cambio debe existir, el diseño, la intención, el alcance, las pruebas que no prueban nada, las afirmaciones falsas | Métodos inexistentes, tipos, promesas, patrones conocidos, en todos los archivos y sin cansarse |
| Son malas para | Lo repetitivo. Después de unos cientos de líneas, se aprueba por cansancio | Saber qué se pidió. Ninguna sabe que la prueba debía existir |
No compiten. Las herramientas limpian lo mecánico, para que la atención humana, que es escasa, quede para lo que solo una persona puede juzgar. Sadowski y otros lo dicen sobre Google: el análisis automático permite a quienes revisan concentrarse en la comprensión y el mantenimiento del cambio, sin distraerse con comentarios triviales.
El laboratorio: revisar y endurecer
El laboratorio tiene dos partes. Los pasos 1 y 2 son individuales, y desde el 3 se trabaja en parejas.
Paso 1: revisión entre equipos. El docente les asigna dos pull requests abiertos del proyecto de otro equipo. Dentro de una copia del repositorio:
gh pr checkout <número> -R <owner>/<repositorio>
make check
Lean la descripción y el diff en orden, y dejen en GitHub al menos tres comentarios en líneas concretas, con etiquetas de Conventional Comments, y una decisión final (aprobar o pedir cambios) justificada con el estándar de Google. No es necesario encontrar defectos para que la revisión sea buena: si el cambio está bien, digan por qué y aprueben.
Paso 2: un pull request para revisar. code/week-11/pr-generado.diff es
una ilustración escrita para la clase: trae la tarea, la descripción y el
diff. Primero, sin correr nada, escriban en revision.md los comentarios
que dejarían. Después, en la copia de Kallpa de la semana 10:
cd /work/kallpa-semana10
git switch -c pr-generado main
git apply /work/code/week-11/pr-generado.diff
make -k check
El orden es lo importante. Si corren primero las herramientas, ya no sabrán qué habrían visto sin ellas. Al final, comparen: ¿qué encontraron las herramientas que ustedes no vieron? ¿Qué vieron ustedes que ninguna reporta?
Paso 3: TypeScript más estricto. En su repositorio de Kallpa, en una rama
nueva, agreguen "noUncheckedIndexedAccess": true y corran make typecheck.
Son los 9 errores de arriba. Corríjanlos con una guarda, un valor por omisión
o un cambio de estructura, sin ! ni as, y sin cambiar el comportamiento:
make test tiene que seguir igual. Luego lo mismo con
"exactOptionalPropertyTypes": true.
Paso 4: linting con tipos. Cambien tseslint.configs.recommended por
tseslint.configs.strictTypeChecked, y agreguen los dos bloques que dice la
guía. Agrupen:
make lint
eslint . -f json | jq -r '.[].messages[].ruleId' | sort | uniq -c | sort -rn
Paso 5: decidir regla por regla. Corrijan todos los de src/. Para las
pruebas, discutan qué hacer con no-floating-promises sobre test() y
describe() y con el any de test/helpers.ts. Cada regla desactivada o
configurada lleva un comentario con el porqué. Recuerden la trampa de las
opciones de restrict-template-expressions, y midan después de cada
configuración.
Paso 6: el pull request. make check en verde, y en la descripción, una
tabla:
| Regla | Avisos | Decisión | Por qué |
|---|---|---|---|
no-floating-promises |
46 (todos en test/) |
… | … |
restrict-template-expressions |
21 | … | … |
| … |
La revisa la otra pareja, con las mismas etiquetas del paso 1.
Esta semana se entrega P3 con la demo del sprint 2, y se publica P4
(projects/p4-entrega-continua/README.md).
P3 pide que eslint . --max-warnings 0 no dé nada, y recomienda
strictTypeChecked. Si el laboratorio les quedó en verde, ya saben cómo
hacerlo en su proyecto.
El código de la semana y make test
La carpeta code/week-11 tiene:
| Archivo | Qué es |
|---|---|
pr-generado.diff |
El pull request del paso 2 del laboratorio |
busqueda-agente.diff, busqueda-corregida.diff |
El ejemplo completo del capítulo, antes y después de la revisión |
busqueda.test.ts |
Comprueba cada afirmación del ejemplo: la inyección, el 500, los mutantes, la corrección |
ejemplos/ |
Los fragmentos del capítulo: falsos positivos y negativos, promesas, as, propiedades opcionales, formas de SQL |
analisis.test.ts |
Comprueba lo que dicen tsc y ESLint sobre esos fragmentos |
eslint.estricto.js |
La configuración del paso 4, para medir |
eslint.sql.js |
La regla hecha a mano que busca SQL en template strings |
eslint.fronteras.js |
Una regla que encuentra cada as y cada ! |
estricto.test.ts |
Los números de Kallpa publicada que da el capítulo |
pr-generado.test.ts |
Que el diff del laboratorio se aplique a Kallpa |
Dentro del contenedor del curso:
$ cd code/week-11
$ make test
tsc -p .
eslint .
node --test "*.test.ts"
...
ℹ tests 31
ℹ suites 2
ℹ pass 31
ℹ fail 0
...
Con make medir salen los números de Kallpa, con make fronteras sus as, con make errores el error de
tsc del método inventado, y con make busqueda se aplica el ejemplo a una
copia en build/busqueda, donde pueden levantar el servidor y repetir los
curl. Nada de esto modifica kallpa/, y make clean borra build/.
Para repetir los curl:
make busqueda
cd build/busqueda
make start
Resumen
- Una revisión de código es la lectura de un cambio por otra persona antes del merge. Además de corrección, da comprensión, consistencia, ownership compartido, conocimiento y registro histórico (SWEG cap. 9). El estudio de Sadowski y otros en Google encontró que encontrar defectos es bienvenido, pero no es el único foco; es un estudio exploratorio de una sola empresa.
- En Google, un cambio necesita LGTM, owner y readability, a
menudo de una sola persona. En GitHub: revisión obligatoria,
CODEOWNERSy protección demain. - El estándar: se aprueba cuando el cambio mejora con seguridad la salud general del código, aunque no sea perfecto. Los hechos pesan más que las opiniones, y en estilo manda la guía.
- Se mira de lo grande a lo chico: diseño, funcionalidad, pruebas, complejidad, nombres. El formato lo revisa una herramienta.
- Cambios pequeños: unas 100 líneas se revisan bien, y 1000 suelen ser demasiado. Quien escribe divide, describe y se revisa. Quien revisa responde en un día hábil como máximo.
- Comentarios útiles: sobre el código, con el porqué, con una sugerencia y
con la severidad marcada (
Nit:, o Conventional Comments). - El análisis estático razona sin ejecutar. Por el teorema de Rice, ninguna herramienta decide con exactitud una propiedad no trivial del comportamiento de todos los programas: todas tienen falsos positivos o falsos negativos, y casi siempre los dos.
- Lo que importa es la tasa de falsos positivos efectivos: avisos con los que nadie hace nada. Tricorder exige menos de 10 % por chequeo, muestra los resultados en la revisión, sugiere correcciones y tiene un botón de “no es útil”.
strictno es lo más estricto:noUncheckedIndexedAccessyexactOptionalPropertyTypeshay que pedirlos. Se corrige con una guarda, un valor por omisión o un cambio de estructura; un!no corrige nada.- El linting con tipos ve promesas sin esperar y
anyque se propagan. En Kallpa da 105 errores, y 46 son falsos positivos de una misma regla sobrenode:test. Por eso se agrupa por regla, se decide regla por regla y se deja el porqué escrito. Configurar una opción puede apagar otras: hay que medir. - En las fronteras del programa, lo que llega de afuera se tipa como
unknowny se revisa. Cadaas,!yanyes un lugar donde el tipo puede mentir. - El código escrito con IA falla de maneras propias: APIs inventadas, cambios
fuera del alcance, pruebas borradas, SQL con texto, afirmaciones sin
comprobar. Pidan cambios chicos, corran
make check, lean primero las pruebas y comprueben lo que dice la descripción. Quien abre el pull request responde por todo el código.
Ejercicios
- Reescriban cada comentario para que sea útil, con una etiqueta de
Conventional Comments, y digan si bloquea: (a) “esto está mal, así no se
hace”; (b) “¿y las pruebas?”; (c) “yo lo habría hecho con un
map”; (d) “muy bien”. - Para cada caso, digan si aprobarían según el estándar de Google, y por qué: (a) un pull request corrige un error de una cancelación y deja un nombre de variable malo; (b) uno agrega un parámetro de configuración “por si después hace falta”; (c) uno arregla un error en producción y deja una función un poco más larga, con una tarea creada para arreglarla; (d) uno baja la cobertura de un módulo de reglas del negocio porque “esas pruebas eran lentas”.
- Busquen un pull request que hayan abierto en P2 o P3. Escriban la
descripción que debió tener, con el formato de The CL author’s guide. Si
pasa de 300 líneas, propongan cómo dividirlo en dos o tres, cada uno con
make checken verde. - En el apunte,
firstPartes un falso positivo connoUncheckedIndexedAccess. Escriban otro ejemplo de TypeScript con un falso positivo y otro con un falso negativo destrict. Comprueben los dos contscy, para el segundo, muestren el error al correr. - Expliquen, sin usar la palabra teorema, por qué una herramienta no puede
decidir si una función llega a lanzar un error. Después digan por qué eso
no impide que
tscsea muy útil. ¿Qué eligetsccuando encuentra un caso que no puede decidir? - Extiendan
eslint.sql.jspara que también avise con"..." + teamdentro deprepare. Agreguen una prueba enanalisis.test.ts. Ahora avisa enwithPlus, pero no enthroughVariable. ¿Se puede arreglar con un selector? ¿Qué tendría que hacer la herramienta? ¿Qué falsos positivos nuevos aparecen? - Una regla de su linter da 40 avisos a la semana y su equipo corrige 5. (a) ¿Cuál es la tasa de falsos positivos efectivos? (b) Si solo 2 de los 35 restantes no eran errores técnicos, ¿qué significa esa diferencia? (c) ¿Pasa el criterio de Tricorder? Propongan dos cambios para mejorarla antes de apagarla.
- Con
noUncheckedIndexedAccess,const first = bookings[0]tiene tipoBooking | undefined. Den dos formas de corregir el error que dafirst.date, y digan qué decide cada una si la lista está vacía. Por québookings[0]!no es una de ellas. - Escriban una función
parseCourtId(value: unknown): numberpara una frontera de Kallpa, que acepte solo enteros positivos. Agreguen pruebas de ejemplo y una propiedad con fast-check. ¿En qué rutas de Kallpa se podría usar, y qué cambiaría en sus respuestas de error? - En su proyecto, listen todos los
as,!,anyyeslint-disable(empiecen coneslint.fronteras.js). Para cada uno, respondan qué lo garantiza. Elijan los dos peores y corríjanlos en un pull request con una descripción que explique el antes y el después. - Agreguen a su proyecto, en su pipeline o en
make check, una regla que encontraría un error real que hayan tenido en P2 o P3, aunque sea conno-restricted-syntax. Midan cuántos avisos da, cuántos son reales y con cuántos harían algo. ¿Se queda la regla? - Un pull request de 900 líneas, escrito con un agente, agrega una funcionalidad y “de paso” reformatea cinco archivos y actualiza dos pruebas que fallaban. Las pruebas pasan. Escriban el comentario que dejarían antes de revisarlo, y la lista de lo que mirarían primero cuando vuelva en partes.