Apuntes · Capítulo 10Calidad: pruebas, revisión e integración
Pruebas basadas en propiedades, fuzzing, mutación y oráculos
Pruebas basadas en propiedades, fuzzing, mutación y oráculos
La semana pasada escribieron pruebas unitarias y de aceptación, midieron la cobertura y siguieron el ciclo de TDD. Todas esas pruebas tienen la misma forma: para esta entrada, este resultado. Son buenas pruebas, y el curso no las va a abandonar. Pero dejan dos preguntas sin responder. La primera: ¿qué pasa con todas las entradas que a nadie se le ocurrió escribir? La segunda: si el código tuviera un error aquí, ¿alguna prueba fallaría? La cobertura no responde ninguna de las dos, porque solo dice por dónde pasó la ejecución, no qué se revisó.
Este capítulo da herramientas para esas dos preguntas. En la primera parte, las pruebas basadas en propiedades cambian “para esta entrada, este resultado” por “para toda entrada de este dominio, se cumple esto”, y dejan que una herramienta busque el contraejemplo. El fuzzing lleva la idea al extremo: mucha entrada rara y una sola exigencia, que el programa no se caiga. En la segunda parte, las pruebas de mutación miden las pruebas en vez del código: le meten errores pequeños al programa y cuentan cuántos nota la suite. Al final aparece la pregunta de fondo, la que todo lo anterior da por resuelta: ¿quién sabe cuál es la respuesta correcta? Es el problema del oráculo, y se vuelve urgente cuando la misma herramienta escribe el código y sus pruebas.
Lectura. Para la primera parte: fast-check, Introduction y Arbitraries; David R. MacIver, What is Property Based Testing? (Hypothesis); y la introducción de Koen Claessen y John Hughes, QuickCheck: A Lightweight Tool for Random Testing of Haskell Programs (ICFP 2000), el artículo que inició la técnica (el código es Haskell: lean las ideas). Complementarias: fast-check, Model-based testing; Andreas Zeller y otros, The Fuzzing Book, Fuzzing: Breaking Things with Random Inputs; y Software Engineering at Google (SWEG), cap. 14, Larger Testing. Para la segunda parte: StrykerJS, Introduction y Tap Runner; y Goran Petrović y Marko Ivanković, State of Mutation Testing at Google (ICSE SEIP 2018). Complementarias: StrykerJS, Supported mutators y Configuration; y Carnegie Mellon, 17-313 Foundations of Software Engineering, sus clases de pruebas y de calidad. El código del capítulo está en
code/week-10y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): De los ejemplos a las propiedades; de Encontrar, reducir y reproducir, Leer un contraejemplo; de Clases de propiedades, la introducción, Invariantes e Ida y vuelta; de Fuzzing, Entradas que nadie pensó; de Pruebas de mutación, La pregunta que la cobertura no responde, Qué es un mutante y Los estados de un mutante y el score; y de El problema del oráculo, Quién sabe la respuesta.
- En clase: Sesión A: Encontrar, reducir y reproducir, Clases de propiedades, Generadores que llegan a los casos interesantes y Fuzzing. Sesión B: Pruebas de mutación y El problema del oráculo. Laboratorio: El laboratorio: encontrar los errores.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Propiedades que no prueban nada, Leer un sobreviviente: ¿hueco o equivalente?, Costo y práctica, Qué es independiente de verdad y las lecturas del recuadro Lectura.
De los ejemplos a las propiedades
Dos formas de decir lo mismo
Una prueba de ejemplo fija una entrada y su resultado:
assert.deepEqual(splitCents(9000, 3), [3000, 3000, 3000]);Una propiedad es una afirmación sobre todas las entradas de un dominio:
Para todo total entero
t >= 0y todo número de jugadoresn >= 1, las partes desplitCents(t, n)suman exactamentet.
Una prueba basada en propiedades (property-based testing) es un programa que intenta refutar esa afirmación: genera entradas del dominio, corre el código con cada una y revisa la afirmación. Si encuentra una entrada que la rompe, ese es un contraejemplo. Si no la encuentra, la propiedad no queda demostrada: queda sin refutar después de cierto número de intentos. Una prueba, de ejemplo o de propiedad, puede mostrar que hay un error, pero no que no hay ninguno.
La diferencia no es de cantidad. Cien pruebas de ejemplo escritas a mano siguen siendo cien casos que a alguien se le ocurrieron. Una propiedad obliga a decir qué tiene que ser verdad, en vez de qué sale en este caso, y deja que la búsqueda de casos la haga una máquina que no comparte los prejuicios de quien escribió el código.
La idea tiene un origen preciso. Koen Claessen y John Hughes publicaron QuickCheck en el año 2000, para Haskell: las propiedades se escriben como funciones y se prueban con entradas aleatorias. De ahí vienen casi todas las herramientas actuales, como Hypothesis en Python y fast-check en TypeScript. David MacIver, autor de Hypothesis, propone en su artículo una definición que pone el énfasis en otro lugar: lo que define la técnica no es el azar (hay herramientas que no lo usan) sino construir pruebas tales que, cuando se les alimenta con muchas entradas, sus fallas revelan problemas del sistema que no se habrían visto alimentando al sistema directamente. Como él dice, las pruebas basadas en propiedades son lo que uno hace, no lo que hace la computadora. La computadora genera entradas; pensar qué tiene que ser verdad sigue siendo trabajo de ustedes.
Un ejemplo: dividir el pago de una reserva
Un equipo de fulbito quiere dividir el pago de la reserva entre sus jugadores.
No es una regla de Kallpa: es un ejemplo pequeño, en
code/week-10/split.ts, para ver la técnica. El
dinero va en céntimos, como en Kallpa, siempre enteros. La versión que se le
ocurre a cualquiera:
export function splitCentsNaive(totalCents: number, players: number): number[] {
  return Array.from({ length: players }, () => Math.round(totalCents / players));
}
Y sus pruebas de ejemplo, que pasan:
assert.deepEqual(splitCentsNaive(9000, 3), [3000, 3000, 3000]);
assert.deepEqual(splitCentsNaive(11250, 2), [5625, 5625]);
Los dos ejemplos tienen algo en común: el total se divide exacto. Nadie los eligió así a propósito. Son los números que vienen a la cabeza porque son fáciles de calcular a mano para escribir la prueba. Esa es la debilidad de los ejemplos: quien los escribe tiende a elegir, sin querer, los casos donde su idea funciona.
Anatomía de una propiedad en fast-check
La misma regla, como propiedad, en
demos/split-naive.demo.test.ts:
import assert from 'node:assert/strict';
import { test } from 'node:test';
import fc from 'fast-check';
import { splitCentsNaive } from '../split.ts';

test('las partes suman el total', () => {
  fc.assert(
    fc.property(fc.integer({ min: 0, max: 100_000 }), fc.integer({ min: 1, max: 22 }), (total, players) => {
      const parts = splitCentsNaive(total, players);
      assert.equal(parts.reduce((a, b) => a + b, 0), total);
    }),
    { seed: 2026 },
  );
});
Hay cuatro piezas:
- Los arbitraries,
fc.integer({ min: 0, max: 100_000 }), describen de dónde salen las entradas. Un arbitrary sabe generar valores al azar y también sabe producir versiones más simples de un valor. - El predicado, la función del final, recibe un valor de cada arbitrary.
La propiedad falla si el predicado lanza una excepción o devuelve
false. Aquí usamosassert, que da mejores mensajes que devolver un booleano. fc.propertyjunta los arbitraries y el predicado. Todavía no corre nada.fc.assertcorre la propiedad, por omisión con 100 entradas generadas, y lanza un error en el primer contraejemplo. Sin esa llamada, la prueba no verifica nada: es un error común olvidarfc.asserty ver una prueba en verde.
El { seed: 2026 } no es parte normal de una propiedad. Lo fijamos en las
demostraciones de este capítulo para que la salida se repita al correrla; en
sus pruebas no lo fijen, porque cada corrida con una semilla distinta explora
entradas nuevas.
La prueba sigue siendo una prueba de node:test, y corre con el mismo comando
que las demás. En el contenedor, import fc from 'fast-check' funciona sin
npm install.
Encontrar, reducir y reproducir
Leer un contraejemplo
Esto sale al correr la propiedad (make demo D=split-naive; se quitaron las
líneas de la pila de llamadas de fast-check):
✖ failing tests:

test at demos/split-naive.demo.test.ts:8:1
✖ las partes suman el total (3.535417ms)
  Error: Property failed after 3 tests
  { seed: 2026, path: "2:1:0:0:0:0:1:0:0:0:0:0:0:0:0:0:0", endOnFailure: true }
  Counterexample: [1564,3]
  Shrunk 16 time(s)

  Hint: Enable verbose mode in order to have the list of all failing values encountered during the run
    [cause]: AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

    1563 !== 1564
Se lee de arriba abajo:
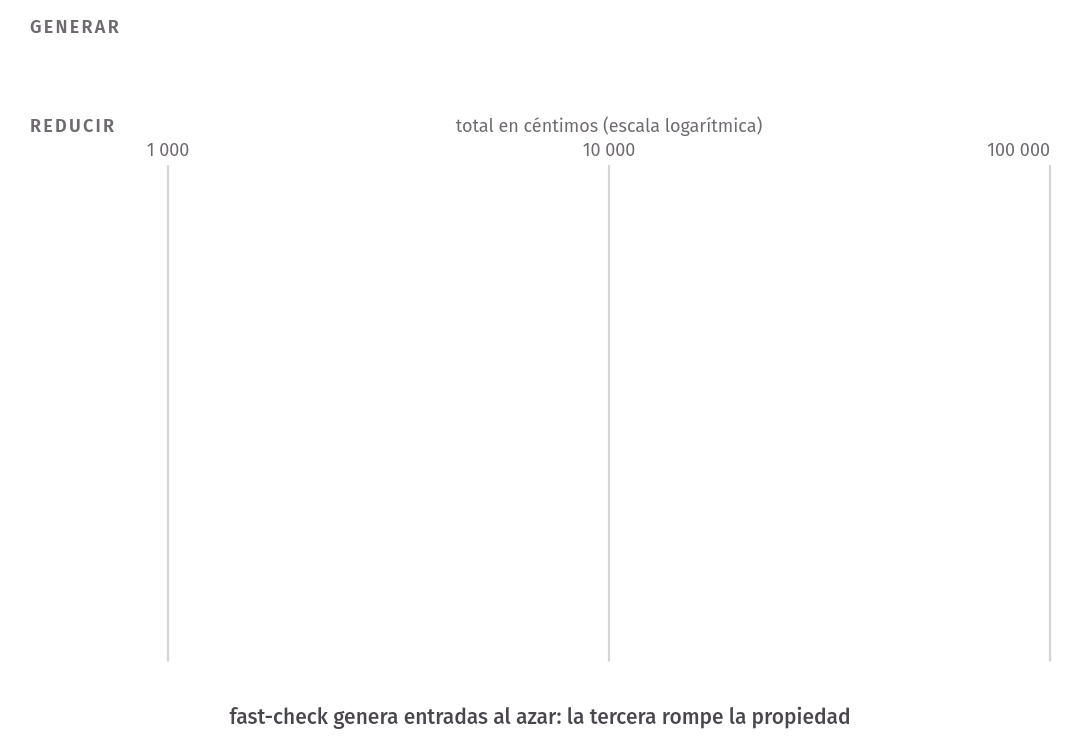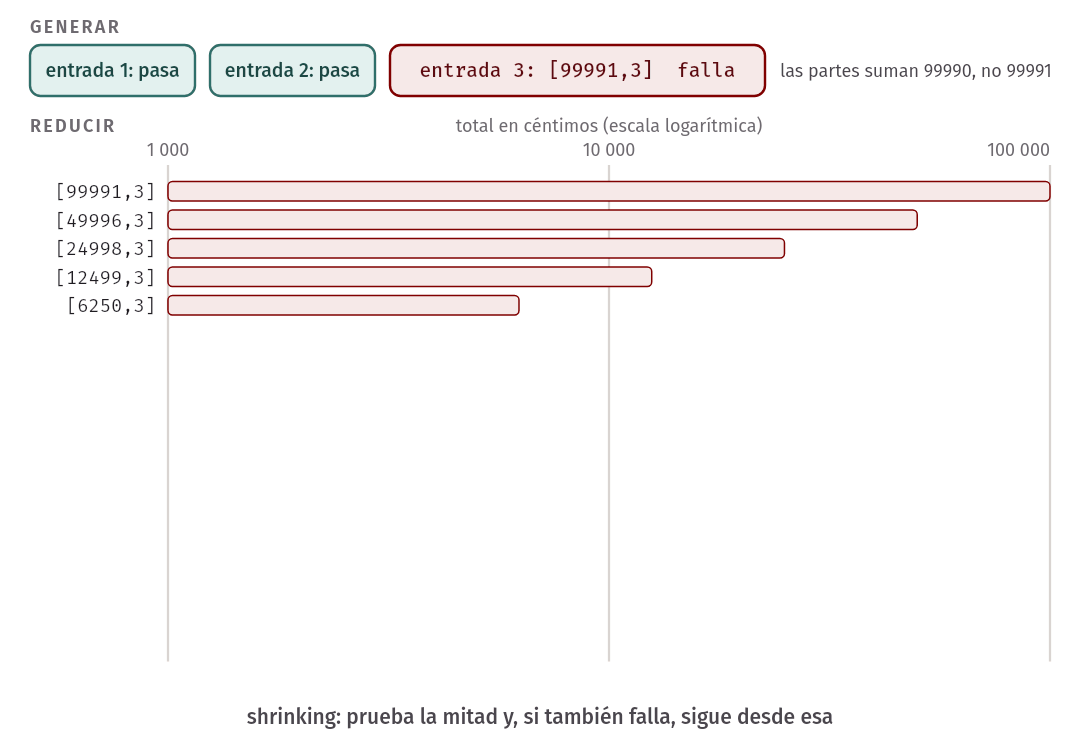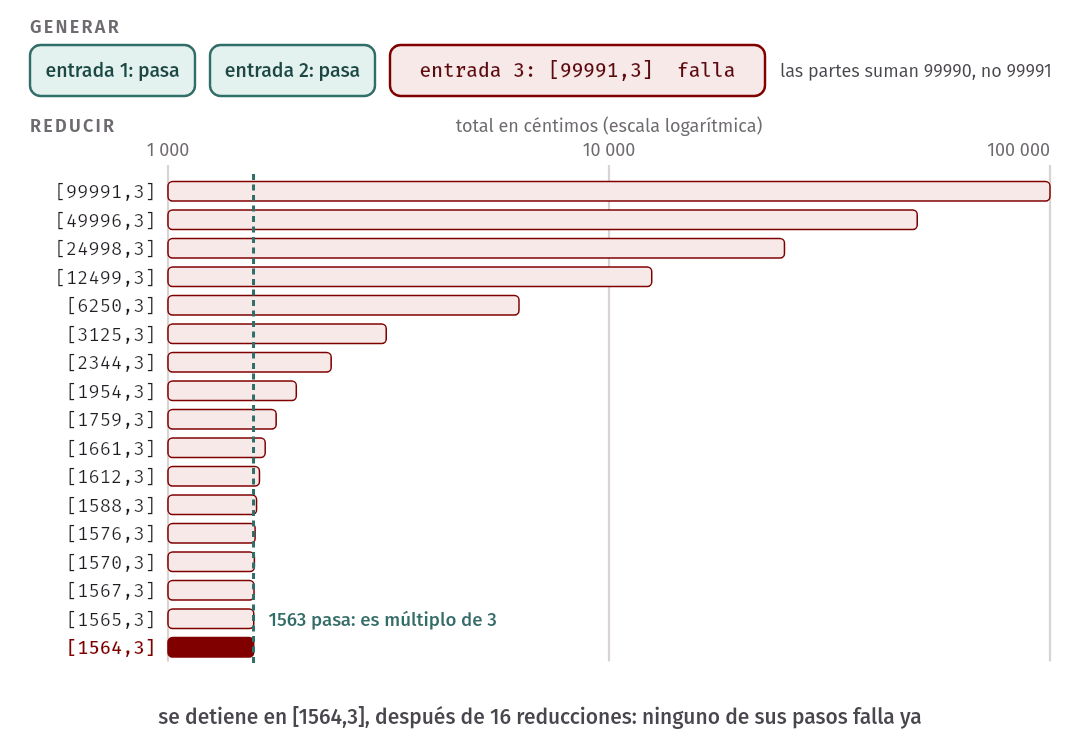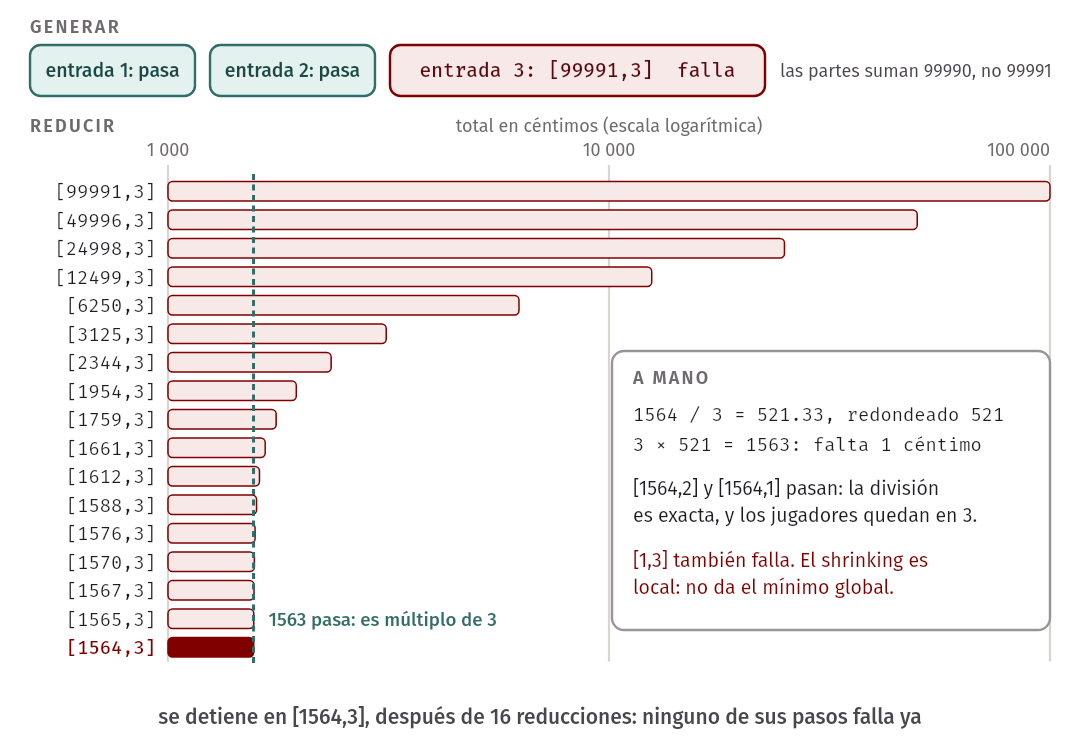
Property failed after 3 tests: la tercera entrada generada ya rompió la propiedad.Counterexample: [1564,3]: los valores, en el orden de los arbitraries. Un total de 1564 céntimos entre 3 jugadores.Shrunk 16 time(s): el contraejemplo original no era este. La herramienta lo simplificó en 16 pasos.1563 !== 1564: elassert. La cuenta se comprueba a mano: 1564 / 3 = 521.33, redondeado da 521, y 3 × 521 = 1563. Falta un céntimo en la caja.
El último paso no es opcional. Un contraejemplo se comprueba a mano contra la regla, porque puede señalar un error del código, un error de la propiedad o una entrada que no debió generarse. Solo después se decide qué se corrige.
Shrinking
Una entrada generada al azar suele ser grande y estar llena de detalles que no
tienen nada que ver con la falla. Por eso, al encontrar un contraejemplo, el
runner hace shrinking: prueba versiones más simples de esa entrada
(números más cercanos a cero, listas más cortas, la primera opción de un
constantFrom) y, cada vez que una de ellas también falla, sigue desde esa.
Se detiene cuando ninguna de las versiones que sabe probar falla. Lo que
reporta es lo último que falló.
Con verbose: 1, fast-check muestra los valores que fallaron en el camino
(make demo D=split-naive-verbose):
  Error: Property failed after 3 tests
  { seed: 2026, path: "2:1:0:0:0:0:1:0:0:0:0:0:0:0:0:0:0", endOnFailure: true }
  Counterexample: [1564,3]
  Shrunk 16 time(s)

  Encountered failures were:
  - [99991,3]
  - [49996,3]
  - [24998,3]
  - [12499,3]
  - [6250,3]
  - [3125,3]
  - [2344,3]
  - [1954,3]
  - [1759,3]
  - [1661,3]
  - [1612,3]
  - [1588,3]
  - [1576,3]
  - [1570,3]
  - [1567,3]
  - [1565,3]
  - [1564,3]
La entrada original era [99991,3]. Lo que se ve es una búsqueda por mitades:
de 99991 a 49996, a 24998, hasta 3125. La lista solo muestra lo que falló: la
mitad de 3125 es 1563, que es múltiplo de 3 y por lo tanto pasa, así que la
búsqueda sigue entre 1563 y 3125 y termina pegada al valor que pasa.
Y aquí hay algo importante: [1564,3] no es el contraejemplo más simple.
Con [1,3] la versión ingenua también falla (cada uno paga 0 y falta 1
céntimo), y es mucho más fácil de pensar. El shrinking es una búsqueda local
con reglas fijas, no una búsqueda del mínimo global: da un valor que ya no se
puede simplificar con los pasos que sabe dar. Cuando se dice que el runner
muestra el contraejemplo más simple, hay que leer “el más simple que
encontró”. Aun así, vale mucho más que [99991,3]. Y si al mirarlo se les
ocurre uno más chico, como aquí, prueben ese y úsenlo en la prueba de
regresión.
¿Y por qué se quedó en 3 jugadores? Porque con [1564,2] y con [1564,1] la
división es exacta y la propiedad pasa. Cada dimensión se detuvo donde dejó de
fallar.
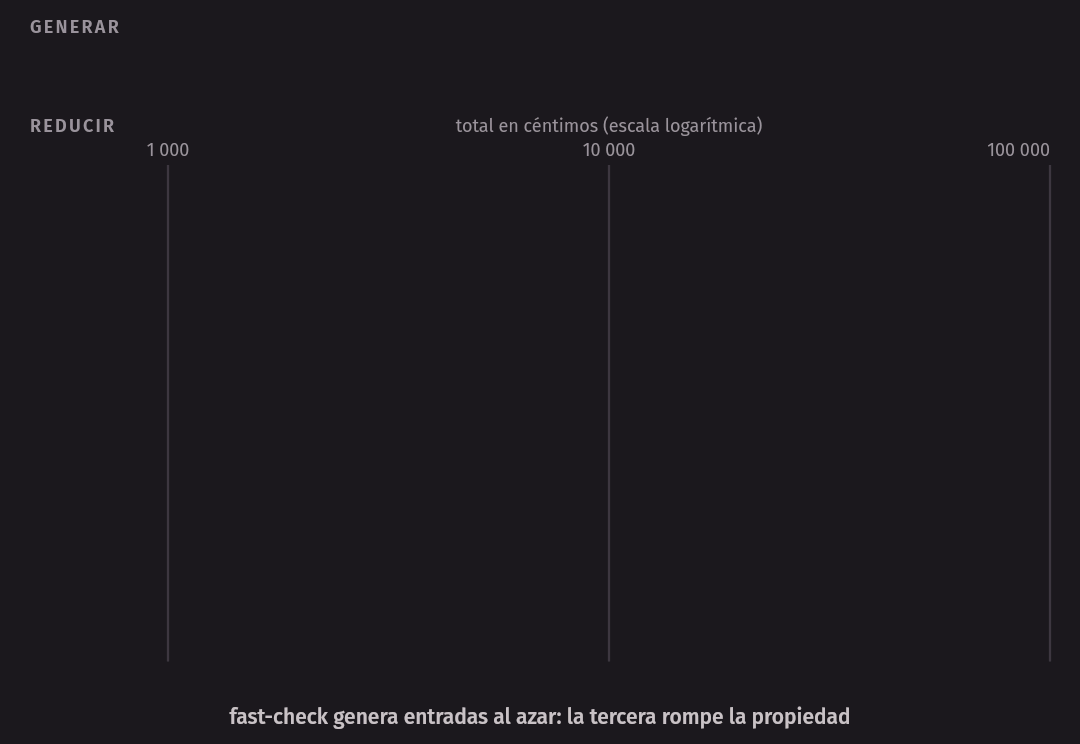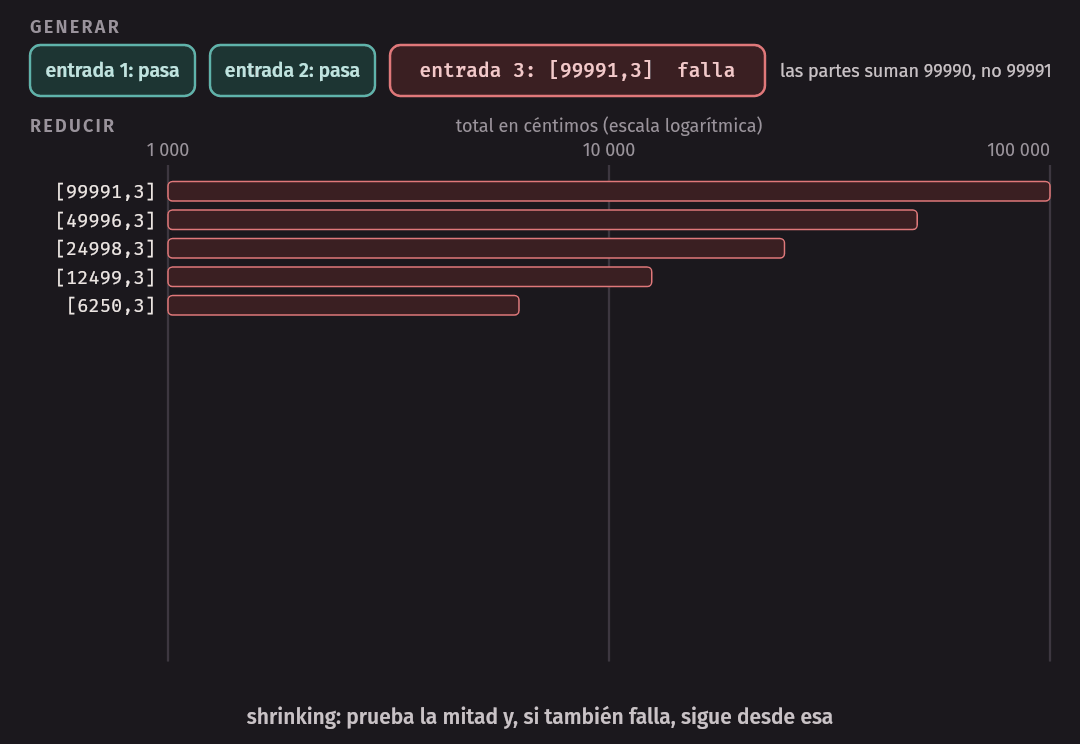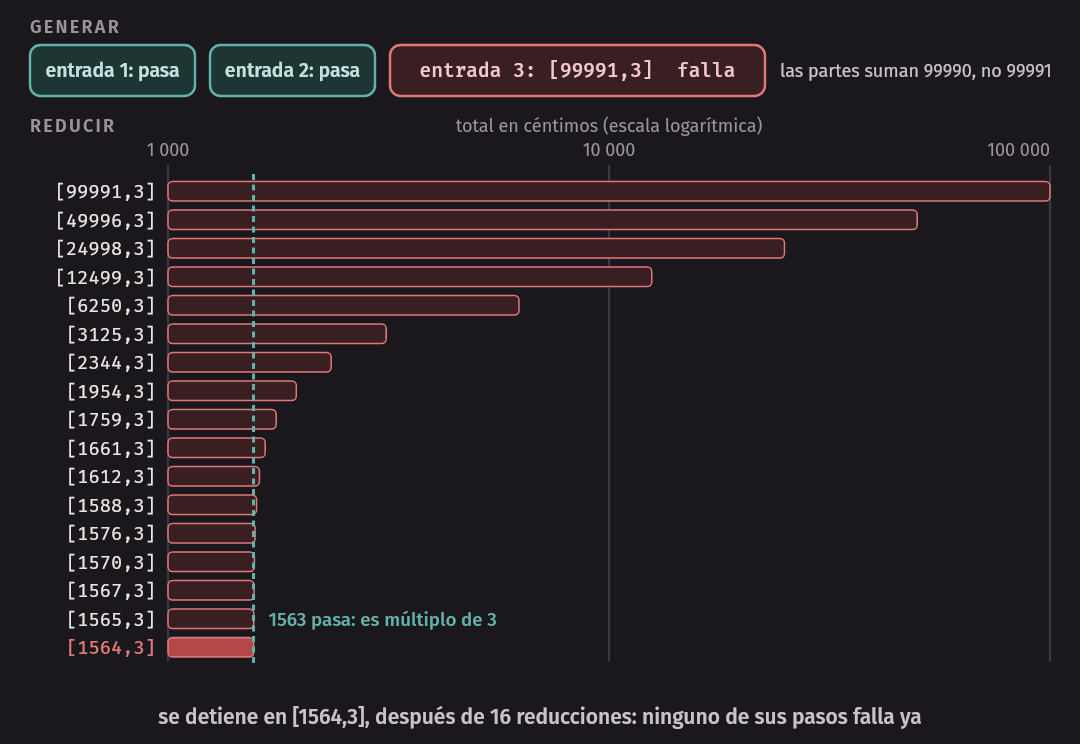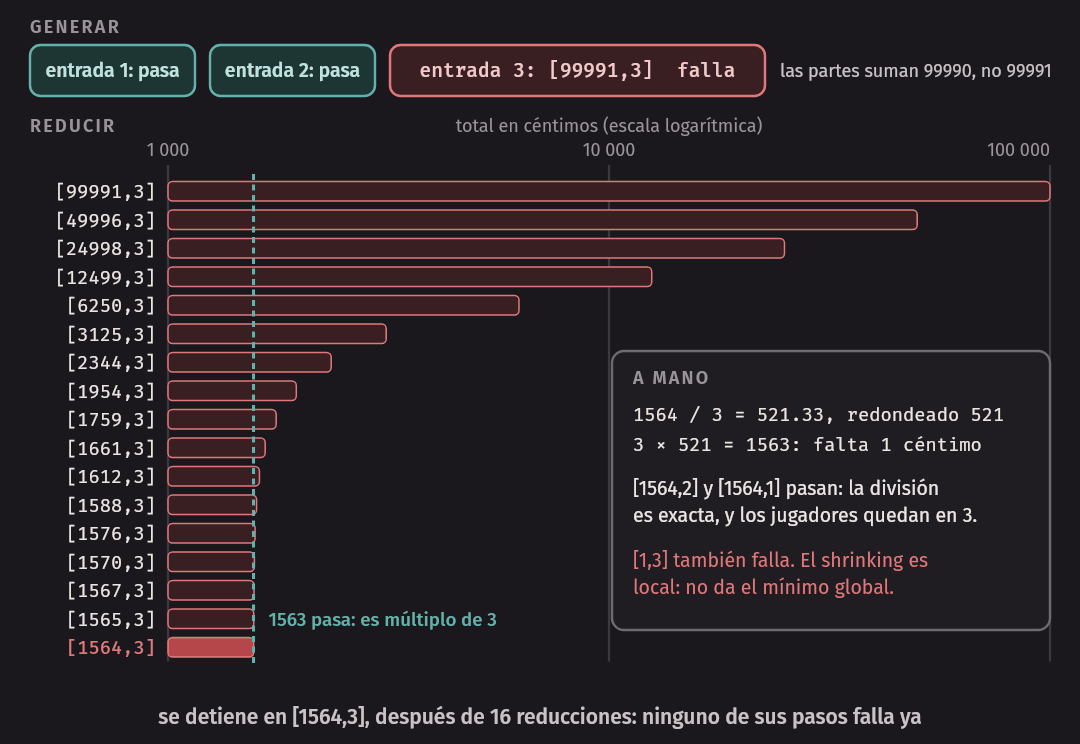
Esto explica también por qué el shrinking es tan valioso con estructuras. Una lista de 40 reservas que hace fallar un cálculo de caja puede quedar en una lista de dos reservas, con horas y montos reducidos, y ahí el error se ve a simple vista.
Idea clave. El shrinking separa lo que causa la falla de lo que solo estaba ahí. Un contraejemplo reducido es un diagnóstico; uno sin reducir es apenas una alarma.
Semilla y camino
Una herramienta que genera al azar tiene un riesgo evidente: una falla que no
se puede repetir no sirve. Por eso toda corrida depende de una semilla
(seed), y fast-check la imprime junto con el camino (path), que dice
qué entrada de la corrida falló y qué pasos de reducción siguió. Con esos dos
valores, la reproducción es exacta:
fc.assert(property, { seed: 2026, path: '2:1:0:0:0:0:1:0:0:0:0:0:0:0:0:0:0', endOnFailure: true });endOnFailure: true le dice que no intente reducir más. La corrida arranca
directamente en el contraejemplo ya reducido (make demo D=split-naive-replay):
  Error: Property failed after 1 tests
  { seed: 2026, path: "2:1:0:0:0:0:1:0:0:0:0:0:0:0:0:0:0", endOnFailure: true }
  Counterexample: [1564,3]
  Shrunk 0 time(s)
Esa línea con la semilla es la que hay que copiar del log cuando una propiedad falla en la integración continua. Y ¿no es un problema que una prueba use el azar? Lo sería si la falla no se pudiera repetir, porque se comportaría como un flaky test. No es igual: una propiedad que falla encontró una entrada real que rompe una regla real, y esa entrada no va a dejar de existir. Lo que sí hay que hacer siempre es convertir el contraejemplo en una prueba de ejemplo, para que el caso quede fijo aunque la próxima corrida genere otras entradas:
test('1564 céntimos entre 3 jugadores no pierde céntimos', () => {
  assert.equal(sum(splitCents(1564, 3)), 1564);
});
La versión correcta da el piso a todos y reparte de a uno lo que sobra. Está
en split.ts y pasa las dos propiedades de
split.test.ts: las partes suman el total, y
hay una parte por jugador que difiere de las otras en a lo más un céntimo.
Error común. Correr una vez, ver que falla, volver a correr “para ver si pasa” y seguir. Una propiedad que falla una de cada diez corridas tiene un contraejemplo real: el generador lo encuentra pocas veces porque es raro, no porque sea imaginario. Copien la semilla antes de volver a correr.
Cuántas corridas
Por omisión son 100, el mismo número que usaba QuickCheck. No es un número
mágico. Si un error solo se manifiesta en una fracción p de las entradas que
produce el generador, la probabilidad de no verlo en n corridas es (1 − p)^n:
p (una entrada de cada…) |
Sin verlo en 100 corridas | Sin verlo en 1000 corridas |
|---|---|---|
| 0.10 (10) | 0.003 % | prácticamente 0 |
| 0.01 (100) | 36.6 % | 0.004 % |
| 0.005 (200) | 60.6 % | 0.7 % |
| 0.001 (1000) | 90.5 % | 36.8 % |
La tabla dice dos cosas. Subir numRuns ayuda, y es barato en funciones
puras: 100 corridas de una función de dominio toman milisegundos. Pero la
mejor palanca es subir p, y eso depende del generador: de eso trata una
sección más abajo.
Clases de propiedades
La dificultad real de la técnica es saber qué afirmar. Decir “el resultado es
este” ya no sirve, porque para eso habría que calcularlo, y calcularlo es lo
que hace el código. Hay cinco formas de salir de ese problema. Las pruebas de
esta sección están en
code/week-10/properties.test.ts y
corren contra la Kallpa publicada, importando sus módulos sin modificarlos.
Todas salen de una regla del README de Kallpa.
Estas propiedades se usan con estos generadores:
const dateArb = fc.integer({ min: 0, max: 364 }).map((d) => addDays('2026-01-01', d));
const sportArb = fc.constantFrom(...SPORTS);
const planArb = fc.constantFrom(...MEMBER_PLANS);
Invariantes
Un invariante es algo que tiene que ser cierto de la salida, sea cual sea la entrada. No dice cuál es el resultado, solo qué forma tiene.
El README dice que el dinero se maneja en céntimos enteros y da las tarifas. De ahí sale que una hora nunca tiene fracciones de céntimo, y que la más barata es la de vóley sin hora punta con descuento de socio, S/ 50 menos 10 %:
test('una hora nunca cuesta menos de S/ 45 ni tiene fracciones de céntimo', () => {
  fc.assert(
    fc.property(sportArb, planArb, dateArb, fc.integer({ min: 7, max: 21 }), (sport, plan, date, startHour) => {
      const price = quotePriceCents({ sport, plan, date, startHour, hours: 1 });
      assert.ok(Number.isInteger(price));
      assert.ok(price >= 4500);
    }),
  );
});
Otro invariante, de dailySummary: la caja del día suma lo que suma cada
cancha. Con una lista generada de reservas, summary.revenueCents tiene que
ser igual a la suma de revenueCents de summary.courts.
Los invariantes son las propiedades más fáciles de escribir, y las más
débiles: muchos programas equivocados los cumplen. Una función que siempre
devuelve 4500 pasa la primera. Pero detectan cosas que los ejemplos casi nunca
miran, como un NaN que aparece con cierta combinación de entradas o un total
que no cuadra. Y sirven para empezar cuando no se sabe qué más decir.
Ida y vuelta
Si dos funciones son inversas, aplicar una y luego la otra deja todo como estaba. Sale de pares como escribir y leer, codificar y decodificar, guardar y cargar:
test('sumar n días y restarlos deja la misma fecha', () => {
  fc.assert(
    fc.property(dateArb, fc.integer({ min: -400, max: 400 }), (date, n) => {
      assert.equal(addDays(addDays(date, n), -n), date);
    }),
  );
});
La forma daysBetween(d, addDays(d, n)) === n es la que escribirán en el
laboratorio. Otro caso, en
parse-range.test.ts: un rango de
horas escrito como texto "18-20" y vuelto a leer da el mismo rango.
Comparación con un modelo
Un modelo es otra implementación de lo mismo, más simple y obviamente correcta, aunque sea lenta o poco práctica. Kallpa decide si dos bloques se cruzan con una comparación elegante, y la semana 4 ya presentó la idea de contar hora por hora:
// model.ts: dos bloques se cruzan si comparten alguna hora.
export function sharesAnHour(a: Block, b: Block): boolean {
  const own = hoursOf(a);
  return hoursOf(b).some((hour) => own.includes(hour));
}

test('overlaps dice lo mismo que contar hora por hora', () => {
  fc.assert(
    fc.property(blockArb, blockArb, (a, b) => {
      assert.equal(overlaps(a, b), sharesAnHour(a, b));
    }),
  );
});
Para ver qué aporta esto, imaginen una versión de overlaps a la que le falta
un caso:
function overlapsForgetful(a: Block, b: Block): boolean {
  return a.startHour <= b.startHour && b.startHour < a.startHour + a.hours;
}
Pasa las dos pruebas de ejemplo de test/booking.test.ts, porque en ambas a
empieza primero. La comparación con el modelo la encuentra enseguida (make demo D=overlaps-model):
✔ los dos ejemplos de test/booking.test.ts pasan (0.424916ms)
✖ coincide con el modelo: comparten alguna hora (3.263209ms)
...
  Error: Property failed after 2 tests
  { seed: 2026, path: "1:4:4:9", endOnFailure: true }
  Counterexample: [{"startHour":19,"hours":1},{"startHour":18,"hours":2}]
  Shrunk 3 time(s)
...
    false !== true
El bloque de 19:00 a 20:00 y el de 18:00 a 20:00 comparten una hora, y la
función dice que no se cruzan porque a empieza después.
Una observación honesta: este dominio es tan pequeño que se puede recorrer entero, y eso hizo la semana 4 con todos los pares de bloques posibles. Cuando se puede, es mejor que el azar, porque no se escapa ningún caso. Las propiedades con entradas generadas ganan cuando el dominio es demasiado grande: una lista de reservas, un texto, un año de fechas combinado con todas las horas y deportes.
El modelo tiene que ser independiente de verdad. Si para construirlo copian
overlaps, la prueba compara la función consigo misma y pasa siempre. La
pregunta de control es: ¿este modelo está escrito con otra idea, tan simple
que se puede revisar leyéndolo?
Relaciones metamórficas
A veces no se conoce la salida correcta para una entrada, pero sí cómo tiene que cambiar la salida cuando cambia la entrada. Eso es una relación metamórfica: no compara una salida con una respuesta, sino dos salidas entre sí.
En Kallpa la tarifa depende del día de la semana, de la hora y del deporte, y de nada más. Entonces, una semana después, la tarifa es la misma:
test('una semana después, el mismo día de la semana y la misma tarifa', () => {
  fc.assert(
    fc.property(sportArb, dateArb, fc.integer({ min: 7, max: 21 }), (sport, date, hour) => {
      const nextWeek = addDays(date, 7);
      assert.equal(dayOfWeek(nextWeek), dayOfWeek(date));
      assert.equal(hourlyRateCents(sport, nextWeek, hour), hourlyRateCents(sport, date, hour));
    }),
  );
});
Otra: la caja del día no cuenta las reservas canceladas. Entonces, agregar una reserva cancelada a la lista no cambia el resumen:
test('agregar una reserva cancelada no cambia la caja', () => {
  fc.assert(
    fc.property(fc.array(bookingArb(), { maxLength: 30 }), bookingArb(), (bookings, extra) => {
      const before = dailySummary('2026-03-10', COURTS, bookings);
      const after = dailySummary('2026-03-10', COURTS, [...bookings, { ...extra, status: 'cancelled' }]);
      assert.deepEqual(after, before);
    }),
  );
});
Fíjense que esta prueba no sabe cuánto debe dar la caja. Y aun así, si alguien se olvida de filtrar las canceladas, falla. Por eso las relaciones metamórficas son tan útiles donde no hay una respuesta correcta fácil de calcular: un buscador (agregar un filtro no aumenta los resultados), un sistema de recomendación, un modelo numérico, una función de precios con muchas reglas. La relación entre el precio de un socio y el de un regular, que escribirán en el laboratorio, es de esta clase.
Equivalencia con otra implementación
Es parecida a la comparación con un modelo, pero la otra implementación no es más simple: es la anterior. Es el oráculo natural de un refactoring, donde lo que se afirma es exactamente que nada cambia. La versión anterior es, además, el único oráculo que conoce los detalles que nadie documentó.
Supongan que reescriben formatSoles de Kallpa para no pasar por decimales.
Está en differential.ts:
export function formatSolesNoFloat(cents: number): string {
  const soles = Math.trunc(cents / 100);
  const rest = String(cents % 100).padStart(2, '0');
  return `S/ ${soles}.${rest}`;
}
Con céntimos no negativos, las dos versiones dan lo mismo en toda corrida. Si
el generador incluye negativos (make demo D=differential):
  Error: Property failed after 1 tests
  { seed: 2026, path: "0:1:0:0:0:0:0:0:0:0:0:0:0:0:0:0:0", endOnFailure: true }
  Counterexample: [-1]
  Shrunk 16 time(s)
...
    + 'S/ 0.-1'
    - 'S/ -0.01'
Aquí pasa algo que conviene notar. El contraejemplo no dice qué versión tiene razón ni si el caso importa. Le toca a una persona decidir: ¿un monto negativo existe en el dominio? En Kallpa, hoy, no hay precios negativos; si hubiera devoluciones, sí. Las opciones son restringir el generador y dejar escrita esa decisión, o corregir la versión nueva. Lo que no se puede es no decidir. Una comparación diferencial no dice qué está bien; dice qué cambió.
En la industria. SWEG, en el capítulo 14, describe la versión en grande de esto: las pruebas de regresión por diferencias (A/B diff). Se levantan dos copias del sistema (la versión en producción y la candidata), se les manda el mismo tráfico, generalmente una muestra del de producción, y se comparan las respuestas. No hay aserciones sobre el comportamiento correcto. El libro señala que el comportamiento esperado no queda definido y que una persona tiene que revisar las diferencias para ver si son intencionales, y las llama posiblemente la forma más común de prueba grande en Google. Lo que buscan es fidelidad: qué tan bien refleja la prueba el comportamiento real del sistema, algo que una prueba unitaria da poco. A cambio, son caras y dan ruido cuando las respuestas varían por razones legítimas. Es una descripción de cómo trabaja Google con sistemas muy grandes, no una receta para un proyecto de dos personas.
Propiedades sobre secuencias de operaciones
Las cinco clases anteriores miran una función. Pero muchos errores aparecen
solo después de cierta secuencia: reservar, cancelar y volver a reservar. Las
pruebas basadas en modelos con estado (model-based testing) generan secuencias
de operaciones y, tras cada una, comparan el sistema con un modelo simple en
memoria. En fast-check se hace con fc.commands y fc.modelRun, y la
documentación complementaria tiene un ejemplo completo. No la usamos en el
laboratorio; el ejercicio 11 la propone como reto. Cuando falla, el shrinking
reduce la secuencia: de treinta operaciones quedan las tres que importan.
De la especificación a la propiedad
Para encontrar propiedades, lean la especificación y hagan estas preguntas. La tabla usa Kallpa y otro dominio cualquiera:
| Pregunta | Clase | En Kallpa | En otro producto |
|---|---|---|---|
| ¿Qué es siempre cierto de la salida? | Invariante | El precio es un entero positivo | El stock nunca es negativo |
| ¿Hay algo que deshace esta operación? | Ida y vuelta | addDays(d, n) y addDays(_, -n) |
Exportar e importar un CSV |
| ¿Hay una forma lenta y obvia de calcularlo? | Modelo | Contar hora por hora | Ordenar con burbuja y comparar |
| ¿Cómo cambia la salida si cambio la entrada así? | Metamórfica | Una semana después, la misma tarifa | Agregar un filtro no da más resultados |
| ¿Hay otra versión que deba dar lo mismo? | Equivalencia | formatSoles antes y después |
La API v1 y la v2 |
Cuidado con una tentación: las propiedades del álgebra escolar, como a + b === b + a. Pasan siempre y no dicen nada del negocio. El proyecto P3 pide
propiedades “sobre reglas que importan” justamente por eso.
Generadores que llegan a los casos interesantes
Una propiedad solo revisa lo que el generador le da. Si el generador nunca produce el caso que rompe el código, la propiedad pasa y da una falsa seguridad.
Los arbitraries básicos
Los que más van a usar, de la documentación de fast-check:
| Arbitrary | Produce |
|---|---|
fc.integer({ min, max }) |
Enteros en el rango, con preferencia por los bordes |
fc.nat() |
Enteros no negativos |
fc.double() |
Números decimales, incluidos NaN e Infinity |
fc.boolean() |
true o false |
fc.string() |
Textos cortos |
fc.constantFrom('a', 'b') |
Una de las opciones |
fc.array(arb, { maxLength }) |
Listas de valores de arb |
fc.record({ campo: arb }) |
Objetos |
fc.tuple(a, b) |
Pares y tuplas |
fc.oneof(a, b) |
Valores de cualquiera de los arbitraries |
Y se combinan con .map, que transforma lo generado. Un arbitrary construido
con .map conserva el shrinking del original. Para Kallpa, una reserva
completa se arma con fc.record; está en bookingArb de
properties.test.ts.
Construir en vez de filtrar
Quieren fechas válidas. Una primera idea: generar texto y quedarse con lo que
parece fecha, usando fc.pre, que descarta una entrada que no cumple una
precondición:
fc.property(fc.string(), (text) => {
  fc.pre(isValidDate(text));
  return dayOfWeek(text) >= 0 && dayOfWeek(text) <= 6;
});
El resultado (make demo D=too-many-discards):
  Error: Failed to run property, too many pre-condition failures encountered
  { seed: 2026 }

  Ran 0 time(s)
  Skipped 10001 time(s)

  Hint (1): Try to reduce the number of rejected values by combining map, chain and built-in arbitraries
  Hint (2): Increase failure tolerance by setting maxSkipsPerRun to an higher value
  Hint (3): Enable verbose mode at level VeryVerbose in order to check all generated values and their associated status
Ni una sola entrada llegó a la propiedad. No es mala suerte: entre 100 000
textos de fc.string(), ninguno tuvo forma de fecha (make generadores, en
la primera línea). Y fast-check avisa con un error, en lugar de pasar en
silencio, lo cual es una buena decisión de diseño de la herramienta.
La salida es construir la entrada válida directamente:
const dateArb = fc.integer({ min: 0, max: 364 }).map((d) => addDays('2026-01-01', d));Da una fecha válida del 2026 cada vez, sin descartar nada. Y el shrinking lleva naturalmente al 1 de enero.
fc.pre sigue siendo útil cuando descarta pocas entradas y construirlas
sería más enredado. Una reserva de startHour entre 7 y 21 y hours entre 1
y 3 tiene que cumplir startHour + hours <= 22. Eso solo descarta unas pocas
combinaciones, así que fc.pre(startHour + hours <= 22) es razonable, y así
lo usarán en el laboratorio.
Error común. Filtrar con
.filterofc.prelo que se puede construir con.map. Si más de la mitad de lo generado se descarta, el generador está mal planteado, aunque fast-check todavía no se queje.
Mirar qué se genera
Un generador puede ser válido y aun así no llegar a la mitad del dominio. La
herramienta para mirarlo es fc.statistics, que clasifica una muestra grande.
En generators.ts comparamos un generador de
fechas de un mes con el de todo el año:
fc.statistics(weakDate, month, { numRuns: 1000, seed: SEED });$ make generadores
node generators.ts
Textos con forma de fecha entre 100000 de fc.string(): 0
Fechas de un mes: tipo de día
lunes a viernes..79.60%
fin de semana....20.40%
Fechas de un mes: mes
2026-01..82.80%
2026-02..17.20%
Fechas de todo el año: tipo de día
lunes a viernes..72.50%
fin de semana....27.50%
Horas de la reserva (con inicio + horas <= 22): { '1': 334, '2': 359, '3': 230 }Dos cosas se aprenden de esa salida. El generador de un mes nunca pasa de
febrero, de modo que una regla que dependa del mes no se revisa. Y fc.tuple
de hora y duración, filtrada, da menos reservas de 3 horas que de 1 y 2, pero
no muy pocas: el filtro no está sesgando el dominio de manera seria.
Qué medir depende de lo que la regla distingue. Si una regla habla de fin de semana, midan cuántos fines de semana salen. Si habla de reservas que tocan el cierre, midan cuántas lo tocan. Es la misma pregunta que se hacen con la cobertura: ¿por dónde pasó? Pero aquí pregunta por el dominio, no por el código, y los dos pueden responder distinto.
Error común. El generador que nunca produce el caso que importa. Si
hourssiempre es 1, o las fechas siempre son de enero, la propiedad pasa sin haber mirado la mitad del dominio. Es el error más difícil de notar, porque la prueba sale en verde. Antes de confiar en una propiedad, pregúntense qué entrada la haría fallar y comprueben que el generador la puede producir.
Propiedades que no prueban nada
El otro error grave está en la afirmación. Esta propiedad se ve seria:
fc.property(dateArb, hourArb, (date, hour) => {
  assert.equal(isPeakHour(date, hour), isWeekend(date) || hour >= PEAK_START_HOUR);
});
Y pasa siempre, porque es la implementación escrita otra vez. Lo comprueba
tautology.test.ts: si alguien cambia el
inicio de la hora punta a las 12:00, la misma propiedad, con la misma
constante, sigue pasando. No detecta ningún error de la regla, porque usa lo
que debería revisar. Una tautología no es una prueba: es la misma
afirmación dos veces.
El remedio viene de la dirección en que se escribe: la propiedad sale de la
especificación, no del código. El README dice que los sábados y domingos son
hora punta todo el día, y da los montos. Eso se escribe con las fechas y los
números del README, sin pasar por las funciones ni las constantes de
pricing.ts:
// El sábado 3 de enero de 2026, más k semanas.
const saturdayArb = fc.integer({ min: 0, max: 51 }).map((k) => addDays('2026-01-03', 7 * k));

test('un sábado, cualquier hora de fulbito cuesta S/ 112.50', () => {
  fc.assert(
    fc.property(saturdayArb, fc.integer({ min: 7, max: 21 }), (date, hour) => {
      assert.equal(hourlyRateCents('fulbito', date, hour), 11250);
    }),
  );
});
Esta sí puede fallar: si la tarifa, el recargo o la regla del fin de semana cambian, la propiedad se entera. Escribir la regla de lunes a viernes de la misma forma queda como ejercicio.
Una señal práctica para reconocer una tautología: ¿la pueden hacer fallar? Cambien a mano una condición del código bajo prueba y vean si la propiedad lo nota. Las pruebas de mutación, en la segunda parte del capítulo, hacen eso de manera sistemática.
Con IA. Las propiedades son una buena especificación para un agente, porque no se pueden hacer pasar con casos especiales. La semana pasada vimos el riesgo de
if (hours === 2) return 22500. Un ejemplo escrito para la clase, ensplit.ts:splitCentsFakedevuelve la respuesta correcta para los tres ejemplos de la prueba y, para cualquier otra entrada,[totalCents]. Los tres ejemplos pasan. La propiedad “hay una parte por jugador” la encuentra en la primera corrida (make demo D=split-fake:Counterexample: [0,2],1 !== 2). Y al revés: una propiedad escrita por una herramienta hay que leerla como cualquier otra prueba, porque puede ser una tautología. Revisen de dónde salen los valores esperados y si importa constantes o funciones del módulo que está probando.
Fuzzing
Entradas que nadie pensó
Fuzzing es alimentar un programa con muchas entradas generadas, a menudo malformadas, buscando que falle. La historia se cuenta en el primer capítulo de The Fuzzing Book. En 1988, Barton Miller estaba conectado a la computadora de su universidad por una línea telefónica de 1200 baudios durante una tormenta. El ruido de la línea hacía que los comandos de UNIX recibieran basura y se cayeran. Miller se sorprendió y lo convirtió en un trabajo para sus estudiantes. Cuando corrieron los primeros fuzzers, en 1989, encontraron que cerca de un tercio de las utilidades de UNIX que probaron se caían, se colgaban o fallaban de otra forma (Miller y otros, 1990).
Lo distintivo del fuzzing es su oráculo implícito. Una propiedad necesita afirmar algo sobre el resultado; el fuzzing solo exige algo que debe valer para cualquier programa: no se cae, no se cuelga, no responde 500. No hace falta entender las reglas del negocio para exigir eso. MacIver marca la frontera en este punto: las pruebas de propiedades obligan a razonar sobre cómo debe comportarse el programa, y el fuzzing se puede aplicar a cualquier programa casi sin entenderlo. Con fast-check se pueden hacer las dos cosas, y la diferencia está en qué se afirma.
Un fuzzer pequeño
Una liga de vóley manda sus pedidos como texto: "18-20" es de 18:00 a 20:00.
La primera versión del parser, en
parse-range.ts, funciona con todo lo que
la liga ha mandado hasta ahora:
export function parseHourRangeNaive(text: string): HourRange {
  const [start, end] = text.split('-');
  return { startHour: Number(start), hours: Number(end.trim()) - Number(start) };
}
El oráculo: la función puede rechazar una entrada con su propio error,
RangeFormatError, pero no puede caerse con otra cosa.
fc.property(fc.string(), (text) => {
  try {
    parseHourRangeNaive(text);
  } catch (error) {
    if (!(error instanceof RangeFormatError)) throw error;
  }
});
$ make demo D=parse-range
...
Error: Property failed after 1 tests
{ seed: 2026, path: "0:0", endOnFailure: true }
Counterexample: [""]
Shrunk 1 time(s)
...
[cause]: TypeError [Error]: Cannot read properties of undefined (reading 'trim')
at parseHourRangeNaive (file:///work/code/week-10/parse-range.ts:10:56)Un texto sin guion deja end en undefined. Este error lo habría atrapado
TypeScript con la opción noUncheckedIndexedAccess, que tsc no activa con
strict: es un tema de la semana próxima. La versión corregida valida con una
expresión regular y lanza RangeFormatError. Pasa 2000 corridas en
parse-range.test.ts.
Fíjense en lo que el oráculo no detecta. La versión ingenua, con
"abc-def", devuelve { startHour: NaN, hours: NaN } sin caerse, y el
fuzzing no se queja. Un programa que no se cae puede estar calculando
cualquier cosa. El fuzzing busca una clase de error: las fallas abruptas. Y
para detectar el resto hacen falta las propiedades.
Fuzzing de una API: el generador decide hasta dónde se llega
En una API, el oráculo implícito es “no responde 500”. Un 400 o un 404 no son fallas: son la API diciendo que la entrada está mal. Un 500 significa que una entrada llegó a una parte del código que no la esperaba.
fuzz-bookings.ts ataca POST /api/bookings de Kallpa con startTestServer(), el servidor de prueba de
test/helpers.ts, y dos generadores. El primero pone valores de cualquier
tipo en cada campo. El segundo respeta los tipos y genera valores cerca y
lejos de los bordes, con fechas construidas alrededor del “hoy” del reloj de
las pruebas:
export const shapedBody = fc.record({
  courtId: fc.integer({ min: 0, max: 5 }),
  memberId: fc.integer({ min: 0, max: 11 }),
  date: fc.integer({ min: -2, max: 16 }).map((d) => addDays('2026-03-09', d)),
  startHour: fc.integer({ min: 5, max: 23 }),
  hours: fc.integer({ min: 0, max: 5 }),
  teamName: fc.string({ maxLength: 50 }),
});
La propiedad solo afirma que el status no es 500. Además, contamos las respuestas:
$ make fuzz
node fuzz-bookings.ts
Valores de cualquier tipo: { '400 VALIDATION_ERROR': 1000 }
Tipos correctos, valores cerca de los bordes: {
  '422 INVALID_HOURS': 83,
  '200 reserva creada': 113,
  '404 COURT_NOT_FOUND': 273,
  '400 VALIDATION_ERROR': 116,
  '422 TOO_MANY_HOURS': 154,
  '422 IN_THE_PAST': 35,
  '422 OUTSIDE_OPENING_HOURS': 76,
  '404 MEMBER_NOT_FOUND': 99,
  '409 SLOT_TAKEN': 32,
  '422 TOO_FAR_AHEAD': 19
}
Ninguno de los dos encontró un 500. Pero los números muestran algo más importante. Con valores de cualquier tipo, las 1000 solicitudes se quedaron en la primera validación: el código de las reglas, el precio y la base de datos ni siquiera corrió. Una corrida en verde de ese generador solo dice que la validación de la entrada no se cae. Con el segundo, las solicitudes llegan a diez respuestas distintas, y 113 reservas se crearon de verdad.
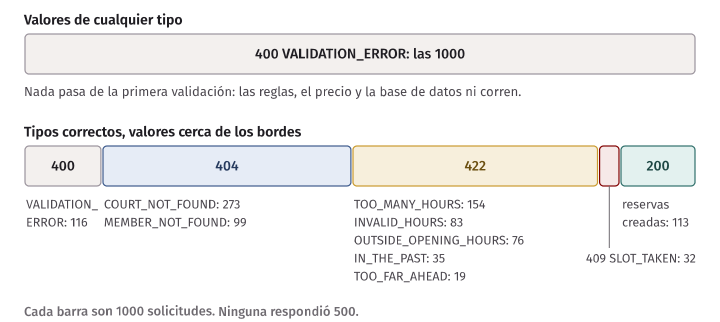
Idea clave. Un fuzzer que no encuentra nada no demuestra que no haya nada. Antes de confiar en el resultado, miren hasta dónde llegaron las entradas.
Dos notas para quien haga esto en su proyecto. Las respuestas que no son 500
también pueden estar mal: una reserva creada con datos absurdos es un error, y
este oráculo no lo ve. Y un fuzzer que golpea la API crea datos, así que tiene
que correr contra una base de datos de prueba, como :memory:, nunca contra
la real.
Fuzzers basados en generadores y guiados por cobertura
Lo que acabamos de hacer es fuzzing basado en generadores: las entradas salen de una descripción de su forma, sin mirar qué hace el programa con ellas. Es simple y sirve para empezar, sobre todo con entradas estructuradas como un JSON.
Los fuzzers guiados por cobertura, como AFL y libFuzzer, usan otra
estrategia: instrumentan el programa, y cuando una entrada llega a código que
ninguna anterior había tocado, la guardan y la usan de base para mutaciones
nuevas (cambiar bytes, cortar, combinar). Así avanzan solos a través de las
capas de un programa, sin que nadie les describa la forma de la entrada. Son
la herramienta de elección para parsers, formatos binarios y código en C o
C++, donde una entrada rara puede corromper la memoria. Se dejan corriendo
durante horas o días, no los segundos que toma una prueba de make test.
En la industria. Google opera OSS-Fuzz, un servicio gratuito que corre fuzzers guiados por cobertura sobre proyectos de código abierto y avisa en privado de lo que encuentra. Su página dice que nació en 2016 a raíz de Heartbleed, una vulnerabilidad de OpenSSL que se pudo haber detectado con fuzzing, y que hasta agosto de 2023 había ayudado a identificar y corregir más de 10 000 vulnerabilidades y 36 000 errores en 1000 proyectos. Es la cuenta que el mismo proyecto publica de sus logros, no un estudio independiente, y no dice qué fracción de los errores de esos proyectos representa. Sirve como orden de magnitud de lo que se encuentra con recursos grandes y corriendo sin parar.
Qué hacer con un hallazgo
Cuando el fuzzing encuentra una falla, se sigue el mismo procedimiento de siempre, con un paso previo:
- Reproducirla fuera de la prueba: con
curlcontra el servidor, si es una API. Una falla que solo existe dentro del fuzzer puede ser un problema del propio fuzzer. - Leer el log del servidor. El 500 dice que algo falló; la pila de llamadas dice dónde.
- Decidir cuál es la respuesta correcta. “No 500” no dice qué debe responder la API. Vayan a la tabla de errores y justifiquen la elección.
- Convertir la entrada en una prueba de ejemplo con la respuesta esperada.
- Corregir, y volver a correr todo.
Pruebas de mutación
La pregunta que la cobertura no responde
La semana pasada se preguntaron qué herramienta delataría una prueba con 100 %
de cobertura que no verifica nada. Aquí está el caso concreto. Un vale de
descuento de la junta vecinal, en
mutation/voucher.ts, otro ejemplo
pequeño que no es parte de Kallpa:
export function amountDueCents(totalCents: number, voucherCents: number): number {
  if (voucherCents >= totalCents) return 0;
  return totalCents - voucherCents;
}

export function applyVouchers(totalCents: number, vouchers: readonly number[]): number {
  let due = totalCents;
  for (let i = 0; i < vouchers.length; i++) {
    due = amountDueCents(due, vouchers[i]);
  }
  return due;
}
Y una prueba que pasa por todas partes sin mirar casi nada:
test('calcula el monto a pagar', () => {
  assert.equal(typeof amountDueCents(9000, 1000), 'number');
  assert.equal(typeof amountDueCents(1000, 9000), 'number');
  assert.equal(typeof applyVouchers(9000, [1000, 500]), 'number');
});
$ cd mutation && node --test --experimental-test-coverage voucher.weak.test.ts
✔ calcula el monto a pagar (0.566042ms)
...
ℹ start of coverage report
ℹ -----------------------------------------------------------
ℹ file | line % | branch % | funcs % | uncovered lines
ℹ -----------------------------------------------------------
ℹ voucher.ts | 100.00 | 100.00 | 100.00 |
ℹ -----------------------------------------------------------
ℹ all files | 100.00 | 100.00 | 100.00 |
ℹ -----------------------------------------------------------
ℹ end of coverage reportCien por ciento de líneas, de ramas y de funciones. La cobertura mide por dónde pasó la ejecución. No puede decir si alguien miró el resultado.
Qué es un mutante
La pregunta que sí responde es esta: si el código tuviera un error aquí, ¿alguna prueba fallaría? Para contestarla, se le mete el error de verdad.
Un mutante es una copia del programa con un cambio pequeño: >= por >,
+ por -, una condición reemplazada por true, un bloque vaciado, un texto
cambiado. Las reglas que producen esos cambios se llaman operadores de
mutación (mutators). Las pruebas de mutación (mutation testing) corren
la suite contra cada mutante:
- Si alguna prueba falla, el mutante muere (killed). La suite notó el cambio.
- Si todas pasan, el mutante sobrevive (survived). Hay un comportamiento del código que se puede cambiar sin que ninguna prueba se entere.
Algunos operadores de StrykerJS, la herramienta que usamos. La lista completa está en Supported mutators:
| Operador | Original | Mutado |
|---|---|---|
| Aritmético | a + b, a * b |
a - b, a / b |
| Igualdad | a < b |
a <= b, a >= b |
| Igualdad | a >= b |
a > b, a < b |
| Igualdad | a === b |
a !== b |
| Lógico | a && b |
a || b |
| Condicional | if (a > b) |
if (true), if (false) |
| Bloque | { ...código } |
{} |
| Texto | 'hola' |
"" |
| Incremento | i++ |
i-- |
| Regex | \d |
\D |
Un mutante es deliberadamente pequeño y no intenta parecerse a un error “inteligente”. Esa decisión se justifica más abajo.
Correr Stryker
StrykerJS necesita un archivo de configuración. Este es el de los ejemplos, en
mutation/stryker.weak.json:
{
  "testRunner": "tap",
  "tap": { "testFiles": ["voucher.weak.test.ts"], "nodeArgs": ["--test-reporter=tap"] },
  "mutate": ["voucher.ts"],
  "reporters": ["clear-text", "json"],
  "jsonReporter": { "fileName": "reports/weak.json" },
  "plugins": ["@stryker-mutator/tap-runner"]
}
testRunner: "tap"y el plugintap-runner: Stryker entiende el protocolo TAP (Test Anything Protocol), una forma de texto de reportar resultados. El runner de Node sabe escribirlo con--test-reporter=tap.tap.testFiles: qué archivos de prueba correr.mutate: qué archivos mutar. Solo código de producción, nunca las pruebas.reporters:clear-texten la terminal,htmlpara un reporte navegable,jsonpara procesarlo con un programa.
Stryker copia el proyecto a una carpeta temporal .stryker-tmp, le inserta
todos los mutantes a la vez detrás de un interruptor que decide cuál está
activo, y hace una corrida inicial con todas las pruebas. Si alguna falla
en esa corrida inicial, Stryker no arranca, porque no tendría sentido culpar a
un mutante de un fallo que ya estaba.
Esto sale con la prueba débil (make mutantes S=weak; aquí se omiten las
líneas de inicio y cinco de los nueve sobrevivientes):
[Survived] ConditionalExpression
voucher.ts:4:7
-     if (voucherCents >= totalCents) return 0;
+     if (true) return 0;
Tests ran:
    voucher.weak.test.ts


[Survived] EqualityOperator
voucher.ts:4:7
-     if (voucherCents >= totalCents) return 0;
+     if (voucherCents > totalCents) return 0;
Tests ran:
    voucher.weak.test.ts


[Survived] ArithmeticOperator
voucher.ts:5:10
-     return totalCents - voucherCents;
+     return totalCents + voucherCents;
Tests ran:
    voucher.weak.test.ts


[Survived] BlockStatement
voucher.ts:11:45
-     for (let i = 0; i < vouchers.length; i++) {
-       due = amountDueCents(due, vouchers[i]);
-     }
+     for (let i = 0; i < vouchers.length; i++) {}
Tests ran:
    voucher.weak.test.ts


Ran 0.92 tests per mutant on average.
------------|------------------|----------|-----------|------------|----------|----------|
            | % Mutation score |          |           |            |          |          |
File        |  total | covered | # killed | # timeout | # survived | # no cov | # errors |
------------|--------|---------|----------|-----------|------------|----------|----------|
All files   |  25.00 |   25.00 |        2 |         1 |          9 |        0 |        0 |
 voucher.ts |  25.00 |   25.00 |        2 |         1 |          9 |        0 |        0 |
------------|--------|---------|----------|-----------|------------|----------|----------|
Cien por ciento de cobertura, 25 % de mutation score. Sumar en lugar de restar no lo nota nadie. Vaciar el bucle de los vales, tampoco. Cada mutante sobreviviente es una frase concreta: “este cambio de comportamiento no lo fija ninguna prueba”.
Los estados de un mutante y el score
| Estado | Qué pasó | ¿Cuenta como detectado? |
|---|---|---|
| Killed | Alguna prueba falló | Sí |
| Timeout | Las pruebas no terminaron: el mutante se colgó | Sí |
| Survived | Las pruebas pasaron por ahí, y todas pasaron | No |
| No coverage | Ninguna prueba ejecuta esa línea | No |
| Runtime error, compile error | El mutante no se pudo evaluar | Queda fuera del cálculo |
| Ignored | Alguien lo marcó para no probarlo | Queda fuera del cálculo |
El timeout cuenta como detectado por una razón práctica: un cambio que cuelga
el programa también colgaría la integración continua, y alguien se enteraría.
En el vale, el único timeout es el mutante que cambia i++ por i--: el
bucle no termina nunca. La página de estados de
Stryker
los define así.
Las fórmulas son:
detectados = killed + timeout
no detectados = survived + no coverage

mutation score (total)   = detectados / (detectados + no detectados)
mutation score (covered) = detectados / (detectados + survived)
En el ejemplo: (2 + 1) / 12 = 25 %, en las dos columnas, porque no hay
mutantes sin cobertura. Las dos columnas dicen cosas distintas cuando sí los
hay: covered pregunta qué tan bien revisan las pruebas el código por el que
pasan, y total castiga además el código que ninguna prueba toca. Si total
es mucho menor que covered, el primer problema es que falta correr código;
si covered también es bajo, el problema son las aserciones.
Leer un sobreviviente: ¿hueco o equivalente?
Con valores esperados de verdad, en
mutation/voucher.test.ts, la
historia cambia (make mutantes S=strong):
[Survived] EqualityOperator
voucher.ts:4:7
-     if (voucherCents >= totalCents) return 0;
+     if (voucherCents > totalCents) return 0;
Tests ran:
    voucher.test.ts


Ran 0.92 tests per mutant on average.
------------|------------------|----------|-----------|------------|----------|----------|
            | % Mutation score |          |           |            |          |          |
File        |  total | covered | # killed | # timeout | # survived | # no cov | # errors |
------------|--------|---------|----------|-----------|------------|----------|----------|
All files   |  91.67 |   91.67 |       10 |         1 |          1 |        0 |        0 |
 voucher.ts |  91.67 |   91.67 |       10 |         1 |          1 |        0 |        0 |
------------|--------|---------|----------|-----------|------------|----------|----------|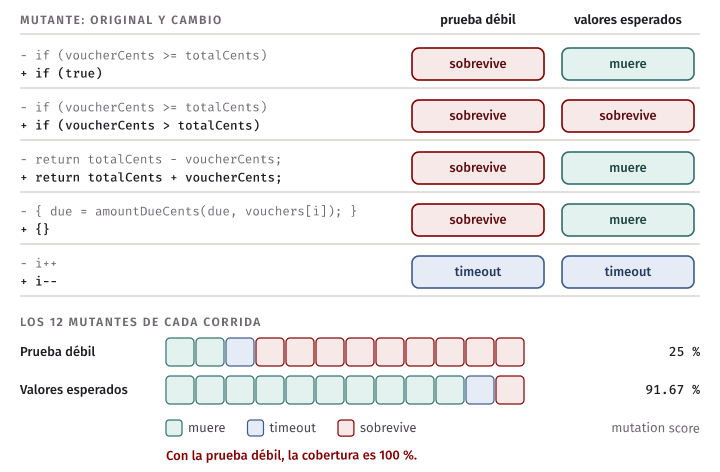
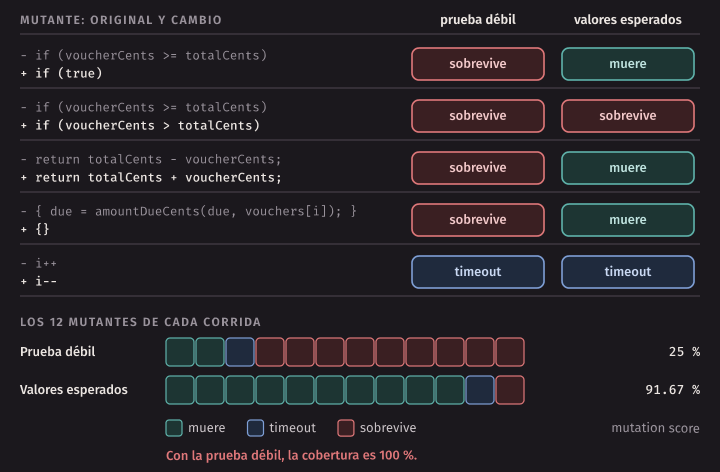
Queda uno. Y la suite ya tiene una prueba justo para el borde:
amountDueCents(1000, 1000) da 0. ¿Falta otra? Lean el mutante con cuidado.
Solo difiere del original cuando voucherCents === totalCents. En el
original, se devuelve 0. En el mutante, la condición es falsa y se ejecuta
totalCents - voucherCents, que con dos valores iguales da 0. Con céntimos
enteros, siempre lo mismo.
Ese es un mutante equivalente: un cambio en el código que no altera ningún
comportamiento observable dentro del dominio de la función. Ninguna prueba que
respete ese dominio lo puede matar, porque no hay nada que notar. No indica un
hueco, y escribir pruebas contra él es perder el tiempo. La aclaración del
dominio importa: en JavaScript, amountDueCents(Infinity, Infinity) da 0 en el
original y NaN en el mutante, porque Infinity - Infinity es NaN. La
equivalencia se afirma para las entradas que el programa admite, y el contrato
de la función es el que dice cuáles son: aquí, céntimos enteros. Otro ejemplo clásico de la teoría, cambiar i < n por i != n en un
for que solo avanza de uno en uno, se ve igual, aunque ese en particular no
lo produce Stryker, que cambia < por <= y >=.
Decidir si un mutante es equivalente puede ser difícil. En general es un problema indecidible, y no hay herramienta que lo resuelva siempre. En la práctica, el procedimiento para cada sobreviviente es este:
- Buscar una entrada donde el mutante y el original den resultados distintos. Para comparaciones, esa entrada casi siempre está en el borde exacto.
- Si la encuentran, es un hueco. Escriban la prueba con esa entrada. El valor esperado sale de la especificación. Si lo sacan del código, solo fijan lo que el código hace hoy, aunque esté mal.
- Si no la encuentran, escriban el argumento, como arriba: en qué caso difieren las dos versiones y por qué da lo mismo. Si el argumento se sostiene, es equivalente.
- Márquenlo y sigan. Stryker permite dejarlo escrito en el código, con su razón:
// Stryker disable next-line EqualityOperator: con voucher === total, el resto ya da 0.
if (voucherCents >= totalCents) return 0;
Con ese comentario, en
mutation/voucher-marked.ts, el
mutante queda como Ignored y deja de contar. El comentario tiene valor
propio: quien lea después sabe que alguien lo pensó. Pero miren el reporte con
cuidado: el comentario apaga todos los EqualityOperator de esa línea, y por
lo tanto también el mutante voucherCents < totalCents, que no es equivalente.
Marcar tiene un costo, así que escriban primero la prueba de lo que sí se puede
matar y verifiquen qué quedó apagado. También se puede no marcar nada y dejar
escrito el argumento en el pull request.
También hay sobrevivientes que no son equivalentes y que no vale la pena
matar. Un texto de un mensaje de error cambiado por "" sobrevive si ninguna
prueba mira los mensajes. Puede estar bien: los clientes HTTP comparan el
código de error, como dice el README, no el mensaje. Si el mensaje no es parte
del contrato, no lo fijen. Una prueba de cada texto solo hace más caro
cambiarlo.
Error común. Matar un mutante escribiendo la aserción que el código hoy satisface, sin mirar la especificación. Sube el score y congela lo que hay, incluidos sus errores. Si no pueden decir de qué línea del README sale el valor esperado, primero averigüen cuál es la regla.
Por qué funciona
Un mutante cambia un solo símbolo y los errores reales pueden ser mucho más enredados. ¿Por qué medir contra algo tan simple? La justificación clásica (DeMillo, Lipton y Sayward, 1978) tiene dos hipótesis:
- La hipótesis del programador competente. Quien escribe el código suele estar cerca: los errores reales suelen estar a un cambio pequeño del programa correcto.
- El efecto de acoplamiento. Las pruebas que detectan los errores simples
suelen detectar también los compuestos. Quien nota el
>=cambiado probablemente notaría también algo más raro en esa misma condición.
Son hipótesis, no teoremas, y se han estudiado. El estudio más citado es el de Just y otros, Are Mutants a Valid Substitute for Real Faults in Software Testing? (FSE 2014). Tomaron 357 errores reales, ya corregidos por sus desarrolladores, de cinco aplicaciones Java de código abierto (321 000 líneas en total) y compararon lo que detectaban los conjuntos de pruebas. Midieron dos cosas. Sobre el acoplamiento: el 73 % de los errores reales estaban acoplados a mutantes de los operadores comunes; un 10 % habría requerido operadores nuevos o más fuertes, y un 17 % no estaba acoplado a ningún mutante. Sobre la correlación: detectar mutantes se correlaciona con detectar errores reales, y de forma más fuerte que la cobertura de sentencias.
Hay que leer bien eso. Es una correlación medida en cinco programas Java, no una ley; no dice qué score alcanza para confiar. Y ese 17 % importa: hay errores reales que ningún mutante representa. Por ejemplo, una regla del negocio que el código simplemente no implementa: no hay línea que mutar.
Costo y práctica
Hay que correr la suite muchas veces. Stryker reduce ese costo con el análisis
de cobertura perTest: en la corrida inicial anota qué pruebas pasan por cada
mutante, y para cada mutante corre solo esas. El mensaje del log lo dice:
INFO DryRunExecutor Starting initial test run (tap test runner with "perTest" coverage analysis). This may take a while.Pero hay una limitación que depende del runner. La documentación del Tap
Runner lo aclara:
para él, una prueba es un archivo, y cada archivo corre en su propio
proceso. Por eso el reporte dice Tests ran: voucher.test.ts, y por eso no
dice qué test() mató a cada mutante. También por eso conviene no meter en
tap.testFiles un archivo lento: el fuzzing de una API haría cientos de
solicitudes HTTP por cada mutante. Para un módulo de dominio, como los de
Kallpa, Stryker tarda unos pocos segundos; en un monolito grande, horas.
En la industria. Petrović e Ivanković, en State of Mutation Testing at Google (ICSE SEIP 2018), describen cómo se aplica en un repositorio de unos 2000 millones de líneas. No calculan un score global: dicen que es inviable por costo, y que tampoco encontraron cómo mostrárselo a los ingenieros de una forma que llevara a actuar. En cambio, la mutación se muestra en la revisión de código: solo sobre las líneas que cambió el pull request, a lo más un mutante por línea, y descartando las líneas “áridas” que no aportan (por ejemplo, las de logs). El mutante vivo aparece como un comentario en el diff. Quien lo recibe puede marcarlo como no útil con un clic, y con esa información afinaron los filtros. El artículo reporta 6000 ingenieros usándolo, más de 70 000 diffs evaluados, 1.1 millones de mutantes probados y 150 000 hallazgos mostrados, y que la utilidad reportada por los desarrolladores subió del 20 % al 80 %. Los límites: lo escribe el equipo que construyó el sistema, la utilidad es la que reportan los usuarios con ese clic, y mide la herramienta en su flujo, no si reduce los errores que llegan a producción. Lo que se puede llevar a un proyecto pequeño es la idea: la mutación es un comentario concreto sobre un cambio, no un número para la gerencia.
Para un equipo como el de ustedes, las pruebas de mutación tienen sentido en los módulos con reglas de negocio, no en todo el repositorio. Córranlas cuando cambien esas reglas, lean los sobrevivientes y decidan caso por caso. P3 lo propone sobre su módulo de reglas.
Error común. Perseguir el 100 % de mutation score, o leerlo como “el código es correcto”. Un score alto dice que las pruebas notan los cambios en el código probado. No dice nada de un requisito que nadie entendió bien ni de una regla que el código no implementa. La sección siguiente tiene un caso real con 100 %.
El problema del oráculo
Quién sabe la respuesta
Toda prueba tiene dos partes: ejecutar y juzgar. Ejecutar se puede automatizar sin problema. Juzgar requiere algo que diga si el resultado es correcto. Eso es un oráculo: un mecanismo que decide si la salida de una prueba es la correcta. Y conseguir uno es el problema del oráculo: para muchos programas, saber cuál es la salida correcta es tan difícil como calcularla. Elaine Weyuker llamó “no probables” (non-testable) a los programas para los que no existe un oráculo practicable, en On Testing Non-Testable Programs (1982). Barr y otros hacen un panorama del tema en The Oracle Problem in Software Testing: A Survey (IEEE TSE, 2015).
Durante este capítulo han usado varias fuentes de oráculo sin llamarlas así:
| Fuente | Qué es | Fuerza | Límite |
|---|---|---|---|
| Ejemplos de la especificación | “Una hora de fulbito en hora punta: S/ 112.50” | Exacto, lo acuerda el cliente | Pocos casos |
| Propiedades e invariantes | “La caja suma lo de cada cancha” | Cubre todo el dominio | Solo revisa parte del resultado |
| Modelo | Contar hora por hora | Respuesta completa | Solo si existe uno simple |
| Otra implementación o versión anterior | formatSoles de antes |
No requiere entender la regla | No dice cuál está bien |
| Relaciones metamórficas | “Una semana después, la misma tarifa” | Sirve sin saber la respuesta | Muchos programas errados la cumplen |
| Oráculo implícito | “Nunca responde 500” | Gratis y universal | Solo ve fallas abruptas |
Ninguna basta sola. Se combinan según lo que se pueda conseguir en cada lugar. Y las pruebas de mutación no son un oráculo: miden cuánto revisan los oráculos que ya tienen. Una suite con oráculos equivocados puede tener un score altísimo.
Oráculos para código generado
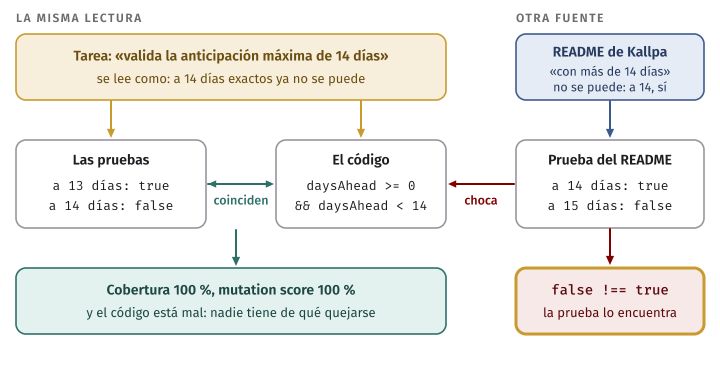
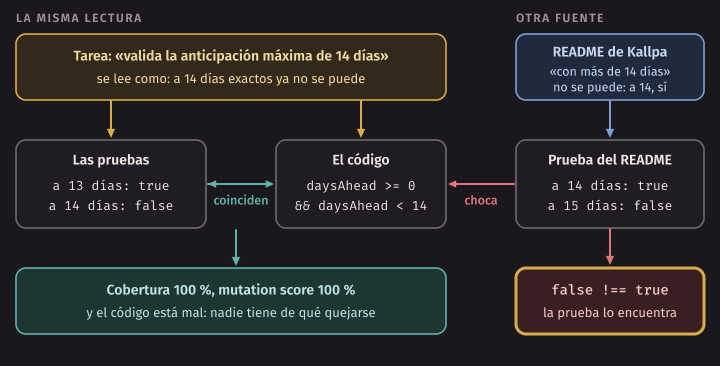
Un agente de programación puede escribir una función y sus pruebas en un minuto. Todas salen en verde. ¿Qué garantiza eso? Mucho menos de lo que parece, porque las pruebas y el código salen de la misma lectura de la tarea. Si la lectura está mal, las dos cosas están mal de la misma manera y coinciden. Esas pruebas comparten los malentendidos del código, así que no son un oráculo independiente.
Un caso escrito para la clase: un cambio como los que suele proponer un agente
cuando se le pide “valida la anticipación máxima de 14 días”. El código, en
mutation/booking-window.ts:
export const WINDOW_DAYS = 14;

export function isWithinBookingWindow(daysAhead: number): boolean {
  return daysAhead >= 0 && daysAhead < WINDOW_DAYS;
}
Y sus pruebas, en booking-window.test.ts:
test('hoy está dentro de la ventana', () => assert.equal(isWithinBookingWindow(0), true));
test('ayer está fuera de la ventana', () => assert.equal(isWithinBookingWindow(-1), false));
test('a 13 días está dentro de la ventana', () => assert.equal(isWithinBookingWindow(13), true));
test('a 14 días está fuera de la ventana', () => assert.equal(isWithinBookingWindow(14), false));
Las pruebas incluso revisan el borde. Se ven impecables. Las métricas también:
$ make mutantes S=window
...
All tests/booking-window.test.ts
  ✓ booking-window.test.ts (killed 10)
Ran 1.00 tests per mutant on average.
-------------------|------------------|----------|-----------|------------|----------|----------|
                   | % Mutation score |          |           |            |          |          |
File               |  total | covered | # killed | # timeout | # survived | # no cov | # errors |
-------------------|--------|---------|----------|-----------|------------|----------|----------|
All files          | 100.00 |  100.00 |       10 |         0 |          0 |        0 |        0 |
 booking-window.ts | 100.00 |  100.00 |       10 |         0 |          0 |        0 |        0 |
-------------------|--------|---------|----------|-----------|------------|----------|----------|
Cien por ciento de cobertura y cien por ciento de mutation score. Y el
código está mal. El README de Kallpa dice que no se puede reservar “con más
de 14 días de anticipación”: a 14 días exactos, sí se puede. La prueba del
agente afirma lo contrario, y como el código hace lo mismo, ninguna
herramienta tiene de qué quejarse. Una sola prueba escrita desde el README lo
encuentra (make demo D=window-readme):
test('a 14 días se puede reservar; a 15, no', () => {
  assert.equal(isWithinBookingWindow(14), true);
  assert.equal(isWithinBookingWindow(15), false);
});
✖ a 14 días se puede reservar; a 15, no (0.804334ms)
AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:
false !== trueEste ejemplo muestra lo que cada herramienta ve. La cobertura ve por dónde se pasó. La mutación ve si las pruebas notan cambios. Lo único que ve el malentendido es algo que no salió de la misma lectura del requisito.
Qué es independiente de verdad
Cuando un agente escribe el código, estas fuentes sí son independientes:
- La especificación escrita antes: los criterios de aceptación, el README de Kallpa, el contrato de la semana 4. Tiene que existir antes del código. Una especificación generada después del código a partir de él es una descripción de lo que hace.
- Las propiedades que escribe el equipo, a partir de esa especificación.
- La versión anterior del código, cuando el cambio dice ser un refactoring o “no cambia el comportamiento”. Si la descripción lo dice, se puede comprobar con una comparación diferencial.
- Las pruebas de mutación, con una condición: miden si las pruebas del agente verifican algo. Un score bajo es una señal clara de que no lo hacen. Un score alto no dice que la especificación se haya entendido bien.
Y estas no lo son: las pruebas que el mismo agente escribió junto con el código, un resumen del mismo agente de lo que hizo (“corrí las pruebas y todas pasan”), y una segunda pasada que parte de lo que ya escribió el agente sin mirar la especificación.
Con IA. Un protocolo razonable para aceptar un cambio de un agente, en este orden. (1) Lean el diff, y comprueben que no tocó pruebas que no debía (semana 9). (2) Corran la suite de ustedes, no solo las pruebas nuevas. (3) Busquen en la especificación los bordes de la regla que tocó, y escriban ustedes los casos de esos bordes, con los valores que dice la especificación. (4) Si dice que no cambia el comportamiento, compárenlo con la versión anterior. (5) Corran Stryker sobre el módulo y lean los sobrevivientes de las líneas que cambiaron. La afirmación “corrí las pruebas y pasan” solo dice que las pruebas que existían no lo vieron. Comprobar es parte del trabajo, y sigue siendo de ustedes aunque el código no lo sea.
El laboratorio: encontrar los errores
El laboratorio aplica el capítulo a Kallpa, en parejas. La guía completa, paso a paso, está en la guía de la semana. Este capítulo no da las respuestas: sus ejemplos enseñan las técnicas sin resolver los pasos. Aquí van los puntos que más cuestan.
La copia limpia. El paso 1 copia Kallpa tal como se publicó, en
/work/kallpa-semana10, en lugar de usar su repositorio. Los cambios de sus
laboratorios anteriores podrían hacer que los diffs no apliquen. La carpeta
/kallpa-*/ ya está en el .gitignore del curso.
Las propiedades de precios. Salen del README, y van a generar las cinco
cosas de las que depende el precio: deporte, plan, fecha, hora de inicio y
horas. Usen dateArb de este capítulo para las fechas y fc.pre(startHour + hours <= 22). No fijen la semilla. Si una propiedad falla, sigan el
procedimiento: leer el contraejemplo, comprobarlo con la tabla del README,
escribirlo como prueba de ejemplo, y recién corregir. Si una propiedad pasa,
no concluyan todavía que no hay nada: córranla varias veces y miren si el
generador produce lo que la regla distingue.
El fuzzing de la API. La URL se arma con el texto generado en medio:
algunos textos cambian de ruta (porque tienen / o ?). Eso está bien:
pedimos solo que nada responda 500. La prueba tiene que consumir la respuesta
y no suponer que es JSON. Para reproducir lo que encuentren, usen make start
y curl en otra terminal; ./env/run.sh abre una segunda shell en el mismo
contenedor.
Stryker. Copien stryker.config.json, agreguen a tap.testFiles sus
archivos nuevos de los pasos 2 y 3, y no el de fuzzing. El archivo del
calendario no ejecuta pricing.ts ni booking.ts, los dos únicos que se
mutan, y el reporte lo muestra con covered 0: es normal. El reporte completo
queda en reports/mutation/mutation.html; ábranlo desde su máquina, porque la
carpeta está montada. El .gitignore de Kallpa ya ignora reports/ y
.stryker-tmp/.
Los sobrevivientes. Para cada uno, sigan el procedimiento de arriba: buscar una entrada que los distinga y sacar el valor esperado del README, no del código. Para muchos, la entrada está en el borde exacto de una regla.
Los diffs del paso 6. Cada agente-*.diff es una ilustración escrita para
la clase: un cambio como los que suele proponer un agente, con la tarea y la
descripción que lo acompaña. Primero léanlo como en una revisión: ¿lo que dice
la descripción es lo que hace el código? Cada uno tiene al menos un error, y
con las 40 pruebas publicadas pasan los tres. Algunos los verán sus pruebas y
otros no. Las diferencias entre uno y otro son lo más importante del
laboratorio: cuando sus pruebas no encuentren un error, pregúntense qué clase
de oráculo le falta a la suite, no solo qué caso.
La tabla del pull request. Por cada error: qué técnica lo encontró y qué prueba lo evita ahora. Y en su registro de uso de IA, qué habrían aceptado de cada diff si no hubieran tenido estas pruebas.
Sin entregas esta semana, pero P3 se entrega la semana 11 y pide propiedades
sobre sus reglas de negocio
(projects/p3-calidad/README.md). Lo de
hoy se traslada directamente a su proyecto.
El código de la semana y make test
La carpeta code/week-10 tiene:
| Archivo | Qué es |
|---|---|
split.ts, split.test.ts |
Dividir un pago: la versión ingenua, la hecha a la medida de los ejemplos y la correcta |
model.ts, properties.test.ts |
Una propiedad de cada clase sobre el dominio de Kallpa |
differential.ts |
Un refactoring de formatSoles para comparar con la versión anterior |
tautology.test.ts |
Una propiedad que repite la implementación y no detecta nada |
generators.ts, generators.test.ts |
Qué producen los generadores |
parse-range.ts, parse-range.test.ts |
El parser de la liga y su fuzzing |
fuzz-bookings.ts, fuzz-bookings.test.ts |
Fuzzing de POST /api/bookings con dos generadores |
mutation/ |
El vale de descuento, la ventana de reserva y sus configuraciones de Stryker |
mutation.test.ts |
Corre Stryker sobre mutation/ y comprueba los números de este capítulo |
demos/, demos.test.ts |
Las demostraciones que fallan a propósito, y la prueba de que fallan como dice el capítulo |
stryker.config.json, agente-*.diff |
El material del laboratorio |
lab.test.ts |
Comprueba que ese material aplica y corre sobre la Kallpa publicada |
Dentro del contenedor del curso:
$ cd code/week-10
$ make test
mkdir -p build
tsc -p .
eslint .
node --test "*.test.ts"
...
ℹ tests 47
ℹ suites 11
ℹ pass 47
ℹ fail 0
...
make test revisa los tipos con tsc y el estilo con ESLint, y corre las
pruebas. Las que están en demos/ no se corren directamente, porque fallan a
propósito: demos.test.ts las lanza una por una y comprueba que fallen con el
contraejemplo que muestra este capítulo. Lo mismo hace mutation.test.ts con
Stryker: los números de esas tablas no están solo copiados aquí, también se
verifican. Nada de esto modifica kallpa/: lo que se copia o se genera queda
en build/.
make demo D=<nombre> corre una demostración, make generadores y make fuzz muestran las salidas de este capítulo, make cobertura la cobertura,
make mutantes S=weak (o strong, marked, window) corre Stryker, y make clean borra build/.
Resumen
- Una propiedad afirma algo sobre todas las entradas de un dominio. Una prueba basada en propiedades intenta refutarla con entradas generadas. Si no lo logra, la propiedad queda sin refutar, no demostrada.
- En fast-check: los arbitraries generan entradas,
fc.propertylas une con un predicado, yfc.assertcorre 100 entradas por omisión y se detiene en el primer contraejemplo. - El shrinking simplifica el contraejemplo hasta donde sabe. Es una búsqueda local, no da necesariamente el mínimo global. La semilla y el camino repiten la corrida. El contraejemplo se comprueba a mano y se convierte en una prueba de ejemplo.
- Las cinco clases de propiedades son invariantes, ida y vuelta, comparación con un modelo, relaciones metamórficas y equivalencia con otra implementación. Las propiedades salen de la especificación, no del código. Una propiedad que repite la implementación es una tautología.
- Los generadores deciden qué se revisa: construir en lugar de filtrar, y
mirar con
fc.statisticsqué se generó. - El fuzzing busca fallas con un oráculo implícito: no caerse, no colgarse, no responder 500. Un fuzzer que no encontró nada no demuestra nada si sus entradas no pasaron de la validación. Los fuzzers guiados por cobertura guardan lo que llega a código nuevo y mutan a partir de ahí.
- Las pruebas de mutación miden la suite: un mutante es una copia con un cambio pequeño; muere si alguna prueba falla y sobrevive si todas pasan. La cobertura puede ser 100 % con un mutation score de 25 %.
- Un sobreviviente es un hueco (se escribe la prueba, con el valor de la especificación) o un mutante equivalente (se argumenta, se marca y se sigue). El método se apoya en dos hipótesis con evidencia empírica parcial: la del programador competente y el efecto de acoplamiento.
- En Google, la mutación se muestra en la revisión de código, sobre las líneas del cambio. Es un comentario concreto, no un número.
- El problema del oráculo: alguien tiene que saber cuál es la salida correcta. Las pruebas que escribe la misma herramienta que escribió el código no son un oráculo independiente. Con 100 % de cobertura y 100 % de mutation score, el código puede seguir mal: lo independiente es la especificación escrita antes, las propiedades del equipo y la versión anterior.
Ejercicios
- Clasifiquen estas propiedades (invariante, ida y vuelta, modelo,
metamórfica o equivalencia) y digan de qué regla del README de Kallpa sale
cada una: (a) una reserva cuesta lo mismo en las dos canchas de fulbito;
(b) la disponibilidad de un día sin reservas tiene 15 horas; (c) a las
10:00, una hora de fulbito un sábado cuesta 25 % más que el martes
anterior; (d)
formatSolesda lo mismo antes y después de un cambio. - Corran
make demo D=split-naive, quitenseed: 2026del archivo y córranlo cinco veces. ¿Qué contraejemplos aparecen? ¿Cuál reportarían en un issue, y por qué? Para el más simple que vean, comprueben la cuenta a mano. Repitan connumRuns: 1000y comparen. Devuelvan el archivo a como estaba omake testva a fallar. - Una propiedad sobre una función de descuentos falla con
["socio", 7, 38]y, después del shrinking, fast-check reporta["regular", 0, 10]. ¿Qué hizo el runner para llegar ahí? ¿Por qué el segundo contraejemplo es más útil que el primero? ¿Qué podrían concluir del hecho de queplanse redujo aregulary que el primer número llegó a 0? ¿Cómo repetirían exactamente esa corrida? - ¿Por qué
isPeakHour(d, h) === (isWeekend(d) || h >= PEAK_START_HOUR)no sirve como oráculo paraisPeakHour? Escriban una propiedad que sí sirva, para la regla de lunes a viernes, siguiendo el ejemplo del sábado: con fechas que saben que son de lunes a viernes y los montos del README, sin usarisWeekendni constantes depricing.ts. Compruébenla cambiando el inicio de la hora punta a las 12:00 en una copia de Kallpa. - En
generators.ts, midan confc.statisticsqué fracción de las reservas defc.tuple(hour, hours)terminan exactamente a las 22:00. Calculen el valor esperado a mano y compárenlo. Con la fórmula de la sección “Cuántas corridas”, ¿cuál es la probabilidad de no ver ese caso en 100 corridas? Modifiquen el generador para que aparezca más seguido sin dejar de cubrir los demás. - Agreguen a
fuzz-bookings.tsun tercer generador que varíe solodateystartHour, con cuerpos de resto válido. ¿Cuántas reservas se crean? ¿Cuántas respuestas distintas ven? ¿Qué tendrían que cambiar para ver alguna vezIN_THE_PAST? Expliquen por qué un resultado sin 500 dice poco si no miran esos conteos. - Escriban una versión de
amountDueCentssin el mutante equivalente: una función con el mismo comportamiento donde cambiar el operador de comparación sí cambie algo que se pueda notar. ¿La versión queda mejor o peor? ¿Conviene cambiar el código para matar un mutante equivalente? - En el producto de su equipo, un mutante cambia
stock >= quantityporstock > quantityen la función que acepta un pedido, y sobrevive. ¿Qué prueba falta? Escríbanla como un caso de “Dado, Cuando, Entonces”. ¿Cómo sabrían si fuera un mutante equivalente? Den un ejemplo de una función parecida donde ese mismo cambio sí sea equivalente. - Un agente les entrega una función con diez pruebas, todas en verde, y
Stryker da 55 % de mutation score sobre esa función. ¿Qué concluyen de las
pruebas y qué concluyen del código? ¿Qué hacen antes de aceptar el cambio?
¿Cambia su respuesta si el score es 100 %? Usen el caso de
booking-window.ts. - Escriban tres propiedades de clases distintas (invariante, ida y vuelta y metamórfica) para una regla de negocio del producto de su cliente. Para cada una, digan de qué parte de la especificación sale y qué error concreto detectaría. Compruébenlo: metan ese error a mano y vean fallar la propiedad. Esto les sirve para P3.
- Reto: siguiendo la lectura complementaria de model-based
testing,
escriban con
fc.commandsuna prueba sobre la API de Kallpa con dos comandos (reservar y cancelar), y como modelo un mapa en memoria de qué horas están ocupadas. Después de cada comando, comparen el modelo conGET /api/courts/:id/availability. ¿Qué secuencia mínima usaría para mostrar que una hora cancelada vuelve a estar libre? - Para el pipeline de su proyecto, decidan dónde corre cada técnica: propiedades, fuzzing de la API, y Stryker. ¿En cada pull request, cada noche, o solo a mano al cambiar las reglas? Justifiquen con cuánto tarda cada una en su proyecto (mídanlo) y con lo que hace Google, según Petrović e Ivanković. ¿Qué hacen si una propiedad con semilla aleatoria falla en la integración continua de un pull request que no tocó ese código?