Apuntes · Capítulo 9Calidad: pruebas, revisión e integración
Pruebas unitarias, dobles de prueba, TDD y BDD
Pruebas unitarias, dobles de prueba, TDD y BDD
Hasta aquí, las pruebas han aparecido varias veces como herramienta de otra
cosa. En la semana 3 escribieron criterios de aceptación que se podían
comprobar. En la semana 4 una especificación decidió qué prometía una función,
y unas pruebas de aceptación revisaron si la cumplía. En la semana 5
refactorizaron un módulo de Kallpa con una sola regla: nada cambia en test/.
En esos laboratorios confiaron en que, si las pruebas seguían en verde, no
habían roto nada.
Esta semana empieza la parte del curso dedicada a la calidad, y las pruebas pasan a ser el tema. ¿Qué hace que una prueba merezca esa confianza? Hay pruebas que pasan con el código roto y pruebas que se rompen con el código sano, y las dos cuestan caro. Una suite también puede ejecutar el 100 % de las líneas de un archivo sin revisar ni una.
El capítulo tiene dos partes, como la semana. En la primera vemos para qué se prueba cuando un sistema vive años, cómo se clasifican las pruebas por tamaño y por alcance, cómo se escriben pruebas que sobreviven a un refactoring, qué son los dobles de prueba y qué dice (y qué no dice) la cobertura. En la segunda practicamos TDD, en el que la prueba se escribe antes que el código, y BDD, que convierte los criterios de aceptación de la semana 3 en pruebas ejecutables. Todo se ejecuta sobre Kallpa, y cada salida que aparece aquí viene de una corrida real en el contenedor del curso.
Lectura. Para la primera parte, Software Engineering at Google (SWEG), cap. 11, Testing Overview, cap. 12, Unit Testing y cap. 13, Test Doubles. Complementarias: Martin Fowler, TestDouble y Mocks Aren’t Stubs; Ham Vocke, The Practical Test Pyramid; Google Testing Blog, Code Coverage Best Practices (2020); y Node.js, Test runner, las secciones de mocking y collecting code coverage. Para la segunda parte, Kent Beck, Canon TDD (2023); Martin Fowler, TestDrivenDevelopment y GivenWhenThen; y Cucumber, Behaviour-Driven Development. Complementarias: Cucumber, Gherkin reference; y Node.js, Test runner:
describe,test,beforeEach,--test-name-patterny--test-only. El código del capítulo está encode/week-09y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Para qué se prueba, Para poder cambiar el código mañana y La regla de Beyoncé; de Tamaño y alcance, Dos preguntas distintas y La pirámide; de Pruebas que no se rompen al refactorizar, Probar a través de la interfaz pública y Probar comportamientos, no métodos; de Dobles de prueba, Por qué hacen falta y Las cinco clases; y de TDD, El ciclo.
- En clase: Sesión A: Tamaño y alcance, Pruebas que no se rompen al refactorizar, Pruebas claras, Dobles de prueba y Cobertura. Sesión B: TDD, BDD y TDD con un agente. Laboratorio: El laboratorio y el código de la semana.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Un fake y su contrato, La costura del reloj, Un ciclo completo, De afuera hacia adentro y las lecturas del recuadro Lectura.
Para qué se prueba
Para poder cambiar el código mañana
Cuando uno aprende a programar, una prueba sirve para ver si el programa funciona. Se corre, se mira el resultado, se entrega. En un sistema que vive años, esa respuesta se queda corta, porque el código de hoy lo van a modificar personas que no lo escribieron, por razones que nadie conoce todavía. La pregunta útil ya no es “¿funciona hoy?”, sino “cuando alguien lo cambie dentro de seis meses, ¿cómo va a saber que no rompió nada?”.
Una prueba es un programa que ejercita otro programa y compara lo que ocurre con lo que debería ocurrir. Una suite es el conjunto de pruebas de un proyecto. Una suite buena hace tres cosas a la vez:
- Detecta errores, y los detecta cerca de quien los introdujo, cuando arreglarlos todavía es barato (la idea de shift left de la semana 1).
- Deja cambiar el código. Sin pruebas, cada cambio se revisa a mano o se evita. La suite es lo que permite refactorizar, como en la semana 5.
- Documenta lo que el sistema promete. Un nombre como
los socios tienen 10 % de descuentodice una regla del negocio, y a diferencia de un comentario, deja de pasar si deja de ser cierta.
En la industria. SWEG, cap. 11, cuenta el caso de Google Web Server (GWS), el servidor que atiende las búsquedas de Google. En 2005 los releases tenían cada vez más errores, y en cierto momento más del 80 % de los pases a producción contenía errores que afectaban a los usuarios y había que revertir. El líder técnico estableció una regla: todo cambio nuevo lleva pruebas, y se corren continuamente. En un año, los pases de emergencia bajaron a la mitad, en un periodo con un número récord de cambios por trimestre. Es una experiencia contada por la propia empresa, sin grupo de comparación: no mide el efecto aislado de las pruebas, pero explica por qué Google decidió invertir en ellas.
La regla de Beyoncé
SWEG la enuncia parafraseando una canción: “If you liked it, then you shoulda put a test on it”. Si te importaba, le hubieras puesto una prueba.
Parece un chiste y es una regla sobre responsabilidades. Cuando un equipo actualiza una dependencia compartida y pasan todas las pruebas de un producto, pero el producto se rompe, la culpa es del producto: el equipo de la dependencia no tenía por qué adivinar un comportamiento que nadie probó. En Kallpa, si alguien cambia cómo se calcula la disponibilidad y nada falla, no pueden reclamarle después que “eso siempre funcionó así”. Si importaba, tenía que haber una prueba que lo dijera.
Esta regla se complementa con la ley de Hyrum de la semana 1: con suficientes usuarios, alguien va a depender de cualquier comportamiento observable. Ninguna suite cubre todos los comportamientos observables. Por eso la pregunta práctica es cuáles son los que de verdad les importan a ustedes y a su cliente.
Idea clave. Una suite no existe para demostrar que el código no tiene errores. Como decía Dijkstra, las pruebas pueden mostrar que hay errores, no que no los hay. Existe para que un cambio roto se note pronto, y para que un cambio sano se pueda hacer sin miedo.
Lo que hace valiosa a una suite
Si una suite existe para permitir cambios, tiene que cumplir dos condiciones que se miran desde lados opuestos:
- Falla cuando el comportamiento cambió. Si no falla, deja pasar el error.
- No falla cuando el comportamiento no cambió. Si falla, gasta tiempo en una falsa alarma y, con suficientes falsas alarmas, el equipo deja de creerle.
Casi todo este capítulo sale de ahí. Las pruebas que no se rompen al refactorizar, los dobles de prueba bien usados y las pruebas aisladas responden a estas dos condiciones.
Una forma especialmente dañina de falsa alarma es la prueba flaky, la que a veces pasa y a veces falla sin que nada haya cambiado. SWEG (cap. 11) da números de Google: su tasa de pruebas flaky ronda el 0.15 %, lo que a su escala son miles de fallas falsas al día, y su experiencia es que, al acercarse al 1 %, las pruebas empiezan a perder valor porque los ingenieros dejan de reaccionar a ellas. Las fuentes usuales de no determinismo son el reloj, el orden de los hilos y la latencia de la red. En Kallpa, la primera ya está resuelta con un reloj inyectable, y la segunda y la tercera casi no existen porque casi nada sale de un proceso.
Tamaño y alcance
Dos preguntas distintas
“Prueba unitaria” y “prueba de integración” se usan como si fueran una sola escala, pero mezclan dos preguntas. SWEG las separa.
El tamaño de una prueba dice qué recursos necesita para correr:
| Tamaño | Puede usar | No puede usar |
|---|---|---|
| Pequeña | Un solo proceso | sleep, E/S bloqueante: red y disco |
| Mediana | Varios procesos e hilos en una máquina, red a localhost |
Red hacia otra máquina |
| Grande | Lo que necesite, también otras máquinas | (sin límite) |
El alcance dice cuánto código ejercita:
| Alcance | Ejercita |
|---|---|
| Unitaria | Una unidad pequeña, como una función o un módulo |
| De integración | Varias unidades juntas, por ejemplo un repositorio con su base de datos |
| De punta a punta | El sistema completo, como lo usa el usuario |
¿Por qué le importa tanto el tamaño a SWEG? Porque de los recursos vienen la lentitud y el no determinismo. Una prueba que corre en un proceso y no hace llamadas bloqueantes solo puede ir tan lento como el procesador, y es difícil que se vuelva flaky por accidente. Una que llama a otra máquina puede fallar porque la red tuvo un mal momento.
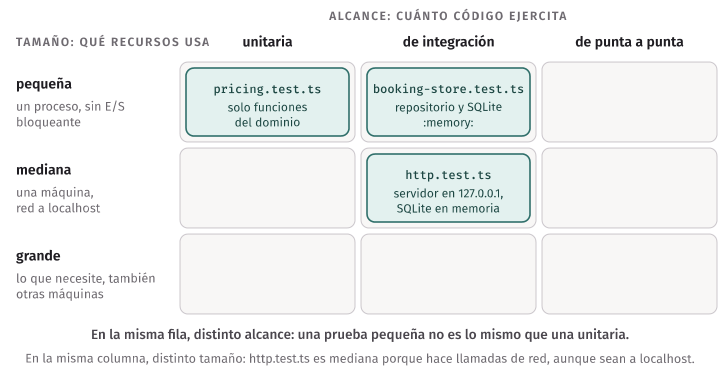
Las pruebas de Kallpa
Clasifiquemos las pruebas de Kallpa con las dos preguntas.
| Prueba | Qué usa | Tamaño | Alcance |
|---|---|---|---|
test/pricing.test.ts |
Solo funciones del dominio | Pequeña | Unitaria |
code/week-09/booking-store.test.ts (versión real) |
Repositorio y SQLite :memory:, en el mismo proceso |
Pequeña | De integración |
test/http.test.ts |
Servidor en 127.0.0.1 y SQLite en memoria |
Mediana | De integración |
La fila del medio es la que confirma que son dos preguntas: una prueba pequeña
no es lo mismo que una unitaria. El repositorio con SQLite en memoria
ejercita el código de Kallpa, el SQL y el motor juntos (alcance de
integración), pero corre en un proceso, sin red. SWEG prohíbe el disco en las
pruebas pequeñas, y admite en una nota al pie el acceso a un sistema de
archivos si es hermético y en memoria. Una base de datos :memory: dentro
del proceso cumple el espíritu de esa nota: no hay disco, ni otro proceso, ni
estado que sobreviva a la prueba.
La última fila tiene un detalle que conviene mirar con cuidado. El servidor de
test/http.test.ts corre en el mismo proceso que la prueba, así que no es
mediana por usar varios procesos. Es mediana porque hace llamadas de red,
aunque sean a localhost, y eso no se permite en una pequeña. Para dejar de
ser mediana tendría que llamar a otra máquina (un WhatsApp de verdad, por
ejemplo), y entonces sería grande.
No hace falta adivinarlo: el tamaño se ve en lo que se importa, y
code/week-09/sizes.test.ts lo comprueba.
test('pricing.test.ts solo importa node:test, assert y el dominio', () => {
  const imports = [...read('test/pricing.test.ts').matchAll(/from '([^']+)'/g)].map((match) => match[1]);
  assert.deepEqual(imports, ['node:assert/strict', 'node:test', '../src/domain/pricing.ts']);
});
La diferencia de tiempos entre los dos archivos existe, aunque a esta escala es chica. Estos son los totales de una corrida, proceso de Node incluido:
$ node --test test/pricing.test.ts
...
ℹ tests 6
...
ℹ duration_ms 73.138126
$ node --test test/http.test.ts
...
ℹ tests 9
...
ℹ duration_ms 150.157875
Una sola corrida no permite concluir mucho y los números cambian de una máquina a otra. Tampoco es lo que más importa aquí: Kallpa puede correr sus 40 pruebas en una fracción de segundo porque todas, incluso las medianas, se quedan dentro de una máquina y usan una base de datos en memoria.
La pirámide
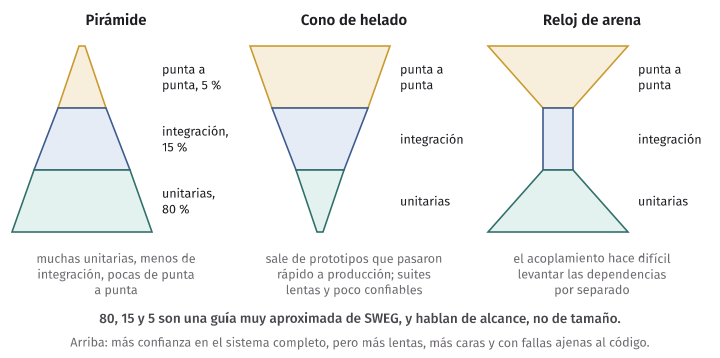
La pirámide de pruebas, que Mike Cohn propuso y Ham Vocke explica en la lectura complementaria, sugiere tener muchas pruebas unitarias, menos de integración y pocas de punta a punta: habla de alcance. La razón no es que unas sean mejores que otras. Las de arriba dan más confianza en que el sistema completo funciona, pero son más lentas, más caras de mantener y fallan por razones ajenas al código (la red, el navegador, un servicio caído).
SWEG (cap. 11) da una proporción: alrededor de 80 % de pruebas unitarias, 15 % de integración y 5 % de punta a punta. Dos precisiones. La primera: la llama a very rough guideline, una guía muy aproximada. La segunda: se refiere al alcance, no al tamaño. No es una meta que Kallpa deba cumplir al dígito, y un proyecto cuya lógica sea sobre todo coordinar servicios puede necesitar otra mezcla.
SWEG también nombra dos formas que hay que evitar. El cono de helado, con muchas pruebas de punta a punta y pocas unitarias, suele salir de proyectos que empezaron como prototipos y pasaron rápido a producción, y tiene suites lentas y poco confiables. El reloj de arena, con muchas unitarias, muchas de punta a punta y pocas de integración, aparece cuando el acoplamiento hace difícil levantar las dependencias por separado.
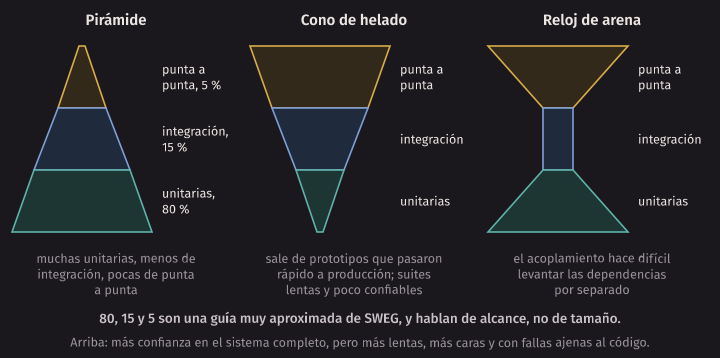
Error común. Tomar la pirámide como una regla de porcentajes. Lo que enseña es una pregunta: para este comportamiento, ¿cuál es la prueba más pequeña que lo verifica de verdad? Una regla de precios se verifica con una prueba pequeña. Que un
SELECTdevuelva las filas correctas no se verifica sin la base de datos.
Pruebas que no se rompen al refactorizar
La prueba frágil y la prueba ciega
SWEG (cap. 12) define una prueba frágil (brittle) como la que falla ante un cambio de código que no introdujo ningún error real. Su costo es sutil: cada falsa alarma exige que alguien la entienda y la arregle, y en una base de código grande eso es lo que hace que un refactoring pequeño cueste semanas. La prueba ideal, dice SWEG, no cambia a menos que cambien los requisitos.
Hay un defecto opuesto, para el que el capítulo usa la palabra ciega: pasa aunque el comportamiento esté roto. Una prueba puede ser frágil y ciega a la vez, y las dos cosas se pueden ver con un solo experimento en Kallpa.
Escribimos dos pruebas para el mismo pedido: reservar dos horas.
La primera revisa cómo trabaja el handler por dentro: arma un service de
mentira, llama a createBooking y mira si se llamó a saveBooking.
test('createBooking llama a service.saveBooking', async (t) => {
  const saveBooking = t.mock.fn(() => 7);
  const service = {
    findCourt: () => ({ id: 1, name: 'Fulbito 1', sport: 'fulbito' }),
    findMember: () => ({ id: 1, name: 'Rosa', phone: '987654321', plan: 'regular' }),
    bookingsForCourt: () => [],
    saveBooking,
    findBooking: () => ({
      id: 7, court_id: 1, member_id: 1, date: '2026-03-10', start_hour: 19, hours: 2, team_name: 'Los Pumas de Comas',
      price_cents: 22500, status: 'confirmed', created_at: '2026-03-09T15:00:00.000Z', cancelled_at: null,
    }),
  };
  const deps = {
    service,
    clock: fixedClock('2026-03-09T15:00:00Z'),
    notifier: { bookingConfirmed() {} },
  } as unknown as AppDependencies;
  const body = { courtId: 1, memberId: 1, date: '2026-03-10', startHour: 19, hours: 2, teamName: 'Los Pumas de Comas' };
  const req = Readable.from([Buffer.from(JSON.stringify(body))]) as unknown as IncomingMessage;
  const res = { writeHead() {}, end() {} } as unknown as ServerResponse;

  await createBooking(deps)({ req, res, url: new URL('http://localhost/api/bookings'), params: {} });

  assert.equal(saveBooking.mock.callCount(), 1);
});
Fíjense en cuánto sabe esta prueba de la implementación: el orden de las
llamadas al servicio, los nombres de las columnas, la forma de res. Y hay
que forzar los tipos con as unknown as para que compile.
La segunda revisa lo que ve quien usa la API: después de reservar dos horas, esas dos horas están ocupadas.
test('una reserva de dos horas ocupa las dos horas', async (t) => {
  const server = await startTestServer();
  t.after(() => server.close());

  const created = await postJson(`${server.url}/api/bookings`, {
    courtId: 1, memberId: 1, date: '2026-03-10', startHour: 19, hours: 2, teamName: 'Los Pumas de Comas',
  });
  assert.equal(created.status, 200);

  const { body } = await getJson(`${server.url}/api/courts/1/availability?date=2026-03-10`);
  const taken = body.slots.filter((slot: { available: boolean }) => !slot.available).map((slot: { hour: number }) => slot.hour);
  assert.deepEqual(taken, [19, 20]);
});
Sobre la Kallpa publicada, las dos pasan. El script in-kallpa/run.sh las
somete a dos cambios en una copia (su salida completa queda en
build/logs/in-kallpa.txt).
Cambio 1: un refactoring. El método saveBooking del servicio pasa a
llamarse insertBooking. No cambia ningún comportamiento, y las 9 pruebas de
test/http.test.ts lo confirman.
== refactoring: saveBooking pasa a llamarse insertBooking
 src/http/handlers.ts            | 2 +-
 src/services/booking-service.ts | 2 +-
 2 files changed, 2 insertions(+), 2 deletions(-)
ℹ pass 9
ℹ fail 0
✔ una reserva de dos horas ocupa las dos horas
✖ createBooking llama a service.saveBooking
ℹ tests 2
ℹ pass 1
ℹ fail 1
✖ failing tests:
✖ createBooking llama a service.saveBooking
  TypeError [Error]: deps.service.insertBooking is not a function
La prueba de interacción falló sin que hubiera un error. Es una falsa alarma: la prueba es frágil. Un cambio más real, como mover el guardado a un módulo de reservas (lo que hicieron en la semana 5), la rompería igual.
Cambio 2: un error de verdad. En otra copia, el repositorio guarda siempre 1 hora en vez de las horas pedidas.
== error: el repositorio guarda siempre 1 hora
 src/store/booking-repository.ts | 2 +-
 1 file changed, 1 insertion(+), 1 deletion(-)
✖ una reserva de dos horas ocupa las dos horas
✔ createBooking llama a service.saveBooking
ℹ tests 2
ℹ pass 1
ℹ fail 1
✖ failing tests:
✖ una reserva de dos horas ocupa las dos horas
  AssertionError [ERR_ASSERTION]: Expected values to be strictly deep-equal:
  + actual - expected

    [
      19,
  -   20
    ]

      at TestContext.<anonymous> (file:///work/code/week-09/build/in-kallpa/test/behavior.test.ts:18:10)
La cancha queda libre a las 20:00, otro vecino la puede reservar encima, y la prueba de interacción sigue en verde. Es ciega a ese error, porque reemplazó justo la parte que estaba mal.
| Refactoring (nada se rompió) | Error (el negocio se rompió) | |
|---|---|---|
| Prueba de interacción | Falla: falsa alarma | Pasa: error no detectado |
| Prueba de comportamiento | Pasa | Falla |
La prueba de interacción dio el resultado equivocado en los dos casos, aunque
saveBooking es una función que cambia estado. Aquí esa regla no alcanza para
justificarla: el estado nuevo se puede observar por la API, y mirarlo es mejor.
Esto no significa que toda prueba con dobles sea mala, ni que todo se deba probar por
HTTP: más adelante veremos cuándo la interacción es justo lo que hay que
revisar. Significa que hay que elegir qué se verifica.
Idea clave. Una prueba que falla cuando el comportamiento no cambió es tan cara como una que no falla cuando sí cambió. La primera gasta tiempo; la segunda deja pasar el error. Las dos erosionan la confianza en la suite.
Probar a través de la interfaz pública
La primera defensa contra la fragilidad es llamar al código como lo llaman sus usuarios. SWEG lo llama test via public APIs: una prueba que usa solo la interfaz pública forma un contrato explícito, y si se rompe, es que también se rompería un usuario real.
¿Qué es “público” depende del nivel. Para src/domain/pricing.ts, es
quotePriceCents y formatSoles. Para Kallpa como sistema, es la API HTTP de
la tabla del README. HOURLY_RATE_CENTS también se exporta, pero el
comportamiento que se quiere fijar es el precio, no cómo está guardada la
tarifa. Tampoco conviene exportar una función solo para poder probarla: si una
función interna tiene tanta lógica que pide pruebas propias, a menudo es un
módulo aparte con su propia interfaz, como vimos en la semana 5.
Un caso concreto: en la semana 5 pudieron refactorizar sin tocar test/
porque las pruebas de Kallpa llaman a la API por HTTP y a las funciones del
dominio, no a los métodos de BookingService. Si test/http.test.ts hubiera
revisado llamadas internas, ese laboratorio habría sido imposible con esa
regla.
Probar comportamientos, no métodos
La tentación natural es escribir una prueba por método: testQuotePriceCents.
SWEG recomienda lo contrario: una prueba por comportamiento. Un método
suele hacer varias cosas, y un comportamiento puede abarcar varios métodos.
// Una prueba por método: si falla, ¿qué regla se rompió?
test('quotePriceCents', () => {
  assert.equal(quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 10, hours: 1, plan: 'regular' }), 9000);
  assert.equal(quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 20, hours: 1, plan: 'regular' }), 11250);
  assert.equal(quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 10, hours: 1, plan: 'socio' }), 8100);
});
test/pricing.test.ts hace lo que se recomienda: una prueba por regla, con el
nombre de la regla.
test('en hora punta la hora cuesta 25 % más', () => {
  assert.equal(quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 20, hours: 1, plan: 'regular' }), 11250);
});

test('los socios tienen 10 % de descuento', () => {
  assert.equal(quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 10, hours: 1, plan: 'socio' }), 8100);
});
Cuando una falla, el nombre dice qué se rompió antes de leer el código. Cuando se agrega una regla, se agrega una prueba y las demás no se tocan.
Revisar el estado antes que las llamadas
SWEG distingue dos formas de verificar:
- Prueba de estado: se ejecuta el código y se mira cómo quedó el sistema, o qué devolvió.
- Prueba de interacción: se revisa qué llamadas hizo el código, en qué orden y con qué argumentos.
Las de interacción son más frágiles por la misma razón por la que es más
frágil probar un método privado: revisan cómo se llegó al resultado,
cuando casi siempre importa solo cuál es el resultado. Por eso la prueba
de arriba mira la disponibilidad y no si se llamó a saveBooking. Fowler usa
nombres parecidos en Mocks Aren’t Stubs: verificación de estado y
verificación de comportamiento (y ojo: ahí “comportamiento” quiere decir “las
llamadas”, no lo que en este capítulo llamamos comportamiento observable).
Pruebas claras
Que se entienda al fallar
Una prueba se escribe una vez y se lee sobre todo cuando falla, muchas veces cuando quien la escribió ya no está. SWEG pide que sea completa (el cuerpo tiene lo necesario para entenderla) y concisa (no tiene nada más). La prueba de quien lee es simple: ¿se entiende sin saltar a otro archivo?
El nombre dice el comportamiento y la condición. No test('cancelar 2'),
sino test('una hora antes de empezar ya no se puede cancelar'). El nombre en
español, tal como lo diría la administración del complejo, sirve además de
documentación. En P3, además, el nombre cita la historia ((HU-03)).
La estructura interna tiene tres partes, con una línea en blanco entre ellas: preparar, ejecutar, revisar. En su forma Dado/Cuando/Entonces, es lo que usaremos en la sesión B.
DAMP antes que DRY
En la semana 5 vimos DRY: cada conocimiento en un solo lugar. En las pruebas, SWEG propone otro criterio, DAMP (Descriptive And Meaningful Phrases): se acepta algo de repetición si hace la prueba más simple y clara.
Compárenlo en una prueba de cancelación:
// Demasiado DRY: ¿qué reserva es? ¿A qué hora? ¿Por qué debería fallar?
test('no deja cancelar', async () => {
  const id = await bookDefault(server);
  await expectCancelError(server, id);
});
// DAMP: repite datos, y se entiende sin ir a otra parte.
test('una hora antes de empezar ya no se puede cancelar', async () => {
const created = await postJson(`${server.url}/api/bookings`, {
courtId: 1, memberId: 1, date: '2026-03-09', startHour: 11, hours: 1, teamName: 'Los Pumas de Comas',
});
const { status, body } = await postJson(`${server.url}/api/bookings/${created.body.booking.id}/cancel`);
assert.equal(status, 422);
assert.equal(body.error.code, 'TOO_LATE_TO_CANCEL');
});DAMP no prohíbe los helpers. startTestServer y postJson son un buen
helper: esconden pasos cuyos detalles no importan para el comportamiento que
se prueba. Lo que no debe esconder un helper es lo que hace que el resultado
sea el esperado: aquí, que la reserva es a las 11:00 y el reloj marca las
10:00. El helper booking() de test/report.test.ts va por buen camino: da
valores por omisión y cada prueba escribe lo que le importa (booking({ status: 'cancelled' })).
Sin lógica en las pruebas
Una prueba tiene que ser tan simple que se vea correcta a simple vista. Un
for, un if o un cálculo son código que también puede estar mal, y nadie
prueba las pruebas. SWEG da un ejemplo con una URL armada concatenando texto,
con un error de doble barra que no se ve hasta escribirla completa.
// Mal: la prueba calcula lo mismo que el código.
assert.equal(quotePriceCents(quote), HOURLY_RATE_CENTS.fulbito * 1.25);

// Bien: el valor sale de la tabla de precios del README.
assert.equal(quotePriceCents(quote), 11250);
Aisladas: cada prueba se sostiene sola
Una prueba aislada no depende de lo que dejó otra. Si depende, falla al correrla sola, al cambiar el orden, o al borrar la prueba de la que depende. Y lo peor es que falla en un lugar que no es la causa.
En code/week-09/demos/order-dependent.test.ts hay un ejemplo chico sobre el
repositorio de reservas. Comparten la base de datos del módulo:
const db = openDatabase(':memory:');
seedCatalog(db);
const repository = new BookingRepository(db);

test('guarda una reserva', () => {
  const id = repository.insert({
    court_id: 1, member_id: 1, date: '2026-03-10', start_hour: 19, hours: 1,
    team_name: 'Los Pumas de Comas', price_cents: 11250, created_at: '2026-03-09T15:00:00.000Z',
  });
  assert.equal(repository.findById(id)?.start_hour, 19);
});

test('lista las reservas del día', () => {
  assert.equal(repository.listByDate('2026-03-10').length, 1);
});
Corriendo todo el archivo (node --test demos/order-dependent.test.ts), las
dos pasan.
Con --test-name-pattern corre solo la segunda y falla, aunque el código no
tenga ningún error:
$ node --test --test-name-pattern="lista las reservas del día" demos/order-dependent.test.ts
✖ lista las reservas del día (1.55325ms)
ℹ tests 1
ℹ suites 0
ℹ pass 0
ℹ fail 1
...
ℹ duration_ms 83.242042

✖ failing tests:

test at demos/order-dependent.test.ts:21:1
✖ lista las reservas del día (1.55325ms)
  AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

  0 !== 1
Node también puede cambiar el orden. --test-randomize lo sortea, y
--test-random-seed lo repite con la misma semilla:
$ node --test --test-randomize --test-random-seed=1 demos/order-dependent.test.ts
✖ lista las reservas del día (1.543708ms)
✔ guarda una reserva (0.3215ms)
ℹ Randomized test order seed: 1
ℹ tests 2
ℹ suites 0
ℹ pass 1
ℹ fail 1
...
ℹ duration_ms 82.832792
La solución es que cada prueba prepare lo que necesita. beforeEach corre
antes de cada prueba y deja una base de datos nueva
(demos/order-independent.test.ts):
let repository: BookingRepository;

beforeEach(() => {
  const db = openDatabase(':memory:');
  seedCatalog(db);
  repository = new BookingRepository(db);
});

test('lista las reservas del día', () => {
  repository.insert(PUMAS);
  assert.equal(repository.listByDate('2026-03-10').length, 1);
});
$ node --test --test-name-pattern="lista las reservas del día" demos/order-independent.test.ts
✔ lista las reservas del día (1.790375ms)
ℹ tests 1
ℹ suites 0
ℹ pass 1
ℹ fail 0¿Por qué el :memory: hace que esto sea razonable? Porque crear una base
nueva toma milisegundos. El aislamiento tiene un costo, y aquí es muy bajo.
Para ejercitar una sola prueba mientras se trabaja también existe test.only
(con --test-only), que no debe llegar a un commit: esconde el resto de la
suite.
Error común. Encontrar una prueba que falla sola y “arreglarla” corriendo siempre todo el archivo. El síntoma desaparece y la dependencia sigue allí. En el paso 2 del laboratorio van a correr una por una las pruebas de
test/http.test.tspara buscar este problema.
De dónde sale el oráculo
Un oráculo es lo que decide si un resultado es correcto. La pregunta más importante sobre una prueba es de dónde sale el valor esperado. Si sale del mismo código que se prueba, no verifica nada.
En demos/wrong-format.ts hay un formatSoles con un error, que muestra un
solo decimal. Tres pruebas sobre él:
test('copia la fórmula del código', () => {
  assert.equal(formatSoles(11250), `S/ ${(11250 / 100).toFixed(1)}`);
});

test('copia el valor que devolvió el código', () => {
  assert.equal(formatSoles(11250), 'S/ 112.5');
});

test('usa el valor que dice la especificación', () => {
  assert.equal(formatSoles(11250), 'S/ 112.50');
});
$ node --test demos/oracle.test.ts
✔ copia la fórmula del código (0.566834ms)
✔ copia el valor que devolvió el código (0.098208ms)
✖ usa el valor que dice la especificación (0.76875ms)
ℹ tests 3
ℹ suites 0
ℹ pass 2
ℹ fail 1
...
ℹ duration_ms 82.248375
✖ failing tests:
test at demos/oracle.test.ts:14:1
✖ usa el valor que dice la especificación (0.76875ms)
AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:
+ actual - expected
+ 'S/ 112.5'
- 'S/ 112.50'
^Las dos primeras pasan con el código roto, cada una por su lado:
- La primera repite la implementación. Si el código está mal, la prueba está mal de la misma manera.
- La segunda copia lo que salió. Beck la lista entre los errores de Canon TDD: copiar valores calculados y pegarlos como valores esperados elimina la doble comprobación, que es de donde sale buena parte del valor de la prueba.
Solo la tercera tiene un oráculo independiente: la tabla de precios del
README, que dice S/ 112.50. Por eso se escribe el valor a mano, desde la
especificación.
Una aclaración para no exagerar: fijar lo que el código hace hoy tiene un uso legítimo, las pruebas de caracterización que vieron en la semana 5, cuando se va a refactorizar sin una especificación. Lo que dicen es “esto no cambió”, no “esto es correcto”. El error es confundir una cosa con la otra.
Idea clave. Antes de confiar en una prueba, pregúntense: ¿de dónde sale el valor esperado? Si la respuesta es “del código”, la prueba no puede detectar un error en ese código.
Dobles de prueba
Por qué hacen falta
Una prueba necesita controlar lo que rodea al código. Pero algunas dependencias lo impiden: el reloj real da otra hora en cada corrida, un WhatsApp de verdad enviaría mensajes reales, un servicio externo puede estar caído. Un doble de prueba (test double) es un objeto que reemplaza a una dependencia durante una prueba, como un doble de riesgo en una película.
Para poner un doble tiene que haber un lugar donde ponerlo, una costura
(seam): un punto donde se puede cambiar la dependencia sin tocar el código. La
técnica usual es la dependency injection, en la que la dependencia se pasa
desde afuera y no se crea por dentro. Kallpa la usa en createServer:
export type ServerOptions = {
  db: DatabaseSync;
  clock?: Clock;
  notifier?: Notifier;
  log?: (line: string) => void;
};
En producción, main.ts pasa el reloj y el notificador reales, o usa los
valores por omisión. En una prueba, se pasa lo que la prueba necesite.
Las cinco clases
Gerard Meszaros les puso nombre en xUnit Test Patterns (2007), y Fowler las
resume en TestDouble. Estas son las definiciones, con un ejemplo de
code/week-09/doubles.test.ts para cada
una:
| Clase | Qué hace | En Kallpa |
|---|---|---|
| Dummy | Se pasa porque hace falta, pero nunca se usa | Un notificador que lanza un error si lo llaman, en una prueba que no reserva |
| Stub | Da respuestas fijas a las llamadas | fixedClock: “ahora” siempre es el lunes 9 de marzo a las 10:00 |
| Fake | Funciona de verdad, con un atajo que no sirve para producción | Un repositorio de reservas en memoria, con un arreglo |
| Spy | Es un stub que además registra cómo lo llamaron | El Notifier de test/helpers.ts, que guarda los avisos en sent |
| Mock | Viene programado con las llamadas que espera y falla si no ocurren | Un notificador que espera un aviso exacto |
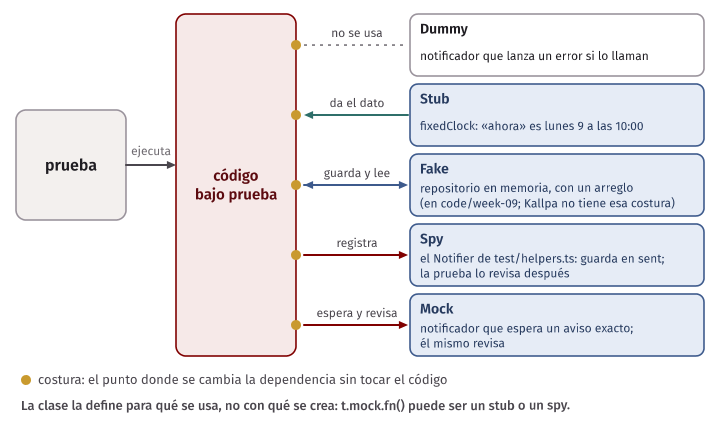
Dummy. Sirve para llenar un parámetro que la prueba no necesita. Hacer que lance un error documenta esa decisión y hace que falle si alguien sí lo usa:
test('dummy: listar las canchas no necesita al notificador', async (t) => {
  // Hay que pasarlo para armar el servidor, pero esta prueba no debe usarlo.
  const dummy: Notifier = {
    bookingConfirmed() {
      throw new Error('este doble no debería usarse');
    },
  };
  const server = await startServer({ notifier: dummy });
  t.after(() => server.close());

  const response = await fetch(`${server.url}/api/courts`);

  assert.equal(response.status, 200);
});
El log: () => {} de test/helpers.ts se parece a un dummy, pero, en sentido
estricto, no lo es: el servidor lo llama en cada pedido. Es un stub de una
función que no devuelve nada.
Stub. Controla lo que recibe el código bajo prueba. Con dos relojes distintos, el mismo pedido da dos resultados, y la prueba no depende de la hora en que se corra:
test('stub: a las 10:00 la hora de las 9:00 ya pasó', async (t) => {
  const server = await startServer({ clock: fixedClock('2026-03-09T15:00:00Z') });
  t.after(() => server.close());

  const response = await postBooking(server.url, AT_NINE);

  assert.equal(response.status, 422);
  assert.equal(((await response.json()) as { error: { code: string } }).error.code, 'IN_THE_PAST');
});
Con fixedClock('2026-03-09T13:00:00Z'), las 8:00 en Lima, el mismo pedido
responde 200 (es la siguiente prueba del archivo).
Spy. Controla lo que el código hace hacia afuera, para mirarlo después.
Con node:test, t.mock.fn() crea una función que registra sus llamadas en
mock.calls. En este ejemplo espía el log del servidor:
test('spy: el log registra cada pedido con su código de respuesta', async (t) => {
  const log = t.mock.fn<(line: string) => void>();
  const server = await startServer({ log, notifier: { bookingConfirmed() {} } });
  t.after(() => server.close());
  const tomorrow = { ...AT_NINE, date: '2026-03-10' };

  await postBooking(server.url, tomorrow);
  await postBooking(server.url, tomorrow);

  assert.deepEqual(
    log.mock.calls.map((call) => call.arguments[0]),
    ['POST /api/bookings 200', 'POST /api/bookings 409'],
  );
});
El nombre t.mock.fn engaña: lo que crea, en la terminología de Meszaros, es
un spy, porque se revisa después. Y la herramienta no decide la clase del
doble. Con una implementación que devuelve un valor fijo y sin revisar sus
llamadas, la misma t.mock.fn funciona como stub:
const now = t.mock.fn(() => new Date('2026-03-09T13:00:00Z'));
const server = await startServer({ clock: { now }, notifier: { bookingConfirmed() {} } });
Lo que define la clase es para qué se usa, no con qué se crea.
Mock. La diferencia con el spy es de orden: el mock sabe de antemano
qué llamadas espera y él mismo las revisa. node:test no trae uno así; este
está escrito a mano para ver la diferencia:
function mockNotifier(expected: BookingConfirmation): Notifier & { verify(): void } {
  let received = 0;
  return {
    bookingConfirmed(confirmation) {
      assert.deepEqual(confirmation, expected);
      received++;
    },
    verify() {
      assert.equal(received, 1, `se esperaba un aviso y hubo ${received}`);
    },
  };
}

test('mock: el aviso a un socio lleva el precio con descuento', async (t) => {
  const notifier = mockNotifier({
    phone: '912345678',
    memberName: 'Luis Huamán Torres',
    courtName: 'Fulbito 1',
    date: '2026-03-10',
    startHour: 10,
    hours: 1,
    priceCents: 8100,
  });
  const server = await startServer({ notifier });
  t.after(() => server.close());

  await postBooking(server.url, { courtId: 1, memberId: 2, date: '2026-03-10', startHour: 10, hours: 1, teamName: 'Real Barranco' });

  notifier.verify();
});
Las seis pruebas del archivo pasan (node --test doubles.test.ts).
En la industria. En la práctica, “mock” se usa como palabra para cualquier doble, y las librerías se llaman mocking frameworks aunque también creen stubs. SWEG (cap. 13) evita esa confusión hablando de tres técnicas: faking (usar un fake), stubbing (programar respuestas) e interaction testing (revisar las llamadas). Cuando alguien les pida “ponle un mock”, pregunten qué quiere: ¿controlar una respuesta o revisar una llamada? Son dos decisiones distintas.
Un fake y su contrato
Un fake tiene comportamiento de verdad, y por eso puede mentir de forma más
creíble que un stub. En fake-booking-repository.ts hay uno para el
repositorio de reservas: un arreglo en lugar de SQLite.
export class FakeBookingRepository implements BookingStore {
  #rows: BookingRow[] = [];

  listByCourtAndDate(courtId: number, date: string): BookingRow[] {
    return this.#rows
      .filter((row) => row.court_id === courtId && row.date === date)
      .sort((a, b) => a.start_hour - b.start_hour);
  }

  insert(row: NewBookingRow): number {
    const id = this.#rows.length + 1;
    this.#rows.push({ ...row, id, status: 'confirmed', cancelled_at: null });
    return id;
  }
  // ...
}
¿Cómo saber que se comporta como la real? SWEG usa el término fidelidad: qué tanto se parece el doble a lo que reemplaza. Un fake sin pruebas se va alejando de la real sin que nadie lo note, y las pruebas que lo usan siguen en verde sobre un mundo que ya no existe. El remedio que propone SWEG son las pruebas de contrato: las mismas pruebas, contra la interfaz pública, se corren sobre la implementación real y sobre el fake.
bookingStoreContract('SQLite en memoria', () => {
  const db = openDatabase(':memory:');
  seedCatalog(db);
  return new BookingRepository(db);
});

bookingStoreContract('fake', () => new FakeBookingRepository());
Las ocho pruebas pasan, cuatro con cada implementación
(node --test booking-store.test.ts).
Si el fake se desactualiza, el contrato lo delata. demos/fake-drift.test.ts
tiene una variante que devuelve las reservas en orden de inserción:
$ node --test demos/fake-drift.test.ts
...
ℹ pass 3
ℹ fail 1
...
✖ las reservas de una cancha salen ordenadas por hora de inicio (0.955291ms)
  AssertionError [ERR_ASSERTION]: Expected values to be strictly deep-equal:
  + actual - expected

    [
  +   19,
      9,
  -   19
    ]
El contrato solo cubre lo que revisa. Este fake no conoce las claves foráneas
ni las columnas NOT NULL, así que acepta filas que SQLite rechazaría, y el
contrato no lo dice porque no tiene una prueba para eso. La fidelidad de un
fake nunca es total.
Kallpa, además, no necesita este fake, y por eso no está en kallpa/: el
:memory: ya es rápido, y BookingService crea sus repositorios por dentro,
así que ni siquiera hay una costura donde enchufarlo. Se incluye aquí para
mostrar la técnica. Aunque en este caso no haga falta, los fakes valen la pena
en los casos en que la implementación real no se puede correr en una prueba.
Cuándo usar cada uno
Los criterios de SWEG (cap. 13) se pueden leer como un orden de preferencia.
- La implementación real, si es rápida y determinista. Tiene la máxima
fidelidad: el código corre como en producción. Kallpa usa la SQLite de
verdad en
test/http.test.tsen lugar de un mock del repositorio. SWEG lo resume en prefer realism over isolation. - Un fake, si la real no se puede usar (es lenta, no es determinista o depende de la red). Idealmente, lo mantiene el mismo equipo que es owner de la implementación real, junto con ella.
- Un stub, para dar respuestas que pongan al código en cierta situación. Conviene usarlo poco: cada stub es una copia de lo que uno cree que hace la dependencia.
- Interaction testing, cuando el efecto no se puede observar de otra manera. SWEG recomienda reservarlo para funciones que cambian estado fuera del código bajo prueba, y no usarlo para las que solo devuelven datos, porque en ese caso basta revisar el resultado.
El ejemplo claro en Kallpa es el aviso por WhatsApp. Una reserva confirmada no
deja rastro en la base de datos sobre si se avisó o no, y no se puede mandar
un mensaje real desde una prueba. Lo único que se puede verificar es que se
llamó al notificador, con qué datos y una sola vez. Eso es una buena prueba de
interacción: la llamada es el comportamiento. En cambio, revisar si se
llamó a service.bookingsForCourt no lo es: esa llamada solo devuelve datos,
y el resultado ya se ve en la respuesta HTTP.
Cambiar estado es necesario, pero no suficiente. saveBooking también cambia
estado, y sin embargo revisar esa llamada fue un error en el experimento de
más arriba, porque la reserva guardada se ve después en la disponibilidad.
El aviso por WhatsApp no deja nada que se pueda consultar. Esa es la diferencia.
Error común. Decir que
:memory:es un fake porque SWEG da “una base de datos en memoria” como ejemplo de fake. SWEG se refiere a una implementación aparte, más liviana, de la misma interfaz. En Kallpa,:memory:es el mismo motor SQLite ejecutando el mismo SQL con las mismas restricciones; solo cambia dónde se guardan los datos. Nadie escribió una segunda implementación que pueda alejarse de la primera. Por eso se clasifica como implementación real. No sería real si en producción usaran otro motor (PostgreSQL, por ejemplo) y en las pruebas SQLite: en ese caso sí se comportaría como un fake, con todos sus problemas de fidelidad.
Error común. Abusar de los mocks. Sus señales de alarma son las del experimento de más arriba: la prueba pasa con el código roto y se rompe con cada refactoring. También hay una señal más simple: si para probar una función hay que armar seis dobles, la prueba está diciendo algo sobre el diseño de esa función.
La costura del reloj
El reloj es el mejor ejemplo de lo que da una costura. En no-seam.ts hay una
función que lee la hora por su cuenta:
export function hasStarted(date: string, hour: number): boolean {
  const now = limaTime(new Date());
  return date < now.date || (date === now.date && hour <= now.hour);
}
Sin una forma de darle “ahora”, una prueba de esta función da un resultado
distinto según la hora en que se corra. En Kallpa, en cambio,
checkBookingRules recibe now como un argumento:
test('con costura, "ahora" es un argumento y el resultado no depende de la hora real', () => {
  const now: LimaTime = { date: '2026-03-09', hour: 10, minute: 0 };
  assert.equal(checkBookingRules({ date: '2026-03-09', startHour: 12, hours: 1 }, now), null);
  const later: LimaTime = { date: '2026-03-09', hour: 13, minute: 0 };
  assert.equal(checkBookingRules({ date: '2026-03-09', startHour: 12, hours: 1 }, later)?.code, 'IN_THE_PAST');
});
Para demostrar en seam.test.ts que la función sin costura cambia de
resultado, se usan los temporizadores simulados de node:test
(t.mock.timers.enable({ apis: ['Date'], ... })), que reemplazan a Date en
todo el proceso:
test('sin costura, el mismo llamado da otro resultado según la hora real', (t) => {
  t.mock.timers.enable({ apis: ['Date'], now: Date.parse('2026-03-09T15:00:00Z') }); // 10:00 en Lima
  assert.equal(hasStarted('2026-03-09', 12), false);
  t.mock.timers.setTime(Date.parse('2026-03-09T18:00:00Z')); // 13:00 en Lima
  assert.equal(hasStarted('2026-03-09', 12), true);
});
Esa herramienta sirve para código que no se puede cambiar. Pero la costura es mejor: la dependencia queda escrita en la firma, se ve quién usa el reloj, y la prueba no altera nada global.
Idea clave. Código difícil de probar suele ser una señal de diseño. Cuando una función lee el reloj, abre la base de datos y envía un mensaje por su cuenta, nadie puede probarla por partes, y tampoco reusarla. Una dependencia inyectada ayuda a las dos cosas.
Cobertura
Qué se mide
La cobertura (coverage) dice qué partes del código se ejecutaron durante las pruebas. Hay varias:
- De líneas: qué porcentaje de las líneas se ejecutó.
- De ramas: qué porcentaje de los caminos de cada decisión (
if,?:,&&,||) se tomó. - De funciones: qué porcentaje de las funciones se llamó alguna vez.
Node la mide con --experimental-test-coverage. make cobertura lo hace
sobre Kallpa:
$ node --test --experimental-test-coverage "test/**/*.test.ts"
...
ℹ tests 40
ℹ suites 6
ℹ pass 40
ℹ fail 0
...
ℹ duration_ms 189.599916
ℹ start of coverage report
ℹ -------------------------------------------------------------------------------------------------------------------------
ℹ file                    | line % | branch % | funcs % | uncovered lines
ℹ -------------------------------------------------------------------------------------------------------------------------
ℹ src                     |        |          |         |
ℹ  domain                 |        |          |         |
ℹ   booking.ts            |  95.56 |    87.50 |  100.00 | 50-51 53-54
ℹ   calendar.ts           | 100.00 |   100.00 |  100.00 |
ℹ   clock.ts              | 100.00 |   100.00 |   80.00 |
ℹ   pricing.ts            | 100.00 |   100.00 |  100.00 |
ℹ   report.ts             | 100.00 |   100.00 |  100.00 |
ℹ  http                   |        |          |         |
ℹ   handlers.ts           |  86.80 |    77.55 |   85.71 | 54 89-90 135-136 139-140 149-151 158-163 170-171 178-179 182-187
ℹ   json.ts               |  91.30 |    75.00 |  100.00 | 24-25 31-32
ℹ   router.ts             | 100.00 |   100.00 |  100.00 |
ℹ   server.ts             |  92.96 |    55.56 |  100.00 | 57-58 64-66
ℹ   static-files.ts       |  81.82 |    66.67 |  100.00 | 18-21
ℹ  notifications          |        |          |         |
ℹ   notifier.ts           |  86.67 |   100.00 |    0.00 | 20-22 28
ℹ  services               |        |          |         |
ℹ   booking-service.ts    |  89.83 |   100.00 |   75.00 | 29-30 41-42 45-46
ℹ  store                  |        |          |         |
ℹ   booking-repository.ts |  90.16 |   100.00 |   75.00 | 39-40 43-46
ℹ   court-repository.ts   | 100.00 |   100.00 |  100.00 |
ℹ   database.ts           |  95.08 |    80.00 |  100.00 | 57-59
ℹ   member-repository.ts  |  92.00 |   100.00 |   80.00 | 12-13
ℹ   seed.ts               |  76.84 |   100.00 |   33.33 | 72-90 93-95
ℹ -------------------------------------------------------------------------------------------------------------------------
ℹ all files               |  91.54 |    86.91 |   86.41 |
ℹ -------------------------------------------------------------------------------------------------------------------------
ℹ end of coverage report
Kallpa, tal como se publicó, tiene 91.54 % de líneas, 86.91 % de ramas y 86.41 % de funciones. ¿Es bueno? La columna más útil no tiene porcentajes: es uncovered lines, porque señala qué mirar. El laboratorio empieza por ahí.
Líneas y ramas no son lo mismo
Una línea puede ejecutarse sin que se tomen todos sus caminos.
hourlyRateCents tiene esta línea, con un ?::
return isPeakHour(date, hour) ? base + (base * PEAK_SURCHARGE_PERCENT) / 100 : base;in-kallpa/one-branch.test.ts la prueba con una sola hora normal. Mirando
solo pricing.ts:
ℹ pass 1
ℹ fail 0
ℹ   pricing.ts |  83.67 |    75.00 |   50.00 | 39-44 48-49
Esa línea es la 27, y no aparece entre las líneas sin cubrir: se ejecutó. Pero el recargo de hora punta nunca se calculó, y la cobertura de ramas lo refleja con ese 75 %. Por eso conviene mirar las dos. Además, el reporte también se limita a contar: “75 %” no dice cuál rama falta, y las líneas 39-44 y 48-49 son de funciones que esta prueba no llama.
Lo que la cobertura no dice
Una línea cubierta solo dice que se ejecutó. No dice que alguna aserción haya
revisado su resultado. in-kallpa/no-assert.test.ts no tiene ninguna
aserción:
test('precios', () => {
  quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 10, hours: 1, plan: 'regular' });
  quotePriceCents({ sport: 'fulbito', date: '2026-03-10', startHour: 20, hours: 1, plan: 'socio' });
  formatSoles(11250);
});
== sin aserciones, pricing.ts correcto
ℹ pass 1
ℹ fail 0
ℹ pricing.ts | 100.00 | 100.00 | 100.00 | Cien por ciento en las tres columnas. En una copia de Kallpa, ahora, se cambia el descuento de socio de 10 % a 50 %, que es un error grave:
== sin aserciones, descuento de socio de 50 %
ℹ pass 1
ℹ fail 0
ℹ   pricing.ts | 100.00 |   100.00 |  100.00 |
Sigue en verde y sigue en 100 %. Con el mismo error, las pruebas de
test/pricing.test.ts sí fallan:
== las pruebas de pricing.test.ts con el mismo error
  ✖ los socios tienen 10 % de descuento
ℹ fail 1
ℹ pass 5
✖ los socios tienen 10 % de descuento
Y la cobertura de pricing.ts era igual en los dos casos. La misma cifra
puede corresponder a una suite que verifica mucho o a una que no verifica
nada. La próxima semana verán una herramienta que mide justo eso, las pruebas
de mutación.
El 100 % de la tabla de pricing.ts, entonces, no dice que los precios sean
correctos. Dice que cada línea corrió alguna vez durante alguna prueba.
Hay otro límite, menos conocido, y es qué archivos se cuentan. En la tabla de
arriba no están src/main.ts, src/config.ts ni src/seed.ts. No es que
tengan 100 %: ninguna prueba los carga, y Node solo reporta los archivos que
se cargaron. Con --test-coverage-include-all aparecen, y el total baja:
$ node --test --experimental-test-coverage --test-coverage-include='src/**' --test-coverage-include-all "test/**/*.test.ts"
ℹ  config.ts              |  28.57 |   100.00 |  100.00 | 1-2 7-14
ℹ  main.ts                |   0.00 |   100.00 |  100.00 | 1-25
ℹ  seed.ts                |   0.00 |   100.00 |  100.00 | 1-22
ℹ   seed.ts               |  76.84 |   100.00 |   33.33 | 72-90 93-95
ℹ all files               |  85.79 |    86.91 |   86.41 |
De 91.54 % a 85.79 %, con las mismas pruebas y el mismo código. El número
depende de qué se decide contar, y conviene saberlo antes de compararlo con
otro. (El primer seed.ts de la salida es src/seed.ts, y el segundo,
src/store/seed.ts).
Un mínimo, no un objetivo
Con --test-coverage-lines=N y --test-coverage-branches=N, el comando
termina con error si no se llega al mínimo:
$ node --test --experimental-test-coverage --test-coverage-lines=95 "test/**/*.test.ts"
...
ℹ Error: 91.54% line coverage does not meet threshold of 95%.
$ echo $?
1
Ese es un buen uso: un piso que evita que la suite se deteriore sin que nadie
lo note. P3 lo usa con 70 % de líneas de src/.
El mal uso es tratarlo como la meta. La ley de Goodhart, en su formulación
usual, dice que cuando una medida se vuelve un objetivo, deja de ser una buena
medida. Si a un equipo le piden 90 %, es posible llegar con pruebas como
no-assert.test.ts, que suben el número y no verifican nada. SWEG (cap. 11)
añade otro efecto: un mínimo de 80 % termina funcionando como techo, y los
cambios llegan con 80 % y ni un punto más. Propone cambiar la pregunta: en vez
de “¿cuánta cobertura hay?”, “¿tengo confianza en que todo lo que esperan los
clientes funciona?”.
En la industria. Code Coverage Best Practices, del blog de pruebas de Google (2020), da como guía general 60 % “aceptable”, 75 % “encomiable” y 90 % “ejemplar”, y aclara que no hay un número ideal y que cada equipo debe elegir el suyo. Son lineamientos de una empresa, no resultados de un estudio. Además, dice dos cosas más útiles que los números: lo que no está cubierto es más significativo que lo que sí, y discutir líneas concretas sin cubrir durante la revisión de código vale más que perseguir una cifra.
Idea clave. La cobertura sirve para encontrar lo que no se prueba: una línea sin cubrir es, con seguridad, una línea sin verificar. Lo contrario no vale: una línea cubierta puede no estar verificada. Sirve para preguntar, no para certificar.
Con IA. Una herramienta que genera pruebas a partir del código tiende a describir lo que el código hace, incluidos sus errores: es el oráculo copiado de la sección anterior, a mayor velocidad. También suele reemplazar con un mock la misma unidad que prueba, o escribir pruebas que suben la cobertura con aserciones que no revisan nada (
assert.ok(result)). Como la cobertura sube igual, esa cifra no les va a avisar. Por cada prueba generada, pregunten qué error del código haría que falle. Si no hay respuesta, esa prueba no verifica nada, y para comprobarlo basta introducir ese error a mano y ver si falla. Es lo mismo que le van a pedir a la otra pareja en el paso 7 del laboratorio.
TDD
El ciclo
TDD (test-driven development) es un flujo de trabajo en el que la prueba se escribe antes que el código. Kent Beck, que lo popularizó, lo resume en Canon TDD en cinco pasos:
- Escribir una lista de los escenarios que se quieren cubrir.
- Convertir exactamente uno de ellos en una prueba concreta y ejecutable.
- Cambiar el código para que esa prueba, y todas las anteriores, pasen. Si aparece un caso nuevo, se agrega a la lista.
- Opcionalmente, refactorizar, para mejorar el diseño de la implementación.
- Volver al paso 2 hasta que la lista quede vacía.
Los pasos 2, 3 y 4 son el conocido ciclo rojo, verde, refactorizar: rojo, porque la prueba nueva falla; verde, porque ya pasa; refactorizar, porque con las pruebas en verde se puede mejorar el diseño sin cambiar el comportamiento.
Tres errores que Beck menciona, porque suelen confundirse con TDD:
- Saltarse la lista. La lista es análisis del comportamiento: qué casos debe cubrir el cambio y qué no debe romper. No incluye decisiones de implementación.
- Convertir toda la lista en pruebas de una vez. Si la primera prueba que pasa cambia una decisión, hay que rehacer todas las demás. Además, se pierde la información de cada paso.
- Mezclar refactoring con hacer pasar la prueba. Son dos sombreros: primero que funcione, después que quede bien.
Error común. Llamar TDD a escribir las pruebas después. Escribir pruebas después es bueno y mucho mejor que no escribirlas, pero no es TDD: esas pruebas no influyeron en el diseño de la interfaz y nunca se las vio fallar.
Por qué funciona, cuando funciona
Hay dos mecanismos que se pueden explicar sin citar ningún estudio:
- La prueba obliga a diseñar la interfaz desde quien la llama. Para escribirla, hay que decidir cómo se llama la función, qué recibe y qué devuelve, antes de pensar cómo se implementa. Beck separa aquí las decisiones de interfaz, que se toman al escribir la prueba, de las de implementación, que vienen después.
- Cada paso es chico. Si algo se rompe, el error está en las últimas líneas, y el resto del sistema sigue en verde.
¿Y la evidencia? Es mixta, y conviene leerla con cuidado:
- Nagappan, Maximilien, Bhat y Williams (Empirical Software Engineering, 2008, el enlace es una reseña con el resumen del artículo) estudiaron cuatro equipos que adoptaron TDD, tres en Microsoft y uno en IBM, y los compararon con proyectos parecidos que no lo usaban. La densidad de defectos antes del release fue entre 40 % y 90 % menor. Según la apreciación subjetiva de los equipos, el tiempo inicial de desarrollo aumentó entre 15 % y 35 %. Son estudios de caso, sin asignación al azar: los equipos que eligen adoptar TDD pueden diferir en otras cosas.
- Fucci, Erdogmus, Turhan, Oivo y Juristo (IEEE Transactions on Software Engineering, versión en arXiv) analizaron 82 observaciones de 39 profesionales que hicieron tareas de desarrollo, y midieron la calidad como corrección funcional. Con modelos de regresión, encontraron que la calidad y la productividad se asociaban sobre todo con trabajar en ciclos cortos y parejos, y que el orden (prueba antes o después del código) no tenía una influencia importante. Es una correlación, sobre tareas acotadas, no sobre un sistema durante años.
Tomados juntos, estos dos estudios no prueban que escribir la prueba primero sea lo que produce el efecto; el segundo sugiere que tal vez importe más el tamaño de los pasos. Lo que nadie discute es lo que queda al final: una suite que permite refactorizar, si se escribió bien.
El rojo importa
Una prueba nueva tiene que fallar, y por la razón esperada. Una prueba que nunca se vio fallar puede no estar probando nada: tal vez no se ejecuta, tal vez la aserción siempre es verdadera, tal vez falla por otra cosa. El rojo es la prueba de la prueba.
Lo veremos con el primer paso del ejemplo: la prueba importa un módulo que todavía no existe.
$ node --test test/busiest-hour.test.ts
node:internal/modules/esm/resolve:241
    throw new ERR_MODULE_NOT_FOUND(
          ^

Error [ERR_MODULE_NOT_FOUND]: Cannot find module '/work/code/week-09/build/tdd/src/domain/busiest-hour.ts' imported from /work/code/week-09/build/tdd/test/busiest-hour.test.ts
...
✖ test/busiest-hour.test.ts (59.633208ms)
ℹ tests 1
Esa prueba está roja, pero no por la aserción. Con un error de tipeo en el import, la salida se vería igual y nunca diría nada de la regla. Es un paso normal al empezar un archivo (Beck, en su libro, también cuenta un error de compilación como un rojo); lo que no se puede hacer es quedarse ahí y dar el rojo por visto. Por eso se agrega lo mínimo para que el import funcione, y se mira de nuevo:
✖ sin reservas no hay hora más pedida (0.798458ms)
ℹ tests 1
ℹ suites 0
ℹ pass 0
ℹ fail 1
...
ℹ duration_ms 70.696208

✖ failing tests:

test at test/busiest-hour.test.ts:5:1
✖ sin reservas no hay hora más pedida (0.798458ms)
  AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

  -1 !== null
Ahora sí: el código devolvió -1, y la regla dice null.
Tres formas de llegar al verde
Beck, en Test-Driven Development: By Example (2002), describe tres pasos posibles:
- Fake it (fingir): devolver la constante que hace pasar la prueba. Parece hacer trampa, pero confirma que la prueba funciona y que hay un camino hasta el verde.
- Triangular: agregar un segundo ejemplo que obligue a generalizar. Si dos ejemplos distintos deben pasar, la constante ya no alcanza.
- Implementación obvia: si el camino es claro, se escribe directamente. Si aparece un rojo inesperado, se vuelve a dar pasos más chicos.
La velocidad se regula: pasos chicos cuando hay dudas, más grandes cuando no.
Un ciclo completo
Veamos un ejemplo real sobre Kallpa, un pedido nuevo de la administración: la
caja del día tiene que decir cuál fue la hora más pedida, para saber cuándo
conviene poner a alguien más en la entrada. make tdd repite todos los pasos
en build/tdd, a partir de los archivos de tdd/steps/. (El laboratorio pide
otro cálculo de la caja del día; este no se parece y no les quita trabajo.)
Primero, la lista. Sale de una conversación y solo habla de comportamiento:
- Sin reservas, no hay hora más pedida.
- Con una reserva, la más pedida es su hora de inicio.
- Una reserva de varias horas cuenta en cada una de sus horas.
- Si hay empate, gana la hora más temprana.
- Las canceladas no cuentan.
Ciclo 1. El primer ejemplo decide la interfaz: una función busiestHour
que recibe los bloques y devuelve number | null.
test('sin reservas no hay hora más pedida', () => {
  assert.equal(busiestHour([]), null);
});
Después del rojo de la sección anterior, el verde es fingido:
// eslint-disable-next-line @typescript-eslint/no-unused-vars
export function busiestHour(bookings: readonly { startHour: number; hours: number }[]): number | null {
  return null;
}
✔ sin reservas no hay hora más pedida (0.405042ms)
ℹ tests 1
ℹ suites 0
ℹ pass 1
ℹ fail 0Ciclo 2. Segundo ejemplo:
test('con una reserva, la más pedida es su hora de inicio', () => {
  assert.equal(busiestHour([{ startHour: 19, hours: 1 }]), 19);
});
✔ sin reservas no hay hora más pedida (0.417333ms)
✖ con una reserva, la más pedida es su hora de inicio (0.519791ms)
...
AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:
null !== 19Rojo por la razón correcta. El cambio más simple:
return bookings.length === 0 ? null : bookings[0].startHour;Sigue siendo incompleto, y las pruebas no lo dicen todavía. Para eso está el siguiente ejemplo.
Ciclo 3. Triangular: este ejemplo no se puede pasar con el primer elemento.
test('una reserva de varias horas cuenta en cada una de sus horas', () => {
  const bookings = [
    { startHour: 9, hours: 1 },
    { startHour: 19, hours: 2 },
    { startHour: 20, hours: 1 },
  ];
  assert.equal(busiestHour(bookings), 20);
});
✖ una reserva de varias horas cuenta en cada una de sus horas (0.498333ms)
...
AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:
9 !== 20Ahora sí hay que contar:
export function busiestHour(bookings: readonly { startHour: number; hours: number }[]): number | null {
  const counts = new Map<number, number>();
  for (const booking of bookings) {
    for (let hour = booking.startHour; hour < booking.startHour + booking.hours; hour++) {
      counts.set(hour, (counts.get(hour) ?? 0) + 1);
    }
  }
  let best: number | null = null;
  let bestCount = 0;
  for (const [hour, count] of counts) {
    if (count > bestCount) {
      best = hour;
      bestCount = count;
    }
  }
  return best;
}
Ciclo 4. El empate:
test('si hay empate gana la hora más temprana', () => {
  assert.equal(busiestHour([{ startHour: 19, hours: 1 }, { startHour: 9, hours: 1 }]), 9);
});
✔ sin reservas no hay hora más pedida (0.466292ms)
✔ con una reserva, la más pedida es su hora de inicio (0.083167ms)
✔ una reserva de varias horas cuenta en cada una de sus horas (0.09125ms)
✖ si hay empate gana la hora más temprana (0.495542ms)
...
AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:
19 !== 9Se hace pasar agregando una condición al if. Con el verde asegurado, llega
el refactoring: la función hace dos cosas (contar y elegir), y la
condición quedó enredada. Se separan, sin tocar ninguna prueba:
type Block = { startHour: number; hours: number };

// La hora con más reservas; si hay empate, la más temprana. null si no hay reservas.
export function busiestHour(bookings: readonly Block[]): number | null {
  const counts = [...countPerHour(bookings)].sort(([hourA, countA], [hourB, countB]) => countB - countA || hourA - hourB);
  return counts.length === 0 ? null : counts[0][0];
}

function countPerHour(bookings: readonly Block[]): Map<number, number> {
  const counts = new Map<number, number>();
  for (const booking of bookings) {
    for (let hour = booking.startHour; hour < booking.startHour + booking.hours; hour++) {
      counts.set(hour, (counts.get(hour) ?? 0) + 1);
    }
  }
  return counts;
}
Las cuatro pruebas siguen en verde.
¿Y la lista? Falta el punto 5, y aquí pasó algo interesante: ese caso no le
toca a esta función. dailySummary ya tiene las reservas confirmadas del día,
de modo que basta pasárselas. Lo que queda por verificar es esa conexión, y
eso es trabajo de la prueba de aceptación que veremos en la sección de BDD.
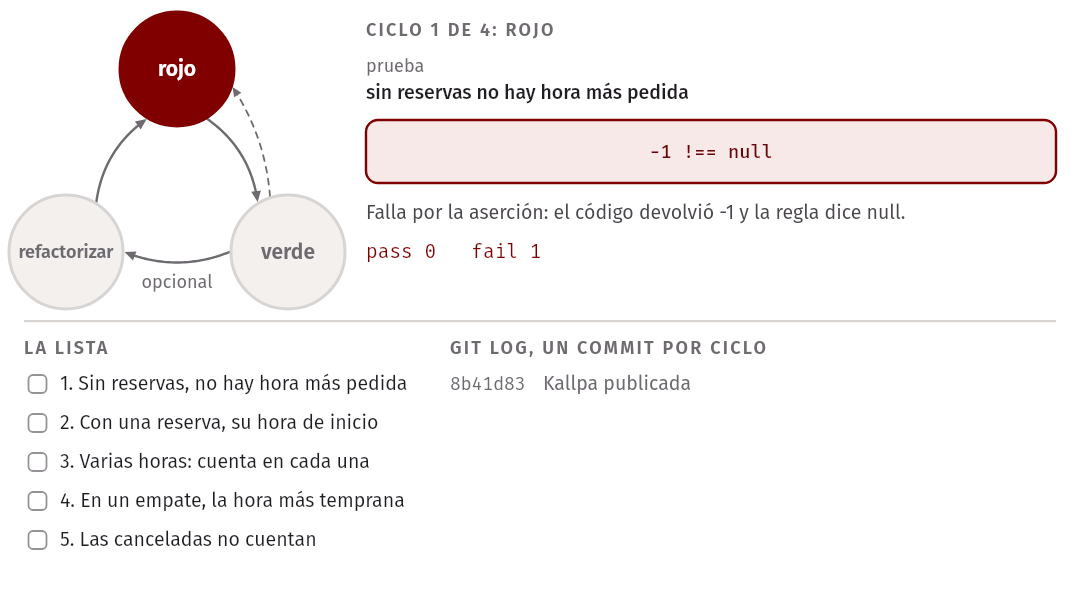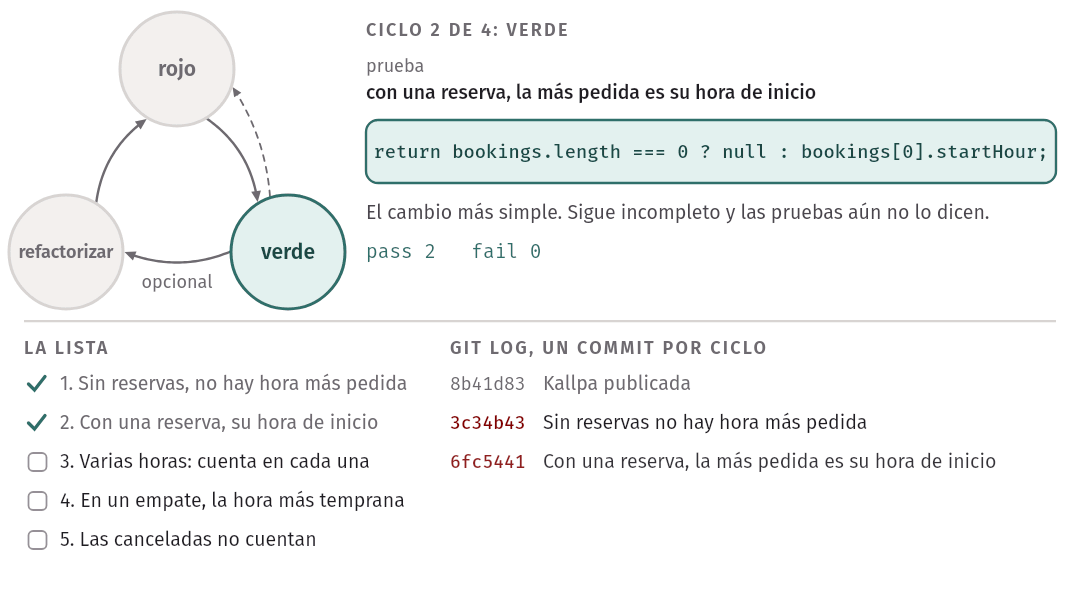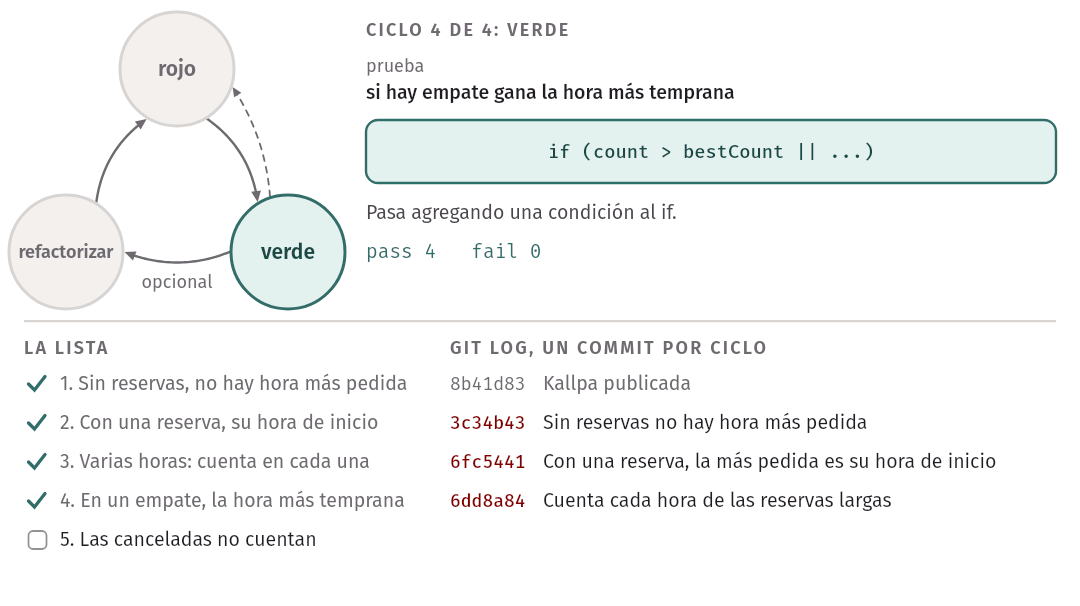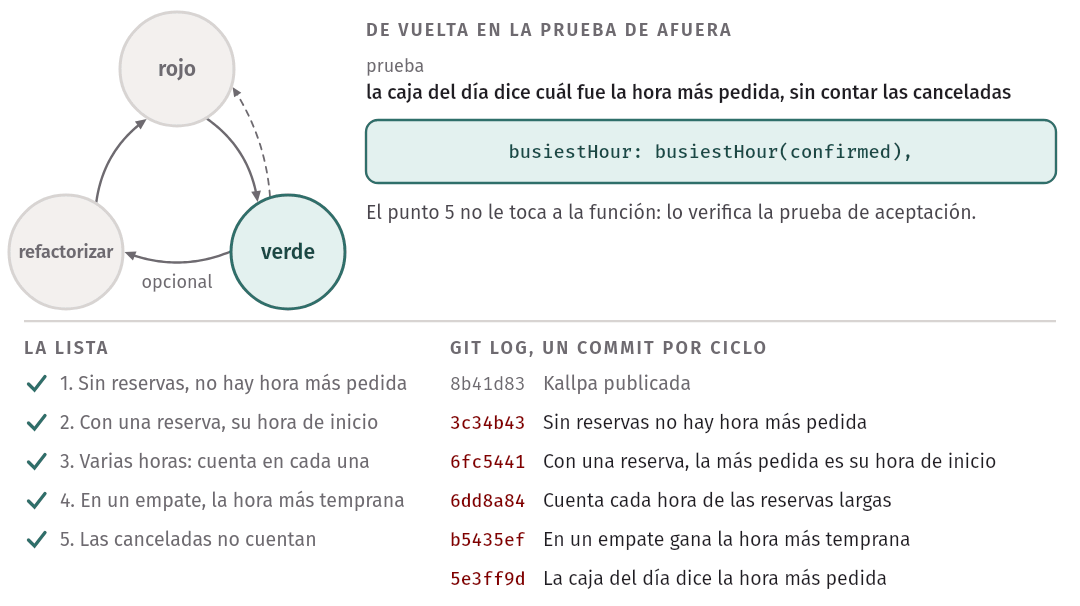
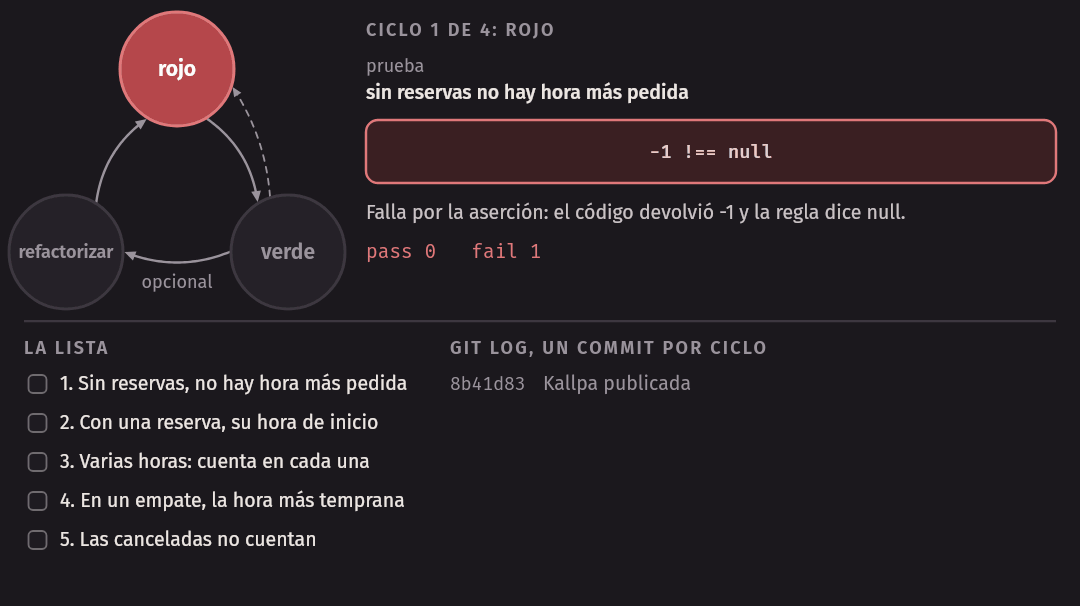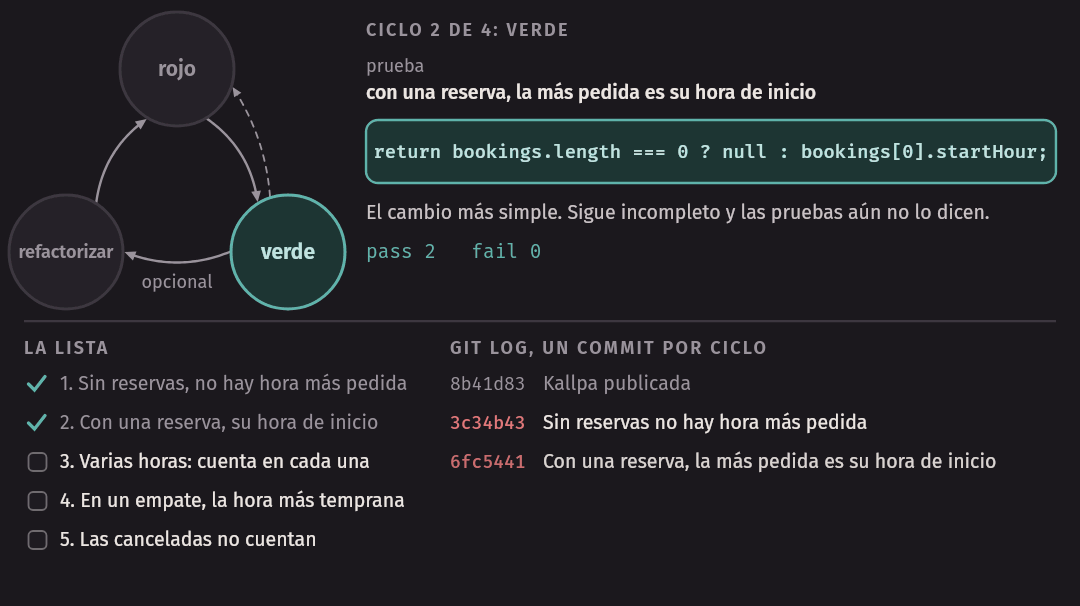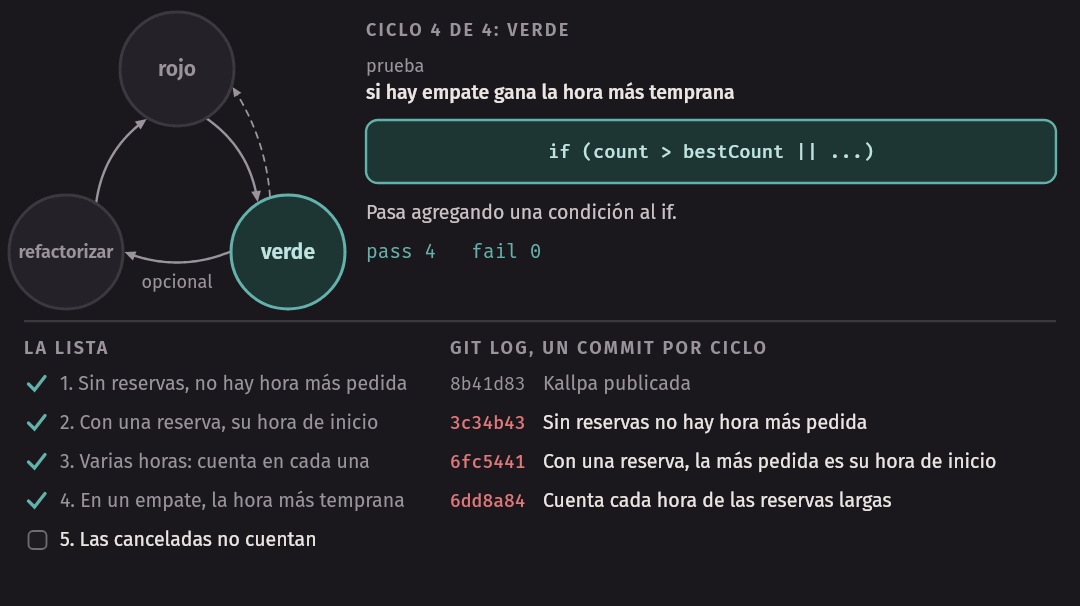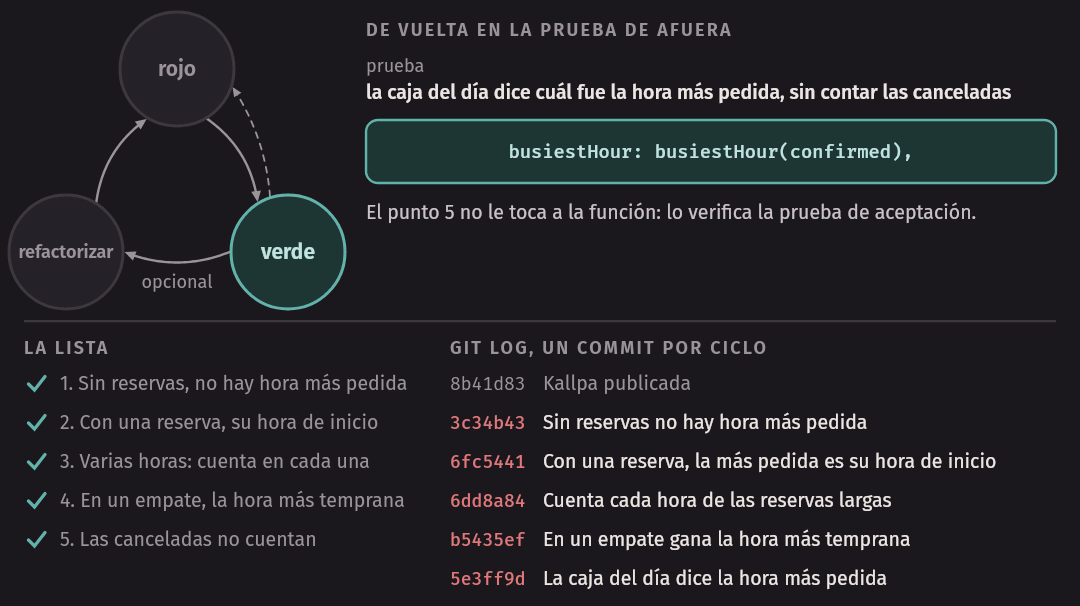
El ritmo se ve en la historia
Un commit por ciclo. Al final, la historia cuenta cómo creció la funcionalidad, con todas las pruebas en verde en cada commit:
$ git log --reverse --format='%h %s'
8b41d83 Kallpa publicada
3c34b43 Sin reservas no hay hora más pedida
6fc5441 Con una reserva, la más pedida es su hora de inicio
6dd8a84 Cuenta cada hora de las reservas largas
b5435ef En un empate gana la hora más temprana
5e3ff9d La caja del día dice la hora más pedida
Es también lo que va a mirar quien revise su laboratorio. Una sola línea con “agrega ocupación y sus pruebas” no permite saber si hubo TDD.
BDD
Empezar por una conversación
BDD (behaviour-driven development) es una forma de trabajar que busca cerrar la brecha entre la gente del negocio y la técnica. Fowler cuenta que la forma Given-When-Then la desarrollaron Daniel Terhorst-North y Chris Matts como parte de BDD. A pesar del nombre y de cómo se usa a veces, no consiste en una herramienta. La documentación de Cucumber lo dice en su introducción: hay mucho más en BDD que usar Cucumber. La describe con tres prácticas que se repiten por cada cambio chico:
- Descubrimiento (discovery): conversar sobre ejemplos concretos del comportamiento nuevo, para ponerse de acuerdo en los detalles.
- Formulación (formulation): escribir esos ejemplos en una forma que se pueda automatizar y revisar que todos están de acuerdo.
- Automatización (automation): implementar el comportamiento de cada ejemplo, empezando por una prueba automática que guía el código.
Ustedes ya hicieron las dos primeras. Los criterios de aceptación Dado/Cuando/Entonces de la semana 3 salieron de hablar con un cliente y son ejemplos concretos. BDD agrega el último paso: que se ejecuten.
De un criterio a una prueba
Fowler explica la forma en GivenWhenThen: dado describe el estado del mundo antes de la acción, cuando es la acción, entonces es lo que se espera que cambie. Este criterio pasa casi palabra por palabra a una prueba HTTP de Kallpa:
Dado que hoy es lunes 9 a las 10:00 y Rosa reservó la cancha 1 para hoy a las 11:00, cuando cancela, entonces la respuesta es 422 con
TOO_LATE_TO_CANCEL.
test('una hora antes de empezar ya no se puede cancelar', async () => {
  // Dado que hoy es lunes 9 a las 10:00 y Rosa reservó la cancha 1 para hoy a las 11:00
  const created = await postJson(`${server.url}/api/bookings`, {
    courtId: 1, memberId: 1, date: '2026-03-09', startHour: 11, hours: 1, teamName: 'Los Pumas de Comas',
  });
  assert.equal(created.status, 200);

  // Cuando cancela
  const { status, body } = await postJson(`${server.url}/api/bookings/${created.body.booking.id}/cancel`);

  // Entonces la respuesta es 422 con TOO_LATE_TO_CANCEL
  assert.equal(status, 422);
  assert.equal(body.error.code, 'TOO_LATE_TO_CANCEL');

  // Y la cancha sigue ocupada
  const availability = await getJson(`${server.url}/api/courts/1/availability?date=2026-03-09`);
  const eleven = availability.body.slots.find((slot: { hour: number }) => slot.hour === 11);
  assert.equal(eleven.available, false);
});
$ node --test acceptance.test.ts
▶ cancelar una reserva
✔ una hora antes de empezar ya no se puede cancelar (21.804417ms)
✔ cancelar una reserva (22.444666ms)
ℹ tests 1
ℹ suites 1
ℹ pass 1
ℹ fail 0
...Noten qué decide el “dado”: el reloj fijo de startTestServer marca las
10:00, y la reserva de la prueba se crea por la API, sin insertar nada directo
en la base. Revisar “la cancha sigue ocupada” es lo que distingue esta prueba
de una que solo mira el código de error: el negocio no quiere solo un mensaje,
quiere que la reserva siga en pie.
Gherkin y Cucumber
Gherkin es un formato para escribir esos escenarios en texto, con palabras clave fijas, de modo que los pueda leer el cliente. Cucumber es la herramienta que lo ejecuta: cada línea se conecta con una función que la implementa.
Característica: Cancelar una reserva

  Escenario: Una hora antes ya no se puede cancelar
    Dado que hoy es lunes 9 de marzo a las 10:00
    Y que Rosa reservó la cancha 1 para hoy a las 11:00
    Cuando Rosa cancela la reserva
    Entonces la respuesta es 422 con el código "TOO_LATE_TO_CANCEL"
(Gherkin admite palabras clave en español; este ejemplo es solo para leer: en el curso no se ejecuta.)
Esa capa cuesta: hay que escribir y mantener las funciones que conectan el
texto con el código. Vale la pena cuando el cliente de verdad lee o escribe
los escenarios. Cuando no, es una traducción más. En el curso no hace falta la
herramienta: describe y test, con nombres en español y comentarios
Dado/Cuando/Entonces, cumplen la misma función, y el cliente puede leer la
lista de nombres que imprime node --test.
Error común. Decir “hacemos BDD” porque se usa Cucumber, sin conversar con el cliente. Lo que se tiene entonces son pruebas de integración escritas en otro formato, más caras de mantener. Lo contrario sí es BDD: una conversación con ejemplos y unas pruebas en
node:test.
De afuera hacia adentro
La forma de juntar BDD con TDD se llama de afuera hacia adentro (outside-in): primero la prueba de aceptación por HTTP, que falla; después, las pruebas unitarias del dominio que la van haciendo pasar. Son dos ciclos, uno adentro del otro.
Nuestro ejemplo de la hora más pedida empezó en realidad así, antes del ciclo
- La prueba de aceptación cubre el punto 5 de la lista, el que quedó pendiente:
test('la caja del día dice cuál fue la hora más pedida, sin contar las canceladas', async (t) => {
  const server = await startTestServer();
  t.after(() => server.close());
  const day = { date: '2026-03-10', memberId: 1, teamName: 'Los Pumas de Comas' };

  // Dado que el martes hay dos reservas a las 19:00, una a las 8:00 y otra a las 8:00 que se canceló
  await postJson(`${server.url}/api/bookings`, { ...day, courtId: 1, startHour: 19 });
  await postJson(`${server.url}/api/bookings`, { ...day, courtId: 2, startHour: 19 });
  await postJson(`${server.url}/api/bookings`, { ...day, courtId: 3, startHour: 8 });
  const cancelled = await postJson(`${server.url}/api/bookings`, { ...day, courtId: 1, startHour: 8 });
  await postJson(`${server.url}/api/bookings/${cancelled.body.booking.id}/cancel`);

  // Cuando la administración pide la caja de ese día
  const { status, body } = await getJson(`${server.url}/api/reports/daily?date=2026-03-10`);

  // Entonces la hora más pedida es las 19:00
  assert.equal(status, 200);
  assert.equal(body.busiestHour, 19);
});
Los datos no son casuales. Si se contara la reserva cancelada, las 8:00 empatarían con las 19:00, y el empate lo ganaría la más temprana. Con los datos elegidos, la prueba falla si alguien cuenta las canceladas. Y el primer rojo:
✖ la caja del día dice cuál fue la hora más pedida, sin contar las canceladas (25.132291ms)
...
  AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

  undefined !== 19
Esa prueba se queda en rojo durante los cuatro ciclos del dominio y no entra a
ningún commit. Al terminar, conectar la función con la caja es un cambio de
tres líneas en report.ts:
+import { busiestHour } from './busiest-hour.ts';
...
+  busiestHour: number | null;
...
+    busiestHour: busiestHour(confirmed),
✔ la caja del día dice cuál fue la hora más pedida, sin contar las canceladas (24.582417ms)
ℹ tests 1
ℹ suites 0
ℹ pass 1
ℹ fail 0El último commit de la historia incluye esa prueba y ese cambio, y make check en esa copia pasa con las 45 pruebas (las 40 de Kallpa, las 4 del
dominio y la de aceptación).
¿Por qué los dos niveles? Son preguntas diferentes. La prueba de aceptación dice que el cliente recibe lo que pidió, y las unitarias dicen por qué y cubren los casos finos (el empate, las reservas largas) sin levantar un servidor por cada uno. Y fíjense en el orden: la prueba de afuera evita construir un dominio impecable que nadie llama.
En la industria. Fowler cuenta en GivenWhenThen que la forma viene de BDD, pero que no hace falta adoptar toda la metodología para aprovecharla: también se usa como comentarios que marcan los bloques de una prueba unitaria. Es lo que van a escribir en el paso 4 del laboratorio.
TDD con un agente
TDD es un buen protocolo para trabajar con un agente, porque separa roles. Ustedes escriben las pruebas, que son la especificación, y el agente escribe el código que las hace pasar. Es el mismo reparto de la semana 4: quien redacta el contrato decide qué se considera correcto, y las pruebas son un oráculo que no salió del mismo lugar que el código.
Hay que revisar dos riesgos en el diff.
Primero: que cambie o borre las pruebas para que pasen. Es la equivocación
que Beck nombra como “borrar aserciones para que la prueba finja pasar”, y el
agente tiene todos los incentivos para cometerla si solo se le pide que el
comando termine en verde. Antes de mirar el código, miren qué pasó en test/:
git diff --stat main -- test/Que una prueba cambie no siempre es malo: si el pedido cambia la forma de una respuesta, alguna prueba que la revise tiene que cambiar. Pero cada cambio en una prueba necesita una razón que salga del pedido, no de que estaba en rojo.
Segundo: que haga pasar exactamente los ejemplos. Un cambio como los que
suele proponer un agente cuando se le pide “haz pasar estas pruebas” (lo
escribimos para la clase, no es la salida de ninguna herramienta en
particular), en demos/overfit-busiest-hour.ts:
export function busiestHour(bookings: readonly { startHour: number; hours: number }[]): number | null {
  if (bookings.length === 0) return null;
  if (bookings.length === 3) return 20;
  return Math.min(...bookings.map((booking) => booking.startHour));
}
Pasa los cuatro ejemplos del ciclo sin contar ninguna hora. Basta otro ejemplo:
$ node --test demos/overfit.test.ts
✔ sin reservas no hay hora más pedida (0.484417ms)
✔ con una reserva, la más pedida es su hora de inicio (0.089916ms)
✔ una reserva de varias horas cuenta en cada una de sus horas (0.075541ms)
✔ si hay empate gana la hora más temprana (0.074125ms)
✖ ejemplo nuevo: dos reservas que comparten la hora de las 10:00 (0.5935ms)
ℹ tests 5
ℹ suites 0
ℹ pass 4
ℹ fail 1
...
  AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

  9 !== 10
Este riesgo no lo cierra un ejemplo más, porque una lista finita de ejemplos siempre se puede pasar con condiciones especiales. La semana 10 muestra cómo las pruebas basadas en propiedades cierran ese hueco.
Con IA. Lean el diff de un agente con tres preguntas. ¿Tocó
test/, y por qué? ¿Hay constantes o condiciones que se parecen demasiado a los datos de las pruebas? ¿Pueden inventar un ejemplo que no esté en la lista y ver si también pasa? La última es la que cuesta menos: escribir una prueba más, a mano, después de que el agente terminó. Y mantengan el ciclo chico también con un agente: un escenario, una prueba, un cambio. Un diff de 300 líneas que hace pasar diez pruebas de golpe es tan difícil de revisar como si lo hubiera escrito otra persona.
El laboratorio y el código de la semana
code/week-09
make prepara las demostraciones que necesitan una copia de Kallpa, y make test revisa los tipos, corre ESLint y corre las pruebas, que comprueban lo
que dice este capítulo. Nada toca la Kallpa original.
| Archivo | Qué comprueba |
|---|---|
sizes.test.ts |
Que pricing.test.ts no usa recursos y http.test.ts sí |
in-kallpa/ e in-kallpa.test.ts |
La prueba de interacción frente a la de comportamiento; los límites de la cobertura |
isolation.test.ts, demos/order-*.test.ts |
Una prueba que depende de otra y cómo aislarla |
oracle.test.ts, demos/oracle.test.ts |
Tres oráculos sobre un mismo error |
doubles.test.ts |
Dummy, stub, spy y mock sobre Kallpa |
booking-store.test.ts, demos/fake-drift.test.ts |
Un fake y sus pruebas de contrato |
seam.test.ts |
La misma regla con costura y sin ella |
coverage.test.ts |
Los números de cobertura de Kallpa y el mínimo |
tdd/ y tdd.test.ts |
Cada rojo y cada verde del ciclo; la historia de Git |
acceptance.test.ts |
Un criterio de aceptación ejecutable |
agent.test.ts, demos/overfit* |
La implementación hecha a la medida de los ejemplos |
Los archivos de demos/ fallan a propósito, y por eso no se corren
directamente: los corren las pruebas de la carpeta y revisan que fallen como
se dice aquí.
$ make test
...
✔ el ciclo de TDD (36.841375ms)
ℹ tests 56
ℹ suites 6
ℹ pass 56
ℹ fail 0
...
ℹ duration_ms 1775.893751
Pruebas unitarias de Kallpa con node:test
El laboratorio se hace en parejas, en su repositorio de Kallpa, en una rama
nueva y con un commit por paso. La guía de la semana
tiene los siete pasos: medir la cobertura, correr una por una las pruebas de
test/http.test.ts, clasificar los dobles, escribir pruebas de aceptación,
hacer TDD de occupancyPercent, fijar un mínimo de cobertura y abrir un pull
request con el antes y el después.
Algunas recomendaciones, sin quitarles el trabajo:
startTestServerno recibe un notificador. Para el paso 3, extiendan el helper o llamen directamente acreateServer, comocode/week-09/server.ts.- Para un cuerpo que no es JSON o que pasa de 16 KiB,
postJsonno sirve, porque siempre manda JSON válido: usenfetch. - En el paso 5, una prueba existente revisa con
deepEqualla forma exacta de lo que hay por cancha. Piensen qué significa que esa prueba cambie: ¿la respuesta cambió de forma de verdad, o solo la quieren ver en verde?
Con IA. El registro de uso del curso sigue vigente. Si le piden a un agente pruebas para el paso 4, la pregunta del paso 7 también vale para ustedes: por cada prueba, qué error del código la haría fallar. Y para el paso 5 las pruebas las escriben ustedes.
P3 está en curso y se entrega en la semana 11: las pruebas de este laboratorio
son el modelo para las del proyecto (enunciado de
P3). Allí se pide cobertura de al menos 70
% de líneas de src/, y que los nombres de las pruebas citen la historia.
Resumen
- Una suite existe para poder cambiar el código: detecta errores temprano, deja refactorizar y documenta lo que el sistema promete. La regla de Beyoncé dice que, si algo importaba, había que ponerle una prueba.
- Tamaño son los recursos que usa una prueba (un proceso sin E/S, una máquina, cualquier cosa). Alcance es cuánto código ejercita (unitaria, de integración, de punta a punta). Son preguntas independientes, y SWEG da una recomendación para cada una: escribir la prueba más pequeña posible, porque es más rápida y determinista, y, en alcance, seguir la pirámide: muchas unitarias, menos de integración y pocas de punta a punta.
- Una prueba frágil falla sin que el comportamiento haya cambiado; una ciega no falla cuando sí cambió. Probar a través de la interfaz pública, por comportamiento, y revisando el estado antes que las llamadas reduce los dos problemas.
- Una prueba clara dice el comportamiento en su nombre, se entiende sin saltar a otro archivo (DAMP antes que DRY), no tiene lógica, está aislada, y su oráculo viene de la especificación, no del código.
- Dobles de prueba: dummy (se pasa y no se usa), stub (respuestas fijas),
fake (funciona, con un atajo), spy (registra las llamadas) y mock (trae
programadas las llamadas que espera).
t.mock.fn()crea un spy, o un stub, según para qué se use. - Se prefiere la implementación real si es rápida y determinista; después, un fake con pruebas de contrato; y la interacción, para efectos que no se pueden observar de otra forma, como el aviso por WhatsApp. La inyección de dependencias da la costura que lo permite.
- La cobertura encuentra lo que no se ejecuta, pero no dice que algo se haya verificado. Una prueba sin aserciones puede dar 100 %. Sirve como piso y como pregunta, no como meta (ley de Goodhart). Además, solo cuenta los archivos que se cargaron.
- TDD: lista de escenarios y, para cada uno, rojo por la razón esperada, verde con el cambio más simple, y refactorizar. Un commit por ciclo. La evidencia sobre productividad y defectos es mixta; lo que queda seguro es una suite.
- BDD: una conversación con el cliente, ejemplos concretos, y esos ejemplos como pruebas ejecutables. Con o sin Gherkin. De afuera hacia adentro: primero la prueba de aceptación, después las unitarias.
- Con un agente, TDD reparte bien los roles, y en el diff se mira si tocó las pruebas y si hizo pasar justo los ejemplos.
Ejercicios
-
Clasifiquen por tamaño y por alcance: (a)
test/calendar.test.ts; (b) una prueba que llama adailySummarycon un arreglo de reservas; (c) una prueba que abre un archivo temporal de SQLite en disco; (d) una prueba que abre un navegador contra Kallpa levantada en otra máquina. Justifiquen con los recursos que usa cada una. -
Escriban una prueba sobre
quotePriceCentsque tenga el nombre'calcula bien', repita la fórmula del código y use unif. Luego reescríbanla como una o varias pruebas que sigan este capítulo. ¿Cuántas salieron? ¿Qué dice ahora el nombre cuando falla? -
Tomen la prueba
createBooking llama a service.saveBookingdein-kallpa/interaction.test.ts. Sin mirarbehavior.test.ts, escriban otra prueba para el mismo comportamiento que siga pasando si el guardado se muda a un módulo de reservas. ¿Qué dejó de saber su prueba sobre el código? -
Escriban una prueba que no cubra ninguna línea nueva de
src/domain/report.ts, y que sin embargo detecte un error que la suite actual no detecta. Introduzcan ese error en una copia y muestren que falla. ¿Qué dice este ejercicio sobre la cobertura? -
Para cada doble, digan qué clase es y justifíquenlo: (a)
{ now: () => new Date('2026-03-09T15:00:00Z') }; (b){ bookingConfirmed: (c) => sent.push(c) }; (c) una claseInMemoryCourtRepositorycon un arreglo; (d){ bookingConfirmed() { throw new Error('no debería llamarse'); } }; (e)t.mock.fn()si la prueba nunca revisamock.calls. -
Agreguen al contrato de
booking-store-contract.tsuna prueba de quelistByMemberordena por fecha y hora. ¿Pasa con el fake y con la real? Después agreguen una prueba de que una reserva con un miembro que no existe se rechaza. Expliquen el resultado, y decidan si hay que arreglar el fake o sacar esa prueba del contrato. -
Reescriban
no-seam.tspara que tenga una costura, de dos maneras: recibiendo unLimaTimey recibiendo unClock. ¿Cuál se prueba con menos código? ¿Cuál deja más responsabilidad a quien llama? -
Corran la cobertura de Kallpa con
--test-coverage-include-all, sin--test-coverage-include. ¿Qué archivos nuevos aparecen, además de los desrc/, y cuánto da el total? Para su proyecto, decidan qué archivos tendrían que contar y escriban el comando. -
Hagan TDD, con un commit por ciclo, de una función
longestFreeBlock(bookings)que diga cuántas horas seguidas libres deja el día en una cancha (de 7:00 a 22:00). Escriban primero la lista. En su historia de Git, ¿se nota qué ejemplo los obligó a generalizar? -
Tomen dos criterios de aceptación de su proyecto (de P1) y conviértanlos en pruebas
node:testcon comentarios Dado/Cuando/Entonces, y un nombre que cite la historia. ¿El criterio estaba lo bastante claro para escribir la prueba, o hubo que preguntarle algo al cliente? -
Escriban una implementación de
busiestHourque pase los cuatro ejemplos del capítulo y también el “ejemplo nuevo” dedemos/overfit.test.ts, sin contar las horas. ¿Qué concluyen sobre cuántos ejemplos hacen falta? Traigan la respuesta a la próxima clase: es el punto de partida de las pruebas basadas en propiedades. -
Le piden a un agente que implemente una funcionalidad con TDD, y su diff agrega 200 líneas a
src/, ninguna entest/, y borra una prueba detest/http.test.tscon el mensaje “elimina prueba obsoleta”. Escriban los comentarios de revisión que le dejarían, y digan qué comprobarían antes de escribirlos.