Apuntes · Capítulo 12Calidad: pruebas, revisión e integración
Integración continua y dependencias
Integración continua y dependencias
La semana pasada endurecieron Kallpa con revisión de código y análisis
estático. Todas esas herramientas tienen el mismo punto débil: alguien tiene
que correrlas. make check no sirve de nada si quien abrió el pull request se
olvidó de correrlo, o si lo corrió en su computadora, con otra versión de
TypeScript, y nadie más lo vio. Esta semana hacemos que esa revisión deje de
depender de la memoria de las personas.
El capítulo tiene dos partes, como la semana. En la primera estudiamos la
integración continua: qué es como práctica, qué hace que un build sea
confiable, cómo se construye un pipeline en GitHub Actions y qué hace falta
para que ese pipeline impida algo, además de mostrar un color. En la segunda
estudiamos las dependencias: el código que no escribieron y del que igual
responden. Veremos versionado semántico, lockfiles, dependencias transitivas,
cómo evaluar un paquete antes de agregarlo, los ataques a la cadena de
suministro, los paquetes inventados por modelos de lenguaje y cómo leer un
reporte de npm audit sin hacer una tontería.
Las dos partes se juntan en una sola idea: un build solo informa si sus entradas están bajo control. Las entradas de un build son el código de ustedes y todo el código de otros que entra con él. Hoy instalarán seis paquetes para revisar Kallpa y llegarán cien.
Lectura. Para la primera parte: Software Engineering at Google (SWEG), cap. 23, Continuous Integration, y cap. 18, Build Systems and Build Philosophy, hasta Modern Build Systems inclusive. Para la segunda: SWEG, cap. 21, Dependency Management, y Russ Cox, Our Software Dependency Problem (2019). Complementarias: Martin Fowler, Continuous Integration (2024); GitHub, documentación de GitHub Actions, en especial Workflow syntax y Secure use reference; Versionado semántico 2.0.0; npm,
npm ci,package-lock.jsonynpm audit; Spracklen y otros, We Have a Package for You! A Comprehensive Analysis of Package Hallucinations by Code Generating LLMs (USENIX Security Symposium, 2025); SLSA y OpenSSF Scorecard. El código del capítulo está encode/week-12y se prueba conmake testdentro del contenedor del curso.
Todas las salidas de este capítulo son de corridas reales en el contenedor del curso, del 2 de noviembre de 2026. Las que dependen del registro de npm pueden no coincidir con lo que ustedes vean: el registro cambia todos los días. Esa es, justamente, parte de la lección.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Qué es la integración continua, Una práctica, no una herramienta, Por qué esperar sale caro y Las reglas que la hacen funcionar; de Presubmit y post-submit, Qué corre antes de integrar; de GitHub Actions, Las piezas; de Una dependencia es código del que responden, Qué se está aceptando y Por qué es difícil; y de Versionado semántico, La convención y Una promesa, no una garantía.
- En clase: Sesión A: Qué es la integración continua, El build, cuando no hay compilación, Presubmit y post-submit, GitHub Actions, Seguridad del pipeline y Un pipeline que no impide nada. Sesión B: Una dependencia es código del que responden, Versionado semántico, El lockfile, Dependencias transitivas, Antes de agregar una dependencia, La cadena de suministro, Paquetes que no existen y Leer
npm auditcon criterio. Laboratorio: El laboratorio: un pipeline para Kallpa.- Después de clase: el Resumen y los Ejercicios. Para profundizar: Reproducible y hermético, Pruebas inestables, El problema del diamante,
peerDependencies, Defensas, y lo que no cubren y las lecturas del recuadro Lectura.
Qué es la integración continua
Una práctica, no una herramienta
Empecemos por la definición, porque casi todo el mundo la usa mal. Martin Fowler, en su artículo de 2024, escribe:
Continuous Integration is a software development practice where each member of a team merges their changes into a codebase together with their colleagues changes at least daily. Each of these integrations is verified by an automated build (including test) to detect integration errors as quickly as possible.
En español: la integración continua es una práctica en la que cada integrante integra su trabajo a la rama principal al menos una vez al día, y cada integración se verifica con un build automático que incluye las pruebas.
Tiene dos partes, y las dos son obligatorias:
- Integrar seguido. Es una decisión del equipo: cambios chicos que entran
a
maintodos los días. - Verificar cada integración. Es un servidor que corre un build.
La mayoría de la gente cree que integración continua es la segunda. Fowler lo dice sin rodeos cuando alguien le pregunta si se puede correr un servicio de CI sobre feature branches: “yes - but you’re not doing Continuous Integration”. Lo que hacen esas herramientas, dice, se llamaría mejor continuous build service. Son una ayuda útil, y no hay que confundir la herramienta con la práctica.
Por eso, un equipo con un pipeline perfecto y ramas que viven tres semanas no hace integración continua. Tiene un build automático, que ya es algo, pero se entera de los choques entre su trabajo y el de los demás tres semanas tarde.
Idea clave. La integración continua no se instala. El pipeline verifica cada integración; integrar todos los días lo decide el equipo. Sin lo segundo, lo primero solo verifica ramas aisladas.
SWEG parte de esa misma definición, en una versión más antigua que dice integrate their work frequently, y resume el objetivo en una frase: detectar los cambios problemáticos automáticamente y lo antes posible. Después propone una definición más amplia, pensada para sistemas enormes: the continuous assembling and testing of our entire complex and rapidly evolving ecosystem. Es decir, no solo su código cambia: también cambian los servicios a los que llaman, los datos, el sistema operativo y las bibliotecas. Por eso las dos partes de este capítulo van juntas. Las dependencias son una de esas cosas que cambian sin pedirles permiso.
Por qué esperar sale caro
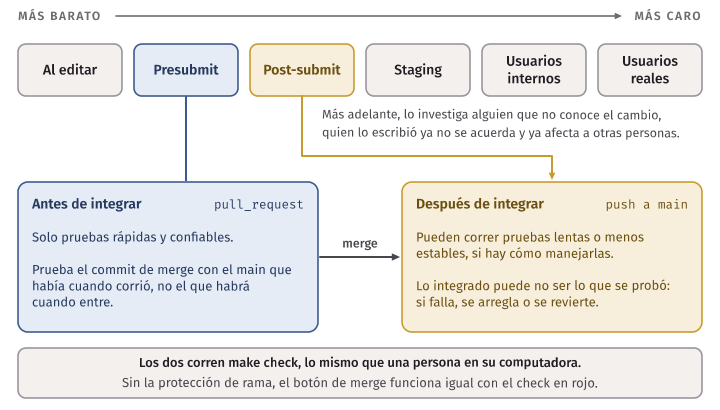
SWEG ordena los lugares donde se puede detectar un error, del más barato al más caro:
- En el ciclo de edición de quien lo escribe.
- En las pruebas automáticas antes de integrar (presubmit).
- Después de integrar, cuando se prueban dos cambios juntos (post-submit).
- En un ambiente de staging.
- Con usuarios internos.
- Con usuarios reales, o en la prensa.
Cada paso siguiente cuesta más por tres razones, según el capítulo: el error lo investiga alguien que no conoce el cambio; quien lo escribió ya no se acuerda de los detalles; y el problema ya afecta a otras personas. La palabra que usa SWEG es feedback loop, y la integración continua es la manera de acortarlo.
La misma lógica vale para el tiempo entre integraciones. Si cada uno integra cada dos horas, un choque con el trabajo de otra persona se descubre con dos horas de cambios sospechosos. Si integra cada dos semanas, con dos semanas.
Dos ramas en verde, un merge en rojo
¿Pueden chocar dos cambios que no tocan las mismas líneas? Sí, y es el caso más incómodo, porque Git no avisa de nada. Fowler los llama conflictos semánticos, y SWEG, mid-air collisions (choques en el aire), cuando ocurren mientras las pruebas de un cambio están corriendo.
Lo armamos en una copia de Kallpa con make colision. Desde el mismo commit
salen dos ramas:
renombra-solescambia el nombre deformatSolesacentsToSolesenpricing.tsy en todas las líneas donde se usa:notifier.tsytest/pricing.test.ts.linea-de-cajaagrega areport.tsuna función nueva que llama aformatSoles, con su nombre de siempre.
Cada una por separado está perfecta. Al juntarlas:
--- rama renombra-soles
make check: código de salida 0
--- rama linea-de-caja
make check: código de salida 0
--- las dos juntas

$ git merge --no-edit linea-de-caja
Merge made by the 'ort' strategy.
 src/domain/report.ts | 6 ++++++
 1 file changed, 6 insertions(+)
[código de salida: 0]

$ make check
tsc -p .
src/domain/report.ts(1,10): error TS2305: Module '"./pricing.ts"' has no exported member 'formatSoles'.
make: *** [Makefile:28: typecheck] Error 2
[código de salida: 2]
Git hizo el merge sin una sola queja: los archivos que tocó cada rama no se pisan. Las dos revisiones pudieron aprobar con razón, y los dos pipelines salieron en verde con razón. Lo que está roto es la combinación, y nadie la había probado.
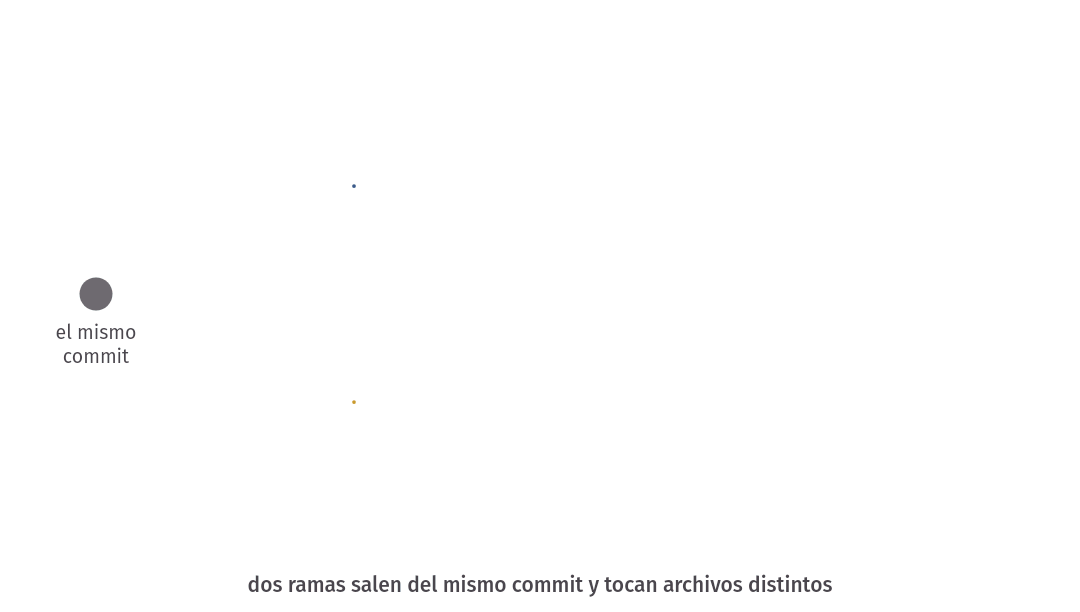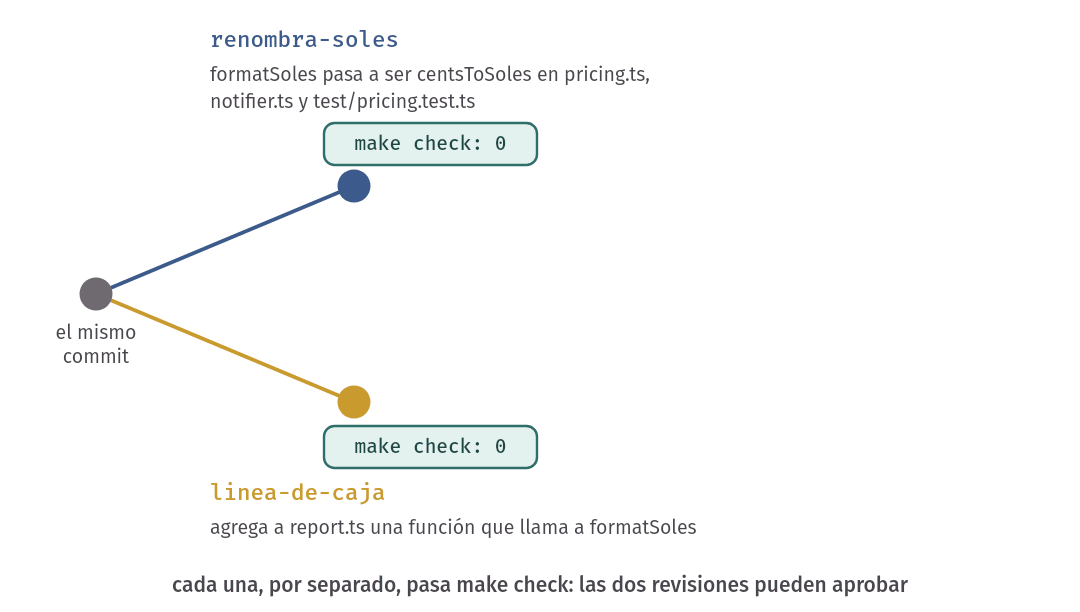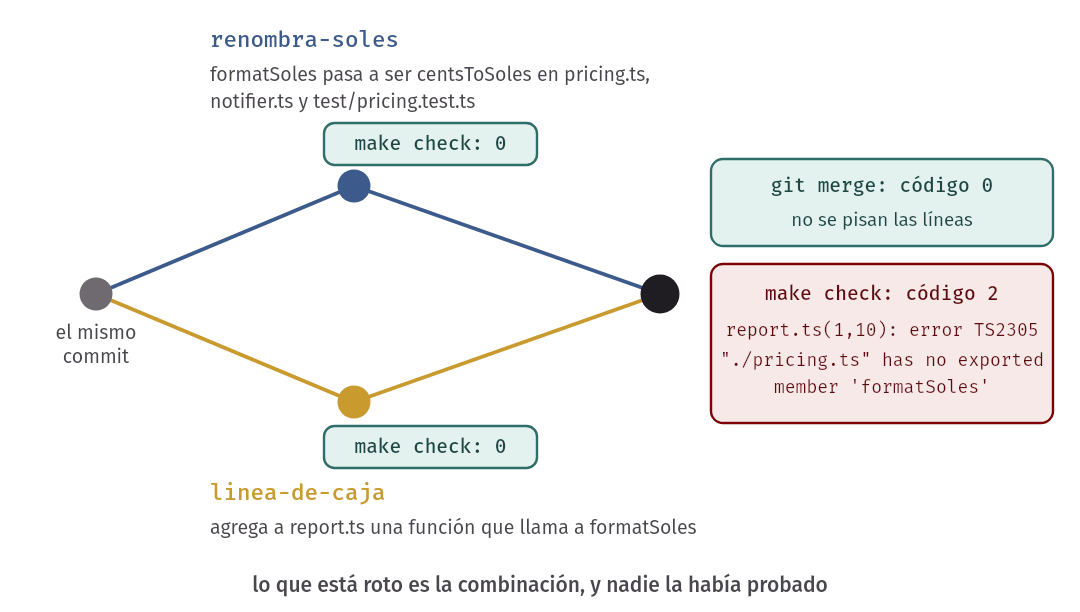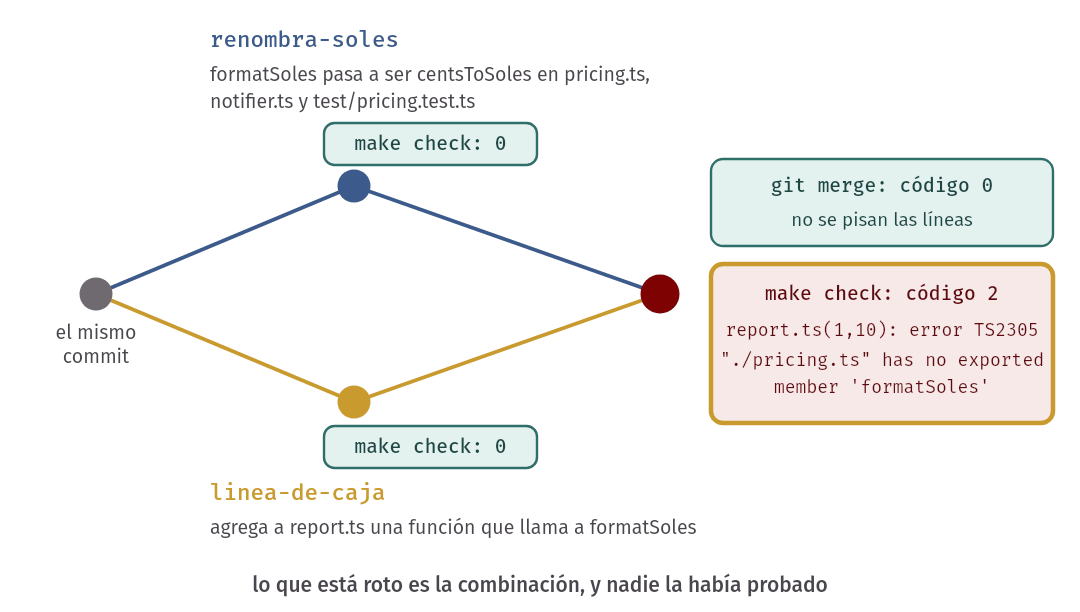
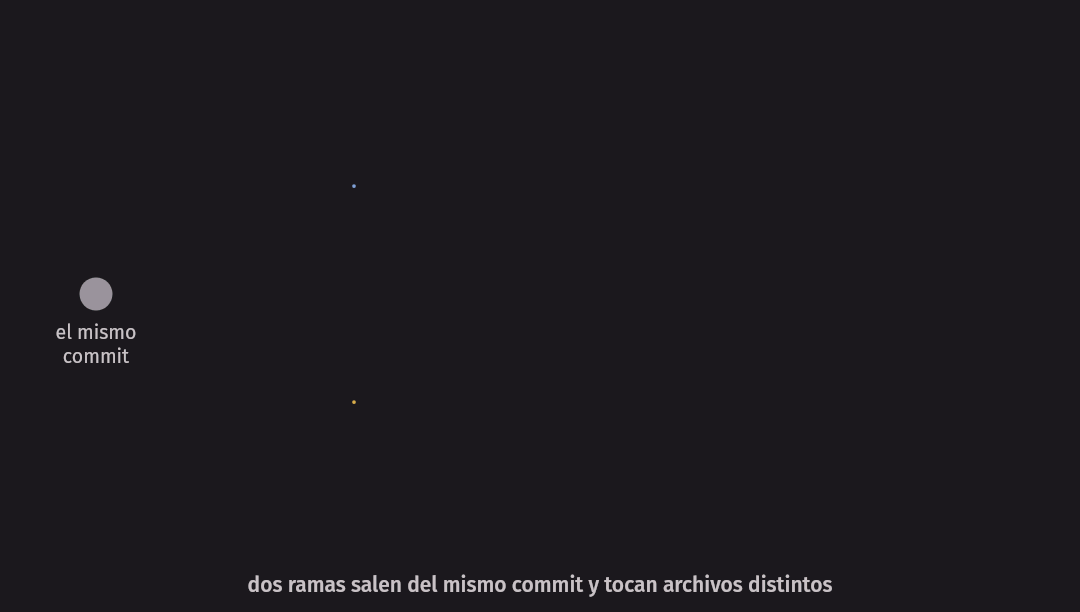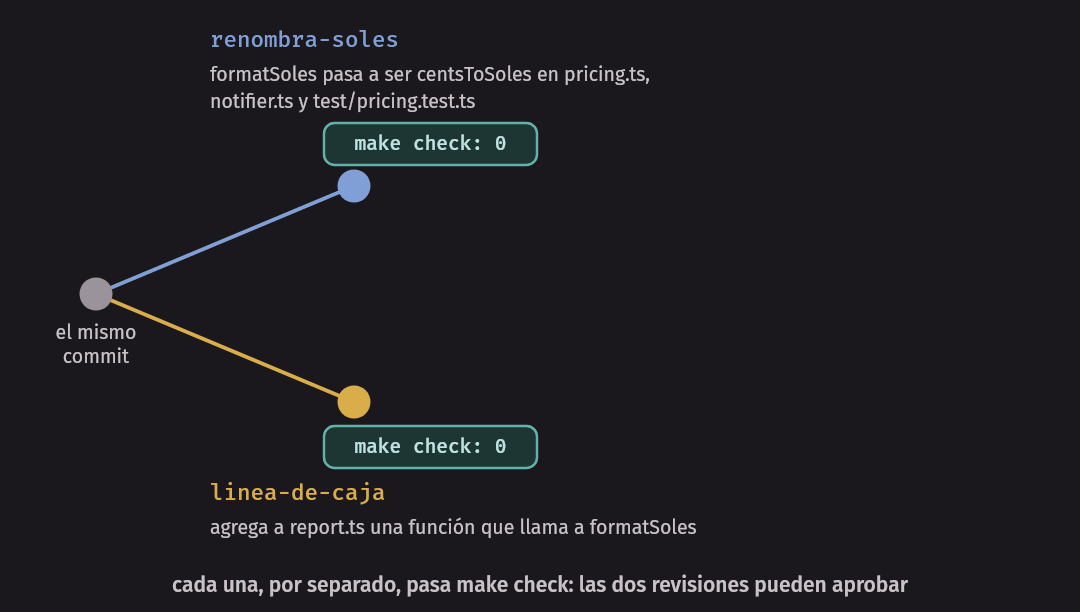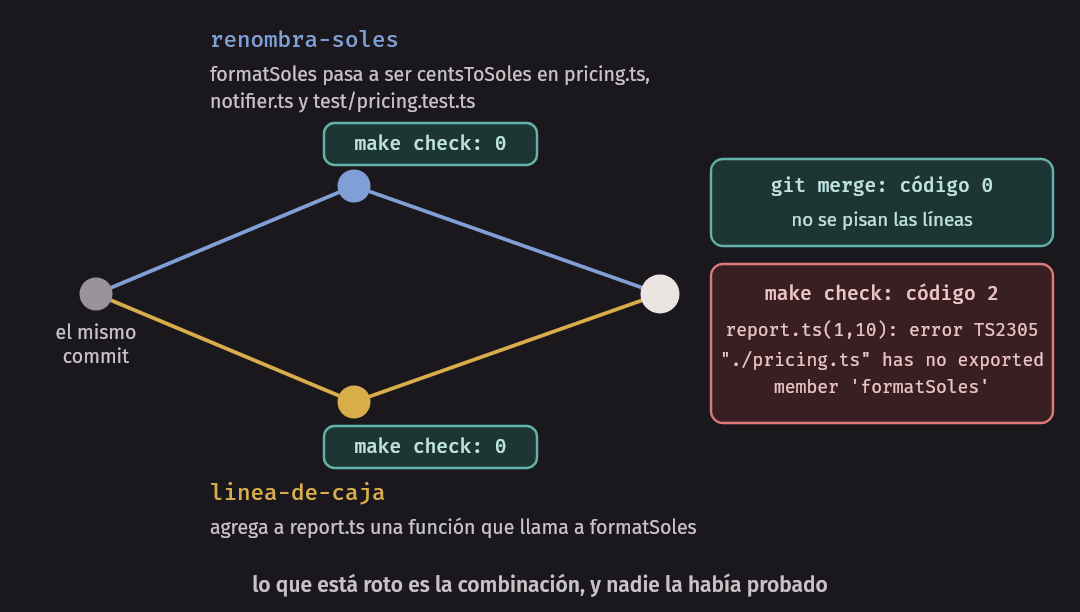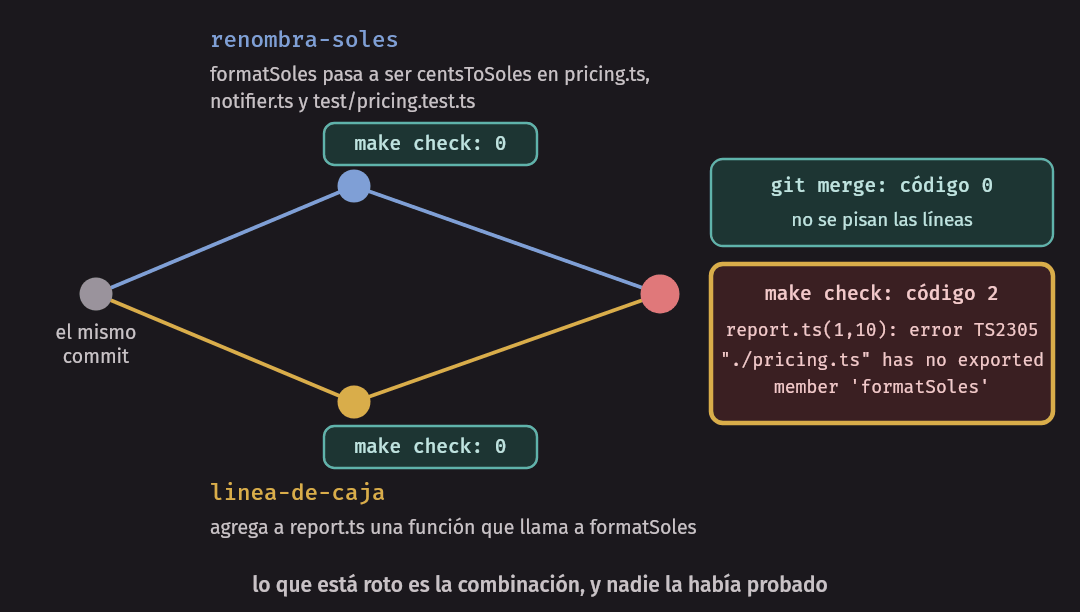
De aquí salen dos conclusiones. La primera: mientras menos tiempo vivan las ramas, menos combinaciones sin probar hay y más fácil es encontrar cuál fue, porque, como dice Fowler, solo hay unas pocas horas de cambios donde buscar. La segunda: algo tiene que probar el resultado del merge, no solo cada rama por su lado. Volveremos a esto cuando veamos la protección de ramas.
Las reglas que la hacen funcionar
El artículo de Fowler enumera las prácticas una por una. Estas son las que importan esta semana:
| Práctica (nombre en Fowler) | Qué quiere decir | En Kallpa |
|---|---|---|
| Put everything in a version controlled mainline | Un repositorio y una rama principal, con todo lo necesario para construir | main, con el Makefile, el tsconfig.json, la configuración de ESLint y, desde hoy, el lockfile |
| Automate the Build | Un solo comando | make check |
| Make the Build Self-Testing | El build incluye las pruebas | make check corre node --test |
| Everyone Pushes Commits To the Mainline Every Day | Integrar todos los días | Pull requests chicos, como en la semana 11 |
| Every Push to Mainline Should Trigger a Build | Lo verifica una máquina, siempre | El workflow de hoy |
| Fix Broken Builds Immediately | Nada es más urgente que el rojo | Arreglar o revertir |
| Keep the Build Fast | Minutos | Las 40 pruebas de Kallpa tardan décimas de segundo |
| Everyone can see what’s happening | El resultado está a la vista de todos | La pestaña Checks del pull request |
Tres comentarios sobre esa tabla.
Fix Broken Builds Immediately. Fowler cita a Kent Beck: “nobody has a higher priority task than fixing the build”. No significa que todo el equipo se detenga; suele bastar con un par de personas. Y aclara que lo mejor, muchas veces, es revertir el commit que lo rompió y arreglarlo con calma. SWEG dice lo mismo: revertir suele ser la ruta más rápida y segura, porque deja el sistema en un estado conocido. En Google la plataforma de pruebas ya revierte sola algunos cambios cuando tiene mucha certeza de que son los culpables.
Keep the Build Fast. Fowler usa como guía la de Extreme Programming: un build de diez minutos. No es una ley, y él mismo lo llama guideline, pero marca de qué hablamos: si el build tarda una hora, nadie espera el resultado antes de pasar a otra cosa, y el rojo llega cuando la persona ya no se acuerda del cambio.
Un build que pasa “casi siempre” no da información. Si el rojo puede significar “se rompió algo” o “volvió a pasar lo de siempre”, la gente aprende a ignorarlo. Lo veremos con números en la sección de pruebas inestables.
En la industria. SWEG cuenta el caso de Google Assistant. Cuando corrían en presubmit pruebas que dependían de servicios reales, las pruebas fallaban rutinariamente, y había días en que más de 50 cambios pasaban por encima de los resultados sin hacerles caso. Al volverlas herméticas redujeron el tiempo de corrida en un factor de 14, prácticamente sin inestabilidad. El costo no desapareció: las pruebas no herméticas se fueron a post-submit, sus fallas se acumulan ahí, y algunos equipos simplemente las desactivan. Es un solo equipo y un relato del propio Google, no un experimento. Sirve como ejemplo de un mecanismo, no como medida de cuánto van a ganar ustedes. (SWEG, cap. 23.)
Error común. Decir “hacemos CI porque tenemos GitHub Actions”. Pregunten dos cosas: ¿cuántas veces al día entra código a
main?, ¿cuánto vive una rama? Si la respuesta es “una vez por sprint” y “dos semanas”, tienen un pipeline, y eso es bueno, pero todavía no tienen integración continua.
El build, cuando no hay compilación
Qué es un build
SWEG, en el capítulo 18, dice que un sistema de build transforma el código en algo ejecutable, y que uno bueno optimiza dos propiedades:
- Rápido. Un solo comando, y el resultado en poco tiempo.
- Correcto. Cada vez que cualquiera corre el build en cualquier máquina, obtiene el mismo resultado, si las entradas son las mismas.
Kallpa plantea una duda legítima: Node ejecuta TypeScript directamente. Quita
los tipos al cargar y corre. No hay ningún paso que genere JavaScript, así que
¿qué es “el build”? La respuesta del capítulo 23 de SWEG ayuda: romper el build
incluye romper las pruebas, no solo la compilación. En un proyecto como este,
el build es lo que tiene que pasar para decir que un cambio está bien. En
Kallpa son tres cosas, y son exactamente lo que corre make check:
check: typecheck lint test

typecheck:  tsc -p .
lint:       eslint .
test:       node --test "test/**/*.test.ts"
En la semana 13 se agrega la imagen de contenedor, y ahí sí habrá un artefacto que construir.
Que no haya compilación vuelve más importante este paso. Miren este cambio
(make tipos): en notifier.ts, a formatSoles le pasamos un string en
lugar de un number.
$ make test | tail -8
ℹ tests 40
ℹ suites 6
ℹ pass 40
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 188.724542

$ make typecheck
tsc -p .
src/notifications/notifier.ts(21,146): error TS2345: Argument of type 'string' is not assignable to parameter of type 'number'.
make: *** [Makefile:28: typecheck] Error 2
[código de salida: 2]
Las 40 pruebas pasan. Node quitó los tipos sin mirarlos, y dentro de
formatSoles la cuenta cents / 100 convierte el texto en número, así que el
resultado es el mismo. El programa corre, el servidor levanta y el mensaje sale
bien. La única línea de defensa contra ese error es que alguien corra
tsc. Si el build no incluye tsc, los tipos son comentarios.
Idea clave. Sin un paso de compilación, nada obliga a que los tipos sean ciertos.
make checkes el compilador que no tienen, y el pipeline es lo que garantiza que corra.
Reproducible y hermético
Dos palabras que se usan mucho:
- Un build es reproducible si con las mismas entradas da el mismo resultado, en cualquier máquina y en cualquier momento.
- Un build es hermético si no depende de nada que no haya declarado: ni de lo que esté instalado en la máquina, ni de la zona horaria, ni de la red, ni de otro servicio.
Lo segundo es una forma de conseguir lo primero. SWEG usa hermético sobre todo para las pruebas (cap. 23: pruebas que corren contra un ambiente autocontenido, sin dependencias externas). El capítulo 18 trata las mismas ideas con otras palabras: las herramientas son dependencias, con versión declarada; las acciones del build corren aisladas, viendo solo sus entradas; y las dependencias externas se fijan con un hash, porque si un archivo remoto cambia sin que cambie el código, “a build might work one day and fail the next for no obvious reason”. Su resumen del capítulo lo dice de forma tajante: depender de la “última” versión es una receta para el desastre y para builds que no se pueden reproducir.
“En mi computadora pasa” casi siempre significa que algo no estaba fijado. Este
es un ejemplo mínimo. Una función calcula la fecha de una reserva con
getDate(), que usa la zona horaria de la máquina, y su prueba se escribió en
Lima (make zona):
$ TZ=America/Lima node --test ejemplos/fecha-local.check.ts | grep -E '^(✔|✖) la fecha|^ℹ (pass|fail)'
✔ la fecha según la máquina (0.489541ms)
✔ la fecha en Lima (0.185209ms)
ℹ pass 2
ℹ fail 0

$ TZ=UTC node --test ejemplos/fecha-local.check.ts | grep -E '^(✔|✖) la fecha|^ℹ (pass|fail)' | head -4
✖ la fecha según la máquina (1.120167ms)
✔ la fecha en Lima (0.20975ms)
ℹ pass 1
ℹ fail 1
Las 21:00 del viernes en Lima ya son sábado en UTC. La prueba pasa en todas las laptops del equipo y falla en el pipeline, porque los runners de GitHub están en UTC. Nadie miente: las dos máquinas dan el resultado correcto para lo que se les preguntó. La zona horaria era una entrada del build y nadie la había declarado.
Kallpa ya estaba preparada para esto. clock.ts usa la zona America/Lima de
forma explícita (por eso “la fecha en Lima” pasa en las dos), y las pruebas
usan un reloj fijo y una base de datos :memory:. No fue casualidad.
Revisemos todas las entradas del build de Kallpa, porque el resultado es honesto pero no perfecto:
| Entrada | ¿Fijada? | Cómo |
|---|---|---|
| El código | Sí | El commit |
| TypeScript, ESLint, fast-check, tipos | Desde hoy | Versión exacta en package.json |
| Los otros 94 paquetes | Desde hoy | Versión y hash en package-lock.json |
| Hora y zona horaria en las pruebas | Sí | fixedClock y limaTime |
| Base de datos | Sí | :memory:, se crea en cada prueba |
| Servicios externos | Sí | Kallpa no llama a ninguno |
| Versión de Node | A medias | En el workflow: node-version: 26 acepta cualquier 26.x |
| Sistema operativo del runner | A medias | ubuntu-latest es una etiqueta que se mueve: el repositorio de las imágenes anuncia que pasa a Ubuntu 26.04 en noviembre de 2026 |
| El registro de npm | No | npm ci lo necesita disponible, aunque los hashes aseguren qué baja |
Dos de esas filas son decisiones razonables para un proyecto como este: fijar todo cuesta trabajo, y actualizar a mano la versión del sistema operativo tiene su propio riesgo. Lo importante es saber qué no está fijado, para que cuando el pipeline se ponga rojo un lunes sin que nadie haya tocado nada, la lista de sospechosos esté escrita.
Sistemas de build: tareas y artefactos
El capítulo 18 de SWEG recorre la historia de los sistemas de build, y vale la pena conocer la distinción de Modern Build Systems, aunque no la usemos.
Un sistema basado en tareas (Ant, Maven, Gradle, y también Make, que es el de Kallpa) define tareas: scripts que hacen lo que quieran y que dependen de otras tareas. Es muy flexible. El problema, dice SWEG, es que da demasiado poder a los scripts: como una tarea puede hacer cualquier cosa, el sistema no sabe qué lee ni qué escribe. Por eso le cuesta correr tareas en paralelo, le cuesta saber qué volver a construir, y los propios scripts se vuelven código con errores que nadie revisa.
Un sistema basado en artefactos (Blaze en Google, Bazel, Pants, Buck) le quita ese poder a los ingenieros. En vez de decir cómo se construye, se declara qué hay que construir y a partir de qué. El sistema decide los pasos, y como conoce todas las entradas de cada paso, puede aislarlos, repetirlos y guardar sus resultados.
SWEG lo presenta como una necesidad de escala: su ejemplo es un monorepo de
miles de millones de líneas. El Makefile de Kallpa tiene siete objetivos y no
necesita nada de eso. Pero las lecciones se trasladan: declarar las
herramientas, aislar lo que se pueda y no descargar versiones “últimas” valen
también para un proyecto pequeño.
La regla: el pipeline llama a lo mismo
Hay una regla de la que depende todo lo demás en este capítulo:
Idea clave. El pipeline llama a lo mismo que corre una persona en su computadora, no a una copia con otros comandos.
Si el workflow corre tsc --noEmit && eslint src && node --test y su
Makefile corre otra cosa, tienen dos definiciones de “está bien”, y un día
van a discrepar: el pipeline pasará y su laptop no, o al revés. Se perderá una
tarde en entender por qué. Con make check en los dos lados, hay una sola
definición. Si mañana agregan un paso, lo agregan en un solo lugar.
Esa regla tiene un costo, y lo vamos a pagar hoy: en el contenedor, tsc está
en el PATH; en un runner, no está. Por eso los primeros pasos del workflow no
son la revisión, sino preparar el ambiente para que make check funcione
igual.
Presubmit y post-submit
Qué corre antes de integrar
En Google, presubmit son las pruebas que corren antes de integrar un cambio, y post-submit las que corren después. Es la decisión central de un sistema de CI: SWEG resume el capítulo diciendo que un sistema de CI decide qué pruebas usar y cuándo.
¿Por qué no correr todo antes de integrar? SWEG da tres razones:
- Es caro. El tiempo de quien espera es valioso, y las pruebas pasan mucho más seguido de lo que fallan, así que la mayor parte de esa espera no aporta.
- La inestabilidad bloquea. Una falla que no tiene que ver con el cambio detiene a alguien sin que haya hecho nada mal.
- No alcanza de todas maneras. Mientras corren las pruebas, el repositorio puede cambiar: es el choque en el aire que vieron arriba.
Su regla práctica para presubmit: only fast, reliable ones. A cambio, se acepta algo de pérdida de cobertura antes de integrar, se atrapa lo demás después y se acepta que habrá que revertir algunas cosas. Después de integrar pueden correr pruebas más lentas o menos estables, si hay mecanismos para manejarlas.
En la industria. TAP, la plataforma de pruebas de Google, hace justo eso. Antes de integrar corre las pruebas asociadas al cambio; después corre en forma asíncrona todo lo que el cambio podría afectar, incluidas las pruebas grandes y lentas. Como no puede correr todo para cada cambio, agrupa varios, y cuando un grupo falla, usa dos caminos para encontrar al culpable: separa el grupo y vuelve a probar cada cambio, y además da herramientas para hacer una búsqueda binaria entre ellos. Su norma cultural desalienta con fuerza integrar trabajo nuevo encima de pruebas que se sabe que fallan. (SWEG, cap. 23.)
En GitHub, esto se traduce en un workflow que corre en el evento pull_request
(presubmit) y otro, o el mismo, en push a main (post-submit). Un equipo de
ustedes tiene pocas pruebas y rápidas, así que todo cabe en las dos. El día que
tengan pruebas de punta a punta que tarden veinte minutos, ya tienen el
criterio para decidir dónde van.
¿Para qué correr de nuevo en push a main, si ya pasó en el pull request?
Porque lo que se integró puede no ser lo que se probó: si main avanzó desde
que corrió el check, el resultado del merge es otra combinación. Es el caso de
las dos ramas de arriba.
Pruebas inestables
Una flaky test es una prueba que a veces pasa y a veces falla sin que nada
haya cambiado. Hagamos la cuenta. Si cada prueba falla sola con probabilidad
p, y las fallas son independientes, la probabilidad de que un build con n
pruebas salga en rojo sin que nadie haya roto nada es:
P = 1 - (1 - p)^nCon las 40 pruebas de Kallpa y un 1 % de falla en cada una, P da 33.1 %: uno
de cada tres builds saldría en rojo sin razón (flaky.ts). Una sola prueba
con 5 % de falla, a lo largo de 20 builds, da un 64.2 % de ver al menos un rojo
falso. La independencia es una simplificación, porque en la práctica las fallas
suelen venir juntas (cuando se cae un servicio, caen todas), pero el orden de
magnitud alcanza para ver el problema.
La consecuencia no es técnica: es de conducta. Después de varios rojos falsos, el equipo aprende que el rojo no significa nada, vuelve a correr el job hasta que pase, y el día que el rojo sea real, también lo volverá a correr. Por eso una prueba flaky en presubmit puede ser peor que no tenerla: no solo no informa, sino que enseña a ignorar a las demás. SWEG dice que erosionan la confianza igual que una prueba rota, con una dificultad extra: como no fallan siempre, cuesta encontrar qué cambio revertir.
¿Qué se hace? En orden:
- Sacarla del presubmit mientras se investiga, con una tarea asignada. SWEG cuenta que algunos equipos tienen herramientas que lo hacen solas.
- Encontrar la causa. Casi siempre es una entrada no declarada: la hora, la red, el orden de las pruebas, datos que deja otra prueba.
- Volver a correr varias veces es una táctica real, y SWEG la menciona. Pero úsenla sabiendo lo que compra: esconde el síntoma, hace más lento el build y puede esconder un error de verdad en el código, que también puede ser intermitente.
Error común. Agregar reintentos automáticos “para que el pipeline deje de molestar” sin abrir un issue. La inestabilidad sigue ahí, ahora invisible, y un error de concurrencia real en su aplicación se verá igual que una prueba mala.
Con IA. Un agente al que se le pide “haz que el pipeline pase” encuentra rápido el camino corto: subir un timeout, agregar un reintento, marcar la prueba con
skipo cambiar lo que comprueba. Son cambios como los que suele proponer un agente, y en el diff parecen inofensivos. Cuando un pull request toca una prueba que estaba fallando, la pregunta de la revisión no es si ahora pasa. Es por qué fallaba, y dónde está la explicación.
CI es una forma de alerta
SWEG incluye un recuadro de Titus Winters con una comparación que ayuda: CI y las alertas de producción sirven para lo mismo, que es identificar problemas de forma automática y lo antes posible. CI lo hace en el extremo temprano, con pruebas que fallan. Las alertas, al final, con métricas. Y las dos comparten las mismas buenas prácticas: una prueba, como una alerta, debe fallar solo cuando se viola algo que importa. La veremos de nuevo en la semana 13, con SLO y on-call.
GitHub Actions
Las piezas
GitHub Actions es el servicio de CI que viene con GitHub. Sus conceptos:
| Concepto | Qué es | En un archivo |
|---|---|---|
| Workflow | Un proceso automático: un archivo YAML en .github/workflows/ |
El archivo completo |
| Evento | Lo que lo dispara: abrir un pull request, un push, una hora | on: |
| Job | Un conjunto de pasos que corren en una misma máquina | jobs: |
| Runner | La máquina: una máquina virtual nueva cada vez, que se borra al terminar | runs-on: |
| Step | Un paso, en orden, dentro de un job | steps: |
| Comando | Un step que corre en la shell | run: |
| Action | Un step reutilizable que otra persona ya escribió | uses: |
Los jobs corren en paralelo, cada uno en su propio runner, salvo que uno
declare needs: con el otro. Los steps de un job corren en secuencia, y si
uno falla, los siguientes no corren. Un step falla si su comando sale con un
código distinto de cero. Toda la lógica de un pipeline descansa en esa
convención del sistema operativo.
Un primer intento
Este workflow está en code/week-12/ejemplos/workflow-incompleto.yml:
# Primer intento: la forma está bien, pero en un runner no llega a correr nada.
name: CI

on:
  pull_request:
  push:
    branches: [main]

permissions:
  contents: read

jobs:
  check:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v7
      - uses: actions/setup-node@v7
        with:
          node-version: 26
      - run: make check
Línea por línea:
on:tiene dos eventos: cada pull request (por omisión, cuando se abre, se sincroniza o se reabre) y cada push amain.permissions:limita elGITHUB_TOKEN, la credencial temporal que recibe el workflow. Volveremos a esto en la sección de seguridad.checkes un id que eligen ustedes. Es también el nombre con el que aparecerá el check si no le ponenname:, y es lo que elegirán en la protección de rama.actions/checkoutdescarga el código. Un runner nuevo está vacío: sin este step no hay nada que revisar. Un detalle importante: en unpull_request, la documentación de GitHub dice que lo que se prueba es el commit de merge del pull request (refs/pull/N/merge), no la punta de su rama. O sea que el check ya prueba “la rama junto conmain”, tal como estabamaincuando corrió.actions/setup-nodeinstala la versión de Node que se le pide.make checkes el build. El mismo comando de siempre.
¿Por qué no llega a correr nada? Porque el runner no tiene el contenedor del
curso. Según la lista de lo que trae la
imagen,
tiene muchas herramientas generales, entre ellas Git y make, pero no tiene
tsc ni ESLint.
No podemos correr un runner de GitHub desde el apunte, pero sí su ambiente, con
el PATH que tendría:
$ env PATH=/usr/local/bin:/usr/bin:/bin make check
tsc -p .
make: tsc: No such file or directory
make: *** [Makefile:28: typecheck] Error 127
[código de salida: 2]
Faltan dos cosas, y el laboratorio les pide agregarlas:
- Instalar las herramientas. El repositorio tiene que declararlas en
package.json, y el job tiene que instalarlas connpm ci. Por eso es la única semana del curso en la que se instala algo con npm. - Que
makelas encuentre.npm cideja los ejecutables ennode_modules/.bin, que no está en elPATH.makellama atscpor su nombre. GitHub tiene un archivo especial,$GITHUB_PATH: lo que se escribe ahí se agrega alPATHde los siguientes steps del job.
Con las dos cosas, el mismo ambiente sí pasa:
$ env PATH="$PWD/node_modules/.bin:/usr/local/bin:/usr/bin:/bin" make check | tail -9
✔ una barra al final no cambia la ruta (0.079958ms)
ℹ tests 40
ℹ suites 6
ℹ pass 40
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 169.690666
setup-node tiene además la opción cache: npm. Su documentación aclara que
no guarda node_modules, sino la caché global de paquetes de npm, y usa el
hash del lockfile como llave. npm ci igual borra y reconstruye
node_modules, pero no vuelve a bajar lo que ya tiene.
Un job colgado no falla
Un step falla cuando su comando sale con un código distinto de cero. Un proceso colgado no sale con ningún código: no falla, solo sigue esperando. Y la documentación de GitHub dice que un job se cancela por omisión a los 360 minutos: seis horas con el pull request detenido y la máquina ocupada, sin un mensaje de error que leer.
Por eso el job del laboratorio declara su propio límite, bastante mayor que lo que tarda normalmente:
jobs:
  check:
    runs-on: ubuntu-latest
    timeout-minutes: 10
No es un caso teórico. tsc termina llamando a process.exit(), y Node tiene un
bug abierto: si en ese momento un
hilo de V8 espera una recolección de basura que el hilo principal ya no va a
hacer, cada uno se queda esperando al otro. El proceso queda vivo, sin usar CPU.
Al preparar este curso, tsc sobre Kallpa se colgó 2 veces en 1200 corridas, con
20 contenedores compitiendo por la máquina. Ese número mide esa carga, no lo que
pasará en un runner: lo que importa es que el problema es raro y, sin un límite,
caro. El contenedor del curso lo evita (env/Dockerfile), pero en el runner se
usa el tsc de node_modules.
Error común. Subir el límite porque el job “a veces no alcanza”. Si un job que dura dos minutos llega a los diez, algo está mal: es mejor que la falla se vea y se investigue.
Lo que el contenedor esconde
La simulación de arriba tiene un agujero, y conviene conocerlo porque les puede
hacer perder una tarde. En el contenedor del curso, tsc deja de estar si le
cambiamos el PATH, pero los import siguen encontrando los paquetes de la
imagen en /node_modules, porque Node busca subiendo de carpeta en carpeta
hasta la raíz.
Probémoslo. Quitamos @eslint/js de package.json, aunque eslint.config.js
lo importa, y corremos make check en el contenedor (make falta):
$ npm uninstall --no-audit --no-fund @eslint/js

removed 1 package in 162ms
[código de salida: 0]

$ make check | tail -8
ℹ tests 40
ℹ suites 6
ℹ pass 40
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 177.576542
Todo verde, con un paquete sin declarar. Lo mismo en la imagen oficial de Node,
sin las herramientas del curso. Eso se corre en la terminal de la computadora,
donde está Docker, con sh runner-limpio.sh @eslint/js. En esa copia todavía no
hay node_modules, y por eso npm uninstall dice que agregó los otros 99 paquetes:
$ npm uninstall --no-audit --no-fund @eslint/js | grep -E "^(added|removed)"
added 99 packages in 2s
$ node --version; which tsc
v26.13.0
/tmp/kallpa/node_modules/.bin/tsc
$ make check | grep -v -E "^ *(✔|▶)" | cut -c1-110
tsc -p .
eslint .

Oops! Something went wrong! :(

ESLint: 10.14.0

Error [ERR_MODULE_NOT_FOUND]: Cannot find package '@eslint/js' imported from /tmp/kallpa/eslint.config.js
...
make: *** [Makefile:31: lint] Error 2
[código de salida: 2]
Este es el “en mi computadora pasa” en estado puro, y aquí la computadora es la imagen del curso. Por eso el pipeline da información que el contenedor no puede dar: es la primera vez que el proyecto se construye solo con lo que declaró.
Con todas las herramientas declaradas, en esa misma imagen limpia, sh runner-limpio.sh termina bien: npm ci instala 100 paquetes y make check
pasa las 40 pruebas, con código de salida 0. Es lo más cerca que se puede
llegar de un runner sin GitHub. Esa corrida tardó 2 segundos en npm ci, en
esta máquina y con una buena conexión: no es lo que tardará en un runner. En el
laboratorio medirán el suyo, y es la única cifra que les importa.
El código de salida manda
Como un step falla solo si su comando sale con un código distinto de cero, hay varias formas de escribir un pipeline que no impide nada, sin darse cuenta.
Una tubería puede esconder la falla. La documentación de GitHub dice que un
run: sin shell: corre con bash -e {0}, mientras que con shell: bash
explícito corre con bash --noprofile --norc -eo pipefail {0}. Sin pipefail,
el código de salida de una tubería es el de su último comando. Comprobemos
la diferencia:
$ bash -e -c 'false | tee /tmp/log; echo sigue'
sigue
[exit 0]

$ bash -eo pipefail -c 'false | tee /tmp/log; echo sigue'
[exit 1]
Entonces, run: make check | tee check.log, sin más, siempre pasa: tee
termina bien aunque make check haya fallado. Se ve rojo en el log y verde en
el check, y es el tipo de pipeline que tarda meses en descubrirse.
continue-on-error: true. Un step o un job con esa opción no hace fallar
el workflow. Tiene usos legítimos, como probar una versión nueva de Node sin
bloquear a nadie, pero en el job principal convierte al pipeline en decoración.
Un comando que nunca devuelve error. npm test || true, por ejemplo. Lo
verán más seguido de lo que creen, normalmente con un comentario que dice “por
ahora”.
Error común. Probar un pipeline solo cuando pasa. El laboratorio les pide romperlo a propósito (paso 5) porque un check que nunca vieron en rojo es un check que no saben si funciona. Es la misma idea de la semana 10: una prueba que no puede fallar no prueba nada.
Un revisor de workflows
revisar-workflow.ts lee un workflow y lo compara con las reglas de esta
semana, sin correrlo. Pueden pasárselo al suyo. Con el primer intento de
arriba:
$ node revisar-workflow.ts ejemplos/workflow-incompleto.yml
error  npm-ci: Falta npm ci: en el runner no están las herramientas.
error  path: Falta agregar node_modules/.bin al PATH: make no encontraría tsc.
aviso  fijar: actions/checkout@v7 usa una etiqueta, que se puede mover; lo más seguro es el SHA del commit.
aviso  fijar: actions/setup-node@v7 usa una etiqueta, que se puede mover; lo más seguro es el SHA del commit.
2 errores, 2 avisos
Es análisis estático, con los límites de la semana 11: revisa la forma del archivo y no dice si el workflow funciona. Eso solo lo dice el runner.
Seguridad del pipeline
Un pipeline es un programa que corre automáticamente, con credenciales, sobre código que todavía nadie aprobó, y que además baja y ejecuta código de terceros. Visto así, conviene pensarlo con cuidado. Tres reglas cubren la mayoría de los casos, y las tres están en la referencia de seguridad de GitHub.
Permisos mínimos
Cada job recibe un GITHUB_TOKEN, una credencial temporal para operar sobre el
repositorio. Un job de revisión solo necesita leer el código, y por eso se
declara:
permissions:
  contents: read
Es el principio de mínimo privilegio. Si un paquete malicioso llega a correr
dentro del job, solo puede leer lo que ya era legible. Con permissions: write-all, podría subir commits al repositorio.
Cuando el pull request viene de un fork, GitHub ya protege algo: según la
documentación, los secrets no se pasan al runner (salvo el GITHUB_TOKEN) y el
token es de solo lectura. Por eso existe la tentación de usar el evento
pull_request_target, que corre con los permisos de la rama base. Es peligroso
justamente por eso: si ese workflow hace checkout del código del fork y lo
ejecuta, un desconocido corre su código con sus credenciales.
Los secrets
Los secrets (tokens, contraseñas) van en la configuración de GitHub y nunca en el código ni en el workflow. GitHub los tapa en los logs, pero la documentación aclara que la redacción automática no está garantizada, porque busca coincidencias exactas: un secret transformado (en base64, dentro de un JSON) puede pasar sin taparse. Si uno llega a un log, se borra el log y se cambia el secret. En este laboratorio no usan ninguno; en P4, el token de despliegue será el primero.
Fijar las actions
uses: actions/checkout@v7 parece una versión fija, pero v7 es una
etiqueta de Git, y quien controla el repositorio puede moverla a otro
commit. No es hipotético.
En la industria. El 14 y 15 de marzo de 2025, alguien modificó las etiquetas de la action
tj-actions/changed-files, de lav1a lav45.0.7, para que apuntaran a un commit con código malicioso. Quienes tenían@v45en su workflow corrieron ese código sin haber cambiado nada. El efecto, según el registro CVE-2025-30066, fue que los atacantes podían descubrir secrets leyendo los logs de actions. En un repositorio público, esos logs los puede leer cualquiera.
Lo que no se mueve es el SHA completo del commit. La documentación de GitHub recomienda fijar ahí: para meter una puerta trasera sin cambiar el SHA, un atacante tendría que generar una colisión de SHA-1. Para encontrarlo:
$ git ls-remote https://github.com/actions/checkout 'refs/tags/v7*'
3d3c42e5aac5ba805825da76410c181273ba90b1	refs/tags/v7
9c091bb21b7c1c1d1991bb908d89e4e9dddfe3e0	refs/tags/v7.0.0
3d3c42e5aac5ba805825da76410c181273ba90b1	refs/tags/v7.0.1
Y se escribe con la versión en un comentario, para que un humano sepa qué es:
- uses: actions/checkout@3d3c42e5aac5ba805825da76410c181273ba90b1 # v7.0.1¿Se ve la lista? v7 y v7.0.1 apuntan hoy al mismo commit. Mañana v7
apuntará a otro, porque esa etiqueta se mueve a propósito con cada release. Una
etiqueta anotada listaría primero el objeto de la etiqueta; en ese caso, usen
el SHA de la línea que termina en ^{}, que es el del commit.
Fijar al SHA tiene un costo: ya no reciben actualizaciones solas, y hay que actualizar a mano o con una herramienta como Dependabot. Por eso el laboratorio pide como mínimo la versión mayor, con el cómo se fijaría al SHA en un comentario. Es una decisión de riesgo, y una action oficial de GitHub no es lo mismo que una de un desconocido.
Una colección de errores
ejemplos/workflow-peligroso.yml
junta todo lo que no hay que hacer, con un comentario en cada línea: permisos
de más, una action sin fijar, npm install, un secret en un echo, una
tubería que esconde el error. Léanlo entero, porque cada línea parece razonable
por separado. revisar-workflow.ts le encuentra 11 errores.
Un pipeline que no impide nada
Ya tienen un workflow que corre. Falta lo más importante. En un repositorio sin
configurar, el botón de merge funciona igual con el check en rojo. El pull
request se integra “porque era urgente”, y main queda rota. El pipeline es
decorativo hasta que alguien lo convierte en una regla.
En GitHub, esa regla es la protección de rama. En Settings → Branches (o
en Rules) se configura para main:
- Require a pull request before merging, con al menos una aprobación. Nadie
sube directo a
main. - Require status checks to pass before merging, eligiendo el check de su job.
La documentación de GitHub tiene tres detalles que conviene saber:
- Por omisión, las restricciones no se aplican a los administradores. Quien tenga permisos de admin puede pasar por encima, salvo que se active Do not allow bypassing the above settings. En un equipo de estudiantes, todos suelen ser admin, así que la regla sin esta opción protege menos de lo que parece.
- Modo estricto o relajado. Con Require branches to be up to date before
merging activado (estricto), la rama tiene que estar al día con
mainantes del merge. Hace correr más builds. Sin esa opción (relajado), hay menos builds, pero las pruebas pueden pasar en la rama y romperse después del merge. - Disponibilidad. La protección está en repositorios públicos con GitHub Free, y en públicos y privados con GitHub Pro, Team y Enterprise. GitHub Pro es gratis con GitHub Education.
El segundo detalle es la respuesta a make colision. En modo relajado,
nuestras dos ramas se integran en verde, una detrás de otra, y main queda en
rojo. En modo estricto, la segunda rama queda desactualizada cuando entra la
primera: tiene que traer los cambios, su check vuelve a correr, sale en rojo y
el error se descubre antes del merge. El precio es volver a correr el build
de todos los pull requests abiertos cada vez que uno entra. Con pocos pull
requests al día, es barato. Para equipos grandes, GitHub ofrece una cola de
merge (Require merge queue), y SWEG describe la misma idea: los proyectos
chicos pueden evitar los choques en el aire integrando los cambios de a uno.
Es decir, el check del pull request no prueba “lo que va a quedar”: prueba la
combinación con el main que había cuando corrió. Para ramas abiertas varios
días y un main que no se detiene, eso cuenta.
Idea clave. Un pipeline da información. La protección de rama la convierte en una regla. Sin required status checks, un check en rojo es una opinión.
Con IA. El pipeline atrapa lo que un agente rompió sin darse cuenta, y por eso un agente no recibe permiso para saltarse los checks ni para cambiar el workflow sin revisión. Las razones son las de siempre, con más fuerza: un agente con la meta de “que quede en verde” tiene incentivos para desactivar una prueba, y, como vimos en la semana 1, puede seguir instrucciones escondidas en lo que lee. Cualquier cambio en
.github/workflows/se revisa como un cambio de seguridad: en ese archivo está quién puede correr qué, con qué credenciales. Un CODEOWNERS sobre esa carpeta lo hace obligatorio.
Una dependencia es código del que responden
Qué se está aceptando
Empezamos la segunda parte. Russ Cox define el problema con una frase incómoda:
A package, for this discussion, is code you download from the internet. Adding a package as a dependency outsources the work of developing that code—designing, writing, testing, debugging, and maintaining—to someone else on the internet, someone you often don’t know.
Cuando agregan una dependencia, sus errores, sus vulnerabilidades y sus cambios son ahora de ustedes. Si se cae producción a las tres de la mañana por una biblioteca, el usuario no va a leer la licencia, que dice que el autor no da ninguna garantía. Agregar una dependencia toma una línea y unos segundos. Mantenerla, años.
¿Por qué lo hacemos, entonces? Porque suele valer la pena. Nadie debería escribir su propio analizador de TypeScript. La pregunta correcta es qué paquete vale su costo. Cox lo plantea como un cálculo de riesgo: el costo esperado de una dependencia es la suma, sobre todo lo que puede salir mal, de cuánto cuesta multiplicado por su probabilidad. En un proyecto de fin de semana, el costo de casi todo es cero. En un sistema que cobra dinero y debe durar años, no.
Por qué es difícil
SWEG dedica el capítulo 21 a esto, y Titus Winters lo llama uno de los problemas menos entendidos de la ingeniería de software. Lo compara con el control de versiones. Los dos tratan de cómo se trabaja con código, pero la gestión de dependencias agrega complejidad en tiempo y en escala:
- Tiempo. El cambio ocurre fuera de su organización, sin aviso y sin que ustedes puedan correr las pruebas de quien lo hace. Quien publica no sabe que ustedes existen.
- Escala. No se trata de un paquete, sino de una red. Con el tiempo, todos los nodos tendrán versiones nuevas, algunas importantes, y hay que encontrar una combinación en la que todas funcionen juntas.
Su mejor consejo es casi una broma, pero no lo es: “prefer source control problems to dependency management problems”. Lo que controlan ustedes se arregla con un commit. Lo que no, se negocia.
SWEG cuenta también cómo sale mal en Google. Alice necesita un paquete de
código abierto para una demo y lo importa a la carpeta third_party, con Bob
como segundo responsable. Otros equipos empiezan a usarlo sin que ellos se
enteren. Pasan los años, Bob cambia de puesto y Alice de equipo. Un día hay una
vulnerabilidad y hay que actualizar, miles de proyectos dependen de él, y nadie
lo conoce ni practicó esa actualización. Google no se pone de ejemplo: el
capítulo resume cómo importa dependencias con un “in short: we could do
better”. Una dependencia que entra por una demo y se queda para siempre es el
caso típico, y esa deuda se cobra de golpe.
Kallpa no tiene ninguna, a propósito
Kallpa no tiene ninguna dependencia de producción: node:http,
node:sqlite y node:test alcanzan. No es un capricho ni una regla universal.
Es una decisión sobre una aplicación chica, de vida larga, para fines de
enseñanza. Sus herramientas de desarrollo (TypeScript, ESLint) sí son paquetes,
y hoy los declaramos.
La distinción importa, y volverá varias veces:
dependencies: llegan a producción. Corren con sus datos y sus usuarios.devDependencies: solo existen en desarrollo y en el pipeline. Ojo, que corren en las máquinas del equipo y en el runner, con sus credenciales. Riesgo diferente no significa riesgo cero.
Versionado semántico
La convención
El versionado semántico (semver) dice que una versión tiene tres números,
MAJOR.MINOR.PATCH, con este significado:
| Sube | Cuando | Ejemplo |
|---|---|---|
| MAJOR | Se rompe la compatibilidad | 10.14.0 → 11.0.0 |
| MINOR | Se agrega algo compatible | 10.14.0 → 10.15.0 |
| PATCH | Se corrige algo, de forma compatible | 10.14.0 → 10.14.1 |
La especificación tiene una excepción que importa: mientras MAJOR es 0,
cualquier cosa puede cambiar. La API todavía no se considera estable.
Una promesa, no una garantía
Semver es una promesa de quien publica. Nada la comprueba. SWEG va más lejos y la llama una estimación con pérdida (a lossy estimate): una persona decide cuánto riesgo cree que tiene su cambio y lo comprime en un número. El problema es que después el package manager toma esa estimación como un hecho absoluto.
El capítulo describe dos maneras de fallar:
- Promete de más (overpromise). La ley de Hyrum, que conocen desde la semana 1, dice que con suficientes usuarios, todo comportamiento observable tendrá a alguien que dependa de él. Cambiar el orden de una salida “sin orden” o el formato de un log es un PATCH para quien lo publica y una rotura para quien dependía de eso. Como dice SWEG, un cambio no es “compatible” en abstracto: lo es o no según cómo lo use cada uno.
- Restringe de más (overconstrain). Una biblioteca sube de MAJOR porque rompió una función que ustedes no usan. El package manager igual les dirá que no se puede actualizar, aunque todo funcionaría bien.
Un ejemplo con Kallpa. Supongamos que typescript-eslint publica un PATCH que
arregla un falso negativo: una regla recomendada ahora también detecta un caso
que antes dejaba pasar. Es una corrección, compatible según semver: la API no
cambió. Pero eslint . empieza a dar un error en un archivo que ayer pasaba,
make check sale en rojo y su pull request no había tocado ese archivo. Es
la ley de Hyrum: dependían de que esa regla no viera ese caso, sin haberlo
decidido.
Lo que da evidencia de verdad, concluye SWEG, son las pruebas y CI: “testing and CI provide actual evidence of whether a new set of versions work together”. Semver dice qué espera quien publica. Su pipeline dice qué pasó.
Los rangos
En package.json no se escribe solo una versión, sino un rango de las que
se aceptan. semver-range.ts implementa las tres formas más comunes:
| Rango | Acepta | No acepta |
|---|---|---|
8.72.1 |
Solo 8.72.1 |
8.72.2 |
~8.72.1 |
8.72.1 a 8.72.x |
8.73.0 |
^8.72.1 |
8.72.1 a 8.x.y |
8.72.0, 9.0.0 |
^0.23.5 |
0.23.5 a 0.23.x |
0.24.0 |
^0.0.3 |
Solo 0.0.3 |
0.0.4 |
Las dos últimas filas son las que casi todos se olvidan. El ^ deja fijo el
primer número distinto de cero. Antes de la 1.0, un MINOR puede romper cosas,
así que ^ no cruza al siguiente MINOR. Y no es un caso de libro: npm explain minimatch muestra que eslint pide @eslint/config-array@"^0.23.5".
Las pruebas de semver-range.test.ts comparan esa implementación con el
paquete semver, el que usa npm de verdad, en 5000 casos generados con
fast-check. Es una prueba diferencial, como las de la semana 10.
Si no escriben nada especial, npm install eslint guarda ^10.14.0. Por eso,
el laboratorio usa --save-exact.
El mismo archivo, dos resultados
¿Qué tan grave es un rango? Hagamos el experimento (make rangos). Un
package.json con una sola línea, "eslint": "^10.0.0", sin lockfile. npm install --before instala lo que habría instalado en esa fecha:
$ npm install --no-audit --no-fund --before=2026-03-01

added 68 packages in 1s
[código de salida: 0]

$ npm ls eslint --depth=0
rangos@ /work/code/week-12/build/rangos/antes
`-- eslint@10.0.2

[código de salida: 0]

$ npm install --no-audit --no-fund

added 77 packages in 1s
[código de salida: 0]

$ npm ls eslint --depth=0
rangos@ /work/code/week-12/build/rangos/hoy
`-- eslint@10.14.0

[código de salida: 0]
El mismo archivo, sin que nadie lo haya tocado, da 68 paquetes en marzo y 77 en
noviembre, con otra versión de ESLint. Si una persona del equipo instaló en
marzo y otra hoy, no están corriendo lo mismo. Con rangos, package.json
describe un conjunto de instalaciones posibles, no una.
El lockfile
Qué guarda
La solución es el lockfile. package-lock.json registra lo que resultó de
resolver los rangos: la versión exacta y el hash de cada paquete instalado,
también los transitivos. Esta es la entrada real de minimatch, que nadie
pidió por su nombre:
"node_modules/minimatch": {
  "version": "10.2.6",
  "resolved": "https://registry.npmjs.org/minimatch/-/minimatch-10.2.6.tgz",
  "integrity": "sha512-vpLQEs+VLCr1nU0BXS07maYoFwlDAH0gngQuuttxIwutDFEMHq2blX+8vpgxDdK3J1PwjCJiep77OitTZ4Ll1A==",
  "dev": true,
  "license": "BlueOak-1.0.0",
  "dependencies": {
    "brace-expansion": "^5.0.8"
  },
  ...
}versiondice qué versión es.resolveddice de dónde se baja.integrityes un hash del archivo que se bajó. Si llega otra cosa, se detiene.
Fíjense en lo que esto implica para el --save-exact del laboratorio. Las seis
directas quedaron exactas en package.json, pero eso no fija las otras 94:
minimatch se pide con ^10.2.4, ^10.2.2 y ^10.2.6. Solo el lockfile fija
todo el árbol. El lockfile entra al repositorio; node_modules/, no.
npm install y npm ci
npm install |
npm ci |
|
|---|---|---|
| Para qué | Agregar o cambiar dependencias | Reproducir lo que dice el lockfile |
¿Modifica package-lock.json? |
Puede | Nunca |
| Si no hay lockfile | Lo crea | Falla |
Si package.json y el lockfile no coinciden |
Resuelve y actualiza el lockfile | Falla |
node_modules existente |
Lo actualiza | Lo borra antes de instalar |
En el pipeline siempre va npm ci. Una precisión, porque se suele contar
mal: npm install no actualiza versiones cada vez que corre. Si hay un
lockfile que satisface package.json, lo respeta. El peligro es que resuelve
el problema en silencio cuando no coinciden. Justo eso se quiere evitar en un
pipeline, donde una diferencia entre los dos archivos debe ser un error y no
una decisión automática.
Ahora veámoslo fallar, que es para lo que está (make lockfile). Alguien edita
package.json y se olvida del lockfile:
$ npm ci
npm error code EUSAGE
npm error
npm error `npm ci` can only install packages when your package.json and package-lock.json or npm-shrinkwrap.json are in sync. Please update your lock file with `npm install` before continuing.
npm error
npm error Invalid: lock file's fast-check@4.10.2 does not satisfy fast-check@4.10.1
...
[código de salida: 1]
Si no hay lockfile, falla con el mismo código, EUSAGE, y pide generarlo.
Y si el hash del lockfile no coincide con lo que llega del registro (cambiamos
a mano el hash de ms y borramos la caché, para simular un archivo que
cambió):
$ npm ci 2>&1 | grep -E 'code EINTEGRITY|integrity checksum' | cut -c1-110
npm error code EINTEGRITY
npm error sha512-iK2f+YrcmoeGqk6fA0ea2bptcu/itMIm4NfEozq6N25+aG6h7s5HZbB/k1aV7b5w5sFLMCbbtRUsTVR+BgC3xw== inte
Los tres son buenos resultados. El pipeline se detuvo en vez de construir otra cosa.
En la industria. Cox cuenta que en 2018, la última versión del paquete
event-streamresultó traer código malicioso, ofuscado, que llevaba dos meses y medio publicado. Quien lo metió no pudo cambiar en silencio la versión 3.3.5, que ya existía: los hashes lo habrían detectado. Tuvo que publicar una versión nueva y esperar a que la gente actualizara sin mirar los cambios, y escondió el código en otro paquete,flatmap-stream, agregado como dependencia nueva. Los hashes cumplieron y el ataque igual funcionó. (Our Software Dependency Problem.)
Lo que el lockfile no hace
Ese recuadro deja ver el límite. Un hash garantiza que lo que instalan hoy es lo mismo que instalaron la primera vez. No dice nada sobre si lo de la primera vez era bueno. El lockfile protege contra cambios, no contra malas decisiones, y cada vez que alguien lo actualiza, vuelve a confiar en lo que llegue.
Error común. Borrar
package-lock.jsony corrernpm installpara “arreglar” un conflicto de merge en ese archivo. Eso actualiza todo el árbol a lo último que acepten los rangos, en un commit que nadie va a revisar. En un conflicto de lockfile, resuelvanpackage.jsony dejen quenpm installreconstruya solo lo que hace falta, sobre el lockfile demain. Revisen el diff.
Dependencias transitivas
Seis se vuelven cien
Las versiones directas del laboratorio son seis, las mismas que trae la imagen
(ver env/Dockerfile). Al instalarlas:
$ npm install --save-dev --save-exact typescript@6.0.3 @types/node@26.6.6 eslint@10.14.0 @eslint/js@10.0.1 typescript-eslint@8.72.1 fast-check@4.10.2

added 100 packages, and audited 101 packages in 37s
...
$ npm ls
kallpa@1.0.0 /work/code/week-12/build/arbol
+-- @eslint/js@10.0.1
+-- @types/node@26.6.6
+-- eslint@10.14.0
+-- fast-check@4.10.2
+-- typescript-eslint@8.72.1
`-- typescript@6.0.3
Cien paquetes. Las dependencias de las dependencias se llaman transitivas.
Pidieron seis, y en su repositorio hay ahora 1399 líneas de lockfile y unos 50
MB en node_modules. El reporte de lockfile-report.ts, que lee solo el
lockfile, dice de dónde salieron:
$ make reporte
Paquetes instalados: 100
Directos y lo que traen por sus dependencies:
  @eslint/js@10.0.1: 0
  @types/node@26.6.6: 1
  eslint@10.14.0: 76
  fast-check@4.10.2: 1
  typescript@6.0.3: 0
  typescript-eslint@8.72.1: 26
Con más de una versión en el árbol:
  eslint-visitor-keys: 3.4.3, 5.0.1
  hookified: 1.15.1, 2.2.0
  ignore: 5.3.2, 7.0.14
Licencias:
   74 MIT
   13 Apache-2.0
    6 BSD-2-Clause
    5 ISC
    1 BlueOak-1.0.0
    1 BSD-3-Clause
Con script de instalación: 0
Sin hash: 0
Descargados de: registry.npmjs.org
Casi todo viene con ESLint. TypeScript, en cambio, trae cero. Los números de la columna no suman 100 porque se repiten: un paquete puede venir por varios caminos. Y ese número puede no ser el que vean ustedes en el laboratorio: las directas están fijas, pero las transitivas se resuelven el día que se instala.
Para saber por qué está un paquete que no pidieron, existe npm explain:
$ npm explain minimatch | head -5
minimatch@10.2.6 dev
node_modules/minimatch
  minimatch@"^10.2.4" from @eslint/config-array@0.23.5
  node_modules/@eslint/config-array
    @eslint/config-array@"^0.23.5" from eslint@10.14.0
Cox recuerda por qué conviene mirar: en marzo de 2016, cuando el autor de un
paquete de ocho líneas, left-pad, lo borró de npm, se rompieron los builds de
la mayoría de los usuarios de Node. Proyectos como Babel, Ember y React
dependían de él de forma indirecta, y muchos no lo sabían.
El problema del diamante
¿Qué pasa cuando dos paquetes piden versiones distintas de un tercero? SWEG lo
llama el problema del diamante: su proyecto usa liba y libb, y las dos
usan libbase. Si liba necesita la versión nueva de libbase y libb, la
vieja, hay un problema: para SWEG, es el problema central de la gestión de
dependencias.
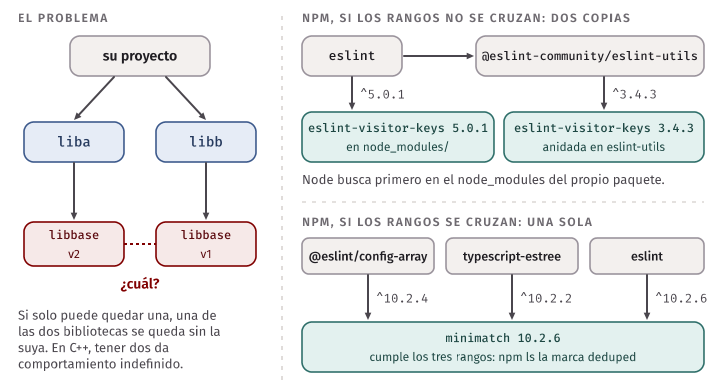
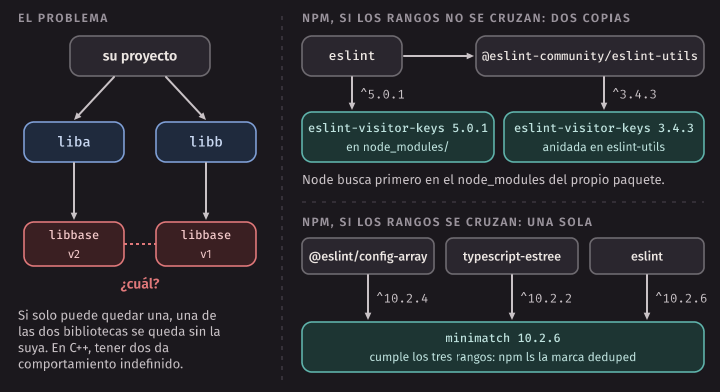
Pero SWEG aclara que cada lenguaje lo tolera en distinto grado. C++ casi no lo
tolera: tener dos versiones da comportamiento indefinido. Node sí, y mucho, por
cómo busca los módulos: cada paquete mira primero en su propia carpeta
node_modules. Así que npm tiene una salida que no todos tienen: instala las
dos.
En nuestro árbol pasa con tres paquetes. eslint usa eslint-visitor-keys
5.0.1, pero @eslint-community/eslint-utils necesita la 3.4.3, y npm se la
deja anidada:
node_modules/eslint-visitor-keys                                               5.0.1
node_modules/@eslint-community/eslint-utils/node_modules/eslint-visitor-keys   3.4.3
Cuando los rangos sí se cruzan, deja una sola copia. minimatch se pide con
tres rangos y hay una sola, la 10.2.6, que los cumple todos (npm ls la marca
deduped).
Tener dos copias no siempre es inofensivo: son dos estados separados y dos versiones de los tipos, y hay que parchar las dos. Pero funciona. Entonces, ¿cuándo aparece el diamante de verdad en npm? Cuando dos copias no sirven, porque los paquetes tienen que compartir una sola.
peerDependencies
Un plugin de ESLint no puede traer su propio ESLint: tiene que enchufarse en el
que está corriendo. Para eso están las peerDependencies: un paquete no
trae esa dependencia, sino que declara con qué versión espera convivir. Y aquí
sí vuelve la restricción de una sola versión:
$ npm view typescript-eslint@8.72.1 peerDependencies
{
  eslint: '^8.57.0 || ^9.0.0 || ^10.0.0',
  typescript: '>=4.8.4 <6.1.0'
}
Esta es la razón por la que el curso sigue en TypeScript 6, aunque ya exista la
7. npm outdated lo muestra:
$ npm outdated
Package     Current  Wanted  Latest  Location                 Depended by
typescript    6.0.3   6.0.3   7.0.2  node_modules/typescript  auditar
[código de salida: 1]
Wanted es lo máximo que acepta el rango de package.json, que es exacto.
Latest es lo último publicado. Fíjense en que npm outdated sale con código
1 cuando encuentra algo, así que tampoco va así en un pipeline.
¿Qué pasa si igual actualizamos? Vale la pena verlo, porque el resultado no es
el que se espera (make peer). Con el pedido explícito de la versión, npm
solo avisa:
$ npm install --no-audit --no-fund --save-dev --save-exact typescript@7.0.2 2>&1 | cut -c1-90 | grep -v 'overriding peer' | sed -n 1,12p
npm warn While resolving: kallpa@1.0.0
npm warn Found: typescript@6.0.3
npm warn node_modules/typescript
npm warn   peer typescript@">=4.8.4 <6.1.0" from @typescript-eslint/eslint-plugin@8.72.1
...
npm warn Could not resolve dependency:
npm warn peer typescript@">=4.8.4 <6.1.0" from typescript-eslint@8.72.1
...
La instalación termina con código 0. tsc pasa. Parecería que salió bien. Pero
el siguiente paso de make check no:
$ env PATH="$PWD/node_modules/.bin:/usr/local/bin:/usr/bin:/bin" make typecheck
tsc -p .
[código de salida: 0]

$ env PATH="$PWD/node_modules/.bin:/usr/local/bin:/usr/bin:/bin" make lint 2>&1 | head -3 | cut -c1-90
eslint .
typescript-eslint does not support TS 7.0.
Please see https://devblogs.microsoft.com/typescript/announcing-typescript-7-0/#running-si
Y en el pipeline ni siquiera llegaría ahí, porque npm ci es más estricto que
npm install:
$ rm -rf node_modules && npm ci 2>&1 | cut -c1-90 | sed -n 1,5p
npm error code ERESOLVE
npm error ERESOLVE could not resolve
npm error
npm error While resolving: typescript-eslint@8.72.1
npm error Found: typescript@7.0.2
Esta es una buena ilustración del camino completo: la declaración de
typescript-eslint decía la verdad, npm install permitió pasarla por alto
con una advertencia que es fácil no leer, y npm ci y make check la hicieron
cumplir. Sin el pipeline, alguien habría subido eso.
Con IA. “Sube TypeScript a la última versión” parece una tarea ideal para un agente, y un agente puede resolver el error de arriba con
--legacy-peer-depso--force, que apagan el reclamo sin arreglar nada. Son el equivalente alas anyde la semana 11. Cuando vean una de esas opciones en un pull request o en un workflow, la pregunta es qué compatibilidad se declaró rota, y quién comprobó que no importa.
Antes de agregar una dependencia
Inspeccionar
Cox hace una comparación que ayuda: no contratarían a un desarrollador del que nunca oyeron hablar sin pedir referencias. Un paquete es lo mismo. Su artículo propone revisar nueve cosas, y aquí están con la manera de hacerlo en npm:
| Pregunta | Qué mirar | Cómo |
|---|---|---|
| ¿Existe y es el que creo? | El nombre exacto y su repositorio | npm view <p> name repository.url |
| Diseño | ¿La documentación es clara? ¿Promete algo sobre la compatibilidad? | El README |
| Calidad del código | ¿Querrían depurar esto? Lean un poco | El repositorio |
| Pruebas | ¿Tiene? ¿Pasan? | El repositorio y su CI |
| Errores | ¿Hay reportes viejos sin respuesta? ¿Se arreglan? | Sus issues |
| Mantenimiento | ¿Quién? ¿Cuántas personas? ¿Último release? | npm view <p> maintainers time |
| Uso | ¿Lo usa más gente? Eso ayuda, pero no garantiza | Las descargas en npmjs.com |
| Seguridad | ¿Procesará entradas no confiables? ¿Tiene historial? | La NVD y npm audit |
| Licencia | ¿Tiene una? ¿Es aceptable? | npm view <p> license |
| Dependencias | ¿Cuántas trae? Cada una es otra inspección | npm view <p> dependencies |
La primera fila no es de Cox: la agregamos por lo que verán en la sección de paquetes inventados. El resto son sus categorías. Y Cox admite algo que hay que decir en voz alta: él mismo solo hace parte de esto, y para parte de sus dependencias. Nadie revisa a fondo cien paquetes. Lo razonable es ajustar el esfuerzo al riesgo: mucho para lo que llega a producción y procesa datos de terceros; poco para una herramienta de desarrollo muy conocida.
Dos ejemplos reales, con el comando del laboratorio (make paquetes):
$ npm view fast-check name version license repository.url time.modified dependencies
name = 'fast-check'
version = '4.10.2'
license = 'MIT'
repository.url = 'git+https://github.com/dubzzz/fast-check.git'
time.modified = '2026-09-19T19:34:55.280Z'
dependencies = { 'pure-rand': '^8.0.0' }
[código de salida: 0]

$ npm view request name version license repository.url time.modified deprecated
name = 'request'
version = '2.88.2'
license = 'Apache-2.0'
repository.url = 'git+https://github.com/request/request.git'
time.modified = '2026-07-17T17:10:13.431Z'
deprecated = 'request has been deprecated, see https://github.com/request/request/issues/3142'
[código de salida: 0]
fast-check tiene licencia conocida, repositorio, actividad reciente y una
sola dependencia. request fue durante años uno de los clientes HTTP más
usados de Node: existe y se puede instalar, pero el propio registro avisa que
está deprecado. Además, hoy Node trae fetch. Un detalle del comando:
time.modified dice cuándo cambiaron los datos del paquete en el registro, no
cuándo salió el último release. La fecha de request es de 2026, y su versión
2.88.2 es de febrero de 2020. Para las fechas de cada versión, usen `npm view
time`. "Existe" y "es popular" son el primer paso de la revisión, no el último. Y la licencia también cuenta: Cox menciona que Google no permite código con licencias como la AGPL (demasiado exigente) o la WTFPL (demasiado vaga).
Una pregunta va antes que todas: ¿la puedo reemplazar con unas pocas líneas
propias o con la biblioteca estándar? La comunidad de Go tiene un proverbio
que Cox cita: a little copying is better than a little dependency. Node hoy
trae HTTP, SQLite, un runner de pruebas, fetch, crypto.randomUUID, Intl y
util.parseArgs. Muchas dependencias de hace cinco años ya no hacen falta.
Si la aceptan
Cox sigue más allá de la inspección, porque una dependencia no termina cuando se instala:
- Pruébenla. Escriban pruebas de lo que necesitan de ella, y úsenlas para cada actualización. Su equipo descubrió así que una biblioteca de expresiones regulares era 70 veces más lenta que la más rápida en un caso básico, y empezó a replantear su uso.
- Abstráiganla. Una interfaz propia y un wrapper delgado, con solo lo que usan. Si mañana hay que cambiarla, se cambia en un lugar. Es el ocultamiento de información de la semana 5.
- Aíslenla, si procesa algo peligroso, en un proceso o un sandbox aparte.
- Evítenla, si ninguna de las anteriores alcanza.
- Actualícenla. Hacer diez actualizaciones chicas es menos trabajo que una grande. Cox cuenta el caso de Equifax en 2017: la vulnerabilidad de Apache Struts se publicó el 7 de marzo con su corrección, y los atacantes entraron el 13 de mayo y se llevaron datos de 148 millones de personas. Sus revisiones no encontraron esos servidores. Si tienen pruebas propias de la dependencia, dice Cox, en la mayoría de los casos esperar para actualizar es más riesgoso que actualizar rápido.
- Vigílenla. Que siga siendo la misma versión; que no entren dependencias nuevas sin que se note; que siga con mantenimiento.
Dejarlo escrito
Agregar una dependencia es una decisión con consecuencias largas, justo lo que
vieron en la semana 7 como una decisión de arquitectura. En el proyecto, cada
dependencia nueva de producción se justifica en un ADR, y P4 pide además
docs/dependencias.md con sus
criterios, cómo fijan las versiones y qué hacen con las auditorías.
Un ADR de este tipo no necesita más que esto:
# ADR 7: usar la biblioteca X para generar PDF

**Contexto.** El cliente necesita recibos en PDF. Node no lo trae, y escribirlo nos tomaría semanas.
**Decisión.** Usar X 3.2.1, exacta.
**Revisado.** Licencia MIT. 2 mantenedores, último release hace un mes. Trae 4 paquetes.
Corre solo en el servidor y recibe solo datos nuestros, sin entrada del usuario.
**Cómo salir.** Se usa solo detrás de `ReceiptRenderer`.
**Consecuencias.** Revisar sus releases una vez por sprint.
La cadena de suministro
Su cadena de suministro es todo lo que interviene para que su software llegue a producción: paquetes, herramientas, actions, imágenes base, el registro, las cuentas de quienes publican. Un ataque a la cadena de suministro no busca un error en su código: busca meterse en algo en lo que ustedes ya confían. Estas son las formas más conocidas.
Typosquatting. Un paquete con un nombre casi igual a uno popular, publicado a la espera de que alguien se equivoque al escribir.
Dependency confusion. Una empresa usa un paquete interno, acme-utils, de
su registro privado. Alguien publica en el registro público un paquete con ese
mismo nombre y una versión más alta. Si la configuración busca en los dos,
puede bajar el público. Es lo que mostró Alex Birsan en 2021, con paquetes de
prueba. Los scopes de npm (@acme/utils) y una configuración que ligue cada
scope a su registro son la defensa.
Un mantenedor comprometido o malicioso. Es el más difícil, porque el paquete es el correcto. El caso de referencia es xz utils.
En la industria. xz es una biblioteca de compresión presente en casi cualquier Linux. Según la cronología de Russ Cox, una persona que se presentaba como Jia Tan mandó su primer parche, inofensivo, el 29 de octubre de 2021. Durante más de dos años aportó parches, mientras otras cuentas presionaban al mantenedor principal para que sumara ayuda, y llegó a ser comantenedor. El 24 de febrero de 2024 publicó la versión 5.6.0 con la puerta trasera (CVE-2024-3094). Un detalle técnico clave: el archivo que la activaba estaba en el tarball publicado, no en el repositorio de código. Quien leyera Git no lo veía. La descubrió Andres Freund, en marzo de 2024, cuando ya estaba en Fedora Rawhide y en la beta de Fedora 40, y a punto de entrar a más distribuciones.
Fíjense en que ninguna de las defensas de arriba lo habría detenido. Un lockfile habría fijado con exactitud el paquete malicioso.
En la industria. En septiembre de 2025 hubo dos episodios seguidos en npm. GitHub marcó como malware la versión 4.4.2 de
debug, y días después CISA alertó sobre un gusano que comprometió más de 500 paquetes y buscaba credenciales. Hoy,debugestá en el árbol de ESLint que instalarán, en la versión 4.4.3, pedida con^4.3.1. Un rango así acepta justo la 4.4.2 (semver-range.test.tslo comprueba). Por eso, en un proyecto que pedíadebugcon un rango como ese, unnpm installsin lockfile en esos días podía bajarla, y unnpm cicon un lockfile anterior, no. Esa versión ya no se puede descargar:$ npm view debug@4.4.2 version 2>&1 | head -2 npm error code E404 npm error 404 No match found for version 4.4.2
Defensas, y lo que no cubren
Ninguna defensa alcanza por sí sola. Lo útil es saber qué cubre cada una:
| Defensa | Qué garantiza | Qué no garantiza |
|---|---|---|
| Lockfile con hashes | Instalan lo mismo que la primera vez | Que la primera vez fuera bueno |
npm ci |
El pipeline no cambia el árbol por su cuenta | Que lo que dice el lockfile sea bueno |
npm audit |
Reporta vulnerabilidades ya publicadas | Lo que todavía nadie reportó |
npm audit signatures |
Lo que bajó lo firmó el registro; si tiene atestación, de dónde se construyó | Que el código sea bueno |
| Fijar actions al SHA | La action no cambia sin que lo sepan | Que ese commit sea bueno |
| SBOM | Saben qué tienen, para responder “¿nos afecta?” | Nada, por sí solo: es una lista |
| SLSA | Un lenguaje común, con niveles, sobre cómo se construyó algo | Que el código fuente sea bueno |
| OpenSSF Scorecard | Una revisión rápida de las prácticas de un proyecto | Que el paquete sea seguro: mide hábitos |
| Esperar antes de actualizar | Lo recién publicado no entra de inmediato | Protege poco contra ataques largos, como xz |
| No correr scripts de instalación | Instalar no ejecuta código | El código corre igual cuando se usa |
| Revisar cada paquete nuevo | Alguien miró | Lo que no se puede ver leyendo |
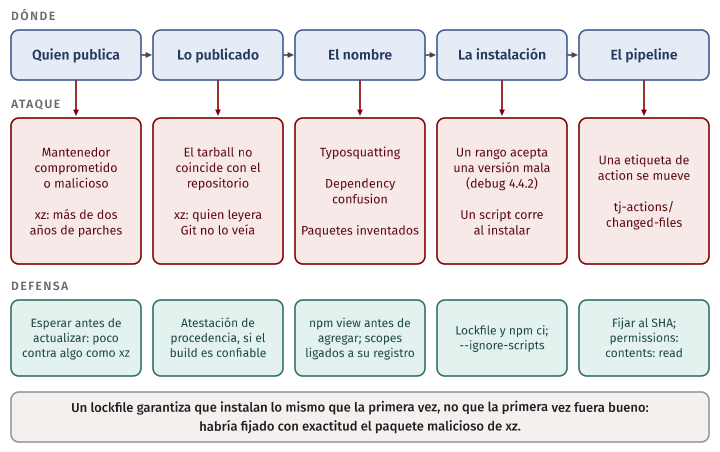
Veamos algunas con Kallpa.
Firmas. npm audit signatures (make auditar):
$ npm audit signatures
audited 100 packages in 2s

100 packages have verified registry signatures

33 packages have verified attestations
(use --json --include-attestations to view attestation details)

[código de salida: 0]
Las firmas del registro dicen que el archivo que bajaron es el que el registro de npm publicó. Las atestaciones de procedencia dicen algo más fuerte: de qué repositorio y qué commit se construyó el paquete, con qué sistema de build. Solo 33 de los 100 las tienen. Eso no significa que los otros 67 estén mal: significa que de esos no sabemos tanto. Observen el caso xz: lo publicado no coincidía con el repositorio. La procedencia ataca justo ese agujero, siempre que el build sea confiable. Ninguna de las dos dice nada sobre si el código hace lo que debe.
SBOM. Un software bill of materials es la lista de todo lo que va en un producto. npm la genera:
$ npm sbom --sbom-format cyclonedx | jq -r '.bomFormat, .specVersion, (.components | length)'
CycloneDX
1.5
100

$ npm sbom --sbom-format cyclonedx --omit=dev | jq '.components | length'
0

$ npm sbom --sbom-format cyclonedx | jq -c '.components[] | select(.name == "minimatch") | {name, version, purl, licenses}'
{"name":"minimatch","version":"10.2.6","purl":"pkg:npm/minimatch@10.2.6","licenses":[{"license":{"id":"BlueOak-1.0.0"}}]}
Lo que llega a producción de Kallpa son cero paquetes. Y si mañana sale una alerta sobre un paquete cualquiera, con la lista se responde en segundos. Cox contaba que los escaneos de Equifax no encontraron unos servidores: se puede arreglar lo que se sabe que se tiene.
Scripts de instalación. Un paquete de npm puede declarar scripts que corren
al instalarlo, con los permisos de quien instala, antes de que nadie use el
código. Es el camino favorito de varios ataques. En nuestro árbol, ninguno los
usa (Con script de instalación: 0, y lo comprueba lockfile-report.test.ts).
La opción --ignore-scripts los apaga, y las versiones recientes de npm tienen
además una política, allowScripts en package.json, para aprobarlos paquete
por paquete.
Esperar. npm tiene una opción min-release-age, en días, para instalar
solo versiones que ya llevan un tiempo publicadas. La lógica: darle tiempo a
alguien para que detecte y retire una versión mala, como pasó con debug. El
costo es que también retrasa las correcciones de seguridad, y no alcanza contra
algo como xz, que estuvo más de un mes publicado sin que nadie lo notara.
SLSA y Scorecard. SLSA (Supply-chain Levels for Software Artifacts) es un marco de requisitos, en niveles de garantía crecientes, para asegurar que un artefacto salió de donde dice que salió y no se alteró en el camino. Sirve más a quien publica software. Scorecard, de OpenSSF, revisa automáticamente las prácticas de riesgo de un proyecto de código abierto: si fija sus dependencias, si protege sus ramas, si tiene revisión de código. Ambas sirven para hacer preguntas. Ninguna dice “es seguro”.
Paquetes que no existen
El ataque
Hay una forma nueva de la misma idea. Un modelo de lenguaje sugiere npm install de un paquete con un nombre razonable, y ese paquete no existe.
Alguien registra ese nombre, con código malicioso, y espera a que otra persona
reciba la misma sugerencia. Se le suele llamar slopsquatting. El término
circula en la industria; no viene del artículo que vamos a leer, que habla de
package hallucinations.
Lo que midió el estudio
Spracklen y otros (USENIX Security 2025) hicieron la medición de referencia. Conviene saber con precisión qué midieron.
- Qué hicieron. Generaron 576 000 muestras de código con 16 modelos, en Python y JavaScript, a partir de dos conjuntos de prompts: preguntas de Stack Overflow y descripciones de paquetes populares. De cada muestra extrajeron los nombres de paquetes y los compararon con las listas de PyPI y npm del 10 de enero de 2024.
- Qué encontraron. De 2.23 millones de nombres generados, 440 445 (19.7 %) no existían, y entre ellos había 205 474 nombres distintos. El promedio fue de al menos 5.2 % en modelos comerciales y 21.7 % en modelos abiertos. En JavaScript hubo más que en Python (21.3 % y 15.8 %).
- ¿Se repiten? Esta es la cifra que hace viable el ataque. Volvieron a correr 500 prompts que habían producido un nombre inventado, 10 veces cada uno: el 43 % de esos nombres salió en las 10 veces, el 39 % no volvió a salir, y el 58 % se repitió más de una vez. La mayoría no son errores al azar. Basta con que un nombre se repita para que valga la pena registrarlo.
Y sus límites, que importan tanto como los números:
- Los porcentajes son de los nombres de paquetes generados, no de los programas ni de las veces que un desarrollador usa la sugerencia.
- Son modelos de 2023–2024, y los comerciales evaluados son tres de la serie GPT. Los modelos cambian rápido: estas cifras no describen lo que hace hoy una herramienta concreta. El propio artículo menciona que un trabajo previo dio tasas 4 a 6 veces más altas para los mismos modelos GPT, así que el número también depende del método.
- Los prompts están pensados para producir código que use paquetes. No miden con qué frecuencia una persona se encuentra con uno de estos nombres mientras trabaja.
- El 81 % de los nombres inventados salió de un solo modelo. Es decir, un atacante tendría que apuntar a un modelo en particular.
- Mide el riesgo, no los ataques. El estudio no muestra cuántas personas fueron afectadas.
Idea clave. Lo sólido del estudio es el mecanismo: los modelos inventan nombres de paquetes, y muchos de esos nombres se repiten. Lo que no se puede sacar de ahí es “la herramienta que uso inventa un 5 %”.
La defensa
La defensa es la de siempre, sin excepciones: no se instala nada que nadie haya verificado. Se empieza por ver si existe:
$ npm view kallpa-slots-helper name version license repository.url time.modified | cut -c1-90
npm error code E404
npm error 404 Not Found - GET https://registry.npmjs.org/kallpa-slots-helper - Not found
npm error 404
npm error 404  The requested resource 'kallpa-slots-helper@*' could not be found or you do not have permission to access it.
npm error 404
npm error 404 Note that you can also install from a
npm error 404 tarball, folder, http url, or git url.
...
Ese nombre lo acabamos de inventar nosotros, para este ejemplo. Y esa es la parte fácil. Un 404 es el mejor resultado posible. El peor es que el comando responda, porque alguien ya registró ese nombre. Como dice el artículo, comparar el nombre con una lista de paquetes conocidos no sirve si el atacante ya publicó el paquete. Existir en el registro no es evidencia de nada. Por eso la revisión sigue:
- ¿Existe?
npm view. - ¿Es el que dice ser? ¿El repositorio existe y coincide? ¿La documentación del proyecto oficial lo nombra? ¿Lo llegaron a buscar ustedes, o solo vino de la sugerencia?
- ¿Cuándo nació? Un paquete creado hace dos semanas y con un solo release
merece desconfianza (
npm view <p> time.created). - ¿Quién lo mantiene? ¿Cuántas personas? ¿Qué más publicaron?
- ¿Qué trae? ¿Tiene scripts de instalación?
npm view <p> scripts dependencies. - ¿Hace falta? La pregunta de la sección anterior. La mayoría de las veces, esta es la que resuelve.
Solo después, y nunca en una máquina con credenciales a la mano si hay dudas. Instalar ya ejecuta código.
Con IA. Cuando trabajen con un agente, tres reglas concretas. Primero, un agente no instala paquetes sin que alguien lo apruebe:
npm installes una acción que corre código de terceros en su máquina. Segundo, cualquier cambio enpackage.jsono enpackage-lock.jsonen un pull request se revisa con el comando de arriba, paquete por paquete. La semana 11 ya lo dejó en la lista de cosas que mirar primero. Tercero, si un paquete no existe, no le pidan al mismo agente “uno parecido” y lo instalen: vuelvan a la pregunta de si hace falta. El registro de uso de IA debe decir qué se sugirió, qué se comprobó y qué se decidió.
Leer npm audit con criterio
Qué dice el reporte
npm audit compara su árbol con una base de vulnerabilidades publicadas. Esta
es la corrida del laboratorio, sin las líneas de rutas (make auditar):
$ npm audit | grep -v -E 'Depends on|node_modules/'
# npm audit report

minimatch  <11.0.1
Severity: moderate
minimatch has potential denial of service via globparts amplification - https://github.com/advisories/GHSA-g3hv-75wg-m249
fix available via `npm audit fix --force`
Will install eslint@4.0.0, which is a breaking change
  @eslint/config-array  *
    eslint  0.7.1 - 2.0.0-rc.1 || >=4.1.0
      @eslint-community/eslint-utils  *
        @typescript-eslint/utils  *
          @typescript-eslint/eslint-plugin  *
            typescript-eslint  *
          @typescript-eslint/type-utils  >=5.9.2-alpha.0
      @eslint/js  >=10.0.1
      @typescript-eslint/parser  *
  @typescript-eslint/typescript-estree  >=6.16.0

11 moderate severity vulnerabilities

To address all issues (including breaking changes), run:
  npm audit fix --force
Primera lectura: “11 vulnerabilidades moderadas”. Lectura correcta: una sola
vulnerabilidad, en minimatch, y 11 paquetes marcados porque están en el
camino hacia ella (minimatch y otros 10 que dependen de él, directa o
indirectamente). npm audit cuenta paquetes afectados, no problemas distintos.
Y --json lo deja claro: 3 de esos 11 son directos, y la causa aparece solo en
uno.
Cinco preguntas
Para decidir qué hacer, se responde en este orden.
1. ¿Llega a producción?
$ npm audit --omit=dev
found 0 vulnerabilities
[código de salida: 0]
No. Son todas dependencias de desarrollo. Kallpa no tiene paquetes en producción, así que un vecino que reserva una cancha nunca ejecuta ese código.
2. ¿Qué tiene que hacer un atacante? Leamos el
aviso. Dice: an attacker
who can supply a glob pattern puede causar un consumo excesivo de CPU y
memoria. Para aprovecharla en este proyecto, alguien tendría que controlar los
patrones de archivos que recibe ESLint, y esos están en su propia
configuración. Quien puede cambiar esa configuración ya puede correr lo que
quiera en el pipeline. El peor resultado sería un eslint . lento.
3. ¿Hay arreglo? La corrección está en minimatch 11.0.1, publicada el 27
de octubre de 2026. Pero ESLint 10.14.0 pide ^10.2.6, y ese rango no acepta
la 11. No podemos arreglarlo nosotros sin forzar la dependencia de otro: hay
que esperar un release de ESLint.
4. ¿Qué propone la herramienta, y qué hace? Propone npm audit fix --force. Veamos qué pasa.
5. ¿Qué decidimos, y dónde queda escrito? Lo vemos después del experimento.
npm audit fix --force
El nombre es tentador: un comando y el reporte queda en cero. Esto es lo que
hace aquí (make fuerza, en una copia):
$ npm audit fix --force --dry-run 2>&1 | grep -E 'Updating'
npm warn audit Updating eslint to 4.0.0, which is a SemVer major change.
npm warn audit Updating @eslint/js to 9.39.5, which is a SemVer major change.
npm warn audit Updating typescript-eslint to 8.14.0, which is a SemVer major change.
ESLint 4.0.0 se publicó en junio de 2017. Para arreglar una vulnerabilidad moderada en una herramienta de desarrollo, propone retroceder seis versiones mayores. Si seguimos adelante:
$ npm audit fix --force --no-fund > /dev/null 2>&1
[código de salida: 1]

$ npm pkg get devDependencies
{
  "@eslint/js": "^9.39.5",
  "@types/node": "26.6.6",
  "eslint": "^4.0.0",
  "fast-check": "4.10.2",
  "typescript": "6.0.3",
  "typescript-eslint": "^8.14.0"
}
[código de salida: 0]

$ npm audit 2>&1 | tail -7 | head -1
17 vulnerabilities (2 low, 14 moderate, 1 high)

$ env PATH="$PWD/node_modules/.bin:/usr/local/bin:/usr/bin:/bin" make check
tsc -p .
eslint .

Oops! Something went wrong! :(

ESLint couldn't find a configuration file. To set up a configuration file for this project, please run:

    eslint --init
...
make: *** [Makefile:31: lint] Error 1
[código de salida: 2]
Fíjense en el resultado. El reporte no quedó en cero. Quedó peor: de 11
moderadas a 17, ahora con una alta. Las versiones exactas se convirtieron en
rangos con ^. ESLint ya no sabe leer la configuración del proyecto, y el
build se rompió. Si alguien lo hubiera hecho en una rama sin mirar y con un
pipeline apagado, lo habría subido.
Error común. Correr
npm audit fix --forcepara que el reporte quede en cero.--forcesignifica exactamente lo que dice: hace el cambio aunque sea de MAJOR. Sin--force,npm audit fixsolo aplica actualizaciones que los rangos permiten, y eso sí se puede probar con tranquilidad: revisen el diff del lockfile y corranmake check.
La decisión se escribe
Después del análisis, la decisión es una línea de trabajo, no un silencio. En
docs/dependencias.md, o en la descripción del pull request:
**GHSA-g3hv-75wg-m249, minimatch < 11.0.1 (moderada), visto el 2 de noviembre de 2026.**
Llega por eslint y typescript-eslint. Solo en desarrollo: `npm audit --omit=dev` encuentra 0.
Para aprovecharla hay que controlar los patrones de ESLint, que son los de nuestra configuración.
Se acepta el riesgo. No se usa `--force`: instala ESLint 4 y rompe `make check`.
Se vuelve a mirar con cada release de ESLint.
¿Y si estuviera en una dependencia que llega a producción? Cambia la primera
respuesta, y casi seguro la decisión. Si el servidor le pasa a esa función
texto que manda un usuario, un atacante sí puede dar el patrón, y lo que era
“un eslint . lento” pasa a ser una caída del servicio. Se busca una versión
corregida, se evalúa cambiar de paquete, se aísla o se le pone un límite al
tamaño de la entrada, y se hace ya. P4 lo pide así: sin vulnerabilidades
altas ni críticas en las dependencias de producción.
En el pipeline
Por omisión, npm audit sale con código distinto de cero por cualquier
hallazgo. La documentación recomienda para CI la opción --audit-level, que
no cambia el reporte, sino el umbral del fallo:
$ npm audit --audit-level=high > /dev/null
[código de salida: 0]

$ npm audit --audit-level=moderate > /dev/null
[código de salida: 1]
Si ponen npm audit sin nivel en el pipeline, queda en rojo desde el primer
día. Ya vieron qué le pasa a un equipo con un rojo permanente.
Hay una consideración más fina, que conecta con el inicio del capítulo: npm audit no es hermético. Mira la base de vulnerabilidades de hoy. Un commit
que estaba en verde ayer puede salir en rojo hoy, sin que nadie haya cambiado
nada, porque alguien publicó un aviso. Ese rojo es información útil, pero
bloquea un pull request que no tiene la culpa. Por eso muchos equipos separan
esa revisión del check obligatorio: un job aparte, o uno que corre una vez al
día. En el laboratorio van a elegir un nivel, y conviene que su justificación
diga qué pasa el día que aparezca un aviso nuevo.
Idea clave. Un reporte de vulnerabilidades es el inicio de un análisis. El número de arriba no mide cuánto riesgo tienen: para eso hay que preguntar si llega a producción, qué tiene que hacer un atacante y si hay arreglo.
El laboratorio: un pipeline para Kallpa
El laboratorio se hace sobre su repositorio de Kallpa,
en una rama pipeline-ci. Los comandos de npm y make van en la shell del
contenedor; git push y la configuración de GitHub, en la terminal de su
computadora. Los pasos tienen este sentido:
-
Declarar las herramientas. Las seis directas con
--save-exact. Busquen enpackage-lock.jsonun paquete que no hayan instalado y pregunten connpm explainquién lo pidió. Hagan commit de los dos archivos. Sinpm installles da otro número de paquetes, es normal: anótenlo. -
Simular el runner, con
npm ciy los dosPATHde arriba. -
Escribir el workflow en
.github/workflows/ci.yml. Partan del primer intento de este capítulo y agreguen lo que falta. Pueden revisarlo antes de subirlo:node /work/code/week-12/revisar-workflow.ts .github/workflows/ci.yml -
Subir la rama y abrir el pull request. Vean el check en la pestaña Checks y abran el log de cada step. Anoten cuánto tardó el job, y cuánto de eso fue
npm ci. Este apunte no les da esa cifra, porque depende de GitHub y de ese día. -
Romperlo a propósito, una vez con
tscy otra con una prueba. Encuentren la línea exacta del error en el log y cierren el pull request sin hacer merge. Si el check no se pone rojo, encontraron un problema en su workflow. -
Proteger
main. Exijan pull request con aprobación y el check. Comprueben que el botón queda bloqueado. Antes, revisen si su repositorio es público o si tienen GitHub Pro con GitHub Education. -
Dependencias con criterio.
npm auditcon sus variantes,npm outdatedynpm audit signatures. En la descripción del pull request expliquen qué dice cada uno, por qué no usan--forcey qué nivel eligieron para su step. -
Paquetes que no existen.
code/week-12/sugerencia.mdes una ilustración escrita para la clase: un cambio con tresnpm install. Antes de instalar nada, revisen cada nombre y escriban la decisión como en su registro de uso de IA.
Lo que hagan hoy es el primer paso de P4, que pide lo mismo para su
proyecto, con un npm run check, un job de deploy y docs/dependencias.md.
En la industria. Los equipos no suelen revisar dependencias a mano todos los días. Herramientas como Dependabot abren un pull request por cada actualización, y ahí se ve el valor de todo este capítulo: si el pipeline es confiable y las pruebas son buenas, un pull request de actualización en verde se puede revisar en minutos. SWEG lo dice en una frase: las pruebas y CI son lo que da evidencia real de que un conjunto de versiones funciona junto. Sin eso, actualizar es un salto al vacío, y por eso se posterga hasta que una vulnerabilidad obliga a hacerlo de golpe.
El código de la semana y make test
Todo está en code/week-12:
| Archivo | Qué es |
|---|---|
semver-range.ts, semver-range.test.ts |
Qué acepta ^, ~ o una versión exacta, comparado con el paquete semver |
lockfile-report.ts, lockfile-report.test.ts |
El reporte del lockfile: paquetes, versiones anidadas, licencias, scripts |
esperado/ |
package.json y package-lock.json de la corrida del 2 de noviembre de 2026 |
revisar-workflow.ts, revisar-workflow.test.ts |
Revisa un workflow contra las reglas de la semana |
ejemplos/workflow-incompleto.yml |
El primer intento |
ejemplos/workflow-peligroso.yml |
Todo lo que no hay que hacer |
ejemplos/fecha-local.ts, fecha-local.check.ts |
La prueba que pasa en Lima y falla en UTC |
flaky.ts, flaky.test.ts |
La cuenta de las pruebas inestables |
escenarios.sh, escenarios.test.ts |
make tipos, make colision y make zona |
registro.sh |
Las corridas que usan el registro de npm |
runner-limpio.sh |
make check en una imagen de Node sin las herramientas, desde su computadora |
sugerencia.md, sugerencia.test.ts |
El material del paso 8 |
make test revisa los tipos, corre ESLint y las pruebas, y no usa la red,
a propósito: si dependiera del registro de npm, sería un presubmit que puede
fallar porque se cayó internet, justo lo que este capítulo critica.
$ cd code/week-12
$ make test
tsc -p .
eslint .
node --test "*.test.ts"
...
ℹ tests 44
ℹ suites 0
ℹ pass 44
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
...
Lo que depende del registro está en objetivos aparte, que imprimen la salida de
hoy y dejan una copia en build/salidas/: make arbol, make runner, make falta, make lockfile, make auditar, make fuerza, make peer, make rangos, make sbom y make paquetes. Nada de esto modifica kallpa/, y
make clean borra build/.
Resumen
- La integración continua es una práctica: cada integrante integra a la rama principal al menos una vez al día, y cada integración se verifica con un build automático. Un pipeline perfecto con ramas de tres semanas no es integración continua. Dos ramas en verde pueden dar un merge en rojo, sin conflictos de Git.
- Cuando Node ejecuta TypeScript sin compilar, el build es
tsc,eslinty las pruebas:make check. Sin él, los tipos son comentarios. - Un build reproducible da lo mismo con las mismas entradas, y uno hermético no depende de lo que no declaró. El pipeline llama a lo mismo que corre una persona.
- Presubmit lleva pruebas rápidas y confiables; post-submit, las demás. Una prueba flaky enseña a ignorar el rojo.
- En GitHub Actions, un workflow se dispara con eventos y tiene
jobs que corren en runners; cada job tiene steps, que son
comandos o actions. Un step falla por su código de salida, y una tubería
sin
pipefaillo esconde. - Seguridad:
permissions: contents: read, secrets fuera del código y de los logs, y actions fijadas, porque una etiqueta se puede mover. Sin protección de rama con required status checks, el pipeline es decorativo. - Semver es una promesa de quien publica; las pruebas son la evidencia.
^acepta hasta el siguiente MAJOR, salvo en0.x;~, hasta el siguiente MINOR. - El lockfile fija la versión y el hash de cada paquete, también los
transitivos. En el pipeline va
npm ci. Garantiza que lo instalado es lo mismo, no que sea bueno. - Seis dependencias directas instalan 100 paquetes. npm tolera muchos diamantes
con copias anidadas; con las
peerDependencies, el diamante vuelve. - Antes de agregar una dependencia: ¿existe?, ¿quién la mantiene?, ¿qué trae?, ¿qué licencia?, ¿hace falta? Cada una de producción va con un ADR.
- La cadena de suministro se ataca por typosquatting, dependency confusion o un mantenedor comprometido, como en xz. Ninguna defensa cubre todo.
- Los modelos de lenguaje inventan nombres de paquetes, y muchos se repiten. Existir en el registro no prueba nada. No se instala nada que nadie haya verificado.
npm auditse lee preguntando si llega a producción, qué necesita el atacante y si hay arreglo, y la decisión se escribe. Aquí,npm audit fix --forcepasó de 11 a 17 vulnerabilidades y rompió el build.
Ejercicios
- Un equipo tiene un pipeline que corre en cada push, pero cada integrante trabaja dos semanas en su rama antes de hacer merge. ¿Hace integración continua? Propongan dos cambios concretos para empezar, y digan qué medirían para saber si funcionaron.
- Sin correr nada, digan qué versiones acepta cada rango, y cuáles de
1.2.3,1.3.0,2.0.0,0.2.5,0.3.0y0.0.9entran en cada uno: (a)^1.2.3; (b)~1.2.3; (c)^0.2.3; (d)~0.2.3; (e)^0.0.9. Comprueben sus respuestas consatisfiesdesemver-range.ts. - Hagan los siguientes cambios en una copia de Kallpa y digan, antes de
correr, qué pasos de
make checkfallan y cuáles no: (a) pasar unstringaaddDaysen un archivo desrc; (b) cambiarPEAK_SURCHARGE_PERCENTa 30; (c) dejar una variable sin usar ensrc/domain/report.ts. ¿Cuáles de los tres no detectaríanode --test? - Una suite de 200 pruebas tiene 5 pruebas flaky, cada una con 2 % de falla.
Calculen cuántos de 100 builds saldrían en rojo sin razón, con
falseRedProbability. Si el equipo reintenta una vez cada build en rojo, ¿cuántos quedan? ¿Qué supuesto están usando, y qué se pierde con el reintento? - En
make colision, cambien el orden: primero hagan merge delinea-de-cajay después derenombra-soles. ¿Da conflicto? ¿Fallamake check? Expliquen qué haría la protección de rama en modo estricto en cada caso, y qué comando correría cada persona. - Lean
ejemplos/workflow-peligroso.yml. Para cada línea marcada, escriban qué le puede pasar a un equipo real, y la línea corregida. Pasen el resultado porrevisar-workflow.tshasta que dé 0 errores. ¿Qué error no encontraría el revisor, aunque el workflow esté mal? - Agreguen a
revisar-workflow.tsuna regla: unnpm auditen un workflow que no use--omit=devda un aviso. Escriban primero su prueba. Después, decidan si debería ser un error, y justifíquenlo con un ejemplo. - Agreguen a
lockfile-report.tsuna lista de los paquetes con el mayor número de pedidos (usenrequesters). ¿Cuáles son los cinco más pedidos enesperado/package-lock.json? ¿Qué pasaría si uno de ellos publica una versión maliciosa, y cómo les llegaría según tengan lockfile o no? - Escojan un paquete de
dependenciesde su proyecto (o, si no tienen,fast-check). Háganle la inspección completa de Cox, con evidencia para cada una de sus nueve categorías: comandos, enlaces y lo que encontraron. Terminen con un ADR de la forma que propone este capítulo. - Un aviso reporta denegación de servicio en una biblioteca de análisis de fechas, con severidad alta. Su proyecto la tiene como dependencia de producción. Escriban la decisión para dos casos: (a) solo procesa fechas generadas por su propio servidor; (b) procesa un campo de un formulario público. ¿Cambia la urgencia? ¿Qué harían mientras no haya versión corregida?
- Busquen en npm tres nombres que les haya sugerido una herramienta de IA en
P2, P3 o en su registro de uso. Apliquen los seis pasos de “La defensa”. Si
todos existen, ¿qué aprendieron sobre lo que
npm viewpuede y no puede decirles? - Propongan el pipeline de P4 para su proyecto: qué corre en presubmit y qué en post-submit, qué entradas fijan y cuáles no, y dónde va la auditoría. Escriban la lista de cosas que hoy podrían hacer que el pipeline se ponga rojo sin que nadie haya tocado el código.