Apuntes · Capítulo 13Producción y evolución
Despliegue y operación
Despliegue y operación
La semana pasada el pipeline aprendió a decir que no: un pull request con
pruebas rotas no llega a main, y las dependencias quedan fijadas en un
lockfile. Pero un commit en main todavía no le sirve a nadie. Los vecinos de
Kallpa no reservan en un repositorio. Esta semana el código sale a producción
y se queda allí, atendiendo personas, fallando a veces.
Producción cambia las preguntas. Hasta ahora preguntábamos si el código hace lo que debe. Ahora preguntamos otras cosas. ¿Qué versión está corriendo? ¿Dónde vive la base de datos cuando se reemplaza el proceso? ¿Qué le pasa a la reserva que llegó justo cuando apagamos el servidor? ¿Cómo nos enteramos de que se cayó antes de que nos llame la administradora? ¿Cuánto puede fallar sin que sea un problema? Y cuando algo sale mal, ¿cómo aprendemos sin buscar a quién culpar?
El capítulo tiene dos partes, como la semana. En la primera estudiamos el despliegue: entrega y despliegue continuos, contenedores e imágenes, el estado, el apagado ordenado, las estrategias de despliegue y los feature flags. En la segunda estudiamos la operación: telemetría, salud del servicio, SLIs, SLOs, presupuesto de errores, incidentes, postmortems y las métricas de DORA.
Casi todo lo que sigue se midió sobre Kallpa, y varios resultados sorprenden:
un docker stop que tarda 10 s o 0.1 s según una línea del Dockerfile, un
servidor que ignora una señal solo cuando está en un contenedor, y un
contenedor healthy que perdió todas las reservas.
Lectura. Para la primera parte: Software Engineering at Google (SWEG), cap. 24, Continuous Delivery, y cap. 25, Compute as a Service, hasta Choosing a Compute Service. Complementarias: La aplicación de doce factores, en especial III, IX y X; Pete Hodgson, Feature Toggles (aka Feature Flags); Docker, Get started y la referencia del Dockerfile. Para la segunda: Site Reliability Engineering (SRE), cap. 4, Service Level Objectives, y cap. 15, Postmortem Culture. Complementarias: SRE, cap. 6, Monitoring Distributed Systems; The Site Reliability Workbook, Implementing SLOs; DORA, DORA’s software delivery performance metrics; y OpenTelemetry, What is OpenTelemetry? El código del capítulo está en
code/week-13y se prueba conmake testdentro del contenedor del curso. Los ejemplos con Docker corren en la terminal de su computadora.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Del pipeline a producción, Entrega continua y despliegue continuo y Más rápido es más seguro; de Contenedores e imágenes, Qué es un contenedor; de El estado no vive en el contenedor, La capa escribible; de Apagarse bien, Señales: SIGTERM y SIGKILL; Estrategias de despliegue; de Qué está pasando allá adentro, Observabilidad y telemetría; de SLIs, SLOs y SLAs, Definiciones y Presupuesto de errores; y de Incidentes, Qué es, y qué se hace primero.
- En clase: Sesión A: Del pipeline a producción, Contenedores e imágenes, El estado no vive en el contenedor, Apagarse bien, Estrategias de despliegue y Feature flags. Sesión B: Qué está pasando allá adentro, SLIs, SLOs y SLAs, Incidentes y Las métricas de DORA. Laboratorio: Laboratorio: desplegar Kallpa, observarla y escribir un postmortem.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Un postmortem completo, Alertar por lo que se quema, ¿Qué le pasa a la reserva?, Capas y caché: lo que cambia seguido va al final y las lecturas del recuadro Lectura.
Del pipeline a producción
Entrega continua y despliegue continuo
Dos términos se confunden todo el tiempo, y comparten las siglas CD.
Entrega continua (continuous delivery): cada cambio que pasa el pipeline queda listo para desplegarse. Hay un artefacto probado, y llevarlo a producción es una decisión, no un proyecto: un botón. Una persona decide cuándo.
Despliegue continuo (continuous deployment): además, cada cambio que pasa el pipeline se despliega solo. No hay una persona en medio.
La diferencia no es técnica. El mecanismo es el mismo, y lo que cambia es si alguien aprieta el botón. Es una diferencia de confianza en el pipeline: para quitar a la persona, lo que ella revisaba tiene que estar revisado por otra cosa. ¿Qué tendría que ser cierto en Kallpa? Que las pruebas cubran lo que duele si se rompe, que una prueba de humo compruebe el despliegue, que haya una señal automática de que algo va mal y un rollback ensayado. P4 pide despliegue continuo porque su producto es pequeño y el riesgo también; un banco puede preferir, con razón, una persona en medio.
Más rápido es más seguro
La intuición dice lo contrario: si desplegar da miedo, desplieguen menos. SWEG cap. 24 sostiene que esa intuición sale cara. Un release que junta el trabajo de tres meses tiene miles de líneas nuevas, y cuando falla nadie sabe cuál de ellas fue. Un despliegue de un solo cambio se entiende y se revierte en minutos.
La frase del capítulo es faster is safer: los lotes pequeños dan más calidad. Agrupa las prácticas en seis ideas: agilidad (lotes pequeños y frecuentes), automatización, aislamiento (módulos que aíslan los cambios), confiabilidad (medir crashes y latencia), decisiones con datos (pruebas A/B) y despliegue gradual.
El capítulo también describe el círculo vicioso. Cuando un release cuesta mucho, se espera a probarlo un poco más; mientras tanto alguien quiere meter “una funcionalidad más que ya casi está”; el release crece, y cuesta más. La respuesta instintiva, frenar y agregar controles, da estabilidad a corto plazo y lentitud para siempre.
En la industria. SWEG cap. 24 cuenta dos casos de Google. En YouTube, cada release tenía un ciclo de 50 horas de pruebas manuales de regresión. En Search, se desplegaba una vez por semana, con suerte; después de varios años de automatización llegaron a un binario nuevo cada dos días. Para lograrlo aceptaron dos ideas: ningún binario es perfecto, así que se decide qué errores frenan un release, y el tren sale a su hora: quien llega tarde toma el siguiente. Son relatos de una sola empresa, contados por sus autores, no un experimento. Otro detalle importante: el capítulo aclara que Search, Maps o YouTube no publican una versión muy distinta cada día; dice que poder hacerlo ya da la mayor parte del valor. Y su recomendación para los equipos grandes, pasar a microservicios, no se traslada a un producto del tamaño de Kallpa (semana 7).
Idea clave. Desplegar debería ser aburrido. Si es un evento, con reunión y nervios, es porque se hace poco y con mucho adentro. Se vuelve aburrido haciéndolo seguido y en pedazos chicos.
Configuración, código y estado
Para desplegar seguido hay que separar tres cosas que en un servidor cuidado a mano suelen estar mezcladas:
- El código: lo mismo en todos los entornos. Entra en la imagen.
- La configuración: lo que cambia entre entornos (puerto, ruta de la base de datos, flags, credenciales). El factor III de doce factores pide guardarla en el entorno, en variables de entorno, y da una prueba: ¿podrían publicar el código hoy, sin filtrar ninguna credencial?
- El estado: las reservas. No se reemplaza nunca, y tiene que sobrevivir a todo lo demás.
Kallpa ya hace bien la segunda parte: src/config.ts lee PORT y KALLPA_DB
una sola vez al arrancar y se niega a arrancar si algo está mal. El factor X
pide además paridad: que desarrollo y producción se parezcan lo más
posible, para que un error aparezca antes. El contenedor del curso existe por
esa razón.
Contenedores e imágenes
Qué es un contenedor
Un contenedor es un proceso con vista propia: su propio sistema de archivos, su propia red y su propia lista de procesos. No es una máquina virtual. Una máquina virtual arranca un sistema operativo entero, con su kernel; un contenedor es un proceso corriente del sistema, que comparte el kernel con los demás y al que el kernel le muestra una vista aislada (con namespaces) y le pone límites de recursos (con cgroups).
Por eso un contenedor arranca en milisegundos y no en minutos. Y por eso un contenedor Linux necesita un kernel Linux. ¿Y en una Mac o en Windows? Docker Desktop corre una máquina virtual Linux, y los contenedores comparten el kernel de esa máquina:
$ uname -sr
Darwin 25.6.0
$ docker run --rm node:26-trixie-slim uname -sr
Linux 6.12.72-linuxkit
Una imagen es el sistema de archivos inicial del contenedor, más unos metadatos (qué comando correr, qué usuario, qué puerto). No corre: es un template de solo lectura. De una imagen salen muchos contenedores, como de una clase salen muchos objetos. Un contenedor agrega encima una capa escribible, propia, donde queda todo lo que escribe. Esa capa va a importar mucho en un momento.
En la industria. SWEG cap. 25 explica por qué esto cambió la operación con una analogía: pets versus cattle. Si el servidor es una mascota, tiene nombre, y cuando se enferma alguien lo cuida. Si son ganado (
replica001areplica100), cuando uno falla la automatización lo saca y pone otro. Lo que distingue al ganado es que crear uno nuevo no requiere pasos a mano. Con un contenedor, cada despliegue es exactamente eso: se tira uno y se crea otro. El capítulo describe la escala de Google, con su planificador Borg; pero el hábito mental sirve para un solo contenedor en una máquina pequeña: cualquier instancia se puede borrar en cualquier momento.
Un primer Dockerfile, y qué tiene de malo
Un Dockerfile es la receta de la imagen. Cada instrucción agrega una capa o
unos metadatos. Las cuatro básicas son FROM (de qué imagen se parte), COPY
(copiar archivos del proyecto a la imagen), RUN (ejecutar un comando durante
el build) y CMD (qué comando corre el contenedor).
Este primer intento para Kallpa está en
ejemplos/Dockerfile.ingenuo:
FROM node:26-trixie-slim
COPY . /app
WORKDIR /app
CMD node src/main.ts
Funciona: la aplicación arranca y responde. Tiene cinco problemas, y ninguna
prueba los ve. Construyámoslo con un .env y una base de datos en la carpeta,
como la de cualquiera que estuvo desarrollando, y miremos adentro:
$ docker build -q -t kallpa:ingenua .
sha256:33d39018d3fc6407350829f89493aa10f5c319e03dbcc537a12b16917f714eda
$ docker run --rm --entrypoint sh kallpa:ingenua -c 'id -u; ls -a /app; cat .env; ls /app/data'
0
.
..
.env
.git
.gitignore
Dockerfile
Makefile
README.md
data
eslint.config.js
package.json
public
src
test
tsconfig.json
DB_PASSWORD=contrasena-de-ejemplo
kallpa.db- Copia todo. Dentro de la imagen quedaron el
.envcon la contraseña, la historia completa de.git, las pruebas y la base de datos de desarrollo. - Corre como root. El
0es elid -u. Si alguien explota una falla de Kallpa, tiene root dentro del contenedor. CMDen forma shell. Sin corchetes, Docker lo corre con/bin/sh -c. Ya vamos a ver qué cuesta esto al apagar.- No dice cómo saber si está sano. Sin
HEALTHCHECK, Docker solo sabe si el proceso existe. - No prepara la carpeta de datos. Con un usuario que no sea root, no podría escribir la base de datos.
Vamos a arreglarlos uno por uno. La solución completa la arman ustedes en el laboratorio; aquí están las ideas y lo que se midió con ella.
Copiar solo lo necesario
Lo primero es nombrar lo que hace falta: src/, public/ y package.json.
Kallpa no tiene dependencias de producción, y Node corre el TypeScript
directamente: en la imagen no hace falta tsc, ni ESLint, ni las pruebas. Una
imagen más chica tarda menos en subirse, y tiene menos cosas que puedan tener
una vulnerabilidad.
Además va un .dockerignore, que es a Docker lo que .gitignore a Git:
lo que lista no entra en el contexto del build. Con COPY src ./src y COPY public ./public explícitos, ni .env ni .git entrarían de todas formas. El
.dockerignore es la segunda barrera: protege el día en que alguien escriba
COPY . .. Excluyan al menos .git/, node_modules/, data/ y .env.
Capas y caché: lo que cambia seguido va al final
Cada instrucción crea una capa, y Docker reutiliza una capa si ni la instrucción ni lo que entra en ella cambiaron. La primera capa que cambia invalida todas las de abajo. Por eso el orden importa: lo que casi nunca cambia va primero y el código va al final.
Con la imagen de la solución, cambiamos una línea de src/domain/court.ts,
hicimos commit y volvimos a construir (la salida está filtrada a las líneas de
cada paso):
$ docker build --progress=plain -t kallpa:$(git rev-parse --short HEAD) -t kallpa .
...
#6 [2/6] WORKDIR /app
#6 CACHED
#7 [4/6] COPY package.json ./
#7 CACHED
#8 [3/6] RUN mkdir data && chown node:node data
#8 CACHED
#9 [5/6] COPY public ./public
#9 CACHED
#10 [6/6] COPY src ./src
#10 DONE 0.0s
...
Solo se rehízo la capa de src. En un proyecto con dependencias se nota mucho
más: primero COPY package.json package-lock.json, luego RUN npm ci, y al
final el código. Al revés, cada cambio de una línea reinstalaría todos los
paquetes.
docker history muestra las capas. Las de 0B solo son metadatos, y por debajo
están las de la imagen base:
$ docker history kallpa --format "{{.CreatedBy}} | {{.Size}}" | cut -c1-90 | head -14
CMD ["node" "src/main.ts"] | 0B
HEALTHCHECK &{["CMD" "node" "-e" "fetch('htt… | 0B
EXPOSE [3000/tcp] | 0B
USER node | 0B
RUN /bin/sh -c mkdir data && chown node:node… | 12.3kB
COPY src ./src # buildkit | 135kB
COPY public ./public # buildkit | 24.6kB
COPY package.json ./ # buildkit | 12.3kB
WORKDIR /app | 8.19kB
CMD ["node"] | 0B
ENTRYPOINT ["docker-entrypoint.sh"] | 0B
COPY docker-entrypoint.sh /usr/local/bin/ # … | 20.5kB
RUN /bin/sh -c ARCH= OPENSSL_ARCH= && dpkgAr… | 179MB
ENV NODE_VERSION=26.13.0 | 0B
Esta salida es de un build anterior, en el que el RUN iba después de los
COPY. Justamente por eso se movió arriba en la versión final.
Error común. Una contraseña en la imagen, “pero la borro después”. Una capa no se modifica: un
RUN rmagrega otra capa que la esconde. El archivo sigue ahí, y lo puede leer cualquiera que tenga la imagen. Lo pueden comprobar conejemplos/secreto/, que copia un archivo y lo borra en la siguiente instrucción:$ docker run --rm secreto ls -a /app . .. $ docker history secreto --format "{{.CreatedBy}} | {{.Size}}" | head -3 RUN /bin/sh -c rm credenciales.txt # buildkit | 8.19kB COPY credenciales.txt . # buildkit | 12.3kB WORKDIR /app | 8.19kB $ docker save secreto | tar -x -C build/secreto $ cd build/secreto/blobs/sha256 && for capa in *; do tar -xOf "$capa" app/credenciales.txt 2>/dev/null; done DB_PASSWORD=contrasena-de-ejemploDentro del contenedor no hay nada, pero la capa del
COPYsigue guardando el archivo. Lo mismo vale paraENVy para unARG: se ven condocker historyodocker inspect. Las credenciales entran al correr, por el entorno, y las pone quien despliega: nunca elDockerfile.
Un usuario sin privilegios
USER node hace que el resto de la imagen y el contenedor corran como ese
usuario (las imágenes oficiales de Node ya lo traen). Comprobémoslo con la
imagen de la solución. También vean qué falta:
$ docker run --rm --entrypoint sh kallpa -c "which curl wget node; id; ls -la /app"
/usr/local/bin/node
uid=1000(node) gid=1000(node) groups=1000(node)
total 24
drwxr-xr-x 1 root root 4096 Nov  2 06:13 .
drwxr-xr-x 1 root root 4096 Nov  2 06:48 ..
drwxr-xr-x 2 node node 4096 Nov  2 06:13 data
-rw-r--r-- 1 root root  379 Nov  2 06:09 package.json
drwxr-xr-x 2 root root 4096 Nov  2 06:10 public
drwxr-xr-x 7 root root 4096 Nov  2 06:13 src
Los archivos del código son de root, y node no los puede cambiar. Solo
data/ es suya. Y la imagen slim no trae curl: which solo encontró
node. Vamos a necesitar ese dato para el HEALTHCHECK.
Imágenes inmutables y etiquetas
Una imagen inmutable no se modifica después de construida. La misma imagen, byte por byte, pasa por las pruebas, por staging y por producción, y lo único que cambia entre entornos es la configuración. Si algo falla en producción, no hay “es que en producción instalamos otra cosa”.
Para eso hay que saber cuál es cuál. Una etiqueta es solo un nombre que apunta
a una imagen, y latest no significa “la última”: es la etiqueta por omisión,
que se mueve cada vez que alguien construye sin pensar. Por eso se etiqueta
con el SHA del commit:
$ git log --oneline | head -3
e979270 Cambia una línea
423e2b2 Ordena las capas de la imagen
b6585a3 Agrega health, logs JSON, apagado ordenado y flag de reservas
$ docker images kallpa --format "{{.Tag}} {{.ID}}"
e979270 c8b329c848c4
latest c8b329c848c4
423e2b2 f9148b91579f
...
b6585a3 d8548bf37aa3
e979270 y latest son la misma imagen hoy; mañana quizá no. Ahora comparen
qué se ve en producción con una y con otra:
$ docker ps --filter name=kallpa --format "{{.Names}} {{.Image}} {{.Status}}"
kallpa kallpa Up 1 second (health: starting)
$ docker rm -f kallpa
kallpa
$ docker run -d --name kallpa -p 8080:3000 -v kallpa-data:/app/data kallpa:e979270
137150f78836940e94848e5b64a8251cb0408998ce109deb942cc7b24cbbcd0c
$ docker ps --filter name=kallpa --format "{{.Names}} {{.Image}}"
kallpa kallpa:e979270
Con kallpa a secas no se sabe qué está corriendo. Con el SHA, sí, y git show e979270 dice qué código es. Volver atrás, el rollback, es correr la
imagen anterior, sin reconstruir nada:
$ docker rm -f kallpa
kallpa
$ docker run -d --name kallpa -p 8080:3000 -v kallpa-data:/app/data kallpa:423e2b2
151dc28c1ff2da9602c31e4ccbdba91635ae1ee93dcd06721b6c457c0ef5b6a7
$ docker ps --filter name=kallpa --format "{{.Names}} {{.Image}}"
kallpa kallpa:423e2b2
$ curl -s localhost:8080/health; echo
{"status":"ok"}
Idea clave. Código en la imagen, configuración en el entorno, estado en un volumen. Cada error de esta sección es una de las tres cosas en el lugar de otra.
Error común. Un rollback con migraciones. Volver a la imagen anterior es fácil si la base de datos sigue siendo compatible con ella. Si la versión nueva borró una columna que la anterior lee, la imagen vieja arranca y falla. Por eso se migra en pasos que primero agregan y después quitan; lo vemos en la semana 16.
El estado no vive en el contenedor
La capa escribible
Levantemos Kallpa sin nada más, y preguntémosle a Docker qué cambió el contenedor respecto a su imagen:
$ docker run -d --name kallpa -p 8080:3000 kallpa
bb657a5009d30a9582d9f988dd5e9fdceb0f96f1a722d87f53c3a280765faff0
$ docker diff kallpa
C /app
C /app/data
A /app/data/kallpa.db
$ docker ps -s --filter name=kallpa --format "{{.Names}} {{.Image}} {{.Size}}"
kallpa kallpa 45.1kB (virtual 289MB)
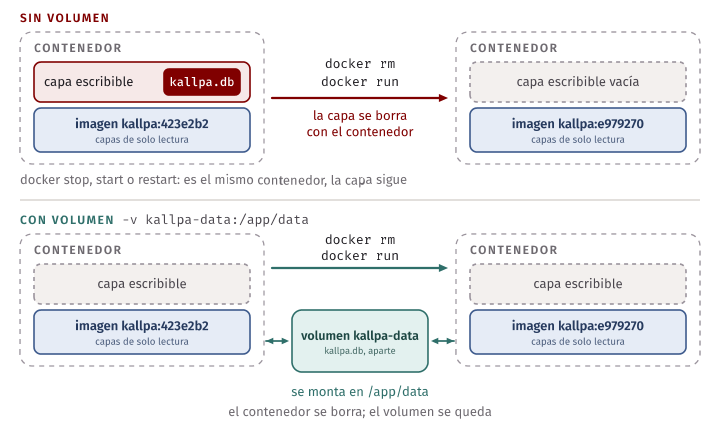
La A significa agregado. La base de datos está en la capa escribible de
este contenedor. Hay que ser precisos con lo que le pasa a esa capa:
| Comando | La capa escribible |
|---|---|
docker stop y docker start |
Sigue ahí: es el mismo contenedor |
docker restart, o un reinicio por --restart |
Sigue ahí |
docker rm |
Se borra |
Y desplegar es rm más run: un contenedor nuevo, de otra imagen, con una
capa vacía. Nada avisa, porque nada falló.
Volúmenes
Un volumen es un espacio de almacenamiento que administra Docker y que existe aparte de cualquier contenedor. Se monta en una carpeta, y lo que se escribe allí no pasa por la capa escribible. Si un contenedor se borra, el volumen se queda.
docker run -d --name kallpa -p 8080:3000 -v kallpa-data:/app/data kallpakallpa-data es un volumen con nombre: se crea la primera vez y se
reutiliza después. SWEG cap. 25 lo dice en general: el estado dentro del
proceso es transitorio, y lo que tiene que sobrevivir se guarda en otra parte,
en almacenamiento persistente. A escala, eso es un servicio de base de datos
replicado. En Kallpa es un archivo de SQLite en un volumen de una sola
máquina: sobrevive a un despliegue, pero no a que se pierda ese disco. P4 pide
además saber cómo se respalda.
Error común. La carpeta de datos con el owner equivocado. Con
USER node, y sin preparar/app/dataen la imagen, Kallpa no arranca. Con un volumen vacío, Docker crea el punto de montaje como root; sin volumen,nodeno puede crear la carpeta en/app. Son dos errores distintos, medidos con esa imagen:$ docker run --rm -v w13v:/app/data kallpa:sin-chown 2>&1 | grep -E "Error|errcode|code:|at " | head -6 Error: unable to open database file at openDatabase (file:///app/src/store/database.ts:41:14) at file:///app/src/main.ts:16:12 at ModuleJob.run (node:internal/modules/esm/module_job:569:25) at async node:internal/modules/esm/loader:650:26 at async asyncRunEntryPointWithESMLoader (node:internal/modules/run_main:105:5) { $ docker run --rm --entrypoint ls -v w13v:/app/data kallpa:sin-chown -ld /app/data drwxr-xr-x 2 root root 4096 Nov 2 06:13 /app/data $ docker run --rm kallpa:sin-chown 2>&1 | grep -E "Error|code:" | head -4 Error: EACCES: permission denied, mkdir 'data' code: 'EACCES',La solución es crear la carpeta en la imagen, antes de
USER node:RUN mkdir data && chown node:node data. Cuando un volumen con nombre está vacío, Docker copia en él lo que la imagen tiene en esa ruta, con owner y permisos. Un volumen que ya tiene datos no se toca, y un bind mount (una carpeta de la computadora montada con su ruta) tampoco copia nada: se queda con los permisos que tenía.
Un contenedor que se puede tirar
Volvamos a la lista del Dockerfile. Con los archivos justos, USER node, la
carpeta preparada y el código al final, ya tenemos una imagen decente. Falta
lo que pasa cuando la apagan.
Apagarse bien
Señales: SIGTERM y SIGKILL
El factor IX de doce factores pide procesos desechables: que arranquen rápido y que terminen bien. “Terminar bien” tiene una definición precisa:
- Una señal es un aviso que el sistema operativo entrega a un proceso.
- SIGTERM (15) significa “termina, por favor”. Se puede atrapar con un manejador.
- SIGKILL (9) mata el proceso sin avisarle. No se puede atrapar.
docker stop manda SIGTERM al proceso principal del contenedor, espera un
tiempo y, si sigue vivo, manda SIGKILL. Cuando un proceso muere por una señal,
el código de salida es 128 + n: 143 por SIGTERM y 137 por SIGKILL.
docker rm -f va directo a SIGKILL.
El resultado que sorprende
Medimos con la imagen de la solución, y con otra igual a la que le quitamos
las dos líneas process.once(...). El tiempo es de time docker stop kallpa,
con el formato abreviado:
$ docker run -d --name kallpa --stop-timeout 10 kallpa
e018e756772af89f6d246e93d3ec2081f15471701c98844785be25e3d08aeb60
$ time docker stop kallpa
kallpa
real 0.113s
$ docker inspect -f '{{.State.ExitCode}}' kallpa
0
$ docker run -d --name kallpa --stop-timeout 10 kallpa:sin-sigterm
49c1662d62f8ee74974d471f2e76109aa0b068663cbe1e3d15c3d7079ffd2bcb
$ time docker stop kallpa
kallpa
real 10.141s
$ docker inspect -f '{{.State.ExitCode}}' kallpa
137Sin manejador, Node ni se enteró: esperó 10 s y murió por SIGKILL. Pero
hagamos lo mismo con la Kallpa publicada, que tampoco maneja la señal, dentro
del contenedor del curso (make start en una shell, pkill en otra):
$ pkill -TERM -f 'node src/main.ts'
$ cat /tmp/pub.log
node src/main.ts
Base de datos nueva en data/kallpa.db: se cargaron los datos de ejemplo.
Kallpa escuchando en http://localhost:3000
GET /health 404
GET /api/courts 200
make: *** [Makefile:22: start] Terminated
Murió en el acto. El mismo programa, sin manejador, muere de inmediato en un caso e ignora la señal en el otro. ¿Por qué?
Por el proceso 1. Con CMD ["node", "src/main.ts"], Node es el proceso
con PID 1 dentro de su contenedor. El kernel trata de forma especial al
proceso 1 de cada espacio de procesos: no le aplica la acción por omisión de
una señal. Para cualquier otro proceso, la acción por omisión de SIGTERM es
morir; para el proceso 1, una señal que no tiene manejador se ignora. En make start, Node es un proceso normal, hijo de make, y muere.
Así que el laboratorio se comporta distinto en sus pasos 3 y 5, y ahora saben por qué. Lo mismo explica los otros arreglos que se ven por ahí. Medimos todos con un tiempo de espera de 10 s:
| Cómo se arranca | Proceso 1 | ¿Corre el manejador? | docker stop |
Salida |
|---|---|---|---|---|
CMD ["node", "src/main.ts"], con manejador |
node |
Sí | 0.113 s | 0 |
CMD ["node", "src/main.ts"], sin manejador |
node |
No hay | 10.141 s | 137 |
CMD node src/main.ts, con manejador |
/bin/sh -c ... |
No | 10.141 s | 137 |
CMD ["npm", "start"], con manejador |
npm start |
No | 0.669 s | 1 |
docker run --init, sin manejador |
el init de Docker |
No hay | 0.106 s | 143 |
docker run --init, con manejador |
el init de Docker |
Sí | 0.229 s | 0 |
Lean cada fila:
- Forma shell. El proceso 1 es
/bin/sh, y no le pasa la señal a Node. Tener el manejador no sirvió de nada. La referencia del Dockerfile lo advierte. npm start.npmsí reaccionó y todo terminó rápido, pero el log no tiene ni una líneashutting down: el manejador no corrió. Un0.669 sque parece bien esconde un apagado que no fue ordenado, y salió con código 1.--init. Docker pone un proceso 1 chiquito que reenvía señales, y Node deja de ser proceso 1. Sin manejador, Node muere con SIGTERM de inmediato (143): es rápido, pero no ordenado. Con manejador, el apagado es ordenado y sale con 0. Es un arreglo legítimo, sobre todo si el proceso crea hijos.
La solución usa la forma exec, con node directamente: es lo más simple y no
depende de una opción de docker run.
Error común. “Si tarda 10 s, ¿qué problema hay?” Dos, además del tiempo: cada despliegue queda 10 s sin atender a nadie, y SIGKILL corta las solicitudes en curso. Y el tiempo engaña en los dos sentidos:
npm starttarda poco y también corta. Con una solicitud en curso,docker stoptardó 0.894 s y el cliente HTTP recibióEmpty reply from server. Lo que hay que mirar es el log.
Cuánto espera docker stop
La documentación de docker stop dice que el tiempo de espera por omisión es
de 10 s en Linux. Sin embargo, en el Docker Desktop 29.2.1 donde se prepararon
estos apuntes, un contenedor nuevo trae otro valor, y así el mismo docker stop tarda 1 s:
$ docker run -d --name kallpa kallpa:sin-sigterm
b7d3ad4d8f15f8b45d7db1e9498015b17b3141e293c216bb295cd94daca01a0a
$ docker inspect -f '{{.Config.StopTimeout}}' kallpa
1
$ time docker stop kallpa
kallpa
real 1.148s
$ docker inspect -f '{{.State.ExitCode}}' kallpa
137
No encontramos en la documentación de dónde sale ese 1. La lección es general:
comprueben con docker inspect. Para fijarlo, docker run --stop-timeout 10,
o docker stop -t 10. Por eso medimos arriba con 10, y el código 137 no
cambia. En su hosting el número será otro: búsquenlo, porque es cuánto tiempo
tiene su aplicación para apagarse.
Un apagado ordenado en Node
El factor IX lo define así: el proceso deja de escuchar el puerto, deja
terminar las solicitudes en curso y sale. En
ejemplos/apagado.ts está en su forma
mínima:
export function shutdown(deadlineMs: number): void {
  console.log('apagando');
  // Si algo no termina a tiempo, se corta a propósito antes de que llegue SIGKILL.
  const deadline = setTimeout(() => server.closeAllConnections(), deadlineMs);
  deadline.unref();
  // close deja de aceptar conexiones y avisa cuando ya no queda ninguna abierta.
  server.close(() => {
    console.log('apagado');
    process.exitCode = 0;
  });
}

if (process.env.GRACEFUL === '1') {
  process.once('SIGTERM', () => shutdown(8000));
}server.closedeja de aceptar conexiones, cierra las inactivas y llama a la función cuando ya no queda ninguna.- El temporizador pone un límite por debajo de lo que espera quien lo apaga:
si algo no termina, se corta a propósito, y queda en el log.
unrefevita que él solo mantenga vivo el proceso. process.exitCode = 0y noprocess.exit(0): se deja salir solo, sin cortar lo que esté escribiendo. En Kallpa, además, se cierra la base de datos en ese momento.
Comprobémoslo con una solicitud en curso de verdad, sobre la imagen de la
solución. curl manda los encabezados de un POST y tarda 3 s en mandar el
cuerpo; al segundo, apagamos el contenedor:
$ time docker stop -t 10 kallpa
cliente: http=200 exit=0 t=3.005829
kallpa
real 2.203s
$ docker inspect -f '{{.State.ExitCode}}' kallpa
0
$ docker logs kallpa | tail -4
{"time":"2026-11-02T06:14:00.713Z","level":"info","msg":"shutting down","signal":"SIGTERM"}
[whatsapp] para 912345678: Hola Luis Huamán Torres, tu reserva de Vóley el 2026-11-05 de 10:00 a 11:00 está confirmada. Total: S/ 45.00.
{"time":"2026-11-02T06:14:02.698Z","level":"info","msg":"request","method":"POST","path":"/api/bookings","status":200,"durationMs":2999}
{"time":"2026-11-02T06:14:02.699Z","level":"info","msg":"stopped"}
El orden del log lo cuenta todo: llega la señal, la reserva termina, recién entonces se apaga. Ahora, sin manejador y con menos paciencia, para que SIGKILL llegue antes que el cuerpo:
$ time docker stop -t 1 kallpa
kallpa
real 1.226s
cliente: http=100 exit=52 Empty reply from server
$ docker inspect -f '{{.State.ExitCode}}' kallpa
137
El cliente HTTP recibió una conexión cortada: Empty reply from server.
¿Qué le pasa a la reserva?
Pregunta de examen: si SIGKILL llega mientras se está guardando una reserva, ¿qué queda? Hay que separar dos cosas.
La base de datos queda bien. SQLite escribe por transacciones, que se
confirman enteras o no se confirman. La prueba apagado.test.ts corre
ejemplos/transaccion-cortada.ts,
que hace un INSERT en una transacción y se manda SIGKILL a sí mismo, y
comprueba que al abrir la base de datos la fila no está; si confirma antes de
matarse, la fila sí está. Nunca hay una reserva a medias.
Quien reservó no sabe qué pasó. La conexión se corta, y la reserva pudo
haberse confirmado o no. Si la página reintenta, quizá se encuentre con su
propia reserva y reciba SLOT_TAKEN. Y si la transacción se confirmó y el
proceso murió antes de llamar a notifier, la reserva existe y el vecino
nunca recibió su WhatsApp. Estas son las ventanas que el apagado ordenado
cierra, por lo menos en los despliegues. El factor IX pide también lo otro: la
máquina puede morir sin avisar, así que el programa debe tolerar una muerte
súbita, y por eso importan las transacciones.
Error común. Creer que
server.closetermina en cuanto acaba la última respuesta. Termina cuando se cierran las conexiones, y hay un detalle:closecierra las conexiones inactivas al momento de llamarlo. Una conexión keep-alive (reutilizable, como las de un navegador) que estaba ocupada en ese momento queda abierta al terminar su respuesta, hasta que se vence sukeepAliveTimeout, de 5 s por omisión. Lo pruebaapagado.test.ts: la respuesta llega en menos de 1 s, y el proceso sale recién después de 4 s; en nuestra corrida, 6.3 s en total. Si su hosting solo espera unos segundos, necesitan elcloseAllConnectionsdel temporizador, o responder conconnection: closedurante el apagado.
En la industria. Apagarse bien es la mitad; la otra mitad es que no sigan llegando solicitudes. SWEG cap. 25 cuenta que en Google, cuando Borg va a mover un contenedor por mantenimiento, le avisa antes; el contenedor rechaza solicitudes nuevas mientras termina las que tiene, y el load balancer entiende esa respuesta y manda el tráfico a otra réplica. Sin un load balancer que coopere, siempre hay solicitudes que se pierden en el cambio.
Estrategias de despliegue
Reemplazar una versión por otra de golpe tiene dos costos: un momento sin servicio, y que un error llegue a todos a la vez. Las estrategias de despliegue reparten esos riesgos. Todas suponen más de una instancia detrás de algo que reparte el tráfico.
Despliegue gradual (rolling). Las instancias se reemplazan de a pocas. Si hay cuatro, se saca una, se pone la nueva, se espera a que esté sana, y se sigue. Es simple y no pide máquinas de más. Durante un rato conviven las dos versiones, y volver atrás es otro despliegue gradual.
Blue-green. Hay dos entornos completos e iguales. Uno atiende (azul); en el otro (verde) se despliega y se prueba, sin tráfico. Luego se cambia el tráfico de uno a otro en un solo paso, y se vuelve atrás con el mismo cambio. Da el rollback más rápido, y cuesta el doble de infraestructura.
Canary. La versión nueva recibe primero una parte pequeña del tráfico, por ejemplo 5 %, y se compara con la anterior: errores, latencia. Si va bien, sube el porcentaje; si no, se saca. El nombre viene del canario de los mineros, que avisaba del gas antes que nadie. Es la que más protege, y la que más pide: tráfico suficiente para que la comparación signifique algo, y métricas por versión.
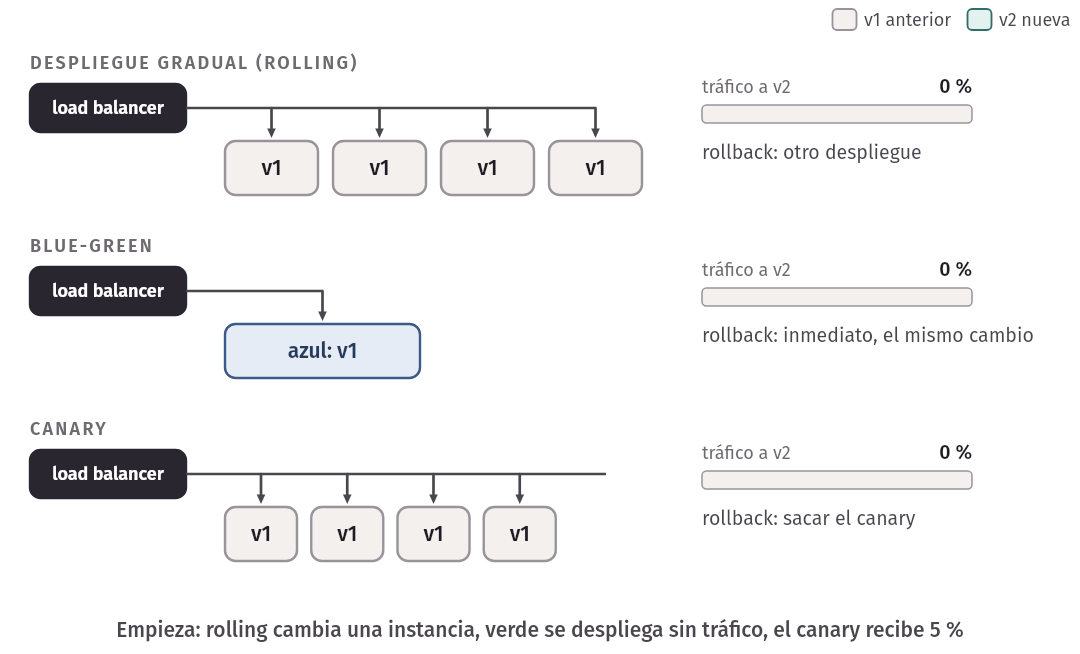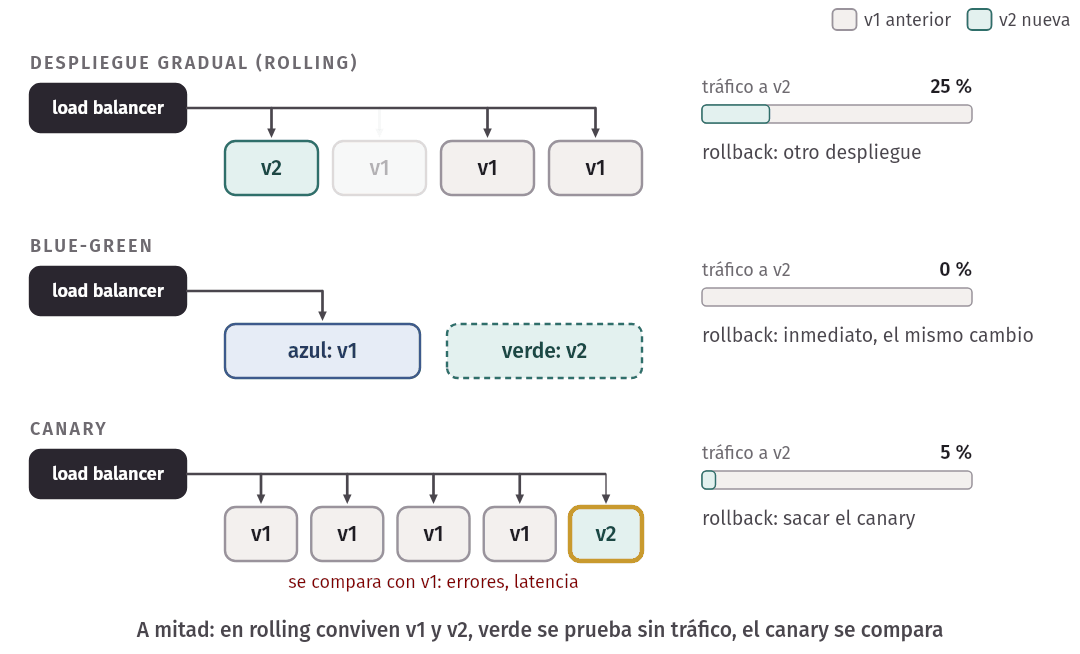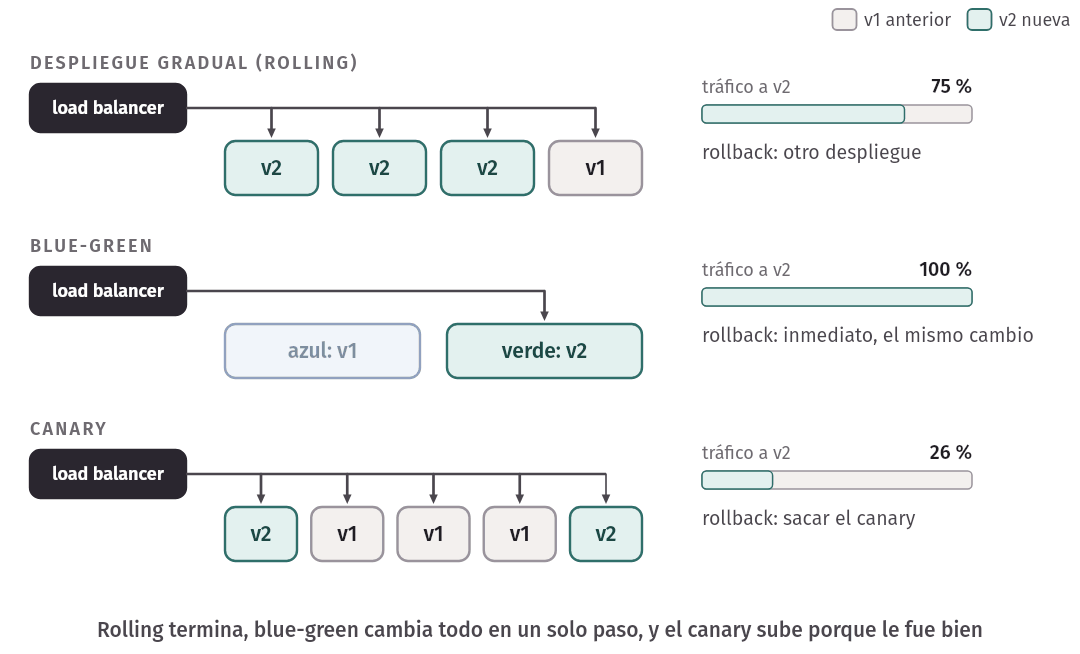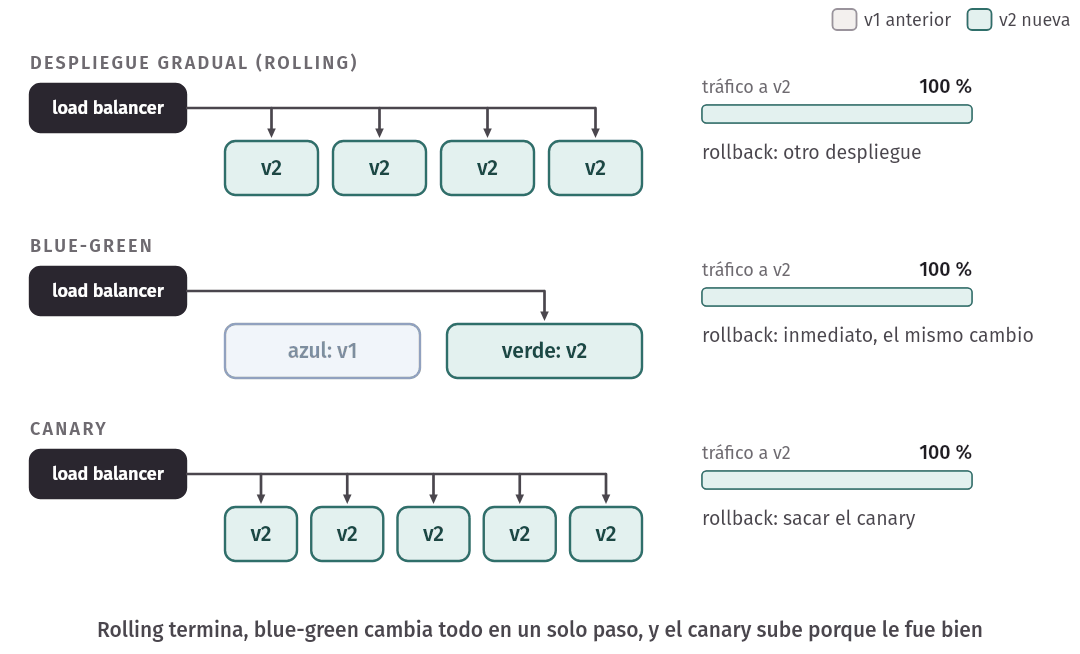
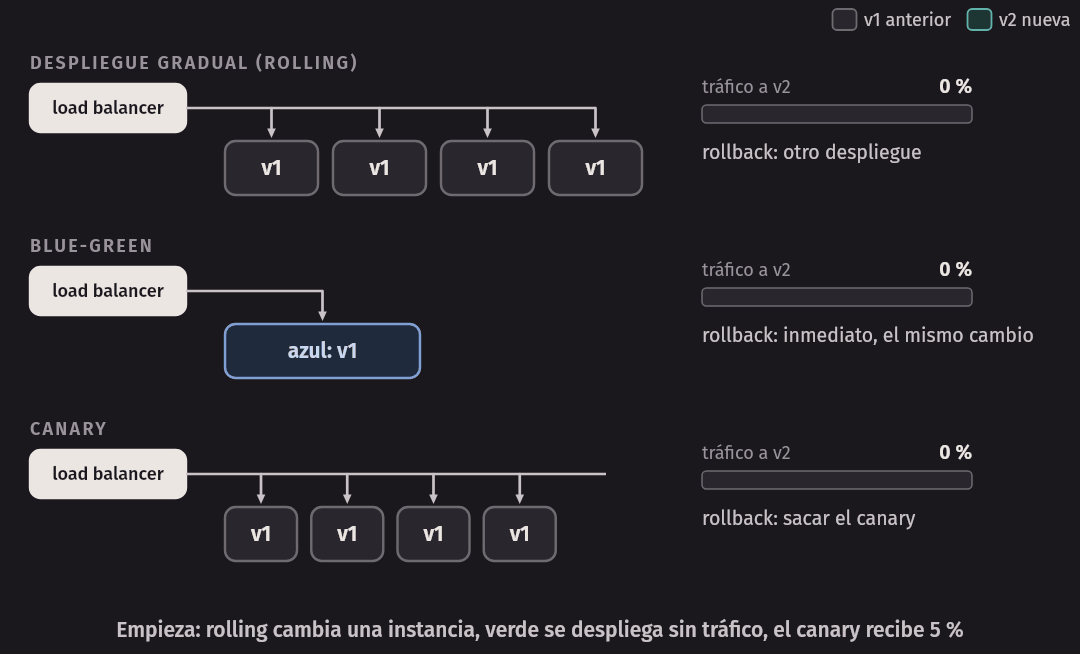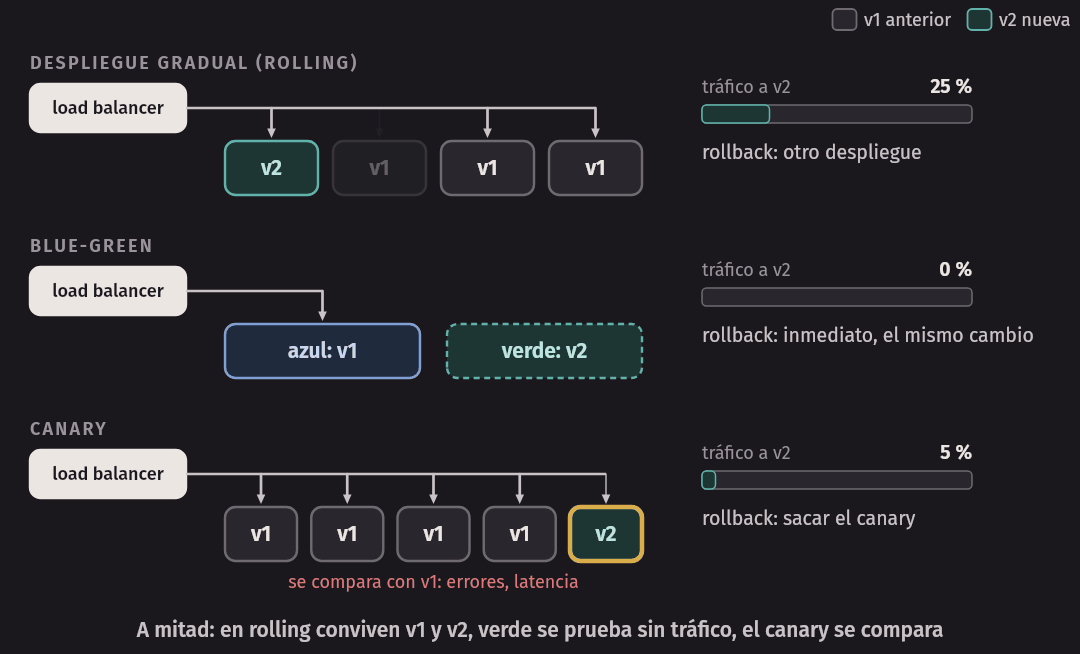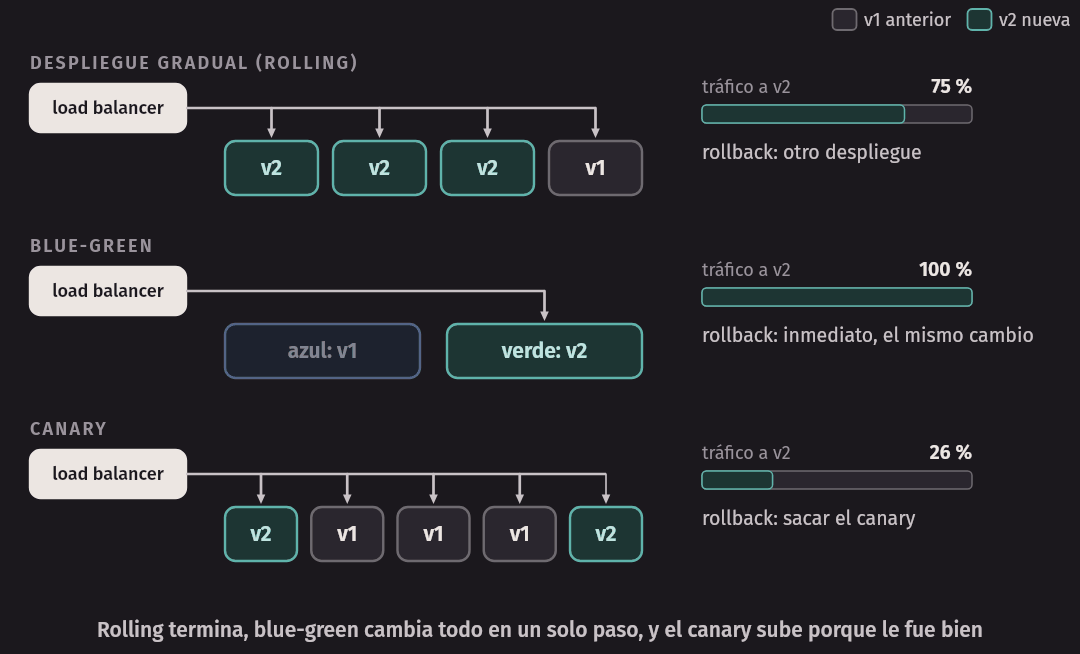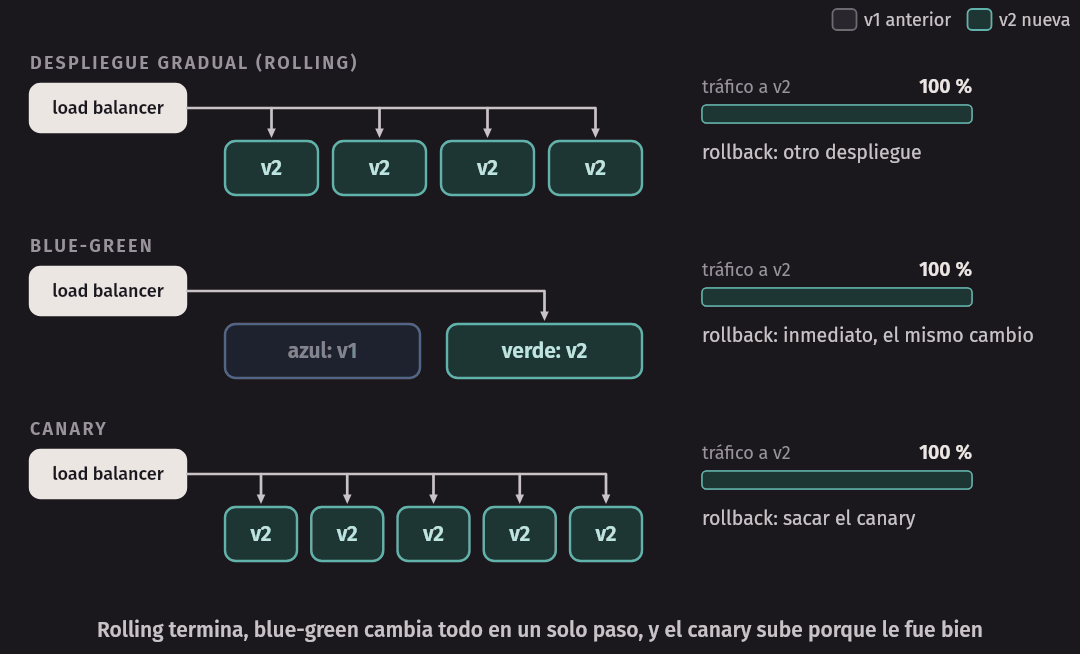
| Rolling | Blue-green | Canary | |
|---|---|---|---|
| Conviven dos versiones | Sí, un rato | No, salvo en el cambio | Sí, a propósito |
| Rollback | Otro despliegue | Inmediato | Sacar el canary |
| A cuántos afecta un error | Crece con el avance | A todos, pero se revierte rápido | A unos pocos |
| Qué necesita | Varias instancias | El doble de entorno | Métricas por versión y tráfico |
SWEG cap. 24 lo plantea como make reality your benchmark: un entorno sintético nunca se parece del todo a producción, y un despliegue por etapas hace que la realidad sea la prueba. También advierte un límite: un canary dice mucho de crashes y estabilidad, y poco de si la versión nueva es mejor; para eso hace falta un experimento A/B.
¿Y Kallpa? Tiene una sola instancia y un archivo de SQLite. En la semana 7
vieron qué pasa con dos procesos sobre el mismo archivo: aparecen errores
database is locked. Ninguna de estas estrategias se aplica sin más. Tampoco
se sostiene un canary con unas pocas solicitudes por hora, porque 5 % de casi
nada no mide nada. Con el volumen de Kallpa y un solo servidor, lo honesto es:
una instancia, cortes de pocos segundos en horas sin reservas, y un rollback
ensayado. Si el complejo creciera, primero cambiaría la base de datos, y esa
decisión va en un ADR.
Idea clave. Cualquier estrategia en la que dos versiones conviven exige que las dos entiendan la misma base de datos. Es la misma condición del rollback.
Feature flags
Un feature flag es una condición en el código que decide, en ejecución, si
una parte se activa. Hace algo que parece imposible: separar desplegar (el
código está en producción) de lanzar (la gente lo usa). Un cambio a medio
terminar puede ir a main y a producción, apagado, sin una feature branch de
varias semanas.
if (config.bookingsOpen) {
  // ...
}
Pete Hodgson los clasifica por dos ejes: cuánto duran y qué tan dinámica es la decisión.
| Tipo | Para qué | Duración | Decisión |
|---|---|---|---|
| Release | Esconder algo a medio terminar | Corta: “una o dos semanas”, dice Hodgson, aunque los de producto duran más | Muy estática |
| Experimento | Comparar variantes (A/B) | De horas a semanas: lo justo para un resultado significativo | Por solicitud |
| Operación | Apagar algo caro o roto sin desplegar. Los de larga vida se llaman kill switch | Mayormente corta, algunos casi para siempre | Se cambia rápido |
| Permisos | Dar acceso a algunos usuarios (socios, pruebas internas) | Larga | Por solicitud |
Para Kallpa: uno de release sería KALLPA_FIXED_BOOKINGS, mientras se termina
una funcionalidad de turnos fijos; uno de experimento compararía dos textos
del botón de reservar; uno de operación es KALLPA_BOOKINGS_OPEN, el del
laboratorio, para dejar de aceptar reservas si algo anda mal, sin dejar de
mostrar la disponibilidad; uno de permisos abriría las reservas una semana
antes solo a los socios.
Con la imagen de la solución, sin construir otra:
$ docker run -d --name kallpa -p 8080:3000 -e KALLPA_BOOKINGS_OPEN=false kallpa
e934624cb4170adeb057e4ec1b1eb17f3c615d567a28c0c760664123bc573102
$ curl -s -o /dev/stdout -w '\n%{http_code}\n' -X POST localhost:8080/api/bookings -H 'content-type: application/json' -d '{"courtId":3,"memberId":2,"date":"2026-11-05","startHour":8,"hours":1,"teamName":"Las de Prueba"}'
{"error":{"code":"BOOKINGS_CLOSED","message":"Las reservas están suspendidas por el momento."}}
503
$ curl -s -w '\n%{http_code}\n' 'localhost:8080/api/courts/3/availability?date=2026-11-05' | cut -c1-60
{"courtId":3,"date":"2026-11-05","slots":[{"hour":7,"availab
200
Un detalle que señala Hodgson: una variable de entorno es la forma más simple,
pero cambiarla exige un re-despliegue o, por lo menos, reiniciar el proceso. En
Docker es lo primero: docker restart conserva el entorno del contenedor, así
que cambiar KALLPA_BOOKINGS_OPEN significa docker rm y otro docker run,
con la misma imagen y el mismo -v. Es justo la operación en la que se puede
olvidar el volumen. Para un flag de operación, que debería cambiar en segundos,
esto alcanza en Kallpa si el comando está en un script; en un sistema con
cientos de procesos no alcanza, y por eso existen servicios de configuración.
SWEG cap. 24 agrega que prender un flag para todos de una vez tampoco es buena
idea: los cambios de flag también se despliegan con cuidado.
Error común. Dejar los flags para siempre. Cada flag es una rama más en el código: dos flags son cuatro combinaciones, diez son más de mil. Hodgson los llama inventario con un costo de mantenimiento, y recomienda tratarlos así: cada uno tiene owner y una fecha para retirarse, y hay equipos que agregan la tarea de quitarlo al crearlo. Un flag de release que lleva un año prendido es código muerto con un
ifdelante.
Con IA. Un agente que despliega es un agente con acceso a producción. Se aplican las mismas reglas que para una persona, y más estrictas: despliega por el pipeline y no por un atajo; tiene los permisos mínimos; pasa por revisión; y hay un rollback probado. Las credenciales de producción no entran en su contexto, porque lo que entra en el contexto puede salir por otro lado (semana 14). Un
Dockerfileo un workflow propuesto por un agente se lee línea por línea, igual que cualquier otro cambio, y los errores de este capítulo son justo los que undocker runfeliz no muestra: un cambio como los que suele proponer un agente corre como root, usaCMD npm starty termina con unCOPY . .. Funciona y pasa las pruebas. Lo que lo delata es medir:id,docker stop,docker logs.
Qué está pasando allá adentro
Con eso termina la primera parte. Kallpa corre en un contenedor, sobrevive a un despliegue y se apaga bien. Ahora hay que saber si le está yendo bien.
Observabilidad y telemetría
Observabilidad es la capacidad de responder preguntas sobre lo que hace un sistema desde afuera, a partir de lo que emite, sin cambiarlo. Lo que emite se llama telemetría, y es de tres tipos:
- Logs: eventos individuales. “A las 19:04 falló este
POST.” Sirven para investigar un caso concreto, y pesan más. - Métricas: números agregados en el tiempo. “142 solicitudes por minuto, 2 % de error.” Son baratas, y sirven para alertar y para ver tendencias. No dicen cuál solicitud.
- Traces: el recorrido de una solicitud por varios servicios, con cuánto tardó en cada uno. Kallpa tiene un solo proceso: para ella casi no aplican, y en un sistema con diez servicios son la única forma de saber dónde se fue el tiempo.
OpenTelemetry es un estándar abierto y un conjunto de herramientas para generar, recolectar y exportar los tres. Él mismo aclara lo que no es: no es un backend de observabilidad, no guarda ni muestra los datos. Evita casarse con un proveedor: se instrumenta una vez, y se cambia adónde se manda.
Logs estructurados
Esta es la línea que escribe la Kallpa publicada por cada solicitud:
GET /api/courts 200Se puede leer, pero no se puede preguntar nada sin expresiones regulares, y no dice ni a qué hora fue. Un log estructurado es una línea JSON con campos fijos:
{"time":"2026-11-02T06:10:47.116Z","level":"info","msg":"request","method":"POST","path":"/api/bookings","status":200,"durationMs":10}Se puede filtrar y agregar. En
ejemplos/kallpa-muestra.txt
está el log real de una corrida de la solución, con una mezcla de solicitudes
buenas y malas que manda
ejemplos/trafico.sh:
$ grep '^{' kallpa-muestra.txt | jq -r 'select(.msg=="request") | .status' | sort | uniq -c
     57 200
      1 400
      1 404
      2 409
      1 422
      3 500
$ grep '^{' kallpa-muestra.txt | jq -r 'select(.status>=500) | .path' | sort | uniq -c
      2 /api/courts/%ZZ/availability
      1 /api/members/%ZZ/bookings
$ grep '^{' kallpa-muestra.txt | jq -c 'select(.level=="error") | {time,path,error}' | head -1
{"time":"2026-11-02T06:15:17.512Z","path":"/api/courts/%ZZ/availability","error":"URI malformed"}
En tres líneas sabemos cuántos errores hubo, en qué rutas, a qué hora
empezaron y por qué. Sale un dato más: los errores de la semana 9 siguen allí,
y por primera vez se ven desde afuera. El grep '^{' deja solo las líneas
JSON, porque en el archivo hay otras: la del comando de make y los avisos
por WhatsApp.
Las reglas prácticas de un log:
- A stdout. La aplicación no decide adónde van sus logs. Es el factor XI
de doce factores, y es lo que hace funcionar
docker logs. - Campos fijos y un nivel (
info,warn,error).timeen UTC e ISO 8601. - Un identificador de solicitud (
requestId) cuando una solicitud escribe varias líneas, para poder juntarlas. - Nada personal ni secreto. Ni contraseñas, ni tokens, ni el celular de un vecino. Los logs se copian, se guardan más tiempo que los datos y los lee más gente.
Error común. Lean la línea de los WhatsApp de ese mismo log:
[whatsapp] para 912345678: Hola Luis Huamán Torres, tu reserva de Vóley el 2026-11-05 de 10:00 a 11:00 está confirmada. Total: S/ 45.00.Celular, nombre y reserva, todo en el log. En Kallpa es un simulador del canal (el complejo aún no tiene WhatsApp Business), y sus datos son de ejemplo; en producción, esa línea es una fuga de datos personales. Por eso el laboratorio pide logs sin datos personales y filtra con
grep '^{'; en su proyecto, esa línea no debe existir.
Un endpoint de salud
GET /health responde rápido si el servicio puede atender. Lo usan el
HEALTHCHECK de Docker, el load balancer, el monitor externo y la prueba de
humo después de un despliegue. Por eso no debe hacer trabajo caro ni pedir
autenticación.
$ curl -s localhost:8080/health; echo
{"status":"ok"}
¿Qué debe revisar? Hay dos preguntas distintas: ¿el proceso está vivo? y
¿puede atender? Si solo responde {"status":"ok"} sin mirar nada, contesta la
primera. P4 pide la segunda: que revise lo que la aplicación necesita (SELECT 1 en la base de datos) y responda 503 si no puede. Pero eso tampoco es
todo. No conviene que revise servicios de terceros, porque si se cae el
proveedor de WhatsApp, reiniciar Kallpa no arregla nada.
El HEALTHCHECK del Dockerfile corre un comando dentro del contenedor cada
cierto tiempo. La imagen slim no tiene curl, así que se le pregunta al
propio Node:
HEALTHCHECK --interval=5s --timeout=2s --start-period=5s --retries=3 \
  CMD ["node", "-e", "fetch('http://localhost:3000/health').then(r => process.exit(r.ok ? 0 : 1), () => process.exit(1))"]
Por omisión revisa cada 30 s, y el primer healthy tardaría medio minuto; por
eso se bajó el intervalo. Medido segundo a segundo:
$ docker run -d --name kallpa -p 8080:3000 -v kallpa-data:/app/data kallpa
395314bcf008c356bb6e2a7bc8745e2215b0b59733a0acb9624e6dc6582f6d0e
$ for i in 1 2 3 4 5 6 7 8; do echo "t=$((i-1))x1s $(docker inspect --format '{{.State.Health.Status}}' kallpa)"; sleep 1; done
t=0x1s starting
t=1x1s starting
t=2x1s starting
t=3x1s starting
t=4x1s starting
t=5x1s healthy
t=6x1s healthy
t=7x1s healthy
Error común. Creer que un contenedor
unhealthyse reinicia. En Docker solo, no: elHEALTHCHECKcambia una etiqueta y nada más. Lo comprobamos con un chequeo que siempre falla y la política de reinicio más agresiva:$ docker run -d --restart=always --name kallpa -p 8080:3000 --health-cmd='exit 1' --health-interval=1s --health-retries=2 --health-start-period=1s kallpa 56acbc51229e0624a8e61622e40b640d8d41b9288e9ca6295b290ffe9d100a6e $ docker inspect -f 'status={{.State.Status}} health={{.State.Health.Status}} restarts={{.RestartCount}}' kallpa status=running health=unhealthy restarts=0Reiniciar por salud lo hace otra cosa: Docker Swarm, que sí usa este
HEALTHCHECK; Kubernetes, con sus propias liveness probes; o su hosting.--restartsolo mira si el proceso terminó.
Un pedido que apaga el servidor
Kallpa tiene un error real que nos sirve para todo lo que sigue. Un solo pedido apaga el proceso entero:
$ curl -s --path-as-is localhost:3000//; echo "curl salio con $?"
curl salio con 52
$ curl -s localhost:3000/api/courts; echo "curl salio con $?"
curl salio con 7
El 52 es “respuesta vacía” y el 7, “no se pudo conectar”. El log dice por qué:
node:internal/url:911
      href = bindingUrl.parse(input, base, true);
                        ^

TypeError: Invalid URL
    at new URL (node:internal/url:911:25)
    at Server.<anonymous> (file:///tmp/pub/src/http/server.ts:49:17)
    at Server.emit (node:events:514:20)
    at parserOnIncoming (node:_http_server:1464:12)
    at HTTPParser.parserOnHeadersComplete (node:_http_common:125:17) {
  code: 'ERR_INVALID_URL',
  input: '//',
  base: 'http://localhost'
}

Node.js v26.13.0
make: *** [Makefile:22: start] Error 1
En src/http/server.ts, new URL está fuera del try. La función que
atiende cada solicitud es async: su error es una promesa rechazada que nadie
maneja, y ante eso Node termina el proceso. Un pedido mal formado, de
cualquiera, y el servicio se cae. En la semana 15 lo vemos como un ataque. Hoy
importa otra cosa: el proceso murió, y nada se entera. En un contenedor
sin política de reinicio, así queda:
$ docker inspect -f 'status={{.State.Status}} exit={{.State.ExitCode}} restarts={{.RestartCount}}' kallpa
status=exited exit=1 restarts=0
Y con --restart=on-failure, Docker lo levanta:
$ docker run -d --restart=on-failure --name kallpa -p 8080:3000 kallpa
eefba3e5c18e34c08cc9ec7a67ef75904b89f8c907a4bde1805a713831d636f2
$ curl -s --path-as-is localhost:8080// ; echo "curl salio con $?"
curl salio con 52
$ docker inspect -f 'status={{.State.Status}} exit={{.State.ExitCode}} restarts={{.RestartCount}}' kallpa
status=running exit=0 restarts=1
$ curl -s localhost:8080/health; echo
{"status":"ok"}
Un reinicio automático es una mitigación, no un arreglo: el error sigue, y sin vigilar el contador de reinicios se vuelve invisible. Lo vamos a medir, y lo retomamos con el postmortem.
Las cuatro señales doradas
¿Qué conviene mirar? El capítulo 6 del libro de SRE propone cuatro señales: “si solo pueden medir cuatro métricas, midan estas”.
- Latencia: cuánto tarda atender una solicitud. Separando la de las buenas
de la de los errores: un
500rápido baja el promedio y hace ver mejor al servicio, y un error lento es peor que uno rápido. - Tráfico: cuánta demanda hay, en solicitudes por segundo o lo que tenga sentido para el servicio.
- Errores: la proporción de solicitudes que fallan, ya sea explícitamente
(un
500), implícitamente (un200con contenido equivocado) o por política (si prometieron un segundo, lo que tarda más es un error). - Saturación: qué tan lleno está el servicio, en el recurso más escaso. Muchos sistemas empeoran antes de llegar al 100 %.
Para Kallpa, un proceso de Node con una base de datos síncrona, la saturación es el event loop: mientras corre una consulta no se atiende nada más, y el disco del volumen, donde crece el archivo.
El mismo capítulo distingue síntomas de causas. El síntoma es qué se rompió (“las reservas responden 500”); la causa, por qué (“el disco se llenó”). Se alerta por síntomas, porque son lo que vive el usuario y porque cubren causas que no anticiparon. Una alerta de “CPU al 80 %” despierta a alguien aunque ningún vecino note nada, y nunca avisará de una causa que nadie imaginó.
Error común. Medir lo que es fácil. Un servidor que responde
200en/healthmientras todas las reservas fallan está “arriba” para el monitoreo y caído para los vecinos. El capítulo 4 del libro de SRE lo dice al revés: empiecen por lo que les importa a sus usuarios, no por lo que pueden medir.
SLIs, SLOs y SLAs
Definiciones
Tres siglas que suenan igual y responden tres preguntas distintas.
Un SLI (service level indicator) es una medida cuantitativa, bien definida, de un aspecto del servicio. ¿Cuánto? The Site Reliability Workbook recomienda escribirlo siempre igual, como una proporción:
SLI = eventos buenos / eventos válidosAsí el SLI siempre va de 0 % (nada funciona) a 100 % (nada falla), y todas las herramientas sirven para todos. Dos ejemplos para Kallpa:
- Disponibilidad: solicitudes a
/api/*que no responden 5xx, sobre todas las solicitudes a/api/*. - Latencia:
POST /api/bookingsexitosos en menos de 300 ms, sobre todos los exitosos.
Fíjense en lo que queda fuera. Un 409 SLOT_TAKEN o un 422 son buenos:
el sistema hizo lo que debía, porque el error es del pedido. /health no es
válido, porque ningún vecino lo pide y adornaría el número.
Un SLO (service level objective) es un objetivo sobre un SLI en una
ventana: “99.5 % de las solicitudes a /api/* sin 5xx, en 30 días”. Es
interno, y es una decisión de producto tanto como técnica.
Un SLA (service level agreement) es un contrato con consecuencias si no se cumple: una multa, una devolución. La prueba, según el libro de SRE: “¿qué pasa si no se cumple?”. Si no hay una consecuencia explícita, es un SLO. Por eso un SLA razonable promete menos que el SLO interno; así hay margen para reaccionar antes de pagar. El libro recomienda ese margen, aunque no es una ley: lo que manda es lo que firmaron. Kallpa no tiene SLA con nadie. Sí puede tener SLOs.
Idea clave. SLI: qué mido. SLO: cuánto quiero. SLA: qué pago si no llego.
Calcular un SLI con los logs
Con el log del ejemplo. El conteo rápido del laboratorio es este:
$ grep '^{' kallpa-muestra.txt | jq -s '{total: length, errores: map(select(.status >= 500)) | length}' -c
{"total":72,"errores":3}
Sirve para empezar, pero hay que mirar qué cuenta. total son todas las
líneas JSON, no solo las solicitudes:
$ grep '^{' kallpa-muestra.txt | jq -r .msg | sort | uniq -c
      1 listening
      1 new database, sample data loaded
     65 request
      1 shutting down
      1 stopped
      3 unhandled error
Entre las 72 hay arranques, apagados y los 3 errores contados una vez más. Y
de las 65 solicitudes, algunas son /health o la página. Para el SLI que
definimos, el filtro es ejemplos/sli.jq:
# El SLI de disponibilidad: solicitudes a /api/* que no responden 5xx.
map(select(.msg == "request" and (.path | startswith("/api/"))))
| { validas: length, buenas: (map(select(.status < 500)) | length) }
| . + { sli: (.buenas / .validas) }
$ grep '^{' kallpa-muestra.txt | jq -s -c -f sli.jq
{"validas":43,"buenas":40,"sli":0.9302325581395349}40 de 43, 93 %. Es tráfico de prueba, con errores a propósito, y no dice nada
del mes de Kallpa; dice que la definición se puede calcular. También dice una
limitación: un log del servidor solo ve lo que le llega. Si el proceso
está caído, no hay línea, y el SLI sale perfecto. En la corrida del //, el
log no registra ninguna de las solicitudes que fallaron. Por eso un SLI serio
se mide también desde afuera (el libro de SRE lo llama medir en el cliente), y
por eso el monitor externo.
La muestra también permite el otro SLI: los 6 POST exitosos tardaron como
máximo 6 ms, así que todos pasan los 300 ms. Con 6 datos eso es solo un
ejemplo. Y un detalle sobre medir tiempos: el libro prefiere percentiles al
promedio, porque un promedio esconde una cola lenta. “El 99 % en menos de 300
ms” dice más que “300 ms en promedio”. Además, durationMs se mide en el
servidor: no incluye la red ni la página.
Presupuesto de errores
El presupuesto de errores es lo que el SLO permite fallar: 1 − SLO. Con 99.5 % es 0.5 %. El libro de SRE define la idea en el cap. 3: con un SLO de 99.999 % en un trimestre, un problema que hace fallar 0.0002 % de las consultas gasta 20 % del presupuesto.
Las cuentas para Kallpa, que comprueba
presupuesto.test.ts. En tiempo:
0.005 × (30 × 24 h) = 0.005 × 720 h = 3.6 hPero eso solo vale para indisponibilidad total. En solicitudes, con unas 20 000 al mes:
0.005 × 20 000 = 100 solicitudesCada nueve adicional divide el presupuesto entre 10:
| SLO | Permite, en 30 días |
|---|---|
| 99 % | 7.2 h |
| 99.5 % | 3.6 h |
| 99.9 % | 43.2 min |
| 99.99 % | 4.32 min |
Para qué sirve. Antes de esto, desarrollo quiere desplegar y operación quiere que no se toque nada, y la discusión es de opiniones. El presupuesto vuelve el asunto una cuenta: mientras queda presupuesto, se despliega; si se acaba, se prioriza la confiabilidad. Un despliegue malo que produce 150 errores gastó 150 % del presupuesto del mes: el equipo para las funcionalidades y arregla. Eso se pacta antes, en una política de presupuesto de errores. El Workbook dice que conseguir que la aprueben producto, desarrollo y operación es una buena prueba de que el SLO está bien puesto.
Por qué no 100 %. Un SLO de 100 % es un error por tres razones. Es inalcanzable, porque ninguna dependencia lo cumple: ni la red del vecino. Deja un presupuesto de cero, así que cualquier cambio queda congelado. Y el vecino no distingue 99.99 % de 100 %, porque su propio WiFi falla mucho más. Pagar por nueves que nadie nota sale caro.
Elegir el objetivo
El cap. 4 da una lista de lecciones. Las que importan para un equipo chico:
- No lo elijan por el desempeño actual. Quizá el sistema actual requiera heroísmos para sostener ese número.
- Que sea simple. Las agregaciones complicadas esconden cambios.
- Eviten lo absoluto. “Siempre disponible” no es un objetivo.
- Tengan pocos. Si un SLO nunca decide una discusión de prioridades, sobra.
- La perfección puede esperar. Mejor empezar flojo y apretar que tener que aflojar después.
Para un producto como Kallpa, con un solo servidor, 99.5 % ya implica cuidar los despliegues. Lo sensato es elegirlo con la administración. ¿Qué tan grave es que la página no ande a las 3 de la mañana? ¿Y un sábado a las 6 de la tarde? El SLO no sabe de horas punta, y un número promedio puede esconder justo la hora que importa.
En la industria. El cap. 4 cuenta una historia contraintuitiva, la del servicio Chubby de Google. Era tan confiable que otros equipos empezaron a depender de él asumiendo que nunca caía, y sus raras caídas se volvían incidentes visibles para los usuarios. La respuesta del equipo de SRE: si en un trimestre no hubo una falla real que bajara la disponibilidad al objetivo, lo apagan a propósito, para que salgan a la luz esas dependencias. Un servicio demasiado bueno también genera deuda. Es un relato de una empresa con esa escala, no un consejo para Kallpa, y resume bien la idea: el SLO es un objetivo, no un piso a superar.
Alertar por lo que se quema
Si el SLO es lo que importa, se alerta cuando está en peligro. El Workbook, en su capítulo Alerting on SLOs, define la velocidad de quemado (burn rate): qué tan rápido, respecto al SLO, se gasta el presupuesto. Con velocidad 1, se acaba justo al final de la ventana. Es la tasa de error observada dividida entre la permitida. Con SLO 99.5 %:
| Tasa de error | Velocidad de quemado | El presupuesto de 30 días dura |
|---|---|---|
| 0.5 % | 1 | 30 días |
| 5 % | 10 | 3 días |
| 100 % | 200 | 3.6 h |
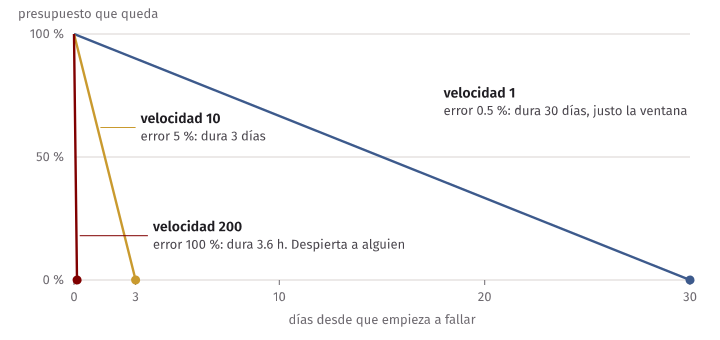
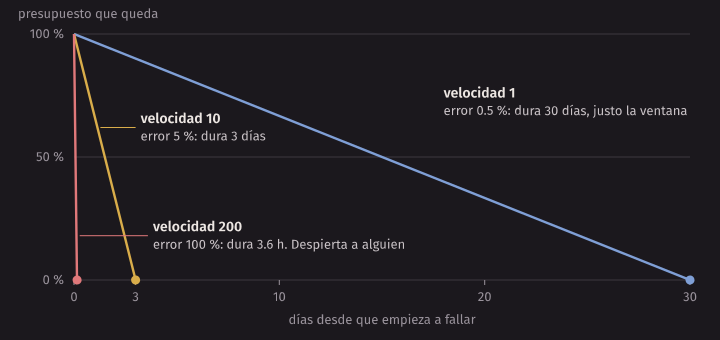
Una caída total a 200 de velocidad merece despertar a alguien; 0.6 % sostenido merece un ticket. Como punto de partida para avisar a una persona, el Workbook recomienda gastar 2 % del presupuesto en una hora (velocidad 14.4) o 5 % en seis horas. Quien recibe ese aviso es la persona on-call, la que está de guardia en ese turno. La regla es la misma que para una prueba: una alerta debe sonar solo cuando se viola algo que importa, porque una que suena de más termina ignorada.
Con una advertencia que Kallpa cumple de lleno. Esos métodos suponen tráfico
abundante, y el mismo capítulo tiene una sección sobre servicios de poco
tráfico. Con 20 000 solicitudes al mes son unas 28 por hora: una sola
solicitud fallida en una hora es 3.6 % de error y 1 % del presupuesto
entero. Una alerta por tasa de error saltaría por un solo vecino con mala
suerte. Para Kallpa, un monitor externo que revise /health y haga una
reserva de prueba de vez en cuando da más señal que cualquier fórmula.
Incidentes
Qué es, y qué se hace primero
Un incidente es algo que afecta a los usuarios y requiere una respuesta
coordinada. No todo error es un incidente: el 500 de una ruta rara se
arregla con un issue, y una caída de las reservas un sábado por la tarde hace
dejar todo lo demás.
Cuando uno está en medio del incidente, con la administradora al teléfono, se tiende a hacer todo a la vez. Por eso se reparten roles, aunque el equipo sea de tres. Es la versión mínima de lo que el cap. 14 del libro de SRE describe para equipos grandes:
- Quien coordina: decide qué se hace y quién lo hace. No toca nada.
- Quien investiga: mira los logs, prueba, ejecuta.
- Quien comunica: le cuenta a la administración qué se sabe y cuándo habrá novedades.
Y el orden importa: primero se mitiga, después se entiende. Mitigar es
detener el daño: un rollback, apagar un flag, un docker start. Investigar la
causa viene después, sin apuro, con el servicio arriba. Si hay un despliegue
reciente, sospechen de él primero y vuelvan atrás: es la mitigación más
barata, y por eso importa tenerla ensayada.
Error común. Mitigar y borrar la evidencia. Un
docker rm -fpara “empezar de cero” borra la capa escribible y, si no los copiaron, los logs. Antes de reemplazar un contenedor enfermo, guardendocker logsy, si puede tener datos, copien los datos condocker cp. Treinta segundos, y evitan que el postmortem se escriba de memoria.
El game day
No hace falta esperar. Un game day es un incidente provocado a propósito, en un entorno controlado, para ver cómo responde el equipo: si el monitor avisa, si los logs alcanzan, si el rollback funciona. El libro de SRE cuenta un ejercicio parecido, la Wheel of Misfortune, donde se recrea un postmortem viejo con personas nuevas en los roles.
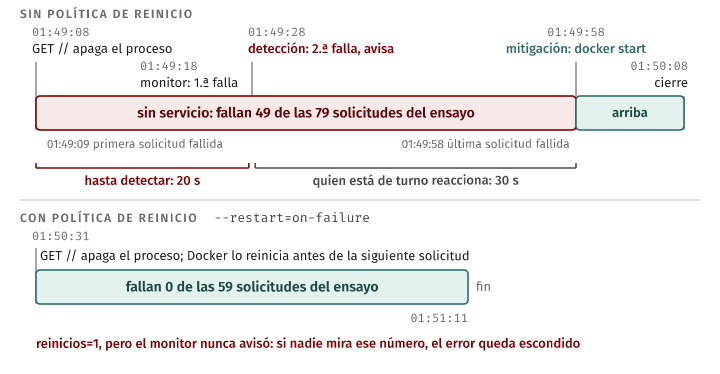
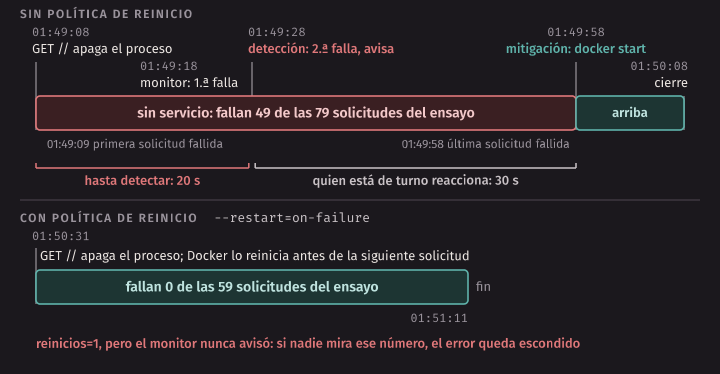
El script ejemplos/game-day.sh hace
uno chico con el error de //: manda una solicitud por segundo, derriba el
proceso y lo vigila con un monitor que revisa /health cada 10 s y avisa a la
segunda falla. Se simula una persona que tarda 30 s en reaccionar. Primero sin
política de reinicio:
$ ejemplos/game-day.sh kallpa
01:49:08 se manda el pedido que tumba el proceso
01:49:18 el monitor ve /health caído (1)
01:49:28 el monitor ve /health caído (2)
01:49:28 el monitor avisa a quien está de turno
01:49:58 docker start
01:50:08 fin del ensayo
estado=running reinicios=0
solicitudes: 79, fallidas: 49
primera falla: 01:49:09 000, última falla: 01:49:58 000
arranques en el log: 2
Y con --restart=on-failure:
$ ejemplos/game-day.sh kallpa --restart=on-failure
01:50:31 se manda el pedido que tumba el proceso
01:51:11 fin del ensayo
estado=running reinicios=1
solicitudes: 59, fallidas: 0
primera falla: , última falla:
arranques en el log: 2
De 49 solicitudes fallidas a ninguna, con una opción en un comando. Lean el
resultado con cuidado: el reinicio tardó menos que el segundo que hay entre
dos solicitudes, así que este tráfico no alcanzó a verlo. La solicitud que
tumbó el proceso sí falló, y también fallarían las que estuvieran en curso. Y
el monitor nunca avisó: si nadie mira reinicios=1, el error queda vivo y
escondido.
El postmortem
Un postmortem es un registro escrito de un incidente: su impacto, lo que se hizo para mitigarlo, sus causas y las acciones para que no se repita (SRE cap. 15). Sin un proceso así, dice el capítulo, los incidentes se repiten indefinidamente.
¿Cuándo se escribe? Se decide antes del incidente. El libro lista razones comunes: caída o degradación visible más allá de un umbral, pérdida de datos de cualquier tipo, una intervención manual de quien está de guardia (como un rollback), un tiempo de resolución largo y una falla de monitoreo (que un humano lo haya descubierto antes que la alarma).
Sin culpables (blameless). Es la parte más difícil, y la definición es precisa: el postmortem busca las causas que contribuyeron sin acusar a una persona o equipo por un comportamiento malo. Supone que todos tuvieron buenas intenciones e hicieron lo correcto con la información que tenían. No es por amabilidad, sino por dos razones prácticas. Si hay castigo, la gente esconde los problemas, y sin información no se aprende. Y como dice el capítulo: no se puede “arreglar” a las personas, pero sí los sistemas y los procesos que las ayudan a tomar buenas decisiones.
| En vez de | Escriban |
|---|---|
“Pedro olvidó el -v.” |
“El comando de despliegue se escribe a mano, y nada comprueba que incluya el volumen.” |
| “Fue un error humano.” | “Un solo comando puede reemplazar producción sin revisión, y el monitor no lo detecta.” |
| “No revisaron bien.” | “La revisión no incluye el script de despliegue, porque no está en el repositorio.” |
“Error humano” nunca es la causa raíz: es el punto en que empieza la pregunta. ¿Por qué el sistema lo permitió? ¿Por qué nada lo detectó? Por eso el template habla de roles, no de nombres.
Sin culpables no significa sin responsables: cada acción tiene un owner. Y el capítulo de SRE dice que un postmortem no revisado es como si nunca hubiera existido: pasa por personas con experiencia, que preguntan si la causa llegó lo bastante hondo, si el impacto está completo y si el plan de acción es razonable. También cuenta cómo se premia lo correcto: en una reunión general de Google, un ingeniero cuyo cambio tumbó un servicio crítico durante cuatro minutos, y que lo revirtió de inmediato, recibió bonos de sus compañeros y un aplauso en esa reunión.
Idea clave. La acción “tener más cuidado” no es una acción. No se puede comprobar, no tiene fecha y se olvida. Una acción es algo que después se puede señalar: un script, una prueba, una alerta.
Un postmortem completo
Este es el postmortem de nuestro game day, tal cual está en
ejemplos/2026-11-02-proceso-caido.md.
materiales.test.ts comprueba que pasa la regla P4-POSTMORTEM de la
revisión de P4.
Postmortem: un pedido mal formado apaga Kallpa
Tipo: game day
Lo provocamos con
ejemplos/game-day.shen una computadora de desarrollo, con una imagen de Kallpa que ya tiene/healthy logs JSON. Las horas son de Lima. El tráfico es de una solicitud por segundo, generado por el mismo script.Resumen
Una sola solicitud con la ruta
//apagó el proceso de Kallpa, y la página dejó de responder durante 50 segundos. El contenedor quedó detenido, y nada lo reinició hasta que una persona corriódocker start. No se perdieron datos.Impacto
- Indisponibilidad total: de 01:49:08 a 01:49:58, 50 segundos.
- Solicitudes: fallaron 49 de 79 (
grep -c ' 000$'sobre el registro de llamadas del script), además de la que causó la caída.- Presupuesto: con el SLO de 99.5 % y 20 000 solicitudes al mes, el presupuesto es de 100; este episodio gastaría 49. Es una cuenta gruesa: en el mes real no llega una solicitud por segundo, y en la noche fallarían menos.
- Datos: ninguno perdido. La base de datos está en un volumen y las transacciones ya confirmadas no dependen del proceso.
Línea de tiempo
Hora Qué pasó 01:49:08 Empieza: llega GET //.new URLlanza un error, el proceso termina con código 101:49:09 Primera solicitud fallida de los vecinos 01:49:18 El monitor ( /healthcada 10 s) ve la primera falla01:49:28 Detección: segunda falla seguida, el monitor avisa, 20 s después del inicio 01:49:58 Última solicitud fallida 01:49:58 Mitigación: quien está de turno corre docker start01:50:08 Cierre: termina el ensayo con el contenedor arriba Causa raíz
Inmediata: en
src/http/server.ts,new URL(req.url, ...)está fuera deltry. La función del servidor esasync, así que el error se vuelve una promesa rechazada que nadie maneja, y Node termina el proceso.Del proceso:
- Las pruebas no mandan rutas mal formadas al servidor: las del router tienen rutas válidas, y
new URLse ejecuta antes de llegar al router.- El despliegue no tiene política de reinicio: un proceso que termina se queda terminado. El
HEALTHCHECKno cubre esto: solo cambia una etiqueta.- El monitoreo detectó en 20 s, pero el aviso dependía de que una persona lo viera.
Lo que salió bien: el monitor sí mira algo que ven los usuarios, y
docker logstenía el stack trace completo. Lo que tuvo suerte: la base de datos estaba en un volumen; si esa misma persona hubiera recreado el contenedor con otro comando, el problema habría sido otro.Acciones
Acción Tipo Owner Fecha Estado Mover new URLdentro deltryy agregar una prueba que mandeGET //y compruebe que responde un error 4xx y que el servidor sigue arribaevita backend 2026-11-06 pendiente Levantar el contenedor con --restart=on-failureen el script de despliegue; repetir el game day y comprobar que no fallan más de 2 solicitudesmitiga quien despliega 2026-11-06 hecho: 0 de 59 fallidas, 1 reinicio Avisar cuando RestartCountsuba: un reinicio automático esconde el error si nadie lo miradetecta operación 2026-11-13 pendiente
Tres cosas para copiar en el suyo:
- Las horas salen de un registro, no de la memoria, y la detección es una fila aparte. La distancia entre “empieza” y “detección” es lo primero que un postmortem debe poder responder.
- La causa raíz tiene dos pisos. Una línea de código (lo inmediato) y lo que permitió que llegara a producción y se quedara (el proceso). Si solo tienen el primero, el error siguiente será otro y no habrán aprendido nada.
- Las acciones se clasifican: una que evita, una que mitiga y una que detecta. Cada una se puede comprobar. La de mitigar ya se comprobó, con la segunda corrida del game day.
El template está en
postmortem-template.md.
Con IA. Una herramienta puede resumir un incidente a partir de logs estructurados, y hacerlo bien ahorra tiempo. Pero la línea de tiempo se comprueba contra esos mismos logs. Un resumen como los que suele proponer una herramienta dice, con toda seguridad: “Los errores empezaron a las 06:10, afectaron a todas las rutas de la API y se resolvieron solos”. Cada parte de esa frase se puede revisar:
$ grep '^{' kallpa-muestra.txt | jq -c 'select(.level=="error") | {time,path,error}' | head -1
{"time":"2026-11-02T06:15:17.512Z","path":"/api/courts/%ZZ/availability","error":"URI malformed"}
$ grep '^{' kallpa-muestra.txt | jq -r 'select(.status>=500) | .path' | sort | uniq -c
      2 /api/courts/%ZZ/availability
      1 /api/members/%ZZ/bookings
Empezaron a las 06:15, en dos rutas. Tres errores, y el proceso nunca se recuperó de nada porque no se cayó. Lo mismo con la causa: una herramienta tiende a la explicación que suena bien. La causa la confirman ustedes, reproduciéndola. Y antes de pegar logs en una herramienta externa, miren qué llevan adentro: si tienen una línea como la de
[whatsapp], también están mandando datos personales.
Las métricas de DORA
Los SLOs miden el servicio. DORA (un programa de investigación, hoy en Google Cloud) mide el proceso de entrega del equipo, con cinco números, separados en dos grupos:
Rendimiento (throughput): cuántos cambios pasan por el sistema.
- Tiempo de entrega de un cambio (change lead time): desde el commit hasta producción.
- Frecuencia de despliegue (deployment frequency): cuántos despliegues en un periodo.
- Tiempo de recuperación (failed deployment recovery time): cuánto se tarda en recuperarse de un despliegue que falla y requiere intervención inmediata. Reemplazó al antiguo MTTR.
Inestabilidad (instability): qué tan bien salen los despliegues.
- Tasa de fallo de cambios (change fail rate): qué proporción de despliegues requiere intervención inmediata (un rollback, un parche urgente).
- Tasa de retrabajo (deployment rework rate): qué proporción de los despliegues no estaban planeados y se hicieron por un incidente en producción.
Su resultado más citado es que velocidad y estabilidad no se contraponen: las métricas están correlacionadas para la mayoría de los equipos, y quienes mejor lo hacen, lo hacen bien en las cinco. Es lo mismo que afirma SWEG con faster is safer, y reducir el tamaño de cada cambio es una recomendación de ambos. Es una correlación, no una demostración de que desplegar más seguido cause menos fallas: un equipo no mejora por desplegar más sin cambiar nada más.
La misma guía de DORA advierte los abusos. Convertir la métrica en meta (“todo debe desplegarse varias veces al día”) invita a hacer trampa: es la ley de Goodhart. No se comparan aplicaciones muy distintas, ni se usa para competir entre equipos. Se aplica a un servicio a la vez, para ver si ustedes mejoran.
Para su proyecto, las cinco salen de GitHub: la historia de Actions da la
frecuencia y las fallas, y git log da el tiempo desde el commit. Con un
sprint y un equipo de tres, los números son pocos: sirven para conversar en la
retrospectiva, no para sacar conclusiones.
Laboratorio: desplegar Kallpa, observarla y escribir un postmortem
La guía completa está en weeks/week-13.md. Trabajen
en su repositorio de Kallpa, en una rama nueva desde main, con un pull
request por paso. Los pasos 1 a 3 van en el contenedor del curso. Docker no
está dentro del contenedor: los pasos 4 a 7 se corren en la terminal de su
computadora, con el puerto 8080 para no chocar con el 3000 de run.sh.
Paso 1: GET /health. Es una ruta más: se agrega en buildRouter, con su
handler y una prueba en test/http.test.ts. La Kallpa publicada responde
404 en esa ruta, y eso lo comprueba una de nuestras pruebas.
Paso 2: logs estructurados. createServer ya recibe una función log, y
las pruebas le pasan una que no hace nada. Cambien lo que escribe. Midan el
tiempo con performance.now(), y en el path usen url.pathname, sin el
query string. Un error 500 también sale en JSON: hoy hay un console.error
en el catch. Con el servidor escribiendo en un archivo (make start > kallpa.log) corran
ejemplos/trafico.sh, o hagan sus
propias solicitudes, y calculen el SLI. Ya vieron qué cuenta el jq de la
guía y qué no.
Paso 3: apagado ordenado. En src/main.ts, igual que
ejemplos/apagado.ts: atrapen SIGTERM, server.close y, en su función,
db.close(). Comprueben con pkill -TERM -f 'node src/main.ts' desde otra
shell. La diferencia se ve en make:
make: *** [Makefile:22: start] Terminatedsin manejador; con manejador, las líneas de apagado en el log y make termina
sin error.
Paso 4: la imagen. Ya vieron cada problema en este capítulo: los archivos
justos, USER node, data/ con su owner, HEALTHCHECK sin curl, CMD en
forma exec, y las capas en orden. Con el HEALTHCHECK por omisión, el
starting les va a durar 30 s.
Paso 5: comparar el apagado. Antes de medir, miren docker inspect -f '{{.Config.StopTimeout}}' kallpa. Si es 1, como en la computadora donde se
prepararon estos apuntes, usen docker stop -t 10 para ver la diferencia. Lo
que se anota es el código de salida y por qué.
Paso 6: el flag. KALLPA_BOOKINGS_OPEN se lee en src/config.ts. Revisen
el valor: no vale cualquier texto. Un KALLPA_BOOKINGS_OPEN=no debe impedir
el arranque, como un PORT inválido. Piensen por qué.
Paso 7: el incidente. Lean incidente.md.
Reprodúzcanlo tal como dice: una reserva, docker rm -f, y el docker run
del relato. No se queden con “se perdió la base de datos”: cada síntoma del
relato tiene una explicación que pueden comprobar. Lean el log del contenedor
nuevo desde su primera línea. Y prueben las dos preguntas de la administración
antes de mitigar: una reserva de antes y otra de después.
Paso 8: el postmortem. En docs/postmortems/AAAA-MM-DD-tema.md, con el
template, y Tipo: game day. Datos del impacto salidos de sus logs, y al
menos tres acciones con owner y fecha: una que evite que se repita, y otra que
lo detecte antes. Piensen en qué prueba de humo lo habría detectado: /health
no, y ya saben por qué.
Esta semana no hay entregas. P4
(projects/p4-entrega-continua/README.md)
pide despliegue, observabilidad y un postmortem de su proyecto: son estos
mismos pasos, sobre su aplicación. Se entrega en la semana 14. Decidan pronto
dónde desplegar, y lean con cuidado qué dice su hosting sobre el disco: si no
guarda archivos entre despliegues, acaban de ver lo que le pasa a SQLite.
El código de la semana y make test
La carpeta code/week-13 tiene:
| Archivo | Qué es |
|---|---|
incidente.md, postmortem-template.md |
El material de los pasos 7 y 8 |
ejemplos/presupuesto.ts |
Las cuentas del presupuesto de errores y la velocidad de quemado |
ejemplos/apagado.ts |
Un servidor mínimo con y sin manejo de SIGTERM |
ejemplos/transaccion-cortada.ts |
Se mata con SIGKILL en medio de una transacción |
ejemplos/kallpa-muestra.txt, ejemplos/sli.jq, ejemplos/trafico.sh |
El log del capítulo, el filtro del SLI y el tráfico que lo produjo |
ejemplos/Dockerfile.ingenuo, ejemplos/secreto/ |
La imagen con cinco problemas y la credencial que queda en una capa |
ejemplos/game-day.sh |
El game day del proceso caído. Corre en su computadora |
ejemplos/2026-11-02-proceso-caido.md |
El postmortem del capítulo |
presupuesto.test.ts, apagado.test.ts, logs.test.ts, caida.test.ts, materiales.test.ts |
Comprueban lo que dice el capítulo |
Dentro del contenedor del curso:
$ cd code/week-13
$ make test
tsc -p .
eslint .
node --test "*.test.ts"
✔ sin manejador, SIGTERM mata el proceso y corta la solicitud en curso (195.386959ms)
✔ con manejador, termina la solicitud en curso, rechaza las nuevas y sale con 0 (597.214ms)
✔ una conexión keep-alive que estaba ocupada retrasa el cierre varios segundos (6307.134878ms)
✔ SIGKILL en medio de una transacción no deja la reserva a medias (125.302833ms)
...
ℹ tests 22
ℹ suites 0
ℹ pass 22
ℹ fail 0
Lo que depende de ser proceso 1, de la capa escribible o del HEALTHCHECK no
se puede probar ahí, porque no hay Docker: esas salidas son de corridas en la
computadora, con Docker 29.2.1, y los comandos están en el capítulo para que
los repitan. make clean borra build/.
Resumen
- Entrega continua: cada cambio que pasa el pipeline queda listo para desplegarse. Despliegue continuo: además se despliega solo. La diferencia es de confianza en el pipeline. SWEG: faster is safer, en lotes pequeños.
- Un contenedor es un proceso aislado que comparte el kernel, no una máquina virtual. Una imagen es su sistema de archivos inicial, en capas que se reutilizan: lo que cambia seguido va al final.
- Código en la imagen, configuración en el entorno, estado en un volumen. Una imagen es inmutable, se etiqueta con el SHA del commit, y el rollback es correr la anterior.
- Borrar un archivo en un
RUNno lo saca de la imagen: una credencial queda en su capa. - La capa escribible sobrevive a
docker stopy se borra condocker rm. Desplegar esrmmásrun. Sin volumen, cada despliegue empieza con otra base de datos, y nada falla. docker stopmanda SIGTERM, espera y manda SIGKILL (137). Node como proceso 1 ignora SIGTERM si no tiene manejador; como proceso normal, muere (143).CMDen forma shell o connpm starthace que el manejador no corra. Midan y lean el log.- Apagado ordenado:
server.close, cerrar la base de datos, salir con 0, con un límite de tiempo. SIGKILL no deja la base de datos a medias, pero el cliente no sabe qué pasó. - Rolling, blue-green y canary reparten el riesgo de un despliegue, y exigen varias instancias y una base de datos compatible con las dos versiones. No se aplican sin más a un SQLite con una sola instancia.
- Un feature flag separa desplegar de lanzar. Hay de release, experimento, operación y permisos. Cada uno tiene owner y fecha.
- Logs (eventos), métricas (agregados), traces (recorridos). Un log estructurado es una línea JSON a stdout, sin datos personales.
/healthlo usan Docker, el load balancer y el monitor.HEALTHCHECKno reinicia nada;--restartsolo mira si el proceso terminó.- Señales doradas: latencia, tráfico, errores, saturación. Se alerta por síntomas.
- SLI: eventos buenos sobre válidos. SLO: el objetivo en una ventana. SLA: un contrato con consecuencias. Presupuesto de errores: 1 − SLO; 99.5 % en 30 días son 3.6 h. Un SLO de 100 % es un error. Un log del servidor no ve lo que no llegó.
- Incidente: roles, y primero mitigar. Postmortem sin culpables: línea de tiempo con la detección, impacto con datos, causas de proceso y acciones verificables con owner y fecha. “Error humano” es donde empieza la pregunta, y “tener más cuidado” no es una acción.
- DORA: tres métricas de rendimiento y dos de inestabilidad. Velocidad y estabilidad se correlacionan. No son metas ni sirven para comparar equipos.
Ejercicios
- Clasifiquen cada una como entrega continua o despliegue continuo, y digan
qué le falta a la otra para cambiar: (a) cada merge a
mainconstruye una imagen, y el lunes alguien elige cuál desplegar; (b) cada merge amainllega a producción en 15 minutos; (c) cada merge se despliega a staging, y producción se despliega a mano una vez al mes con una lista de pasos. - Kallpa tiene un SLO de 99.5 % de solicitudes sin 5xx en 30 días, y recibe
unas 20 000 al mes. (a) ¿Cuántas pueden fallar? (b) Un despliegue malo hace
fallar 20 de las 28 solicitudes de una hora: ¿qué parte del presupuesto
gastó y a qué velocidad de quemado iba? (c) Otro, en un fin de semana de
mucho tráfico, produce 150 errores. ¿Qué hace el equipo después? Agreguen
sus cuentas a
presupuesto.test.ts. - Sin correrlo, digan qué código de salida y qué tiempo aproximado da
docker stop -t 10para cada caso, y qué líneas aparecen en el log: (a)CMD ["node", "src/main.ts"], con manejador; (b)CMD node src/main.ts, con manejador; (c)CMD ["sh", "-c", "exec node src/main.ts"], con manejador. Compruébenlo. El tercero no está en el capítulo: expliquen qué haceexec. - Reordenen este
Dockerfilepara que un cambio ensrc/no reinstale las dependencias, y digan qué capas se reutilizan:FROM node:26-trixie-slim,WORKDIR /app,COPY . .,RUN npm ci --omit=dev,USER node,CMD ["node", "src/main.ts"]. Agreguen lo que falte para quenodepueda escribir en/app/data. - Corran el ejemplo de
ejemplos/secreto/en su computadora. Después cambienCOPYyrmpor una sola instrucciónRUNque cree el archivo y lo borre. ¿Sigue en una capa? ¿Sigue endocker history? ¿Cuál es la forma correcta de pasar esa credencial? - Den para Kallpa un flag de release, uno de operación y uno de experimento. Para cada uno: dónde se lee, dónde se cambia, cuánto tarda en cambiar y cuándo se retira. ¿Cuál retirarían primero?
- Escriban un SLI de disponibilidad y uno de latencia para su proyecto,
como eventos buenos sobre eventos válidos. Digan qué queda fuera y por qué,
y calcúlenlos con
jqsobre un log real. Propongan un SLO para cada uno, y escriban qué pasaría si se acaba el presupuesto. - Un servicio responde
200en todo, pero en una de cada cien reservas el precio sale mal, por un error de redondeo. ¿Lo ve su SLI de disponibilidad? ¿Lo ven las cuatro señales doradas? Propongan una forma de detectarlo. ¿Qué tipo de error es, según el capítulo 6? - Arreglen el error de
//en una rama de su Kallpa: muevannew URLdentro deltryy agreguen una prueba que falle antes del arreglo. ¿Qué código HTTP debería responder? Repitanejemplos/game-day.sh. ¿Qué tiene que cambiar el script para seguir sirviendo como ensayo? - Reescriban como una o dos acciones que funcionen, con tipo, owner y fecha: (a) “Pedro debe revisar mejor antes de desplegar”; (b) “tener más cuidado con los volúmenes”; (c) “mejorar el monitoreo”; (d) “agregar más pruebas”.
- El monitor de
incidente.mddecíahealthymientras faltaban todas las reservas. Diseñen una prueba de humo que corra el pipeline después de cada despliegue y que hubiera fallado ese viernes. Debe funcionar en producción sin dejar reservas falsas. ¿Es posible con soloGET? Discutan también el arranque: ¿deberíasrc/main.tscargar los datos de ejemplo cuando la base está vacía en producción? - Calculen las cinco métricas de DORA de su equipo en el sprint actual, con
GitHub y
git log. Digan de dónde sale cada número y cuál no pudieron medir. Elijan una sola para mejorar en el próximo sprint, y expliquen cómo evitarían que se vuelva una meta tramposa.