Apuntes · Capítulo 16Producción y evolución
Mantenimiento: código heredado, deuda técnica y deprecación
Mantenimiento: código heredado, deuda técnica y deprecación
La semana pasada miraron su aplicación como la miraría un atacante, y antes la desplegaron, la observaron y la conectaron a un modelo de lenguaje. El producto ya está en manos de alguien. Esta semana estudiamos lo que viene después, que es lo más largo de la vida de un sistema: seguir cambiándolo sin romper lo que la gente ya usa.
La semana 1 definió la ingeniería de software como programación integrada en el tiempo, y llamó sostenible a un proyecto que puede reaccionar a los cambios que valen la pena a un costo razonable. Todo el curso ha sido sobre eso, aunque hasta ahora lo hayamos visto desde el lado de quien construye. Aquí lo vemos desde el lado de quien hereda: alguien abre un script sin pruebas que escribió una persona que ya no está, y tiene que cambiarlo el viernes.
El capítulo sigue la semana. La Sesión A recorre cinco ideas: los tipos de mantenimiento; cómo se cambia código heredado sin pruebas, con puntos de cambio, costuras y pruebas de caracterización; la deuda técnica y cómo hacerla visible; las migraciones graduales (strangler fig, parallel change y los cambios de la base de datos); y la deprecación, desde las cabeceras HTTP hasta los cambios que tocan miles de archivos. La Sesión B es sobre sus presentaciones finales y sobre lo que necesita saber quien mantenga el producto. El laboratorio es la defensa oral.
Lectura. Para la primera parte: Software Engineering at Google (SWEG), cap. 15, Deprecation, y cap. 22, Large-Scale Changes. Para la segunda: el enunciado de P5 y SWEG, cap. 3, Knowledge Sharing. Complementarias: Martin Fowler, Technical Debt Quadrant y StranglerFigApplication; Danilo Sato, Parallel Change; IETF, RFC 9745, The Deprecation HTTP Response Header Field (2025) y RFC 8594, The Sunset HTTP Header Field; Hyrum’s Law; y SWEG, cap. 10, Documentation. El código del capítulo está en
code/week-16y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Después de la primera entrega; de Código heredado, La definición de Feathers, El procedimiento y Pruebas de caracterización; de Deuda técnica, La metáfora y El cuadrante de Fowler; de Migraciones graduales, Por qué no reescribir; de Deprecación, Qué es y por qué cuesta; y de Presentaciones finales, Qué contar.
- En clase: Sesión A: Código heredado, Caracterizar la caja del día de Kallpa, Deuda técnica, Migraciones graduales y Deprecación. Sesión B: Presentaciones finales. Laboratorio: La defensa oral.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Strangler fig, Parallel change, Migraciones de la base de datos, Cuando el cambio toca miles de archivos y las lecturas del recuadro Lectura.
Después de la primera entrega
Cuatro tipos de mantenimiento
Mantenimiento es todo lo que se hace a un sistema después de su primera entrega. La clasificación más usada tiene cuatro tipos, los mismos que usa la norma ISO/IEC 14764.
| Tipo | Qué lo dispara | Un ejemplo en Kallpa |
|---|---|---|
| Correctivo | Algo no hace lo que debería | Una reserva de 17:00 a 19:00 se cobra con una sola tarifa, y el README dice otra cosa |
| Adaptativo | El entorno cambió, aunque el sistema no tenga nada de malo | Una versión nueva de Node, o una ley que obliga a emitir comprobantes electrónicos |
| Perfectivo | Alguien quiere algo más o algo mejor | La caja del día muestra el porcentaje de ocupación; la página carga más rápido |
| Preventivo | Nada falla todavía, pero se ve venir | Extraer la regla de “solo cuentan las confirmadas”, que hoy está repetida |
Los bordes no son nítidos, y las normas no siempre coinciden en dónde cae una funcionalidad nueva. No importa tanto la etiqueta como lo que deja ver: solo uno de los cuatro tipos corrige errores. Un sistema perfecto, sin un solo bug, igual necesita mantenimiento, porque el mundo a su alrededor sigue cambiando.
Error común. Pensar en el mantenimiento como “arreglar errores” y, por lo tanto, como algo que un buen equipo casi no tendría que hacer. Casi todo lo que le van a pedir a su cliente después de la entrega no será un bug: será una regla nueva, un dato más, un proveedor que cambió de API.
Cuánto cuesta
Se suele decir que la mayor parte del costo de un sistema llega después de su primera versión. La idea es razonable y la experiencia la respalda, pero tengan cuidado con los porcentajes exactos que circulan: suelen venir de estudios antiguos, de sistemas muy distintos a los suyos, y con definiciones de “mantenimiento” que incluyen las funcionalidades nuevas. Si van a citar un número, vayan a la fuente y digan qué midió.
Lo que sí se puede argumentar sin un porcentaje es lo que dice SWEG en el cap. 15:
“code is a liability, not an asset”
El código es un pasivo, no un activo. Tiene costos que siguen corriendo mientras exista: recursos para operarlo, trabajo para actualizarlo cuando cambia lo que lo rodea. Lo que tiene valor es la funcionalidad; el código es el medio. Si la misma funcionalidad se puede dar con una línea entendible o con diez mil enredadas, se prefiere la primera. Por eso quitar código es, a veces, de lo más útil que se puede hacer, y por eso SWEG le dedica un capítulo a retirar sistemas.
Con IA. Una herramienta baja mucho el costo de escribir código y no baja el de tenerlo. Si el código es un pasivo, poder producir el triple en una tarde también puede significar triplicar lo que hay que mantener. La pregunta útil antes de aceptar un cambio generado no es “¿funciona?”, sino “¿queremos ser owners de esto durante años?”.
Código heredado
La definición de Feathers
En el lenguaje de todos los días, código heredado es código viejo o feo, o código de otra persona. Michael Feathers propone otra definición, en Working Effectively with Legacy Code (2004), que la semana 5 ya mencionó:
Código heredado es código sin pruebas.
Parece exagerado, y es a propósito. No importa quién lo escribió, cuándo, ni qué tan bonito se ve. Importa una sola cosa: si lo cambian, ¿pueden saber si rompieron algo? Con pruebas, sí, y pueden cambiar hasta código feo con bastante tranquilidad. Sin pruebas, ni el código más elegante se puede cambiar sabiendo lo que pasa.
Con esta definición, el código de ayer ya puede ser heredado. Y el que aceptaron de un agente sin entenderlo, también, aunque tenga pruebas, porque esas pruebas no le dicen a nadie qué intención había detrás. Volvemos a esto al final de la Sesión A.
Feathers plantea además el dilema del código heredado: para cambiar el código con seguridad hacen falta pruebas, y para poner las pruebas muchas veces hay que cambiar el código. La salida es un procedimiento que hace esos primeros cambios lo más pequeños y mecánicos posible.
El procedimiento
Son cinco pasos, y el orden importa:
- Identificar los puntos de cambio. ¿Qué líneas hay que tocar?
- Encontrar los puntos de prueba. ¿Desde dónde se puede observar lo que hace ese código?
- Romper las dependencias que impiden probarlo, con cambios mínimos.
- Escribir pruebas que fijen lo que hace hoy.
- Hacer el cambio y refactorizar.
Recién el quinto paso es lo que les pidieron. Lo aplicamos a un caso.
El cierre de caja
La administración de Kallpa tiene un script que escribió hace años alguien que
ya no trabaja ahí. No está en el repositorio de la aplicación, no tiene
pruebas y Doris lo corre cada noche. Está en
heredado/cierre-de-caja.ts,
escrito para este capítulo:
import { DatabaseSync } from 'node:sqlite';

const db = new DatabaseSync(process.env.KALLPA_DB ?? 'data/kallpa.db');
const date = process.argv[2] ?? new Date().toISOString().slice(0, 10);

type Row = { court: string; start_hour: number; team_name: string; price_cents: number; plan: string; status: string };
const rows = db
  .prepare(
    `SELECT c.name AS court, b.start_hour, b.team_name, b.price_cents, m.plan, b.status
     FROM bookings b JOIN courts c ON c.id = b.court_id JOIN members m ON m.id = b.member_id
     WHERE b.date = ? ORDER BY c.name, b.start_hour`,
  )
  .all(date) as Row[];

console.log(`CIERRE DE CAJA ${date}`);
let total = 0;
for (const row of rows) {
  if (row.status === 'cancelled') continue;
  let amount = row.price_cents / 100;
  if (row.plan === 'socio') amount = amount * 0.9;
  total += amount;
  console.log(`${row.court.padEnd(10)} ${String(row.start_hour).padStart(2)}:00 ${row.team_name.padEnd(26)} S/ ${amount.toFixed(2)}`);
}
console.log(`TOTAL S/ ${total.toFixed(2)}`);
if (total > 500) console.log('Depositar en el banco');
Doris pide un cambio chico: “al final, que me diga cuántas reservas fueron de socios y cuántas de regulares”. Con un script de treinta líneas, la tentación es abrirlo y agregar un contador. Sigamos el procedimiento.
Puntos de cambio. El bucle, donde se sabe el plan de cada fila, y el final, donde se imprime el total.
Puntos de prueba. Lo único que el script deja ver es lo que imprime. No
devuelve nada, y todo ocurre al cargar el archivo: no hay función que llamar.
Pero sí hay dos cosas que se pueden cambiar sin editarlo: la variable de
entorno KALLPA_DB y el argumento con la fecha.
Una costura
Una costura (seam) es, según Feathers, un lugar donde se puede cambiar el
comportamiento de un programa sin editar en ese lugar. Ya conocen la mejor
de Kallpa, que la semana 9 usó en sus pruebas: el Clock que recibe
createServer. El código llama a clock.now() y es quien lo arma el que
decide si es el reloj de verdad o uno fijo.
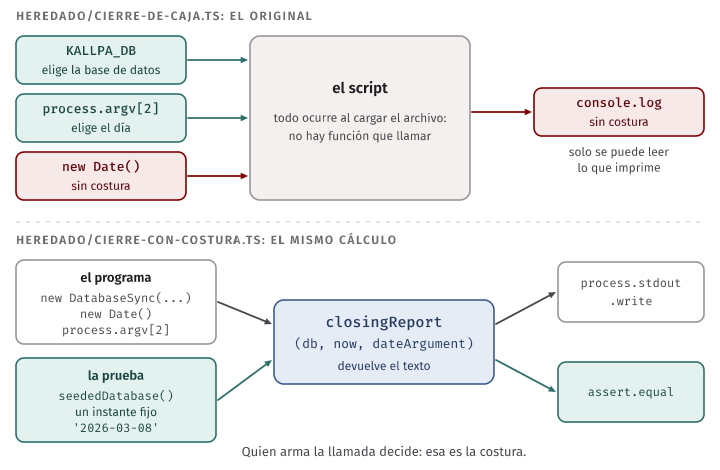
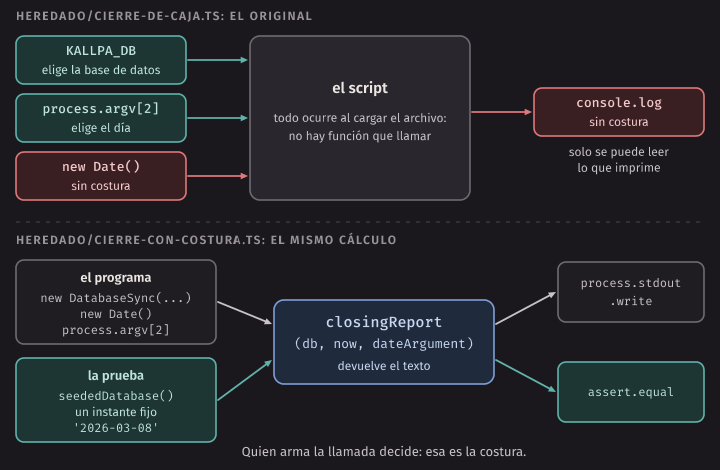
El cierre de caja ya trae dos costuras sin querer: KALLPA_DB elige la base
de datos y process.argv[2] elige el día. Con eso ya se puede armar una
primera red, sin tocar una sola línea: una base de datos con los datos de
ejemplo de Kallpa alrededor de un lunes fijo (el 9 de marzo de 2026), y correr
el script como programa para varios días. Lo que imprime se guarda en
golden/cierre-*.txt:
CIERRE DE CAJA 2026-03-09
Básquet    17:00 Básquet Ate                S/ 60.00
Fulbito 1  19:00 Real Barranco              S/ 182.25
Fulbito 2  20:00 Los Cracks del Jueves      S/ 225.00
TOTAL S/ 467.25
Esa red, por tosca que sea, permite el paso 3. Lo que todavía no se puede
observar es qué hace el script sin fecha, porque new Date() no tiene
costura. Y correr el programa completo para cada caso es lento y solo deja
comparar texto. Hay que romper dos dependencias: el reloj y la consola. El
cambio es mecánico: envolver todo en una función que recibe la base de datos y
el instante, y que devuelve el texto en lugar de imprimirlo.
export function closingReport(db: DatabaseSync, now: Date, dateArgument?: string): string {
  const date = dateArgument ?? now.toISOString().slice(0, 10);
  // ... la misma consulta ...
  const lines = [`CIERRE DE CAJA ${date}`];
  let total = 0;
  for (const row of rows) {
    if (row.status === 'cancelled') continue;
    let amount = row.price_cents / 100;
    if (row.plan === 'socio') amount = amount * 0.9;
    total += amount;
    lines.push(`${row.court.padEnd(10)} ...`);
  }
  // ...
  return lines.join('\n') + '\n';
}

if (import.meta.main) {
  const db = new DatabaseSync(process.env.KALLPA_DB ?? 'data/kallpa.db');
  process.stdout.write(closingReport(db, new Date(), process.argv[2]));
}
El archivo completo es
heredado/cierre-con-costura.ts.
Fíjense en lo que no cambió: ni los nombres, ni el cálculo, ni el 0.9,
ni el toISOString. Nada de “ya que estoy”. Quien revise este cambio tiene
que poder comprobar que no cambia nada, y para eso está la red: la prueba
corre el script original y el nuevo como programas, y compara cada uno con los
archivos guardados.
for (const day of SAMPLE_DAYS) {
  assert.equal(runOriginal('heredado/cierre-de-caja.ts', path, day), golden(day), day);
  assert.equal(runOriginal('heredado/cierre-con-costura.ts', path, day), golden(day), day);
}
Idea clave. Los primeros cambios a un código sin pruebas se hacen sin la red de las pruebas que todavía no existen. Por eso son mínimos y mecánicos, y se apoyan en lo que haya: las costuras que ya existen, el tipo que revisa
tsc, el comparador de salidas. Se rompe solo la dependencia que estorba, y se deja todo lo demás como estaba, aunque moleste.
Pruebas de caracterización
Una prueba de caracterización registra lo que el código hace hoy, no lo que debería hacer. La semana 5 ya la presentó. Se diferencia en todo de una prueba escrita con TDD:
| Prueba con TDD | Prueba de caracterización | |
|---|---|---|
| Cuándo se escribe | Antes que el código | Después, a veces años después |
| De dónde sale el valor esperado | De la especificación | Del propio código, al correrlo |
| Si falla | El código está mal | Cambió el comportamiento; hay que averiguar si se quería |
| Qué afirma | Lo que debe pasar | Lo que pasa, con errores incluidos |
El oráculo es el problema que vimos en la semana 10. En la semana 9 decíamos que una prueba que copia lo que hace el código no sirve, porque si el código está mal la prueba está mal igual. Aquí se hace exactamente eso, y a propósito, porque la pregunta es otra: no “¿está bien?”, sino “¿cambié algo sin querer?”. Son pruebas para preservar, no para verificar. Cumplida su función, varias se reemplazan por pruebas que sí digan qué se espera.
Feathers da una receta para escribirlas, que parece un juego. Se escribe una aserción que uno sabe que va a fallar, y se deja que el fallo cuente qué hace el código:
test('¿qué dice el cierre del 8 de marzo?', () => {
  const db = seededDatabase();
  assert.equal(closingReport(db, new Date('2026-03-09T15:00:00Z'), '2026-03-08'), '?');
});
$ make primera
...
✖ failing tests:
test at demos/primera-caracterizacion.check.ts:8:1
✖ ¿qué dice el cierre del 8 de marzo? (2.316708ms)
AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:
+ actual - expected
+ 'CIERRE DE CAJA 2026-03-08\n' +
+ 'Fulbito 1 20:00 Deportivo Rímac S/ 91.13\n' +
+ 'Vóley 18:00 Vóley Femenino San Juan S/ 101.25\n' +
+ 'TOTAL S/ 192.38\n'
- '?'Se copia lo que dice el fallo como valor esperado, y queda fijado. Con la costura se pueden fijar además los casos que el script no dejaba alcanzar, como qué pasa sin fecha. Hay que elegir bien los ejemplos: los que recorren las ramas del punto de cambio. Aquí, un día con socios, uno con una reserva cancelada, un día vacío, y un total por encima de los S/ 500 del aviso de depósito.
Lo que aparece cuando se mira
Al fijar lo que el script hace, salen tres cosas raras. Las tres quedaron en
cierre.test.ts, con su nombre:
✔ caracterización: sin fecha, de mañana usa el día de Lima (1.246459ms)
✔ caracterización: sin fecha, desde las 19:00 usa el día siguiente (posible bug) (4.08ms)
✔ caracterización: a los socios les quita 10 % otra vez (posible bug) (1.009208ms)
✔ caracterización: el aviso de depósito sale con más de S/ 500 (2.324583ms)
✔ el cierre y la caja de Kallpa difieren en S/ 20.25, 10 % de la reserva del socio (1.043125ms)
El día equivocado. toISOString da la fecha en UTC, y Lima está 5 horas
atrás: desde las 19:00, para el script ya es mañana. Por eso Doris pasa la
fecha a mano (“sin fecha sale mal de noche”). Lo sabe ella y nadie más: es lo
que SWEG llama conocimiento tribal, y volvemos a él en la Sesión B.
El descuento doble. price_cents ya tiene el descuento de socio, porque
Kallpa lo guarda así al confirmar. El script se lo aplica otra vez. La reserva
de Real Barranco, de un socio, costó S/ 202.50 y el cierre dice S/ 182.25. Por
eso el cierre del 9 de marzo dice S/ 467.25 y GET /api/reports/daily dice
48750 céntimos: una diferencia de S/ 20.25.
Fracciones de céntimo. En el cierre del 8 de marzo, S/ 101.25 × 0.9 =
91.125, que toFixed(2) imprime como 91.13. El README de Kallpa explica por
qué el dinero va en céntimos enteros: estos centavos no cuadran con ninguna
caja.
¿Qué se hace con eso? Nada, en este cambio. Esta es la regla más difícil de cumplir del capítulo, y es la misma de la semana 5:
- La prueba de caracterización se queda con el valor de hoy y lleva “posible bug” en el nombre, para que nadie la lea como si fuera lo correcto.
- Se abre un issue con la evidencia.
- El arreglo va en otro pull request, con su propia prueba y después de preguntar.
¿Por qué preguntar, si está clarísimo? Porque “parece un bug” no siempre lo es, y aquí entra la ley de Hyrum. Quizás el contador lleva años descontando S/ 20 de memoria porque “el cierre siempre da un poco menos”. Si corrigen el total sin avisar, el cierre de esta noche no cuadra con nada, y el error es de ustedes. Un issue así sirve:
# El cierre de caja descuenta dos veces a los socios

Evidencia: 9 de marzo, Real Barranco (socio). La reserva se guardó con S/ 202.50 y el
cierre imprime S/ 182.25. El total del cierre es S/ 467.25 y el de la caja de la API,
S/ 487.50. `cierre.test.ts` lo fija hoy como comportamiento actual.

Pregunta para Doris y para quien lleve las cuentas: ¿alguien corrige este número a
mano, o lo usa tal cual? Antes de cambiarlo hay que saberlo.
Error común. Corregir el error en el mismo pull request del cambio pedido. El revisor ya no puede comprobar que el refactoring no cambió nada, y si algo sale mal al día siguiente, no hay forma de saber cuál de las dos cosas lo causó.
Recién ahora, el cambio
Con la red puesta, el cambio de Doris es casi aburrido. No se toca el bucle: se agrega código nuevo al lado del viejo, con pruebas propias. Feathers le llama sprout, hacer brotar una función nueva, y evita que lo nuevo herede los problemas de lo viejo. Esta función sí se puede escribir con TDD, y usa enteros y SQL parametrizado:
export function bookingsByPlan(db: DatabaseSync, date: string): PlanCount[] {
  const rows = db
    .prepare(
      `SELECT m.plan, COUNT(*) AS bookings
       FROM bookings b JOIN members m ON m.id = b.member_id
       WHERE b.date = ? AND b.status = 'confirmed'
       GROUP BY m.plan ORDER BY m.plan`,
    )
    .all(date) as PlanCount[];
  return rows.map((row) => ({ ...row }));
}

export function closingReportByPlan(db: DatabaseSync, now: Date, dateArgument?: string): string {
  const old = closingReport(db, now, dateArgument);
  const date = dateArgument ?? now.toISOString().slice(0, 10);
  const counts = bookingsByPlan(db, date).map((c) => `${c.plan}: ${c.bookings}`);
  return `${old}RESERVAS ${counts.join(', ') || 'ninguna'}\n`;
}
La prueba más importante afirma que todo lo anterior quedó igual, letra por letra:
test('el cambio agrega una línea y deja igual todo lo anterior', () => {
  const db = seededDatabase();
  const report = closingReportByPlan(db, MORNING, '2026-03-09');
  assert.equal(report, `${golden('2026-03-09')}RESERVAS regular: 2, socio: 1\n`);
});
Fíjense que la segunda línea de closingReportByPlan copia el toISOString:
es decir, si se corre sin fecha desde las 19:00, el conteo también es del día
siguiente. Es lo coherente mientras el error siga vivo; se corrige junto con
él.
En la industria. Google trata su suite global de pruebas como un oráculo para saber si ya se quitaron todos los usos de algo viejo. SWEG (cap. 15) agrega una responsabilidad que suele sorprender: es quien depende de un sistema el que debe tener pruebas suficientes para saber si la remoción lo daña. Es la regla de Beyoncé de la semana 9: si te importaba, le hubieras puesto una prueba.
Caracterizar la caja del día de Kallpa
El archivo con lo que hay
En Kallpa la costura ya existe, así que caracterizar es más fácil. El módulo
seeded.ts levanta un servidor con los datos de
ejemplo alrededor de un lunes fijo, y make golden guarda en
golden/caja.json lo que responde GET /api/reports/daily para siete días
elegidos: dos pasados, hoy, uno con una cancelación, uno con dos horas que
cruzan las 18:00, un sábado y un día vacío.
Con la herramienta de siempre, un resumen de lo que quedó guardado:
$ jq -r 'to_entries[] | [.key, .value.bookings, .value.hours, .value.revenueCents] | @tsv' golden/caja.json
2026-03-06	1	2	22500
2026-03-08	2	3	21375
2026-03-09	3	5	48750
2026-03-10	2	3	21250
2026-03-11	2	3	22125
2026-03-14	1	2	11250
2026-03-20	0	0	0
Una prueba compara lo que responde el servidor con ese archivo. Y aquí pasa de nuevo: el miércoles 11 de marzo, la reserva de básquet de 17:00 a 19:00 de los datos de ejemplo aparece con 12000 céntimos. El README dice que cada hora se cobra con su tarifa (S/ 60 + S/ 75 = S/ 135). Es el error de precios que encontraron con una propiedad en la semana 10. La caracterización de la Kallpa tal como se publicó lo fija, porque eso es lo que hace hoy. En su repositorio, donde lo corrigieron, el archivo diría otra cosa. Por eso la caracterización no es una especificación: su valor no dice qué está bien, solo qué hay.
Un refactoring protegido
Supongamos que la caja se va a volver lenta y el equipo quiere calcularla en
SQL, sin traer todas las reservas a memoria. No debería cambiar nada para
quien llama: es un refactoring.
caja/report-sql.ts lo hace bien, y
pasa la prueba en los siete días:
const courts = db
  .prepare(
    `SELECT c.id AS courtId, c.name AS courtName,
            COUNT(b.id) AS bookings,
            COALESCE(SUM(b.hours), 0) AS hours,
            COALESCE(SUM(b.price_cents), 0) AS revenueCents
     FROM courts c
     LEFT JOIN bookings b ON b.court_id = c.id AND b.date = ? AND b.status = 'confirmed'
     GROUP BY c.id, c.name
     ORDER BY c.name`,
  )
  .all(date) as CourtSummary[];
Ahora vean un cambio como los que suele proponer un agente cuando se le pide “calcula la caja en SQL”, escrito para esta clase como ilustración. Se lee bien:
`SELECT c.id AS courtId, c.name AS courtName,
        COUNT(*) AS bookings,
        SUM(b.hours) AS hours,
        SUM(b.price_cents) AS revenueCents
 FROM bookings b
 JOIN courts c ON c.id = b.court_id
 WHERE b.date = ? AND b.status = 'confirmed'
 GROUP BY c.id
 ORDER BY c.id`
Aplicado a Kallpa con caja/agente.diff,
pasa make check, las 40 pruebas:
ℹ pass 40
ℹ fail 0
¿Por qué? Porque la prueba de report.test.ts llama a la función del dominio,
que el cambio dejó de usar, y ninguna prueba de Kallpa pide la caja por HTTP.
Lo sabían desde el laboratorio de la semana 9. La caracterización, en cambio,
lo encuentra en dos lugares:
$ make caja-agente
...
✖ la caja del 20 de marzo, un día sin reservas (2.741ms)
✖ la caja del 9 de marzo (0.886042ms)
...
✖ failing tests:

test at demos/caja-agente.check.ts:10:1
✖ la caja del 20 de marzo, un día sin reservas (2.741ms)
  AssertionError [ERR_ASSERTION]: Expected values to be strictly deep-equal:
  + actual - expected

    {
      bookings: 0,
  +   courts: [],
  -   courts: [
  -     {
  -       bookings: 0,
  -       courtId: 4,
  -       courtName: 'Básquet',
...
Dos diferencias. Las canchas sin reservas desaparecen, porque el JOIN parte
de las reservas, y el comentario de dailySummary decía que debían aparecer
todas. Y el orden cambió: ORDER BY c.id pone a Básquet (cancha 4) al final,
y antes salía primero porque listCourts ordena por nombre. Nadie prometió
ese orden. Pero si un panel lee courts[0], se rompió, y eso es Hyrum otra
vez. Una prueba de caracterización no distingue entre lo prometido y lo
observable, y por eso lo nota. Decidir si el orden se debe conservar sigue
siendo trabajo de una persona.
Los totales, ojo, están bien en los dos días: bookings, hours y
revenueCents salen iguales. Quien revise mirando solo “la plata cuadra” lo
aprueba.
Error común. Creer que la caracterización protege todo lo que el código hace. Solo protege lo que los ejemplos recorren. Si
golden/caja.jsonno tuviera un día vacío, el primer error pasaría. Las herramientas de la semana 9 y la 10 se usan aquí también: la cobertura muestra qué líneas ni siquiera se ejecutan, y los mutantes que sobreviven muestran qué comportamientos no quedaron fijados.
Con IA. Las pruebas de caracterización y los agentes se llevan bien en un sentido preciso. Un agente es rápido para generar ejemplos que recorran las ramas y para hacer el trabajo mecánico de la costura; si la red ya está, también para el refactoring. Lo que no puede hacer es decidir si un comportamiento raro es un error o una regla: eso se le pregunta al cliente. Y revisen que no “corrija” la prueba para que pase: un diff que modifica
golden/en un refactoring está diciendo que el comportamiento cambió.
Deuda técnica
La metáfora
La expresión viene de Ward Cunningham, en un informe de experiencia de 1992 sobre un sistema financiero, The WyCash Portfolio Management System:
“Shipping first time code is like going into debt. A little debt speeds development so long as it is paid back promptly with a rewrite.”
Sacar código por primera vez es como endeudarse: un poco de deuda acelera el desarrollo, siempre que se pague pronto. El mismo texto da la otra mitad: “Every minute spent on not-quite-right code counts as interest on that debt”. Cada minuto que se gasta en un código que no está del todo bien cuenta como intereses.
Entonces, tres términos, que conviene usar con cuidado:
- Deuda técnica: un atajo que hace más rápido el cambio de hoy y más caros los siguientes. La nota al pie de SWEG que citamos en la semana 1 es más amplia: la diferencia entre el código que tenemos y el que quisiéramos tener.
- Intereses: el costo extra que se paga en cada cambio que pasa por ahí.
- Capital: lo que costaría arreglarlo.
La metáfora ayuda porque explica la decisión a alguien no técnico. Endeudarse no es malo en sí: se hace para comprar una casa. Lo malo es no saber cuánto se debe ni a qué tasa.
Idea clave. El dato que decide si una deuda se paga es el interés, no lo feo que se ve el código. Si un módulo enredado no se toca nunca, su interés es casi cero, y Fowler lo dice directamente: una deuda prudente “may not be worth paying down if the interest payments are sufficiently small”. Lo que duele es la deuda en lo que se cambia todas las semanas.
El cuadrante de Fowler
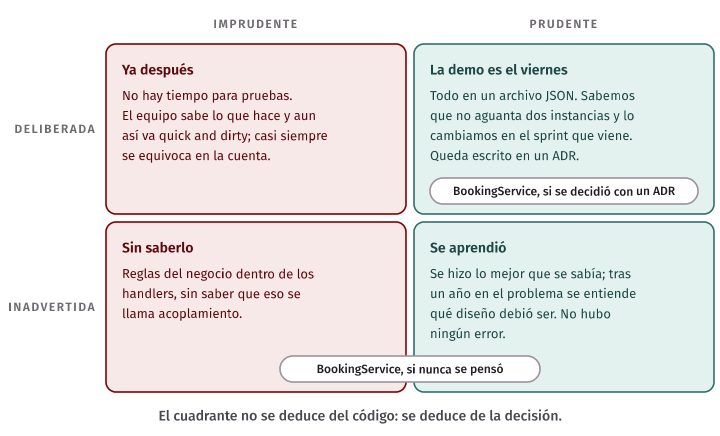
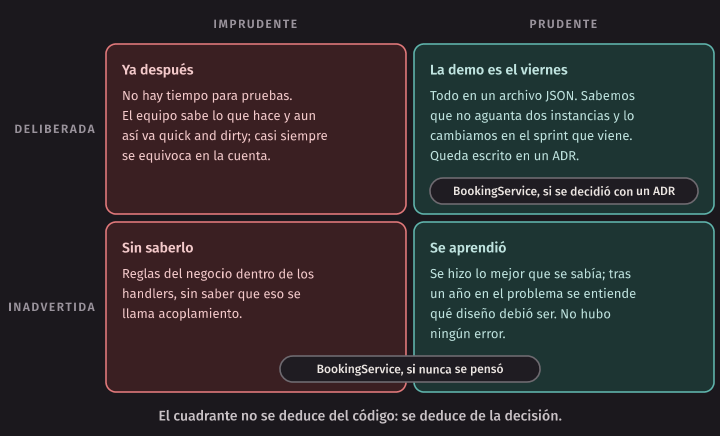
Fowler observa que se discutía mucho si un código desordenado “cuenta” como deuda, y dice que esa es la pregunta equivocada. La metáfora sirve en los dos casos, y lo útil es distinguir dos ejes: si la deuda es deliberada o inadvertida, y si es imprudente o prudente. Las frases de cada cuadrante son las de su artículo:
| Imprudente (reckless) | Prudente (prudent) | |
|---|---|---|
| Deliberada | “We don’t have time for design” | “We must ship now and deal with consequences” |
| Inadvertida | “What’s Layering?” | “Now we know how we should have done it” |
En su proyecto se ve así:
- Deliberada e imprudente. “No hay tiempo para pruebas, ya después.” El equipo sabe lo que hace y aun así elige ir “quick and dirty”. Fowler agrega que casi siempre se equivocan en la cuenta, porque el buen diseño existe para ir más rápido.
- Deliberada y prudente. “La demo es el viernes con el cliente. Guardamos todo en un archivo JSON, sabemos que no aguanta dos instancias, y lo cambiamos en el sprint que viene.” Se conoce el costo, y queda escrito en un ADR.
- Inadvertida e imprudente. El equipo no sabe que está haciendo algo mal: las reglas del negocio dentro de los handlers, sin saber que eso se llama acoplamiento.
- Inadvertida y prudente. Es la que sorprende y la que Fowler considera inevitable en un buen equipo. Se hizo lo mejor que se sabía, y después de un año en el problema se entiende cuál debió ser el diseño. No hubo ningún error: se aprendió.
Ese último cuadrante es la razón por la cual “hacerlo bien desde el principio” no elimina la deuda. Mientras se programa, se aprende.
Un ejemplo con código que conocen. BookingService, que la semana 5 señaló
como módulo superficial, y las reglas del negocio en los handlers. ¿En qué
cuadrante está? No se puede responder mirando el código: depende de lo que
sabía y decidió quien lo escribió. Si lo decidió con un ADR para llegar a una
fecha, es deliberada y prudente; si nunca lo pensó, inadvertida. El
cuadrante no se deduce del código, se deduce de la decisión. Lo que sí se ve
en el código es el interés.
Hacerla visible
La deuda que no está escrita no se puede pagar, ni priorizar, ni explicarle a un cliente. Para que se pueda decidir sobre ella, tiene que estar donde se deciden las cosas:
- Un issue por deuda, con el costo que genera y una propuesta. Va al backlog y compite con todo lo demás.
- Las decisiones conscientes, en un ADR, en la sección Consecuencias: lo que se aceptó, por qué y qué señal diría que ya hay que pagar.
- Lo que queda al entregar, en
## Pendientesdedocs/entrega.mden P5, con la prioridad acordada con el cliente.
“El código está feo” no es un issue. Comparen con uno que tiene evidencia,
sacada de la Kallpa publicada con un grep:
$ grep -n "'confirmed'" src/http/handlers.ts src/domain/report.ts
src/http/handlers.ts:66:    const taken = deps.service.bookingsForCourt(courtId, date).filter((b) => b.status === 'confirmed');
src/http/handlers.ts:92:    const sameDay = deps.service.bookingsForCourt(court.id, request.date).filter((b) => b.status === 'confirmed');
src/domain/report.ts:24:  const confirmed = bookings.filter((b) => b.date === date && b.status === 'confirmed');
# "Solo cuentan las confirmadas" está repetido en tres lugares
Tipo: deuda técnica (inadvertida, prudente).
Qué pasa: `listByCourtAndDate` devuelve también las canceladas y cada llamador tiene que
acordarse de filtrar (handlers.ts:66, handlers.ts:92, report.ts:24).
Cuánto cuesta: cualquier estado nuevo (por ejemplo, *no se presentó*) obliga a revisar los
tres lugares, y olvidar uno da una doble reserva o una caja mal sumada. Lo sufrimos una vez,
en el pull request #14, con unas 2 horas de investigación.
Propuesta: un método `confirmedBookings(courtId, date)` en el repositorio. Unas 2 horas,
con las pruebas que ya hay.
Cuándo: la próxima vez que se agregue un estado, o antes si alguien más toca estas rutas.No tiene que ser perfecto. Basta con que alguien que no estuvo pueda decidir: cuánto cuesta dejarlo y cuánto cuesta arreglarlo. Si el costo es una estimación, se dice.
¿Cuándo se paga? No hay fórmula. Unos equipos reservan una parte de cada sprint y otros la pagan al tocar ese código por otro motivo. Una técnica útil para ubicar el interés es cruzar qué tan complejo es un archivo con qué tan seguido cambia. Este comando muestra qué archivos cambian más en su propio repositorio:
git log --format= --name-only | sort | uniq -c | sort -rn | headUn archivo enredado que cambia cada semana es donde el pago rinde; uno enredado que no se toca desde marzo puede esperar.
Con IA. Dos deudas nuevas, además de las de siempre. La primera: un agente puede llenar un repositorio de código que pasa las pruebas y que nadie del equipo entendió. Es deuda inadvertida en el sentido estricto, y de las peores, porque nadie decidió tomarla. La segunda: una herramienta puede encontrar patrones y proponer pagos, pero no sabe cuál de ellos duele. Sepan el interés antes de aceptar un refactoring de 800 líneas que “mejora la calidad”.
Migraciones graduales
Por qué no reescribir
Tarde o temprano alguien lo propone: este código es un desastre, lo reescribimos desde cero y en tres meses queda bien. Casi siempre sale mal, por tres razones:
- Se pierde el conocimiento guardado en el código. Cada caso raro que alguien ya resolvió, cada comprobación rara que parece innecesaria, es algo que ocurrió en la realidad. Fowler lo explica así: “Replacements seem easy to specify, but often it’s hard to figure out the details of existing behavior”. Y agrega que mucho de ese comportamiento ya no se quiere, por lo que construirlo es un desperdicio.
- Tarda más de lo previsto. Fowler ha visto ese plan de apariencia simple “go down in flames most of the time”. SWEG cuenta lo que han observado en Google: migrar a sistemas enteramente nuevos es “extremely expensive”, y los costos se suelen subestimar.
- Mientras tanto hay dos sistemas. Los usuarios no pueden esperar funcionalidades nuevas, así que el viejo sigue cambiando y el nuevo persigue a un objetivo en movimiento.
SWEG lo resume en una de las conclusiones del capítulo 15: “Evolving a system in place is usually cheaper than replacing it with a new one, when turndown costs are included.”
Esto no quiere decir que no se reemplace nunca nada. Quiere decir que se reemplaza por pedazos. Hay dos técnicas con nombre.
Strangler fig
El strangler fig (higuera estranguladora) es una planta que Fowler vio en los bosques de Queensland: germina en una rama de un árbol, crece a su alrededor hasta llegar al suelo y termina por sostenerse sola. El árbol original puede morir y dejar a la higuera con su forma. En software, el sistema nuevo crece alrededor del viejo, detrás de la misma interfaz, y le va quitando funciones hasta que el viejo se puede apagar.
Hace falta un punto por donde pase el tráfico y donde se decida a quién le
toca cada cosa. En una API, eso es una fachada: quien llama la ve siempre
igual, y por dentro una tabla dice qué atiende cada sistema.
facade.ts tiene la idea en unas 50 líneas, con
tres modos por prefijo de ruta:
//   legacy       lo atiende el sistema viejo
//   shadow       responde el viejo y, en segundo plano, se compara con el nuevo
//   replacement  lo atiende el sistema nuevo
export function modeFor(path: string, routes: readonly Route[]): Mode {
  return routes.find((route) => path.startsWith(route.prefix))?.mode ?? 'legacy';
}
El modo shadow es la idea más útil de esa tabla. El usuario sigue recibiendo
lo que responde el sistema viejo, pero la fachada también le pregunta al nuevo
y compara. Es la prueba diferencial de la semana 10, con el tráfico real como
generador. Y solo se hace en lecturas:
// Solo lecturas: un POST mandado a los dos sistemas haría dos reservas.
if (mode === 'shadow' && req.method === 'GET') {
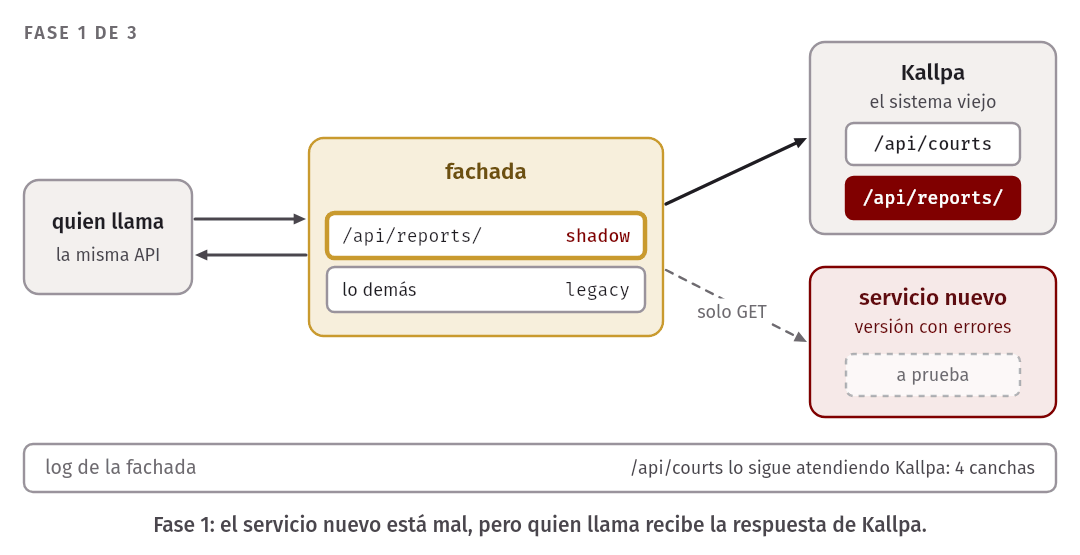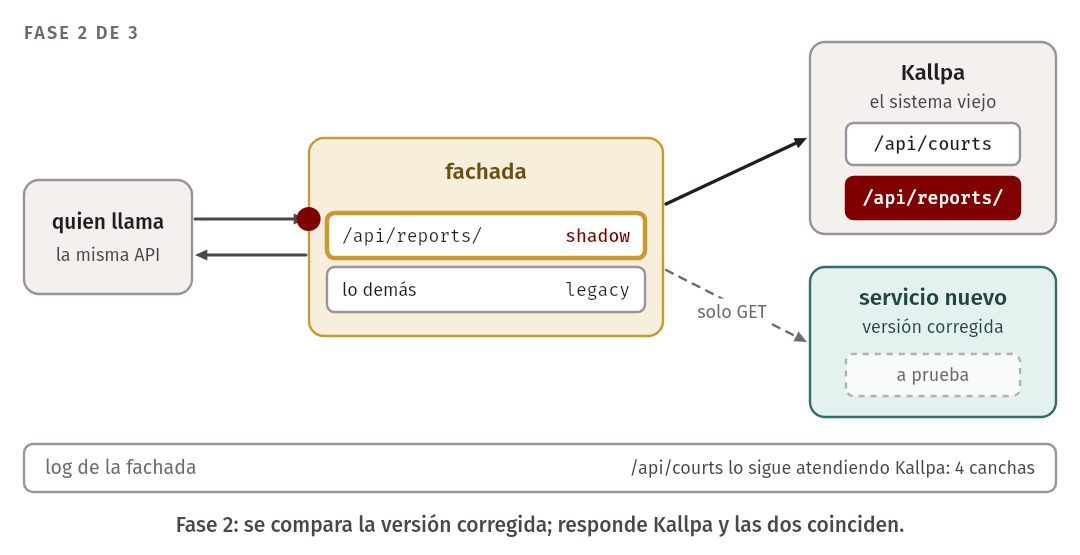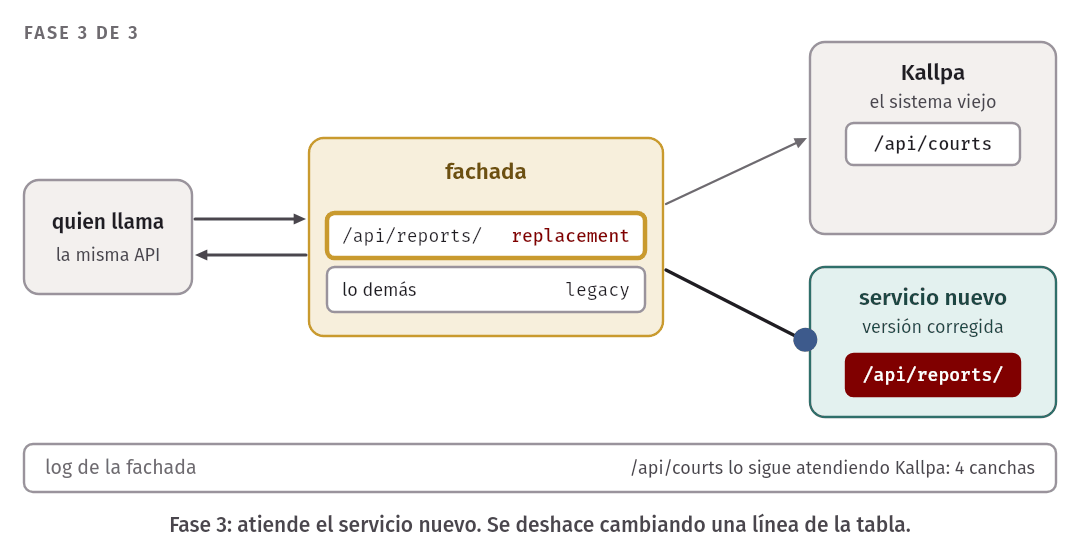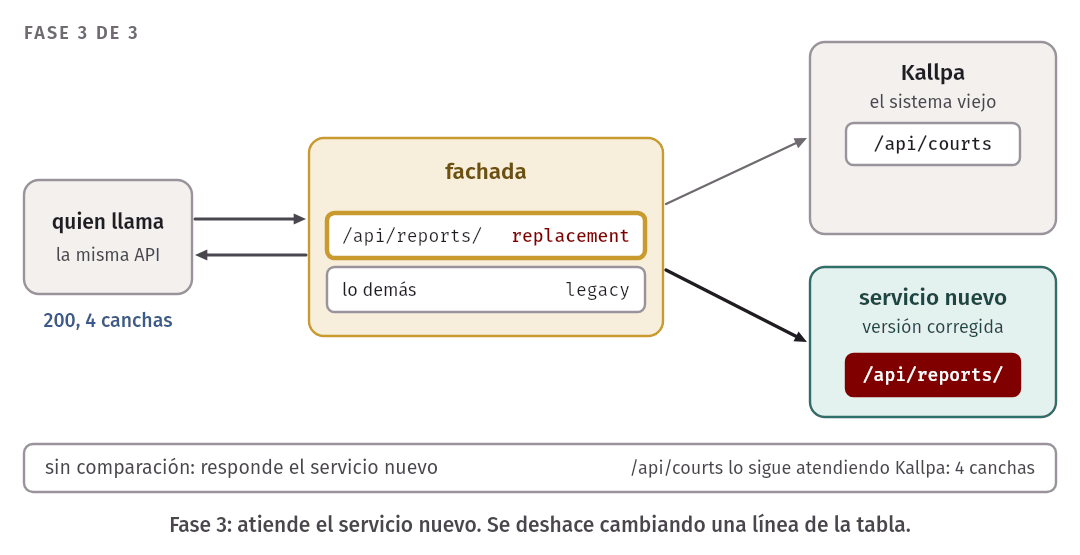
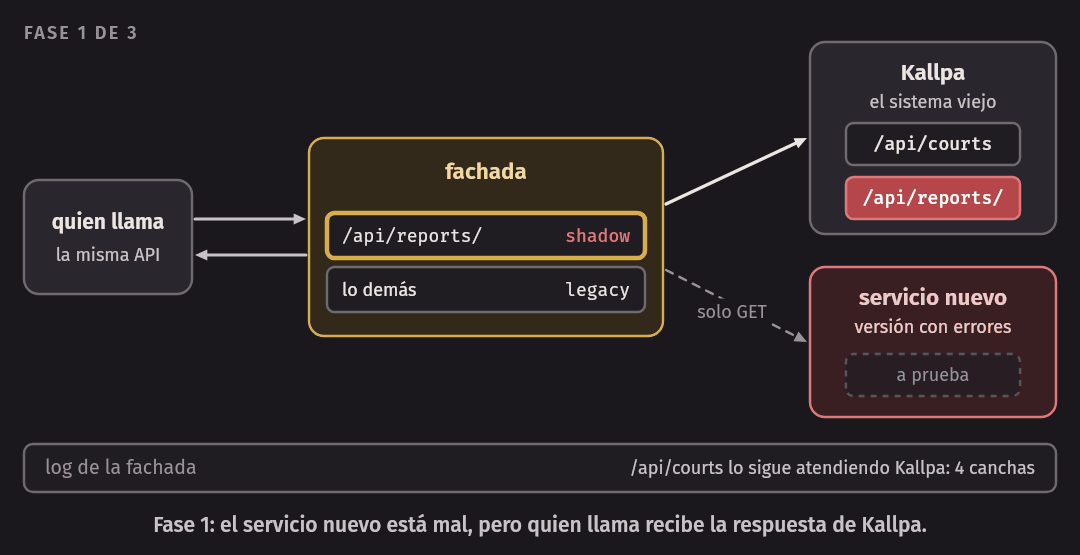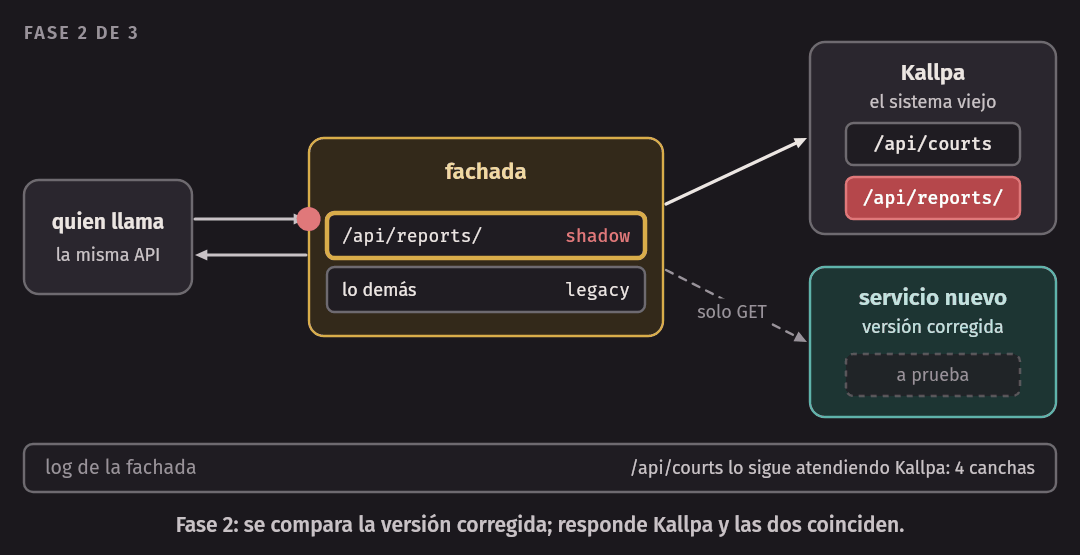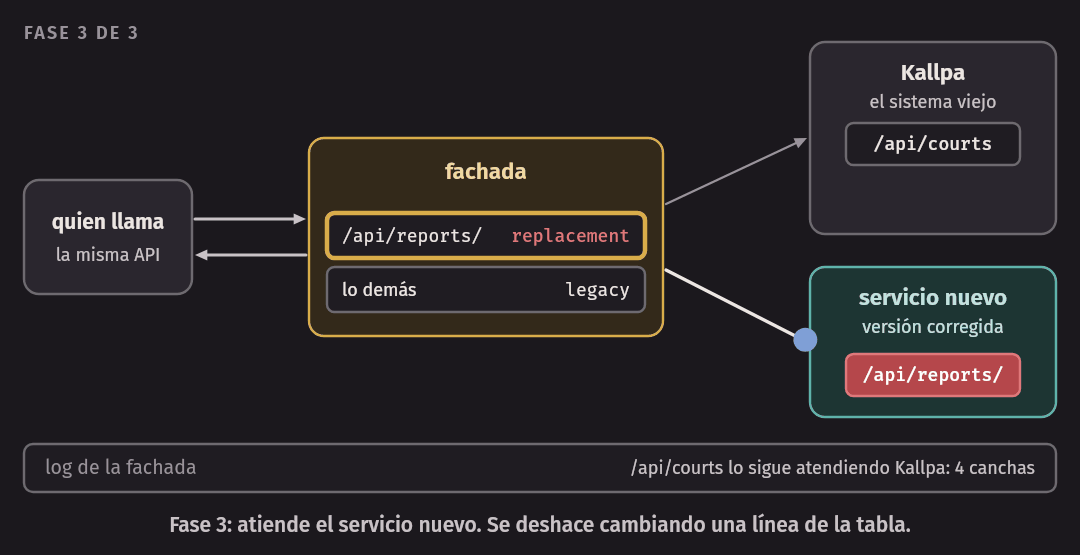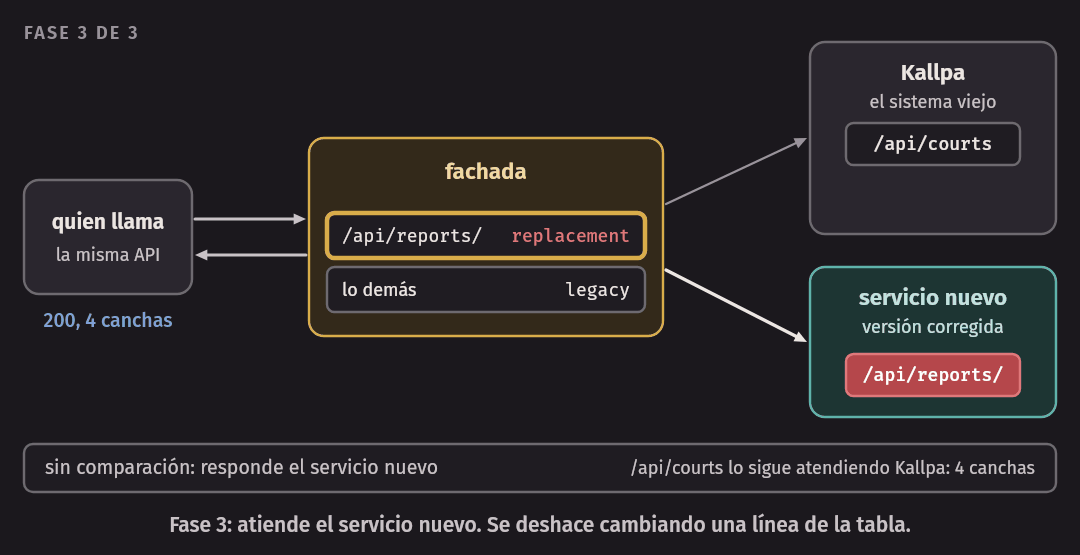
make facade muda la caja del día a un servicio nuevo, por fases. En la
primera se compara la versión con errores que vimos arriba (salida recortada
con ...):
=== Fase 1: se compara la versión con errores (/api/reports/ en modo shadow)
SHADOW-DIFF /api/reports/daily?date=2026-03-06
  2026-03-06: 200, 4 canchas
SHADOW-DIFF /api/reports/daily?date=2026-03-08
  2026-03-08: 200, 4 canchas
...
  /api/courts lo sigue atendiendo Kallpa: 4 canchas

=== Fase 2: se compara la versión corregida (/api/reports/ en modo shadow)
SHADOW-OK /api/reports/daily?date=2026-03-06
  2026-03-06: 200, 4 canchas
...
=== Fase 3: atiende el sistema nuevo (/api/reports/ en modo replacement)
  2026-03-06: 200, 4 canchas
...
  /api/courts lo sigue atendiendo Kallpa: 4 canchas
Lean la fase 1 con cuidado. El servicio nuevo está mal, pero quien llama sigue viendo las 4 canchas, porque la respuesta es la del sistema viejo: el error se encontró sin que nadie lo sufriera. Cada fase se puede deshacer cambiando una línea de la tabla, igual que un feature flag de la semana 13. Y la última línea de cada fase importa: el resto de la API nunca se enteró.
Fowler y sus colegas agregan algo importante: el objetivo tiene que estar claro desde el principio, y hay que ir aprendiendo a descomponer el sistema viejo. Una migración gradual que nunca termina deja dos sistemas para siempre, que es lo peor de los dos mundos. Tampoco exige microservicios: el nuevo puede ser un módulo del mismo proceso, y las “rutas” pueden ser una llamada a una interfaz.
Parallel change
El parallel change (cambio en paralelo, también expand and contract) sirve para hacer un cambio incompatible en una interfaz sin romper a nadie, en tres etapas:
- Expandir. Se agrega la forma nueva sin quitar la vieja.
- Migrar. Se pasa a cada uso a la forma nueva. Con clientes externos, es la etapa más larga.
- Contraer. Cuando ya nadie usa la vieja, se quita.
Danilo Sato, en el artículo, señala dos ventajas: el sistema se puede liberar en cualquiera de las tres etapas, lo que lo hace natural con entrega continua; y aun cuando controlan todos los usos, evita que el cambio rompa todo el código de golpe.
La semana 6 dejó planteado un caso real. GET /api/members/:id/bookings
devuelve un arreglo suelto, mientras GET /api/courts devuelve un objeto; no
se le puede agregar paginación sin romper a quien llama. Ahí escribimos
v2-bookings.diff, el paso de expandir. Aquí lo llevamos hasta el final, con
tres diffs que se aplican en orden en
parallel/.
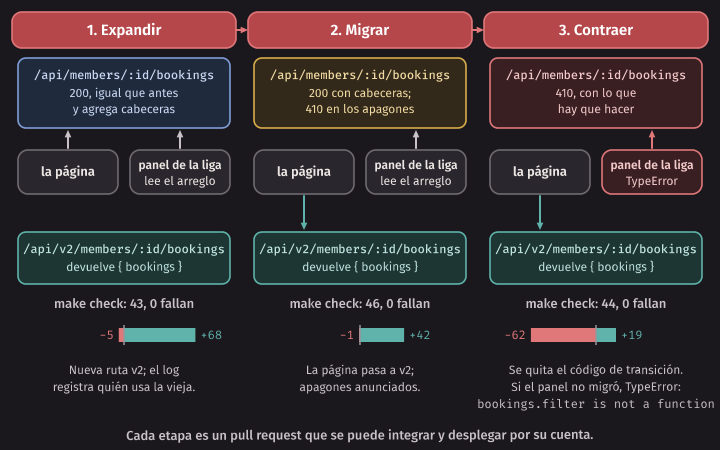
| Etapa | Qué cambia | Pruebas de make check |
|---|---|---|
1-expandir.diff |
Nueva /api/v2/...; la vieja responde igual y agrega cabeceras; el log registra quién la usa |
43, 0 fallan |
2-migrar.diff |
La página pasa a v2; apagones anunciados en la vieja | 46, 0 fallan |
3-contraer.diff |
La vieja responde 410 con lo que hay que hacer; se quita el código de transición |
44, 0 fallan |
Cada etapa es un pull request que se puede integrar y desplegar por su cuenta. Así se ve la historia y lo que toca cada uno (el mismo orden de la tabla):
ff4e2d6 Contraer
3ba375e Migrar
a3017d2 Expandir
c010cc2 Kallpa publicada

 README.md            |  3 ++-
 src/http/handlers.ts | 26 ++++++++++++++++++++++----
 src/http/server.ts   |  4 ++++
 test/v2.test.ts      | 40 ++++++++++++++++++++++++++++++++++++++++
 4 files changed, 68 insertions(+), 5 deletions(-)

 public/app.js           |  2 +-
 src/http/handlers.ts    | 15 +++++++++++++++
 test/v2-migrado.test.ts | 26 ++++++++++++++++++++++++++
 3 files changed, 42 insertions(+), 1 deletion(-)

 README.md               |  3 ++-
 src/http/handlers.ts    | 31 +++++--------------------------
 src/http/server.ts      |  6 ++----
 test/v2-migrado.test.ts | 17 -----------------
 test/v2.test.ts         | 24 ++++++++++--------------
 5 files changed, 19 insertions(+), 62 deletions(-)
La última cifra es de las que dan gusto: la etapa de contraer quita más de lo que agrega. Eso es lo que paga el trabajo.
Para ver qué siente quien llama,
parallel/cliente-panel.ts es un
cliente que no está en el repositorio: el panel de la liga de fulbito,
escrito por otro equipo cuando la ruta devolvía un arreglo. make etapas lo
corre contra cada etapa:
$ make etapas
...
=== etapa 1
GET /api/members/5/bookings → 200
  deprecation: @1798761600
  sunset: Sat, 01 Jan 2028 00:00:00 GMT
  link: </api/v2/members/5/bookings>; rel="successor-version"
GET /api/v2/members/5/bookings → 200, 1 reservas
panel de la liga: [ '2026-03-10 9:00 Las Matadoras' ]

=== etapa 2
GET /api/members/5/bookings → 200
  deprecation: @1798761600
  sunset: Sat, 01 Jan 2028 00:00:00 GMT
  link: </api/v2/members/5/bookings>; rel="successor-version"
GET /api/v2/members/5/bookings → 200, 1 reservas
panel de la liga: [ '2026-03-10 9:00 Las Matadoras' ]

=== etapa 3
GET /api/members/5/bookings → 410
GET /api/v2/members/5/bookings → 200, 1 reservas
panel de la liga: TypeError: bookings.filter is not a function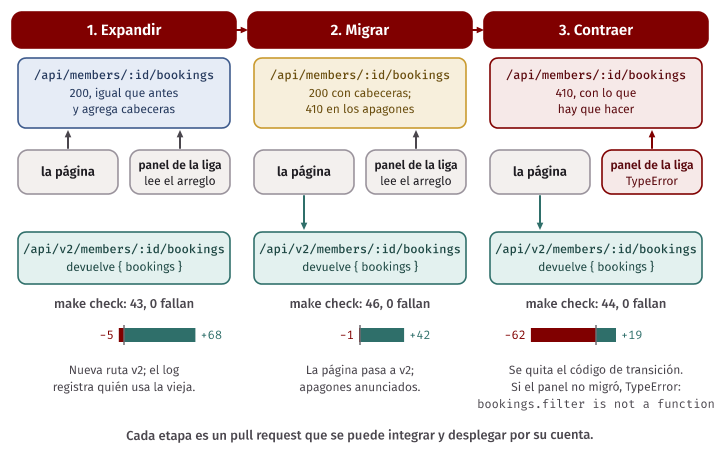
Cómo saber cuándo contraer
La pregunta dura del parallel change es cuándo ya nadie usa lo viejo. La
semana 6 dejó apuntado el límite: contando líneas del log se sabe cuánto
se usa una ruta, pero no quién. Kallpa no tiene autenticación. Lo mínimo
es registrar la cabecera User-Agent en una línea aparte, cada vez que se
sirve algo deprecado:
// Para saber quién sigue usando lo deprecado. Sin el número de vecino: no hace falta.
if (res.hasHeader('Deprecation')) log(`DEPRECATED /api/members/:id/bookings ua="${req.headers['user-agent'] ?? '?'}"`);
Fíjense en que el log no guarda la ruta real, con el número de vecino: cuando se mide algo así, no hay por qué dejar en los logs un dato que la pregunta no necesita (la semana 15 lo llamó proporcionalidad). Con varios clientes haciendo solicitudes, la cuenta sale así:
=== quién sigue usando la ruta vieja (etapa 1)
   3 DEPRECATED /api/members/:id/bookings ua="panel-liga/1.2"
   2 DEPRECATED /api/members/:id/bookings ua="Mozilla/5.0"
   1 DEPRECATED /api/members/:id/bookings ua="script-contador"
Es útil y tiene límites que hay que decir. User-Agent lo escribe quien
llama, y puede ser cualquier cosa o nada: un fetch de Node dice solo node.
Mozilla/5.0 no dice qué persona ni qué página. Con una API con
autenticación, lo correcto es contar por cliente. Y un mes en cero no prueba
que el uso sea cero: un script de fin de año se corre una vez al año. Por eso
vienen los apagones.
Contraer antes de tiempo
¿Qué pasa si se apuran? make apurados aplica la etapa 3 sin la migración
de la página: es lo que pasaría si alguien saltara la etapa 2 porque “ya casi
nadie la usa”.
$ make apurados
ℹ tests 43
ℹ pass 43
ℹ fail 0
57:  const bookings = await api(`/api/members/${memberSelect.value}/bookings`);
make check en verde, y la lista de “mis reservas” rota para todos los
vecinos, porque la página sigue llamando a la ruta que ahora responde 410 y
ninguna prueba de Kallpa abre la página. Un pipeline en verde no sabe lo que
no se probó: la regla de Beyoncé de nuevo, desde el lado de quien sufre. Por
eso la etapa 2 agrega test/v2-migrado.test.ts, que falla si la página vuelve
a mencionar la ruta vieja.
Error común. Quedarse en la etapa 2. Es muy cómodo: todo funciona, ya no hay urgencia, y el código de transición se queda para siempre, con dos rutas, dos pruebas y un
if. Sin la etapa de contraer se pagó el costo de la migración y no se cobró el beneficio. Si van a empezar, pongan fecha y owner a la tercera etapa.
Migraciones de la base de datos
La misma regla vale para el esquema, y aquí el tema es más delicado porque los datos no se pueden “desplegar de nuevo”. La semana 13 lo dejó planteado: un rollback solo es posible si la versión anterior del código puede correr sobre el esquema nuevo. Durante cada despliegue, además, puede haber un momento en que conviven las dos.
Kallpa ya sigue la primera parte de la regla, y lo dice un comentario en
src/store/database.ts: las migraciones se agregan al final, nunca se edita
una que ya corrió. La segunda parte es que cada migración sea compatible con
la versión anterior del código.
Supongamos que members.phone debe llamarse whatsapp. La forma directa es
un RENAME COLUMN. La gradual, un ADD COLUMN, primero, con la columna vieja
viva:
// Compatible: solo agrega. La columna nueva acepta NULL, porque el código anterior
// va a seguir insertando vecinos sin llenarla.
export const EXPAND_WHATSAPP = `
  ALTER TABLE members ADD COLUMN whatsapp TEXT;
  UPDATE members SET whatsapp = phone;
  PRAGMA user_version = 3;
`;
make migraciones corre el código publicado de Kallpa sobre cada una:
RENAME COLUMN: el código anterior falla: no such column: phone
ADD COLUMN: el código anterior lista 10 vecinos
user_version: 3; el código anterior solo conoce 2 migraciones
insertó el código anterior: { id: 11, name: 'Vecina del rollback', whatsapp: '900000001' }
insertó el código nuevo: { id: 12, name: 'Vecina nueva', whatsapp: '900000002' }
DROP COLUMN: el código anterior falla: no such column: phone
La primera línea es un rollback imposible: aun volviendo a la imagen anterior,
la aplicación no puede leer ni a un vecino. Y fíjense en la tercera: migrate
de Kallpa solo avanza, así que abrir con el código viejo una base de datos con
una versión más nueva no hace nada y funciona. Eso se puede dar por supuesto
solo porque hay una prueba
(migraciones.test.ts).
Las líneas cuarta y quinta muestran por qué durante la transición el código
nuevo lee con respaldo y escribe en las dos. El código anterior puede
seguir corriendo un tiempo e insertar vecinos sin whatsapp:
const row = db.prepare('SELECT id, name, COALESCE(whatsapp, phone) AS whatsapp FROM members WHERE id = ?').get(id);El orden completo, en el tiempo:
| Paso | Base de datos | Código | ¿Se puede volver atrás? |
|---|---|---|---|
| 1. Expandir | ADD COLUMN whatsapp, se copia lo que hay |
Sin cambios | Sí |
| 2. Escribir en las dos | Igual | Escribe en las dos, lee whatsapp con respaldo a phone |
Sí |
| 3. Rellenar | UPDATE de las filas con whatsapp en NULL |
Igual | Sí |
| 4. Solo la nueva | Igual | Lee y escribe solo whatsapp |
Sí, a la versión del paso 2 |
| 5. Contraer | DROP COLUMN phone |
Igual | No: es el último paso, cuando nadie va a volver a una versión que lea phone |
El último renglón de la salida de make migraciones lo muestra: después de
contraer, la puerta del rollback se cerró, y está bien, siempre que se haga a
propósito y con un respaldo de la base de datos.
Idea clave. Las tres técnicas son la misma idea a distintas escalas. El strangler fig es para un sistema; el parallel change, para una interfaz; y las migraciones que solo agregan, para un esquema. En todas, nunca hay un momento en que todo cambia a la vez, y en cada paso el sistema funciona y se puede volver al anterior.
Deprecación
Qué es y por qué cuesta
SWEG llama deprecación al proceso ordenado de migrar a los usuarios de un sistema obsoleto y finalmente retirarlo. No es lo mismo que marcar algo como viejo, y esa confusión causa la mayoría de sus fracasos.
Es más difícil de lo que parece, por varios motivos que el capítulo enumera:
- La ley de Hyrum. “removing a system can be thought of as the ultimate change”: no se está cambiando un comportamiento, se lo está quitando por completo. Van a aparecer dependientes que nadie esperaba, usando cosas que solo “funcionan por casualidad”.
- Lo nuevo nunca es igual a lo viejo. Si fuera idéntico no aportaría nada, así que cada uso hay que evaluarlo en el contexto del sistema nuevo.
- Cariño por lo viejo. En Google se encontraron con ingenieros que respondían “I like this code!”.
- La política. Mantener un equipo dedicado a quitar cosas cuesta dinero visible, y el costo de dejar el sistema viejo no se ve en ninguna planilla.
- Y un dato de escala: una organización tiene un límite de deprecaciones simultáneas que aguanta. Hay que elegir, y terminar las que se empezaron.
Tampoco todo lo viejo merece irse. SWEG usa de ejemplo LaTeX, que lleva décadas de mejoras: que sea antiguo no lo vuelve obsoleto. La deprecación conviene cuando el sistema es demostrablemente obsoleto y existe un reemplazo comparable.
Advisory y compulsory
SWEG divide las deprecaciones en dos zonas de un mismo continuo:
| Advisory (recomendada) | Compulsory (obligatoria) | |
|---|---|---|
| Fecha límite | No tiene | Sí, y se hace cumplir |
| Recursos | Nadie dedicado a migrar | Un equipo que ayuda a migrar |
| Qué logra | Avisa que hay algo nuevo; desanima usos nuevos | Termina con el sistema |
| Cuándo sirve | El sistema nuevo es tan superior que la gente se muda sola | Cuando el sistema se tiene que apagar |
| Su riesgo | Nunca termina. “Hope is not a strategy” | Sin apoyo se vuelve un unfunded mandate: obligar a otros a trabajar gratis |
La experiencia de Google es poco alentadora para la primera: una advertencia de deprecación puede llevar a (ligeramente) menos usos nuevos, pero rara vez hace que los equipos migren por su cuenta. Quien quiere de verdad retirar algo tiene que hacer el trabajo o ayudar a hacerlo.
Lo que suena contraintuitivo, y SWEG lo señala así, es que la obligatoria escala mejor cuando un solo equipo de expertos, normalmente el owner del sistema viejo, hace las migraciones de los demás. Ese equipo acumula experiencia y herramientas. Y un dato incómodo: si el último usuario es un sistema crítico que puede vetar la fecha, la deprecación no era tan obligatoria.
Avisos que sirven
Una advertencia de deprecación tiene dos propiedades, según SWEG: tiene que ser accionable (quien la lee sabe el siguiente paso, en la práctica y no en teoría) y relevante (aparece cuando la persona puede hacer algo). Avisar de una función deprecada mientras se escribe el código ayuda; un correo el fin de semana anterior al apagón, no. Y los avisos que se acumulan terminan ignorados: lo que en medicina se llama fatiga de alertas.
En HTTP, dos RFC dan las cabeceras, que ya vieron en la semana 6:
Deprecation: @1798761600
Sunset: Sat, 01 Jan 2028 00:00:00 GMT
Link: </api/v2/members/5/bookings>; rel="successor-version"Deprecation(RFC 9745) dice desde cuándo el recurso está (o estará) deprecado, como@y un tiempo Unix. El RFC recalca que no cambia nada: “The act of deprecation does not change any behavior of the resource”.Sunset(RFC 8594) dice cuándo se espera que deje de responder, como fecha HTTP. RFC 9745 aclara que ese formato distinto es “for historical reasons”, y que la fecha no puede ser anterior aDeprecation.Linkapunta al reemplazo. También existen las relacionesrel="deprecation"yrel="sunset", para enlazar la política o la guía de migración. Eso hace al aviso accionable.
Y sus límites, que los RFC dicen explícitamente: estas cabeceras son
indicios (hints). Sunset no garantiza que el recurso esté disponible
hasta esa fecha ni que deje de estarlo después, y los clientes tienen que
funcionar sin ellas. Casi ningún cliente las lee por su cuenta: el panel de la
liga no mira ninguna cabecera, y por eso siguió llamando hasta el último día.
Sirven para quien va a mirar, para las herramientas y para dejar constancia.
No reemplazan avisarle a la persona.
En el código de TypeScript, la marca equivalente es @deprecated en un
comentario:
/**
 * @deprecated Redondea mal los céntimos. Usen `formatSoles(cents)`, que recibe céntimos.
 */
export function toSoles(amount: number): string {
tsc no se queja por eso: el editor lo tacha y nada más. Si quieren que
moleste, está la regla no-deprecated de typescript-eslint, que necesita
información de tipos (semana 11):
$ eslint --no-config-lookup -c eslint.deprecado.js ejemplos/deprecado.ts

/work/code/week-16/ejemplos/deprecado.ts
  14:22  error  `toSoles` is deprecated. Redondea mal los céntimos. Usen `formatSoles(cents)`, que recibe céntimos  @typescript-eslint/no-deprecated

✖ 1 problem (1 error, 0 warnings)
Encontrar a los dependientes y evitar que vuelvan
SWEG clasifica las herramientas de una deprecación en tres grupos:
Descubrir. ¿Quién lo usa, y cómo? Con búsqueda de código para lo que está
en sus repositorios, y con logs y muestreo en producción para lo dinámico. Es
la medición de arriba. Como quedan dependientes que ni ellos mismos saben que
lo son, Google anuncia apagones planificados, cada vez más largos antes de
la fecha. Lo que se rompe en ese rato es la lista de pendientes que ninguna
herramienta encontró. La etapa 2 de Kallpa los tiene, con el Clock como
costura para probarlos sin esperar a septiembre de 2027:
export const MEMBER_BOOKINGS_V1_BROWNOUTS = [
  { from: '2027-09-01T15:00:00Z', to: '2027-09-01T16:00:00Z' },
  { from: '2027-10-05T15:00:00Z', to: '2027-10-05T21:00:00Z' },
  { from: '2027-11-02T13:00:00Z', to: '2027-11-03T13:00:00Z' },
];
Durante esas ventanas, la ruta vieja responde lo mismo que responderá después
(410), con un mensaje que dice qué hacer. Una hora, seis horas, un día.
Migrar. Las mismas herramientas de los cambios a gran escala, que vienen en la siguiente sección.
Prevenir el retroceso. La parte que más se olvida. Si mientras se migran
los usos viejos alguien agrega uno nuevo, copiado de un ejemplo que encontró
en el repositorio, esto se vuelve un juego sin fin (SWEG lo llama
whack-a-mole). Conviene que el retroceso lo impida una máquina y no una
persona. Con la regla de ESLint que ya conocen de la semana 11, en
eslint.retroceso.js:
$ make -s retroceso

/work/code/week-16/ejemplos/pagina-nueva.js
  3:32  error  GET /api/members/:id/bookings está deprecada y deja de responder el 1 de enero de 2028. Usen /api/v2/members/:id/bookings, que devuelve { bookings }  no-restricted-syntax

✖ 1 problem (1 error, 0 warnings)
Es accionable (dice qué usar), relevante (aparece al escribirlo) y solo avisa en lo que se está agregando.
Owners e hitos
Otras dos lecciones que SWEG dice haber aprendido por las malas. Sin owners explícitos, la deprecación no avanza, y delegarla en los usuarios la convierte en una advisory que nunca termina. Y hacen falta hitos intermedios: si lo único que se mide es “apagado”, el equipo trabaja meses sin ver avance y el logro final no lo nota nadie, porque en ese momento ya nadie lo usa.
Un plan pequeño para la ruta de Kallpa, con todo esto junto:
| Cuándo | Qué | Hito que se mide |
|---|---|---|
| Etapa 1 | Se publica v2, cabeceras, medición. Aviso a los equipos conocidos | Línea base de usos de v1 por User-Agent |
| Etapa 2 | Se migra la página. Se ayuda a migrar al panel de la liga. Regla anti-retroceso | La página, en cero; el panel, migrado |
| Sep., oct. y nov. de 2027 | Apagones de 1 h, 6 h y 24 h, anunciados | Aparecen o no dependientes nuevos, y cuántos |
| 1 de enero de 2028 | Etapa 3: 410 con el mensaje |
Código de transición borrado |
| Unos meses después | Se quita también el 410 |
Una ruta menos que mantener |
¿Y si llega la fecha y sigue el panel de la liga, que es de alguien importante? Eso se decide con datos a la vista, y es lo honesto: se mueve la fecha, se migra por ellos, o se apaga. Lo que no se hace es no decidir.
En la industria. SWEG cuenta el caso de los sistemas sin owner: proyectos que sus autores abandonaron porque ya hay un reemplazo y siguen corriendo “en el sótano”, como dependencia de algo crítico. No desaparecen solos, y fallan en el peor momento. Por eso propone preguntarse desde el diseño: ¿qué tan fácil será para mis usuarios migrar a un reemplazo? ¿Puedo reemplazar partes de mi sistema una a una? Y da un ejemplo de otra ingeniería: al diseñar una central nuclear se planifica y se aparta dinero para su desmantelamiento.
Cuando el cambio toca miles de archivos
SWEG llama large-scale change (LSC) a cualquier conjunto de cambios lógicamente relacionados que en la práctica no se pueden enviar como una sola unidad atómica. La definición no da un número de archivos: lo que importa es esa imposibilidad, que aparece por varias razones. Las herramientas no aguantan un commit de ese tamaño; al crecer tanto, siempre tendrá conflictos de merge; correr todas las pruebas afectadas tarda demasiado, y antes de que termine ya cambió algo. El capítulo observa algo contraintuitivo: mientras más crecen el código y el equipo, más chico se vuelve el cambio atómico más grande posible.
En Google son casi siempre generados por herramientas, y se usan para quitar antipatrones, reemplazar lo deprecado o actualizar infraestructura. En un recuadro del capítulo, Adam Bender dice que es común que entre el 10 % y el 20 % de los cambios de un proyecto vengan de un LSC. Su proceso tiene cuatro fases:
- Autorización. Un documento breve con el motivo, el impacto estimado y respuestas a lo que preguntarían los revisores, que aprueba un comité pequeño.
- Creación del cambio. Lo más automatizado posible, para poder regenerarlo cuando alguien vuelva a usar lo viejo o aparezcan conflictos.
- Manejo de los fragmentos. La herramienta de Google (Rosie) divide el cambio por proyecto y por owner en fragmentos (shards) que se prueban, se revisan y se integran por separado.
- Limpieza. Quitar lo viejo y evitar que vuelva.
SWEG usa aquí la analogía de cattle versus pets: un cambio hecho a mano es una mascota, que se cuida uno por uno; los de un LSC son ganado. Y su recuadro advierte algo que tiene consecuencias para cualquier equipo: sin buenas pruebas, este trabajo sería imposible, porque quienes lo hacen no conocen los proyectos que tocan.
Ustedes no tienen miles de archivos, pero el problema aparece mucho antes.
Veamos el cambio mecánico más simple del mundo en Kallpa: renombrar el campo
priceCents de Booking a totalCents, de dos formas. make renombrar lo
hace en copias, con sed y con el servicio de lenguaje de TypeScript, el
mismo que usa el editor para “renombrar símbolo”:
=== 1. Con sed, en todo el repositorio
  tsc: sin errores
  pruebas: 40 pasan, 0 fallan
  handlers.ts: totalCents: row.price_cents
  quedan con priceCents: ninguno

=== 2. Con el servicio de lenguaje de TypeScript
   1 src/domain/booking.ts
   1 src/domain/report.ts
   2 src/http/handlers.ts
   3 test/report.test.ts
  tsc: sin errores
  pruebas: 39 pasan, 1 fallan
  ✖ API de Kallpa (32.045541ms)
  ✖ failing tests:
  quedan con priceCents: src/http/handlers.ts, src/notifications/notifier.ts, test/http.test.ts, public/app.js
El caso 1 es el más peligroso: todo en verde y el cambio es incompatible.
sed renombró también el JSON de la API, la página y las pruebas, de modo que
todo sigue coincidiendo dentro del repositorio. El panel de la liga, que lee
priceCents, se rompió, y nada lo dice. Además renombró un campo de otro tipo
(BookingConfirmation en notifier.ts) que no tenía nada que ver.
El caso 2 es más preciso y por eso más revelador. La herramienta cambió solo
las referencias reales, y dejó notifier.ts tranquilo. tsc pasa. Pero no
puede ver lo que no tiene tipos: test/http.test.ts lee
body.booking.priceCents con un any, y public/app.js es JavaScript. Una
prueba falla, y la página queda rota. Es un buen resumen de la semana 11: la
herramienta solo llega hasta donde llega la información de tipos.
La lección no es “use tal herramienta”. Un campo de la API no es un nombre interno: es un contrato, y cambiarlo es un parallel change, no un renombre. Si fuera interno, cualquiera de las dos serviría.
¿Cómo se parte un cambio así para que se pueda revisar? Primero expandir (el tipo acepta las dos formas, o un alias), después un pull request por módulo o por owner, cada uno con el check en verde, y después contraer. Si un fragmento no pasa solo, no es un fragmento.
Con IA. Aquí los agentes rinden de verdad, en un sentido preciso: un LSC es un trabajo mecánico y repetido, que una herramienta hace sin aburrirse. Pero la condición es la de SWEG. Hacen falta pruebas que caractericen el comportamiento antes de empezar; sin ellas, se obtiene un diff enorme que nadie puede verificar y que además “pasa”. Antes de pedirle a un agente que renombre un campo en 300 archivos: escriban lo que no debe cambiar (el JSON, por ejemplo), corran el cambio en fragmentos que quepan en una revisión, y revisen la regla de transformación y una muestra, en lugar de 300 archivos. Si la transformación se puede escribir como un programa determinista (un codemod), mejor: el programa se revisa una vez y se puede volver a correr. Por último, no confundan las cifras: una herramienta de texto que dice “300 archivos actualizados” no dice que estén bien.
Lo que el equipo no entiende
Dos ideas para cerrar la sesión, que juntan el capítulo y el curso.
La primera. El código que el equipo aceptó sin entender es código heredado desde el día en que se hizo commit. Vuelvan a la definición: el problema del código heredado es no poder cambiarlo sabiendo lo que pasa. Si nadie en el equipo sabe por qué algo está así, ni qué se rompe si se toca, eso es lo que tienen, aunque tenga una semana de vida y una suite en verde. Las pruebas generadas junto con el código ayudan menos de lo que parece: la semana 10 explicó que no son un oráculo independiente.
La segunda. La definición de Feathers no se resuelve generando pruebas. Una suite que nadie leyó fija un comportamiento que nadie decidió. Sirve como caracterización, si se la trata como tal: una red para no cambiar nada sin querer, y no una prueba de que está bien.
Por eso la defensa oral de este curso pregunta lo que pregunta.
Presentaciones finales
Qué contar
La presentación final de P5 no es un recorrido por las pantallas. “Aquí está el botón de login, aquí está la lista” no le dice nada a nadie que no haya visto ya una lista. Tiene un hilo, que es el del curso: el problema del cliente, lo que se construyó para resolverlo, y cómo se sabe que funciona.
Una estructura que funciona, en el tiempo que publique el docente:
- El problema, en palabras del cliente. Quién es, qué hacía antes, qué le dolía. Una historia concreta vale más que tres adjetivos.
- La demo: el producto desplegado, haciendo una tarea real del cliente, de principio a fin.
- Una decisión de diseño con las alternativas que se descartaron. Un ADR de verdad: por qué esto y qué se perdió.
- La evidencia de calidad. El pipeline, las pruebas que verifican la regla de negocio más difícil y el postmortem del incidente. No “tenemos pruebas”, sino “esta regla la entendimos mal hasta que esta propiedad falló”.
- El uso de IA, con datos del registro. En qué ayudó, qué se rechazó y por qué, y un caso en que una herramienta produjo algo incorrecto que pareció correcto, y cómo se descubrió.
- Qué se le entrega al cliente para que alguien más lo pueda mantener.
- La retrospectiva. Qué harían distinto en un proyecto nuevo, con un ejemplo concreto de cada sprint. Lo que no salió bien se cuenta igual, con lo que se aprendió.
Al final, las preguntas del curso y del cliente. Cualquier integrante responde cualquier pregunta. “Eso lo hizo mi compañero” no es una respuesta.
Error común. Una demo que depende de que nada falle. Se prepara con datos inventados conocidos (nunca los del cliente: la semana 15 explicó por qué), se prueba el día anterior en el mismo entorno, y se tiene un plan B: un video corto de la demo, por si la red o el despliegue fallan en la sala. Si algo falla en vivo, lo que muestran es cómo responden: miran el log, vuelven a la versión anterior, y siguen.
Lo que necesita quien venga después
El capítulo 3 de SWEG, sobre compartir conocimiento, describe los problemas que tiene cualquier equipo con unas palabras que conviene tener a la mano, porque van a reconocerlos en el suyo:
- Punto único de falla (single point of failure): información crítica que solo tiene una persona. Se relaciona con el bus factor que vieron en la semana 1 (cuántas personas pueden irse antes de que el proyecto se trabe). SWEG advierte que suele nacer de buenas intenciones: “déjame hacerlo a mí, que es más rápido” optimiza el corto plazo a costa de que el equipo nunca aprenda.
- Conocimiento tribal: lo que hay entre lo que la gente sabe y lo que está escrito. El “sin fecha sale mal de noche” de Doris es eso. Si se documenta y se mantiene, deja de depender de que esa persona esté.
- Islas de información: partes que no se hablan, con imágenes incompletas y sus propias versiones de cómo se hace algo.
Tampoco vale documentar todo y olvidarse de las personas: un experto responde lo que el documento no previó, y un documento mal mantenido engaña. SWEG dice que los dos se complementan. Y antes de todo eso pone la seguridad psicológica: si preguntar da vergüenza, nadie pregunta, y un README no lo arregla.
El README.md de P5, con ## Arquitectura, ## Cómo contribuir y ## Licencia, y el resto de la entrega, son el conocimiento del equipo puesto
donde lo encuentre alguien que nunca los conoció. El mejor examen lo dice el
enunciado: que alguien de otro equipo siga el README desde cero, en el
contenedor del curso, y anote dónde se trabó. El capítulo 10 de SWEG agrega un
criterio: la documentación es para un lector concreto, con un propósito, y hay
que mantenerla como el código, con owners y en revisión. Un README
desactualizado es peor que uno corto.
Idea clave. Piensen en la persona que hereda su proyecto un año después, con el mismo miedo que tuvieron ustedes frente al cierre de caja. ¿Puede correr las pruebas? ¿Sabe por qué se tomaron las decisiones raras? ¿Encuentra la deuda que ustedes ya conocían? La calidad de una entrega se mide en esas respuestas.
El laboratorio y el código de la semana
code/week-16
Corran make test dentro del contenedor. Aplica las tres etapas a copias de
Kallpa en build/, corre el make check de cada una, y comprueba lo que dice
este capítulo:
ℹ tests 40
ℹ suites 0
ℹ pass 40
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0| Archivo o carpeta | Qué tiene | Objetivo de make |
|---|---|---|
heredado/, cierre.test.ts |
El cierre de caja: original, con la costura y con el cambio pedido | make primera |
golden/, caja.test.ts |
Lo que responde hoy la caja y lo que imprime el cierre | make golden |
caja/ |
La caja en SQL, bien, y la ilustración con errores | make caja-agente |
facade.ts, facade.test.ts |
La fachada del strangler fig | make facade |
parallel/, etapas.test.ts |
Las tres etapas, el cliente viejo y la medición | make etapas, make apurados |
migraciones.ts, migraciones.test.ts |
Las migraciones que rompen y las que no | make migraciones |
demos/renombrar.ts |
El cambio mecánico, con sed y con tipos |
make renombrar |
eslint.retroceso.js, eslint.deprecado.js |
Prevenir el retroceso | make retroceso |
ensayo/ |
El ensayo de la defensa | make ensayo |
La defensa oral
El laboratorio de esta semana no tiene un enunciado de ejercicios: es la defensa oral de P5 (sección correspondiente), con el orden que publica el docente. Comprueba lo que dice la política del curso: cada integrante responde por todo lo que el equipo entregó, lo haya escrito a mano o con una herramienta. No se prepara una presentación. Se prepara el repositorio y se conoce el código.
Antes. Cada integrante clona el repositorio desde cero, en una carpeta
nueva. Corre npm ci, el check del equipo (npm run check), la revisión de
P5 (make -f /work/projects/p5-producto/Makefile check) y levanta el
producto. ¿Por qué un clon limpio, si en su laptop funciona? make ensayo lo
muestra con Kallpa, en una copia donde alguien usó un archivo que quedó en
.gitignore:
=== En la laptop de quien lo escribió
ℹ pass 40
ℹ fail 0
=== git status
0
=== En un clon limpio
src/config.ts(16,26): error TS2307: Cannot find module './holidays.local.ts' or its corresponding type declarations.
=== Después de subir lo que faltaba
ℹ pass 40
ℹ fail 0
Noten que git status no muestra nada (0 líneas): el archivo está ignorado,
así que ni parece que falte. “En mi computadora funciona” es exactamente la
frase que esta prueba desarma. Y cada integrante repasa las partes que no
escribió: los pull requests de los demás, los ADRs, la estrategia de pruebas,
el postmortem y el registro de uso de IA, y le pregunta al equipo lo que no
entiende.
Durante. Hay cuatro tipos de pregunta:
-
Explicar una parte elegida por el docente: un archivo, un pull request, una prueba, un ADR, una entrada del registro. Qué hace, por qué está así, qué alternativa se descartó, qué se rompería si se cambia. Esa última pregunta es la del código heredado: si no la pueden responder, tienen código heredado en su propio proyecto.
-
Un cambio en vivo. Una regla nueva, un campo, un mensaje de error. Una persona elegida en el momento lo hace en una rama, con su prueba, y corre
npm run check, explicando en voz alta. Si usa una herramienta de IA, explica y verifica cada línea que acepta. Sirve ensayarlo:make ensayotambién hace uno (un nombre de equipo tiene al menos 3 caracteres), con su prueba, en tres archivos:=== El cambio en vivo: un nombre de equipo tiene al menos 3 caracteres src/domain/booking.ts | 1 + src/http/handlers.ts | 5 +++-- test/nombre-equipo.test.ts | 14 ++++++++++++++ 3 files changed, 18 insertions(+), 2 deletions(-) ℹ pass 41 ℹ fail 0 -
La operación: dónde está desplegado, cómo se vuelve a la versión anterior, qué muestra el pipeline cuando falla, qué dice el postmortem.
-
Lo que no se hizo. Reconocer los límites del producto suma: lo que está en
## Pendienteslo eligieron ustedes.
Al terminar el laboratorio, cada integrante entrega la evaluación entre pares de su equipo.
Con IA. “Lo generó la herramienta” no es una respuesta. Si una parte del código la escribió un agente y hoy no la pueden explicar, léanla con la misma disciplina del cierre de caja: los puntos de cambio, qué se puede observar, qué pasa si se toca. Pueden pedirle a una herramienta que les haga preguntas sobre su propio repositorio, para practicar; pero las respuestas las tienen que dar ustedes, y se comprueban contra el código. Es la misma regla con que empezó este curso: quien entrega responde.
Resumen
- Mantenimiento es todo lo que se hace después de la primera entrega: correctivo, adaptativo, perfectivo y preventivo. Solo el primero arregla errores. Según SWEG, el código es un pasivo y la funcionalidad es el activo.
- Código heredado, según Feathers, es código sin pruebas. Para cambiarlo: puntos de cambio, puntos de prueba, romper dependencias, escribir pruebas y recién entonces cambiar. Una costura es un lugar donde se puede cambiar el comportamiento sin editar ahí.
- Una prueba de caracterización fija lo que el código hace hoy, no lo que debería. Si muestra algo raro, se anota como posible bug y se decide aparte: por la ley de Hyrum, alguien puede depender de eso. Solo protege lo que sus ejemplos recorren.
- Deuda técnica: un atajo que abarata hoy y encarece después; los intereses son ese costo extra. El cuadrante de Fowler cruza deliberada e inadvertida con imprudente y prudente, y se deduce de la decisión, no del código. La deuda se decide por su interés, y tiene que estar escrita: en issues, con costo y propuesta, y en ADRs.
- No reescriban todo: se pierde conocimiento, tarda más y hay que mantener dos sistemas. Strangler fig: el sistema nuevo crece detrás de la misma interfaz, con comparación en lectura antes de cambiar el tráfico. Parallel change: expandir, migrar, contraer, y cada etapa se puede integrar sola.
- Migraciones de la base de datos: solo se agregan al final, y cada una es
compatible con la versión anterior del código. Un
RENAME COLUMNhace imposible el rollback. Se cierra esa puerta al final y a propósito. - Deprecación: retirar cuesta, y por la ley de Hyrum siempre hay alguien.
Advisory avisa y nunca termina; compulsory tiene fecha y quien deprecia
ayuda a migrar. Hacen falta owners, hitos, descubrir usos, migrar y prevenir
el retroceso. Los avisos, accionables y relevantes.
DeprecationySunsetson indicios: no reemplazan avisarle a la persona. Los apagones planificados encuentran lo que nadie sabía. - Cambios a gran escala: los que no se pueden enviar como una unidad atómica. Con herramientas, en fragmentos que se revisan e integran por separado, y sobre pruebas. Un campo de la API no es un nombre interno: un renombre mecánico puede dejar todo en verde y romper a quien llama.
- Con IA: los agentes rinden en lo mecánico si hay pruebas que caractericen el comportamiento. Lo que el equipo aceptó sin entender es heredado desde el primer commit.
- La presentación cuenta el problema, la solución y cómo se sabe que funciona. La defensa comprueba que cualquiera del equipo explica y cambia cualquier parte. Prepárenla con un clon limpio.
Ejercicios
- Den un ejemplo de mantenimiento correctivo, adaptativo, perfectivo y preventivo en su proyecto. ¿Cuál hicieron menos este semestre? ¿Quién va a hacer cada uno después de que ustedes se vayan?
- En el cierre de caja, ¿es
KALLPA_DBuna costura? ¿Cuál es su punto de habilitación, es decir, dónde se decide qué base de datos se usa? Busquen en Kallpa dos costuras más y digan qué permite cada una probar. - Abran
heredado/cierre-de-caja.ts. Encuentren un comportamiento quecierre.test.tstodavía no fije (hay varios; por ejemplo, un nombre de equipo de más de 26 caracteres). Escriban la prueba de caracterización con la receta del fallo primero, y digan si parece un posible bug. - ¿Qué diferencia hay entre una prueba de caracterización y una unitaria escrita con TDD? Una caracterización muestra que la caja del 11 de marzo cobra S/ 120 por una reserva que según el README cuesta S/ 135. ¿Cambian la prueba, cambian el código, o ninguna de las dos? ¿Qué harían, y en qué orden?
- Corrijan el descuento doble del cierre, siguiendo lo que dice el capítulo: el issue, la pregunta, un pull request separado. ¿Qué pruebas cambian y cuáles no? ¿Cómo evitan que el cierre de esa noche sorprenda a quien lleva las cuentas?
- Ubiquen en el cuadrante de Fowler tres deudas de su proyecto. Para cada una
escriban el issue: cuánto cuesta hoy (con evidencia), qué propuesta tienen
y cuándo la pagarían. Corran
git log --format= --name-only | sort | uniq -c | sort -rn | heady digan si cambia su prioridad. - Planifiquen con parallel change un cambio de su propia API: qué se hace en cada etapa, qué cabeceras se agregan, cómo van a saber cuándo pueden contraer y qué pasa si se apuran.
- Sobre las etapas de
code/week-16: ¿qué registrarían en el log, en lugar deUser-Agent, si Kallpa tuviera autenticación? ¿Qué hace que un mes con cero usos no baste? Agreguen una prueba a la etapa 2 que falle siSunsetqueda antes queDeprecation. - Extiendan
facade.tspara enviar areplacementsolo un porcentaje de las lecturas, como un canary de la semana 13. ¿Qué tendría que pasar para subir ese porcentaje? ¿Cómo manejarían una escritura si la nueva versión tuviera su propia base de datos? - Escriban la secuencia de migraciones para partir
members.nameenfirst_nameylast_nameen Kallpa, sin perder la posibilidad de rollback en ningún paso hasta el último. Agreguen una prueba como las demigraciones.test.ts. ¿Qué pasa con los nombres de tres palabras? ¿Quién decide eso? - Un equipo quiere usar un agente para renombrar un campo en 300 archivos de
su repositorio. Escriban qué tiene que existir antes de empezar, cómo
partirían el cambio para poder revisarlo y qué mirarían en cada fragmento.
Comprueben qué de esto les habría cambiado el resultado de
make renombrar. - Ensayen la defensa de su equipo: una persona elige un archivo que otro integrante escribió, y le pide explicar qué hace, por qué está así, qué alternativa se descartó y qué se rompería si se cambia. Después pídanle un cambio en vivo con su prueba. Anoten lo que no supieron responder, y estudien eso.