Apuntes · Capítulo 6Diseño y arquitectura
APIs y patrones de diseño
APIs y patrones de diseño
La semana pasada repartieron el código de Kallpa en módulos y vieron que lo
que importa de un módulo es su interfaz: lo que los demás necesitan saber para
usarlo. Esta semana esa idea sale del proceso. Una API HTTP también es una
interfaz, pero tiene una diferencia que lo cambia todo: si en un refactoring
renombran un método, tsc les marca cada llamada y las corrigen en el mismo
pull request. Si renombran un campo de una API, quien la llama no está en su
repositorio, no se entera y su aplicación se rompe en el celular de alguien.
El capítulo tiene dos partes, como la semana. La primera es sobre APIs: cómo se diseñan alrededor de recursos, qué quieren decir seguro e idempotente, por qué un reintento puede cobrar dos veces y cómo lo evita una clave de idempotencia, cómo se usan los códigos de estado y los errores, qué cambios rompen a quien llama y cómo se hace convivir una versión vieja con una nueva. La segunda es sobre patrones de diseño: cuáles siguen vigentes, cómo se ven en TypeScript (a veces son solo una función) y cómo se decide no usarlos. En el laboratorio escriben la especificación OpenAPI de Kallpa tal como es hoy, con sus defectos, y proponen las mejoras aparte.
Lectura. Para la primera parte: Google, API Design Guide, en su versión actual, las AIP: AIP-121 (recursos), AIP-136 (métodos propios), AIP-158 (paginación) y AIP-180 (compatibilidad hacia atrás); los enlaces viejos, Standard methods y Errors, hoy redirigen a las AIP correspondientes. Microsoft, Azure REST API Guidelines: Exactly Once Behavior, Handling Errors, API Versioning y Repeatability of requests. RFC 9110, HTTP Semantics, sec. 9.2 (métodos seguros e idempotentes). Complementarias: RFC 9457 (Problem Details); el borrador de la IETF The Idempotency-Key HTTP Header Field; RFC 9745 (Deprecation) y RFC 8594 (Sunset). Para la segunda parte: Refactoring.Guru, Patrones de diseño (Strategy, Adapter, Decorator, Observer y Factory Method), y Martin Fowler, Inversion of Control Containers and the Dependency Injection pattern (2004). Complementarias: Peter Norvig, Design Patterns in Dynamic Languages (1996), y Martin Fowler, Repository. El código del capítulo está en
code/week-06y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Una API es un contrato; de Diseño orientado a recursos, Sustantivos primero y Los métodos estándar; de Seguro e idempotente, Las definiciones; de Por qué importa: la respuesta perdida, Lo único que sabe quien llama; de La clave de idempotencia, El protocolo; de Códigos de estado con significado, Los que van a usar; y de los patrones, Una solución con nombre y Strategy.
- En clase: Sesión A: Diseño orientado a recursos, Seguro e idempotente, Por qué importa: la respuesta perdida, La clave de idempotencia, Códigos de estado con significado, Errores que un programa pueda leer, Evolución y versiones y OpenAPI: el contrato por escrito. Sesión B: Patrones de diseño: qué siguen siendo, de Strategy a Factory Method, y Cuándo un patrón estorba. Laboratorio: El laboratorio: documentar la API de Kallpa.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: La frontera entre
400y422, Las decisiones que el código no toma por ustedes, Deprecar sin sorprender, Lo que dijo Norvig en 1996 y las lecturas del recuadro Lectura.
Una API es un contrato
Quien llama no está en la sala
Una API (application programming interface) es la parte de un sistema que otros programas usan para hablar con él. Aquí nos interesan las API HTTP: quien llama manda una solicitud (método, ruta, cabeceras y quizá un cuerpo) y recibe una respuesta (código de estado, cabeceras y quizá un cuerpo). La página de Kallpa es un cliente HTTP de su propia API; mañana podría serlo una aplicación de celular escrita por otra persona, o la hoja de cálculo con la que alguien de la administración lee la caja del día.
Esa API es un contrato en el sentido de la semana 4: dice qué pide cada operación y qué promete a cambio. Tiene dos rasgos que un contrato entre módulos no tiene:
- No se puede revisar a quien llama. Dentro de un repositorio,
tscy las pruebas encuentran a todos los que usan una función. Fuera, no hay manera de saber quién usa qué. - No se puede actualizar a todos a la vez. Un cambio en un módulo y en todos sus usuarios entra en un solo commit. Una aplicación instalada en mil celulares se actualiza cuando sus dueños quieren.
Por eso una API se diseña con más cuidado que una interfaz interna y se cambia con reglas. Lo que cuesta poco al principio (un nombre, una forma de respuesta, un código de estado) puede ser carísimo un año después.
Todo lo observable termina en el contrato
En la semana 1 vimos la ley de Hyrum: con suficientes usuarios, todo comportamiento observable de un sistema termina siendo algo de lo que alguien depende, lo prometa o no el contrato. En una API eso incluye cosas que nadie pensó prometer:
- El orden de una lista:
GET /api/courtsdevuelve las canchas por nombre. Un cliente HTTP puede tomar la primera como “la cancha principal”. - El texto de un mensaje de error: el README de Kallpa dice que se compare
error.codey no el mensaje, pero alguien puede buscar la palabra “reservada” dentro demessage. - Un campo que sobra, o que falta cuando no aplica:
teamNameaparece en una hora ocupada y no aparece en una libre. Hay código que usa su presencia para saber si la hora está ocupada, sin leeravailable.
Una especificación no elimina el problema, pero le pone un borde: dice qué se promete. Lo que quede fuera todavía puede romper a alguien, pero ya no es una promesa rota.
Idea clave. Una interfaz interna se cambia y se corrige a quien la usa. Una API pública se cambia sin poder corregir a quien la usa. Las dos cosas se llaman “interfaz”, pero la segunda se parece más a una ley publicada que a una función.
Diseño orientado a recursos
Sustantivos primero
Hay muchas maneras de organizar una API. La que siguen la mayoría de las API HTTP públicas, y la que recomiendan las dos guías de esta semana, es el diseño orientado a recursos. AIP-121 lo plantea en este orden: primero se deciden los recursos (los sustantivos) que la API ofrece, después cómo se relacionan y al final qué operaciones tiene cada uno, usando en lo posible los verbos estándar.
Un recurso es una cosa con identidad a la que se le puede dar un nombre: una cancha, una reserva, un vecino. Una colección es un conjunto de recursos del mismo tipo. Las rutas nombran recursos y colecciones, y el método HTTP dice qué se hace con ellos:
GET  /api/courts                  la colección de canchas
GET  /api/courts/1/availability   algo que le pertenece a la cancha 1
GET  /api/members/2/bookings      las reservas del vecino 2
POST /api/bookings                agrega una reserva a la colección
La idea de fondo es la misma de los módulos profundos de la semana pasada:
pocas operaciones que se combinan. Quien ya sabe usar una colección sabe usar
todas. Si cada operación tuviera su propio verbo (getCourts,
listCourtsForMember, findAvailableCourtHours…), quien llama tendría que
aprender cada una.
Error común. Verbos en las rutas para operaciones estándar:
/api/getCourts,/api/createBooking,/api/deleteBooking?id=12. El método HTTP ya es el verbo. Además, la ruta con verbo esconde información a todo lo que está en el medio (proxies, caches, monitoreo), que sí entiendeGETyDELETE, pero no sabe qué quiere decirdeleteBooking.
Los métodos estándar
Las AIP llaman métodos estándar a cinco operaciones que se repiten en casi todos los recursos, y fijan su traducción a HTTP:
| Método estándar | HTTP | Sobre qué | AIP |
|---|---|---|---|
| Get | GET |
un recurso | 131 |
| List | GET |
una colección | 132 |
| Create | POST |
una colección | 133 |
| Update | PATCH |
un recurso | 134 |
| Delete | DELETE |
un recurso | 135 |
AIP-134 explica por qué actualizar es PATCH y no PUT, aunque PUT sea
idempotente: PATCH cambia solo los campos que se mandan, y PUT reemplaza
el recurso entero, así que un cliente HTTP viejo que no conoce un campo nuevo
lo borraría al mandar el recurso sin él.
Kallpa encaja con este vocabulario en cuatro de sus siete operaciones (lo leen en su README):
| Kallpa | Método estándar |
|---|---|
GET /api/courts |
List de canchas |
GET /api/members |
List de vecinos |
GET /api/members/:id/bookings |
List de las reservas de un vecino |
POST /api/bookings |
Create de una reserva |
GET /api/reports/daily?date=... |
ni colección ni recurso guardado: un cálculo |
GET /api/courts/:id/availability?date=... |
un cálculo sobre una cancha |
POST /api/bookings/:id/cancel |
no encaja: es un método propio |
Los dos cálculos son lecturas: no cambian nada, así que GET les queda bien
aunque no devuelvan un recurso guardado.
Métodos propios
¿Y cancelar una reserva? En Kallpa no se borra: queda con estado cancelled y
se guarda cuándo se canceló, y hay reglas (hasta 3 horas antes). Un DELETE
sugeriría que la reserva deja de existir. Un PATCH con { "status": "cancelled" } funcionaría, pero daría a entender que status se puede poner
en cualquier valor.
AIP-136 llama método propio (custom method) a una operación que no se
expresa bien con los estándar, y pide usarlo solo en ese caso: “Custom
methods should only be used for functionality that can not be easily expressed
via standard methods”. Según esa AIP, la ruta lleva dos puntos y el verbo, y
el método HTTP es POST si hay efectos y GET si solo se lee:
POST /api/bookings/12:cancel      el estilo de Google
POST /api/bookings/12/cancel      el estilo de Kallpa, también muy común
Los dos dicen lo mismo: una acción sobre un recurso concreto. Azure recomienda
también la forma con dos puntos (<resource-id>:<action>), siempre con POST
y respondiendo 200. Lo que importa es escoger una forma y usarla en toda la
API.
Lo que un GET no puede hacer
Un GET no cambia datos. Esta no es una regla de estilo, sino una que protege
al sistema de sus intermediarios. Un navegador puede pedir por adelantado los
enlaces de una página, un proxy puede repetir un GET sin preguntar cuando se
corta la conexión, un cache puede responder sin que la solicitud llegue al
servidor y un robot de búsqueda sigue todos los enlaces que encuentra. Si GET /api/bookings/12/cancel cancelara, cualquiera de ellos podría cancelar una
reserva sin que nadie lo haya pedido.
Seguro e idempotente
Estas dos palabras tienen definiciones precisas, en RFC 9110, el documento que define HTTP. Vale la pena leerlas tal cual, porque se suelen repetir mal.
Las definiciones
Seguro (safe), sección 9.2.1: un método es seguro si su semántica definida
es esencialmente de solo lectura, es decir, quien llama “does not request,
and does not expect, any state change on the origin server”. No pide ni
espera un cambio de estado. Son seguros GET, HEAD, OPTIONS y TRACE.
Idempotente (idempotent), sección 9.2.2: “A request method is considered
‘idempotent’ if the intended effect on the server of multiple identical
requests with that method is the same as the effect for a single such
request.” El efecto buscado en el servidor de N solicitudes iguales es el
mismo que el de una. Son idempotentes PUT, DELETE y los métodos seguros.
| Método | ¿Seguro? | ¿Definido como idempotente? |
|---|---|---|
GET, HEAD, OPTIONS, TRACE |
sí | sí |
PUT |
no | sí |
DELETE |
no | sí |
POST |
no | no |
PATCH |
no | no |
La tabla se lee en una dirección: todo método seguro es idempotente (si no
cambia nada, N veces tampoco), pero no al revés. DELETE cambia el estado y
es idempotente: borrar algo dos veces deja lo mismo que borrarlo una.
Tres precisiones que se olvidan
Es sobre el efecto, no sobre la respuesta. RFC 9110 lo dice en esa misma
sección: repetir tiene el mismo efecto “though the response might differ”.
El primer DELETE /x responde 204 y el segundo puede responder 404, y
DELETE sigue siendo idempotente, porque el servidor quedó igual después de
los dos.
Es sobre lo que se pidió, no sobre todo lo que pasa. “The idempotent
property only applies to what has been requested by the user”. Un GET que
escribe una línea de log sigue siendo seguro: quien llama no pidió el log. Por
eso cada solicitud de Kallpa agrega una línea al log y GET /api/courts sigue
siendo seguro.
POST y PATCH no están definidos como idempotentes, lo que no es lo
mismo que “nunca lo son”. La definición habla de lo que se puede suponer de
un método sin saber nada más. Un programa genérico (un navegador, un proxy,
una biblioteca HTTP) no conoce su API y solo ve el método, por eso no
reintenta un POST por su cuenta. Una operación concreta sobre POST sí
puede tener un efecto idempotente, si está diseñada así y lo documenta. El RFC
lo contempla: un cliente no debería reintentar automáticamente un método no
idempotente, “unless it has some means to know that the request semantics are
actually idempotent, regardless of the method”.
Dos operaciones de Kallpa, con la definición en la mano
Corramos lo mismo que el paso 2 del laboratorio: una reserva y una repetición
exacta, como si fuera un reintento después de un timeout, y después una
cancelación doble (make recorrido; las fechas dependen del día, y las líneas
largas están cortadas por el guion):
--- reservar y reintentar
$ curl -X POST localhost:3100/api/bookings -H content-type: application/json -d {"courtId":2,"memberId":2,"date":"2026-11-10","startHour":10,"teamName":"Los Halcones"}
HTTP/1.1 200 OK
{"booking":{"id":16,"courtId":2,"memberId":2,"date":"2026-11-10","startHour":10,"hours":1,"teamName":"Los Halcones","priceCents":8100,"status":"confirmed","createdAt":"2026-11-02T05:40:39.195Z","cance

$ curl -X POST localhost:3100/api/bookings -H content-type: application/json -d {"courtId":2,"memberId":2,"date":"2026-11-10","startHour":10,"teamName":"Los Halcones"}
HTTP/1.1 409 Conflict
{"error":{"code":"SLOT_TAKEN","message":"La cancha ya está reservada en ese horario."}}

--- cancelar dos veces
$ curl -X POST localhost:3100/api/bookings/16/cancel
HTTP/1.1 200 OK
{"booking":{"id":16,"courtId":2,"memberId":2,"date":"2026-11-10","startHour":10,"hours":1,"teamName":"Los Halcones","priceCents":8100,"status":"cancelled","createdAt":"2026-11-02T05:40:39.195Z","cance

$ curl -X POST localhost:3100/api/bookings/16/cancel
HTTP/1.1 409 Conflict
{"error":{"code":"ALREADY_CANCELLED","message":"La reserva ya estaba cancelada."}}
¿Es idempotente cancelar? Hay que separar dos preguntas. Como método,
POST no está definido como idempotente. Como operación, miren el efecto:
después de la primera cancelación, la reserva queda cancelled con su
cancelledAt; después de la segunda, queda exactamente igual (api.test.ts
compara la reserva antes y después). La respuesta cambia de 200 a 409, lo
que la definición permite. El efecto de esta operación sí es idempotente. Lo
que falta es decirlo: nada en la API le permite a un programa saberlo, y
mientras tanto no tiene ese “means to know” del RFC.
¿Es idempotente reservar? Parece que sí, porque el segundo intento no creó nada. Pero esa no es la prueba: la definición pide el mismo efecto para N solicitudes iguales en cualquier caso. Si entre la primera solicitud y el reintento alguien cancela esa reserva, el reintento encuentra la hora libre y crea una segunda.
Lo comprueba api.test.ts, en la prueba reservar no es idempotente:
reserva, cancela y repite exactamente la misma solicitud; el reintento
responde 200 con otro id, y el vecino queda con dos filas para esa hora,
una cancelada y otra confirmada.
El 409 que frena casi todos los reintentos viene de la regla del negocio (la
cancha no puede estar ocupada dos veces), no de que la operación sea
idempotente.
Idea clave. Seguro: quien llama no pide cambios. Idempotente: pedir lo mismo N veces deja al servidor como pedirlo una. La definición mira el efecto buscado, no la respuesta y no lo que el servidor haga por su cuenta (como escribir un log).
Error común. Decir “
DELETEes idempotente, así que siempre debe responder204”, o “un404en el segundoDELETErompe la idempotencia”. La respuesta puede cambiar: lo que no puede cambiar es el efecto.
Por qué importa: la respuesta perdida
Lo único que sabe quien llama
Un vecino aprieta “Reservar” con mala señal. El celular manda el POST, la
barra de carga gira y la conexión se corta. ¿Se hizo la reserva? Hay tres
posibilidades y, desde el celular, las tres se ven igual:
- La solicitud nunca llegó. No hay reserva.
- La solicitud llegó y el servidor todavía la está procesando. Puede que haya reserva dentro de un momento.
- El servidor la procesó y la respuesta se perdió de regreso. Hay reserva.
Por eso importa la idempotencia. Si la operación es idempotente, la app puede reintentar sin pensar: en los tres casos el resultado final es el correcto. Si no, reintentar es una apuesta. RFC 9110 lo dice directamente: los métodos idempotentes se distinguen “because the request can be repeated automatically if a communication failure occurs before the client is able to read the server’s response”.
El caso 3, de verdad
El caso 3 es fácil de reproducir sin esperar a que la red falle.
lost-response.ts levanta un proxy que reenvía la solicitud al servidor real,
espera su respuesta y, la primera vez, cierra la conexión sin entregarla:
const text = await upstream.text();
if (remaining > 0) {
  remaining--;
  req.socket.destroy(); // el servidor ya hizo su trabajo; la respuesta se pierde
  return;
}
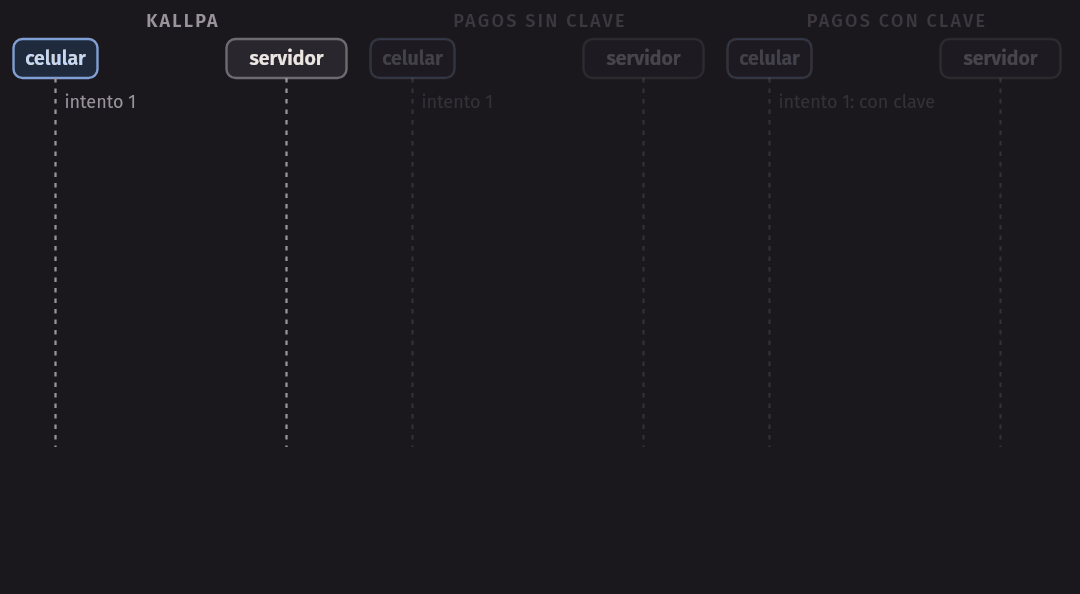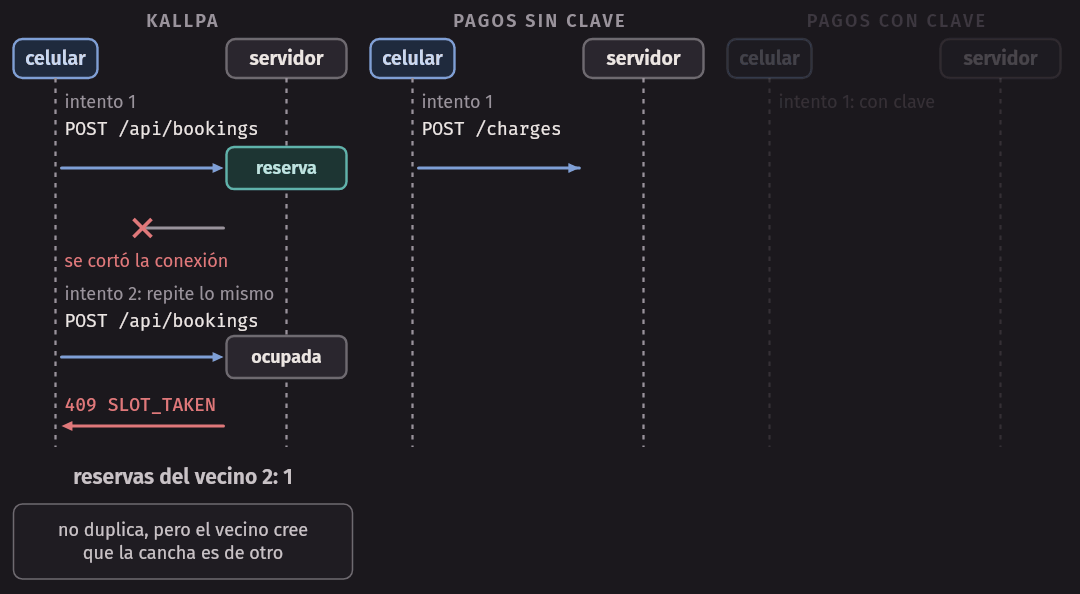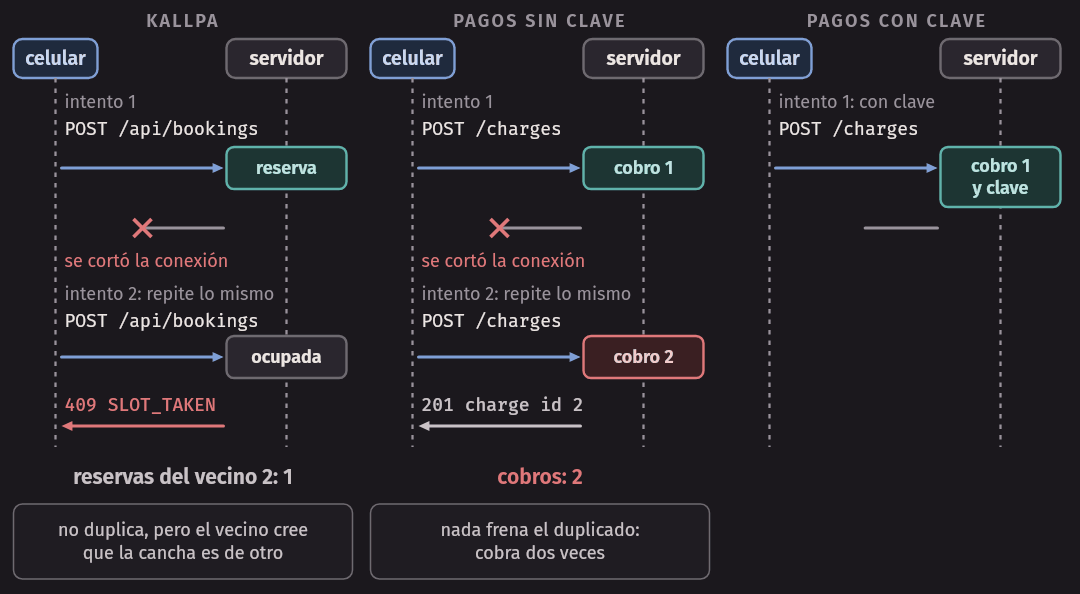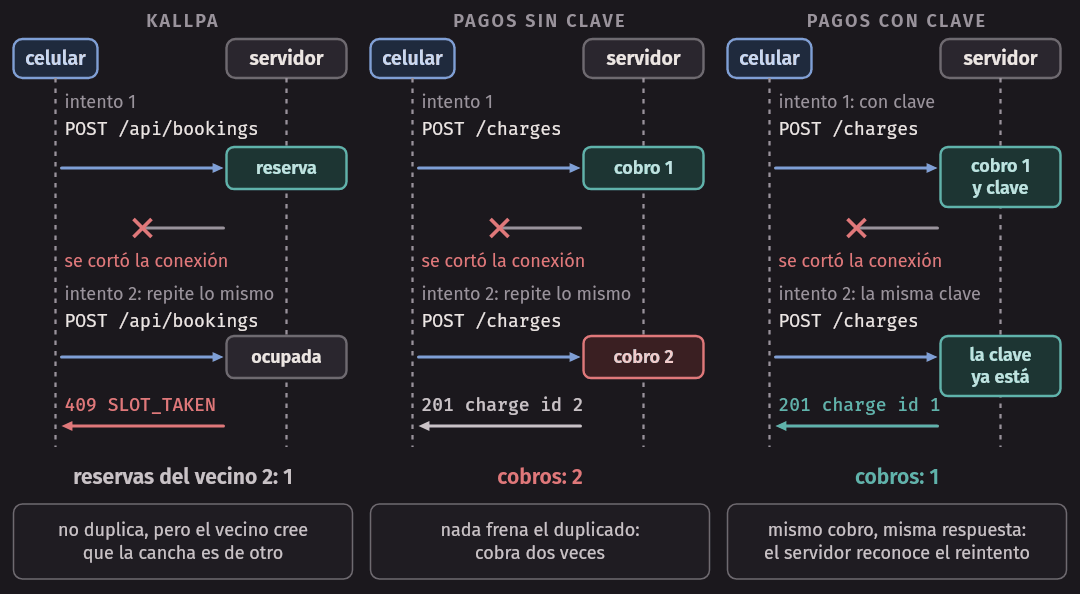
make retry pasa por ese proxy a Kallpa y a un servidor de pagos mínimo
(charges-server.ts), que no tiene ninguna regla que frene un duplicado.
Quien llama hace lo que haría cualquier app: si se corta, repite lo mismo.
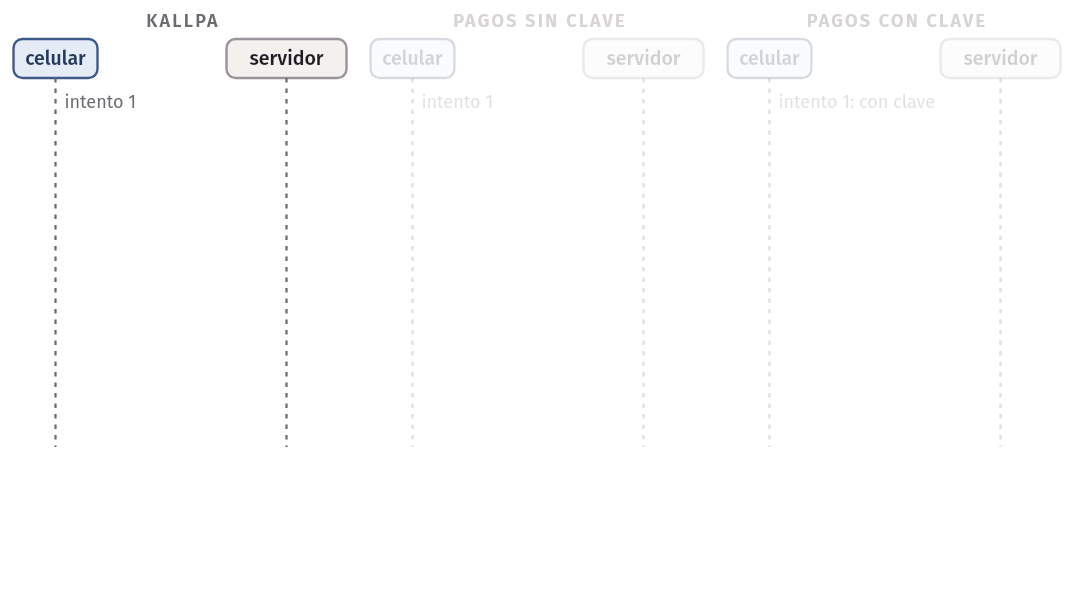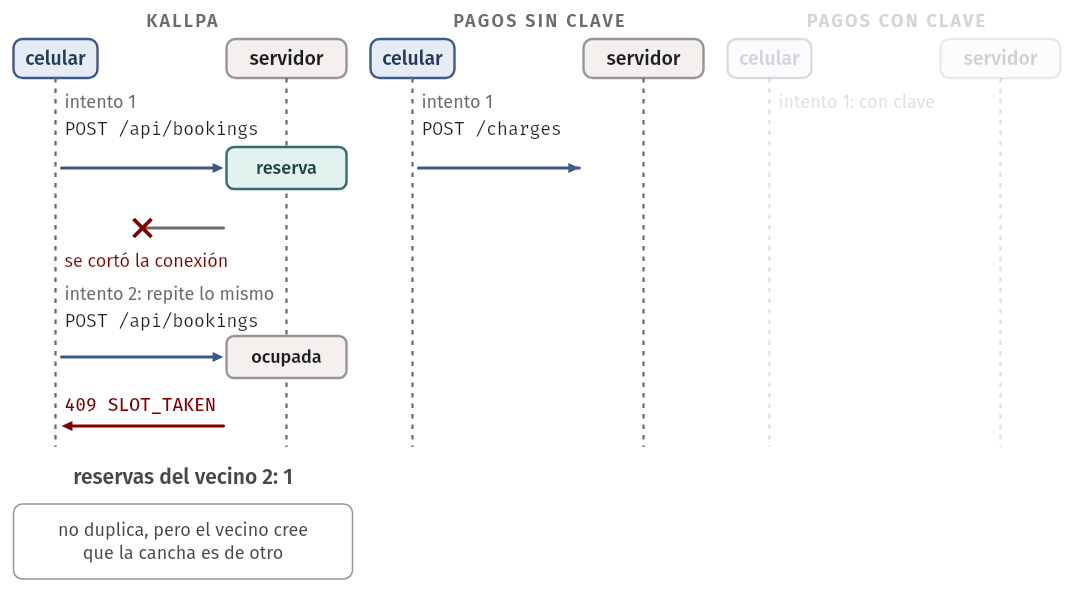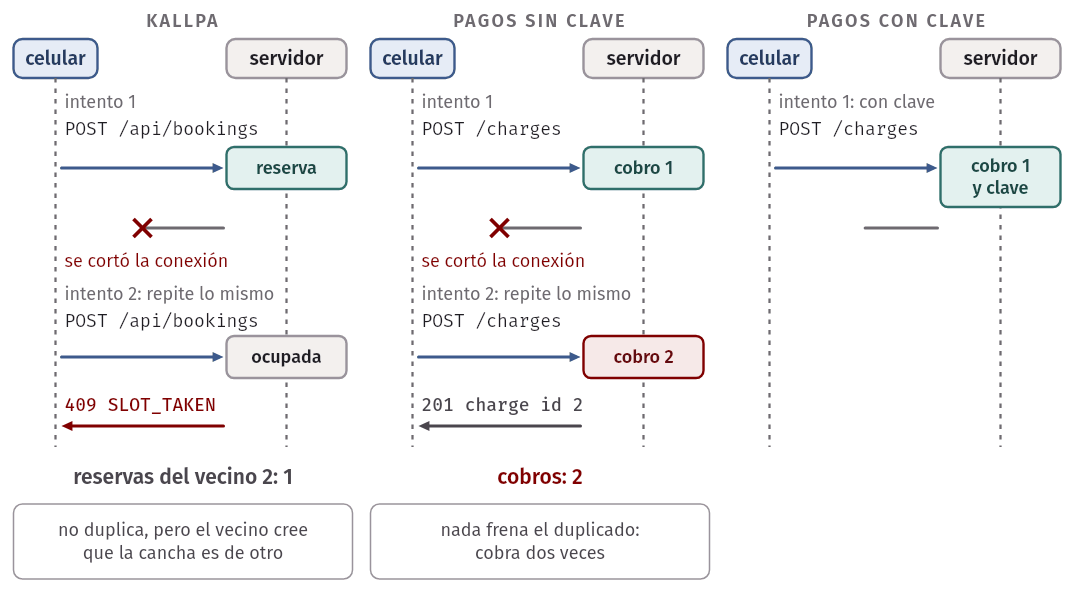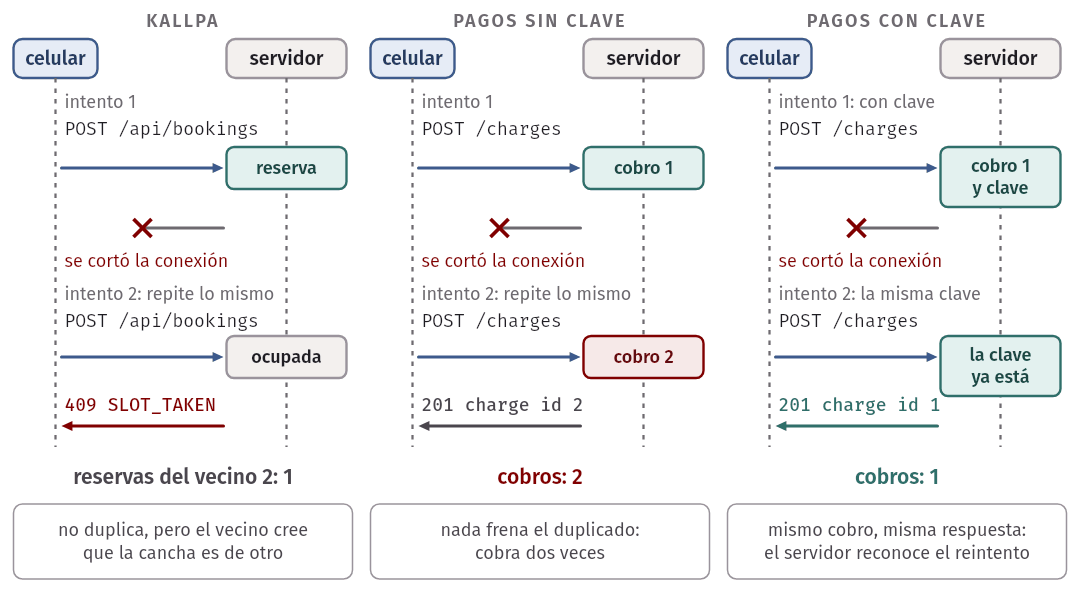
Kallpa, POST /api/bookings
  intento 1: se cortó la conexión (fetch failed)
  intento 2: 409 {"error":{"code":"SLOT_TAKEN","message":"La cancha ya está reservada en ese horario."}}
  reservas del vecino 2 en la base de datos: 1

Pagos sin clave, POST /charges
  intento 1: se cortó la conexión (fetch failed)
  intento 2: 201 {"charge":{"id":2,"memberId":2,"cents":8100}}
  cobros en la base de datos: 2

Pagos con clave, POST /charges
  intento 1: se cortó la conexión (fetch failed)
  intento 2: 201 {"charge":{"id":1,"memberId":2,"cents":8100}}
  cobros en la base de datos: 1
Hay dos fallas distintas:
- Kallpa falla sin duplicar, pero informa mal. La reserva se hizo y es del vecino 2, pero lo último que él ve es “la cancha ya está reservada en ese horario”. El mensaje es correcto y engañoso: dice que la cancha está ocupada, no que la ocupa él. La app le mostrará un error, y el vecino buscará otra hora o llamará a la administración, mientras tiene una reserva que no sabe que tiene.
- Pagos duplica. Sin una regla que lo frene, el reintento cobra dos veces. El vecino vio un solo botón y un solo error.
La última parte de la salida muestra la solución.
La clave de idempotencia
El protocolo
Como un POST no es idempotente por sí mismo, se le agrega algo que permita
reconocer un reintento. Quien llama genera un valor único por intención
(por cada vez que el vecino aprieta el botón, no por cada envío) y lo manda en
una cabecera. El servidor guarda la clave con la respuesta y, si la vuelve a
ver, no repite la operación: devuelve lo que guardó.
POST /api/bookings
Idempotency-Key: "8e03978e-40d5-43e8-bc93-6894a57f9324"
(Las comillas son parte del valor en el borrador: la cabecera es un Structured Field cuyo valor debe ser una cadena.)
La cabecera está descrita en un borrador de la IETF, The Idempotency-Key HTTP Header Field. La versión que revisamos es la -08, de octubre de 2026: un borrador activo, todavía no un RFC, y que puede cambiar. Casi todo lo que pide lo pide con SHOULD, es decir, como recomendación fuerte. Lo que recomienda:
| Situación | Respuesta del servidor |
|---|---|
| La clave es nueva | Procesa normalmente |
| Reintento, la primera ya terminó | Una respuesta “consistent with the request being completed”; lo usual es repetir la guardada |
| Reintento, la primera todavía se procesa | 409 Conflict |
| La misma clave con otro cuerpo | 422 Unprocessable Content |
| Falta la clave en una operación que la exige | 400 Bad Request |
Pide también dos cosas con MUST: que el servidor publique cómo funciona su idempotencia, incluido cuánto dura una clave, y que una clave no se reutilice con un cuerpo distinto. Recomienda usar un UUID: su sección de seguridad advierte que una clave fácil de adivinar podría servirle a un atacante para leer la respuesta guardada de otra persona.
Como decorator de una operación
idempotency.ts lo implementa sin tocar la
operación, envolviéndola con otra función (en la segunda parte del capítulo le
daremos nombre a esta forma: decorator). Una clave está en proceso o
terminada, con su respuesta guardada, y la lógica sigue la tabla de arriba
abajo:
return async (key: string | undefined, request: Request): Promise<Replayable> => {
  if (key === undefined) {
    return errorResponse(400, 'IDEMPOTENCY_KEY_MISSING', 'Esta operación pide la cabecera Idempotency-Key.');
  }
  const print = fingerprint(request);
  const now = options.now();
  const existing = store.get(key);
  if (existing && now - existing.storedAt < options.ttlMs) {
    if (existing.fingerprint !== print) {
      return errorResponse(422, 'IDEMPOTENCY_KEY_REUSED', 'Esa clave ya se usó con otro cuerpo.');
    }
    if (existing.state === 'in-progress') {
      return errorResponse(409, 'REQUEST_IN_PROGRESS', 'La primera solicitud con esa clave todavía se procesa.');
    }
    return { ...existing.response, replayed: true };
  }
  // Se marca antes del primer await: un reintento concurrente ya ve la clave.
  store.set(key, { state: 'in-progress', fingerprint: print, storedAt: now });
  try {
    const response = await operation(request);
    store.set(key, { state: 'done', fingerprint: print, storedAt: now, response });
    return { ...response, replayed: false };
  } catch (error) {
    // No se sabe qué pasó: se libera la clave para que un reintento pueda
    // volver a correr la operación.
    store.delete(key);
    throw error;
  }
};
La huella (fingerprint) es un hash del cuerpo. Sirve para detectar que se
reutilizó una clave con otro contenido, y se calcula sobre una forma canónica
del JSON, con los campos ordenados, porque {"a":1,"b":2} y {"b":2,"a":1}
son el mismo pedido aunque tengan otros bytes. El reloj se recibe como
dependencia, igual que en Kallpa, y por eso se puede probar el vencimiento sin
esperar 24 horas. idempotency.test.ts comprueba cada fila de la tabla:
✔ sin clave no se ejecuta nada: 400
✔ un reintento con la misma clave y el mismo cuerpo devuelve la misma respuesta sin repetir el efecto
✔ el orden de los campos no cambia la huella
✔ la misma clave con otro cuerpo: 422 y sin efecto
✔ un reintento mientras la primera todavía corre: 409
✔ cuando vence la clave, el mismo pedido vuelve a ejecutarse
✔ las respuestas de error de la operación también se guardan y se repiten
✔ el límite de este diseño: si el proceso falla después del efecto, el reintento lo repite
(Salida de node --test, sin los tiempos de cada prueba.)
Las decisiones que el código no toma por ustedes
El módulo anterior es para entender la lógica. Una clave de idempotencia real
obliga a decidir varias cosas, y es lo que harán en el paso 7 del laboratorio
para POST /api/bookings:
-
¿Dónde se guarda y cuándo? Esta es la más importante. La última prueba de la lista muestra el problema: si el proceso se cae después de hacer el efecto y antes de guardar la respuesta, el reintento repite el efecto, con clave y todo.
const operation = async (request: Charge) => {
  charges.push(request); // el efecto ya ocurrió...
  if (fail) throw new Error('se cayó antes de guardar la respuesta'); // ...y la respuesta se pierde
  return { status: 201, body: { id: charges.length } };
};
La garantía real solo existe si la clave y el efecto se guardan en la misma transacción de la base de datos: o quedan los dos, o ninguno. Un
Mapen memoria, como el del ejemplo, además se pierde al reiniciar el servidor. -
¿Por cuánto tiempo? Lo bastante para cubrir los reintentos reales y no tanto como para llenar la base de datos. Lo que escojan, se publica.
-
¿Qué pasa con los efectos que no están en la base de datos? Un aviso por WhatsApp no entra en una transacción. Si se manda antes del commit y el commit falla, se avisó de una reserva que no existe; si se manda después, un fallo puede dejar una reserva sin aviso.
-
¿Qué se guarda? Guardar también los rechazos da una respuesta estable, pero un
409guardado seguiría diciendo “ocupada” aunque la cancha se libere. No guardarlos deja volver a intentar. Las dos opciones son defendibles; lo que no se defiende es no haberlo decidido. -
¿Quién es owner de la clave? Si la clave es global, cualquiera que la adivine recibe la respuesta de otro. Con autenticación, la clave se guarda por usuario. Kallpa no tiene autenticación (semana 15).
-
¿Es obligatoria? En una API que ya existe, volverla obligatoria rompe a todos. Se empieza con una cabecera opcional, que es un cambio compatible.
En la industria. El borrador de la IETF incluye una sección de Implementation Status con empresas y productos que usan esa cabecera, entre ellos Stripe y Adyen. Azure llega al mismo lugar por otro camino: sus guías exigen que todas las operaciones sean idempotentes (“all service operations (including POST) must be idempotent”), recomiendan crear recursos con
PUToPATCHy, para losPOST, usar otras dos cabeceras,Repeatability-Request-IDyRepeatability-First-Sent, definidas por OASIS, con una ventana de al menos 5 minutos. Otros nombres, la misma idea: quien llama identifica su intención y el servidor reconoce la repetición. Fuentes: el borrador -08, sec. 4, y Azure REST API Guidelines, Exactly Once Behavior y Repeatability of requests.
Con IA. Al pedirle a un agente “agrega reintentos a este cliente HTTP”, lo típico es un bucle con backoff alrededor de la llamada, y funciona en todas las pruebas: un reintento solo se nota cuando se pierde una respuesta, que en una prueba normal no pasa. Revisen dos cosas: si la operación que se reintenta es idempotente y si el cliente genera la clave una vez por intención, fuera del bucle. Una clave generada dentro del bucle, una por intento, no protege de nada. Se comprueba con una prueba como
lost-response.test.ts: una red que corta y un contador de efectos.
Error común. Generar la clave en cada envío. Si el reintento lleva otra clave, el servidor lo trata como un pedido nuevo.
Códigos de estado con significado
Los que van a usar
El código de estado es lo primero que lee un programa, y tiene significado para todo lo que está en el medio: un cache, un balanceador de carga, una biblioteca que decide si reintentar. Estos cubren casi todo:
| Código | Nombre (RFC 9110) | Cuándo |
|---|---|---|
200 |
OK | Salió bien y hay algo que devolver |
201 |
Created | Se creó un recurso; la cabecera Location dice dónde quedó |
204 |
No Content | Salió bien y no hay cuerpo |
400 |
Bad Request | La solicitud está mal formada |
401 |
Unauthorized | No se sabe quién llama; la respuesta debe traer WWW-Authenticate |
403 |
Forbidden | Se sabe quién llama y no puede hacer esto |
404 |
Not Found | Ese recurso o esa ruta no existe |
405 |
Method Not Allowed | La ruta existe con otro método; la respuesta debe traer Allow |
409 |
Conflict | Choca con el estado actual del recurso |
413 |
Content Too Large | El cuerpo es demasiado grande |
422 |
Unprocessable Content | Bien formada, pero no se puede procesar |
429 |
Too Many Requests | Demasiadas solicitudes (este lo define RFC 6585) |
500 |
Internal Server Error | Falló el servidor, no quien llama |
503 |
Service Unavailable | No puede atender ahora, pero es temporal |
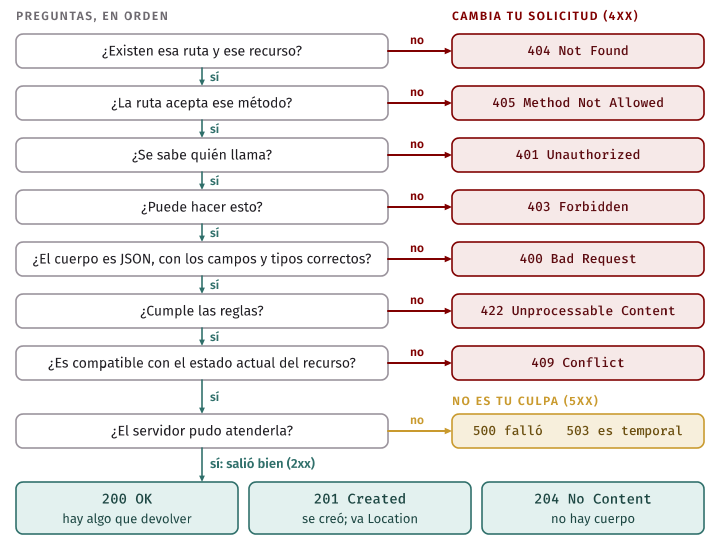
Tres frases para no confundirlos. 401 frente a 403: el primero dice
“no sé quién eres” y el segundo “sé quién eres y no”. 4xx frente a
5xx: el primero le dice a quien llama “cambia tu solicitud”; el segundo,
“no es tu culpa”. 409 frente a 422: 409 choca con el estado actual
de un recurso (la misma reserva podría funcionar si se cancela la otra); 422
no cumple una regla, sea cual sea el estado de los demás recursos. La frontera
no es perfecta, porque hay reglas que dependen del tiempo: una fecha demasiado
lejana hoy (TOO_FAR_AHEAD) será válida en unos días.
La frase de la primera línea de la respuesta la pone Node, y no siempre coincide con el nombre actual:
$ curl -X POST localhost:3100/api/bookings -H content-type: application/json -d {"courtId":2,"memberId":2,"date":"2026-11-10","startHour":10,"hours":4,"teamName":"X"}
HTTP/1.1 422 Unprocessable Entity
{"error":{"code":"TOO_MANY_HOURS","message":"Se pueden reservar como máximo 3 horas seguidas."}}

$ curl -X POST localhost:3100/api/bookings -H content-type: application/json --data @/tmp/kallpa-grande.json
HTTP/1.1 413 Payload Too Large
{"error":{"code":"BODY_TOO_LARGE","message":"El cuerpo de la solicitud es demasiado grande."}}
Unprocessable Entity y Payload Too Large son los nombres antiguos; RFC
9110 los cambió a Unprocessable Content y Content Too Large. No es un
error de Kallpa: los programas comparan el número, y RFC 9112, sobre HTTP/1.1,
dice que un cliente debería ignorar esa frase (“A client SHOULD ignore the
reason-phrase content”).
La frontera entre 400 y 422
¿Un hours: 4 es un 400 o un 422? RFC 9110 define el 422 para una
solicitud cuya sintaxis es correcta y que aun así no se puede procesar. Pero
400 también abarca lo que el servidor percibe como un error de quien llama.
La norma deja lugar a más de una respuesta razonable, y las guías importantes
no coinciden:
- Azure usa
400para todo: “fail the operation with400-Bad Requestif any value fails validation”. - Google tampoco usa
422: en la tabla degoogle.rpc.Code, a la que remite AIP-193, ningún código se traduce a ese estado. Un argumento inválido (INVALID_ARGUMENT) o una condición que no se cumple (FAILED_PRECONDITION) van a400. - El borrador de la clave de idempotencia sí usa
422, y muchas API también. - Kallpa escoge en su README:
400si “falta un campo o tiene el tipo equivocado”, y422para las reglas del negocio.
Cualquiera de estas decisiones puede defenderse. Lo que no: decidirlo campo por campo, sin una regla, porque quien llama tendría que aprender cada caso. Por eso conviene una frase como esta en la documentación de la API, y revisar que todos los endpoints la respeten:
400: el cuerpo no es JSON, falta un campo o tiene el tipo equivocado.422: tiene la forma correcta, pero no cumple una regla.
Si Kallpa la cumple en todos sus campos es parte de lo que revisarán en el laboratorio.
Errores que un programa pueda leer
Lo que necesita un error
Un error de API tiene dos lectores: un programa, que decide qué hacer, y una persona, que trata de entender qué pasó. Necesita:
- un código estable para el programa, que no cambie aunque se reescriba el mensaje;
- un mensaje para la persona, que se pueda mejorar en cualquier momento;
- si sirve, detalles (por ejemplo, qué campo falló y por qué).
Kallpa usa una forma, en todas partes:
{ "error": { "code": "SLOT_TAKEN", "message": "La cancha ya está reservada en ese horario." } }api.test.ts recorre errores de seis orígenes distintos (ruta que no existe,
método equivocado, JSON roto, reserva que no existe, vecino que no existe,
fecha que falta) y comprueba que todos tienen exactamente esas dos claves.
Las formas que van a encontrar
No hay una sola forma estándar. Estas son las tres que más se ven:
| Quién | Forma | El identificador para programas |
|---|---|---|
| RFC 9457, Problem Details | application/problem+json con type, title, status, detail, instance |
type: una URI |
| Azure | { "error": { "code", "message", "target", "details", "innererror" } } |
error.code, un texto, repetido en la cabecera x-ms-error-code |
| Google (AIP-193) | { "error": { "code", "message", "status", "details" } } |
details lleva un ErrorInfo con reason y domain |
Un detalle que confunde: en Google, error.code es el número HTTP
(429), y el identificador simbólico viene en status (RESOURCE_EXHAUSTED)
y en ErrorInfo.reason. En Azure y en Kallpa, error.code es un texto.
Se escriben igual y no significan lo mismo. En los tres casos el mensaje se
escribe para personas; AIP-193 además advierte que, en una API antigua que no
tiene identificadores para programas, cambiar el mensaje es peligroso, porque
es lo único que quien llama puede comparar. Es la ley de Hyrum otra vez.
Azure es explícito sobre el contrato: “x-ms-error-code values are part of
your API contract (because customer code is likely to do comparisons against
them) and cannot change in the future”.
Importa menos cuál elijan que usar la misma en toda la API. Una API con dos formas de error obliga a escribir dos ramas en cada cliente HTTP.
Error común. Devolver
200con{ "success": false, ... }. Todo lo que está en el medio (caches, monitoreo, una biblioteca de reintentos) ve un éxito. El panel de errores del equipo estará en cero mientras los usuarios no pueden reservar.
Error común. Devolver en el cuerpo de un
500el mensaje de la excepción o el stack trace. Es información interna que le sirve a un atacante, y además alguien terminará dependiendo de ella. Kallpa la manda al log y responde un mensaje fijo:Ocurrió un error inesperado.
Evolución y versiones
Compatible e incompatible
Un cambio es compatible (backward compatible) si el código que ya funciona contra la API sigue funcionando sin cambios. Es incompatible (breaking) si puede dejar de funcionar. La lista que sigue combina AIP-180 y la práctica común:
| Cambio | ¿Compatible? | Por qué |
|---|---|---|
| Agregar un endpoint | Sí | Nadie lo usa todavía |
| Agregar un campo opcional en la solicitud | Sí, si omitirlo hace lo mismo que antes | AIP-180: el valor por omisión debe reproducir el comportamiento anterior |
| Agregar un campo en la respuesta | Sí, si quien llama ignora lo que no conoce | Ver abajo |
| Quitar o renombrar un campo | No | Quien lo leía recibe undefined |
| Cambiar el tipo de un campo | No | También si “se ve igual” en JSON |
| Cambiar el significado de un campo | No | Y ninguna herramienta lo detecta |
| Volver obligatorio algo opcional | No | Las solicitudes de ayer fallan hoy |
| Cambiar un código de estado | No | Quien lo comparaba toma otro camino |
| Cambiar un valor por omisión | No | AIP-180 lo prohíbe expresamente |
| Aumentar el largo máximo de un texto | Con cuidado | AIP-180 pide tratarlo como incompatible: alguien guardó ese campo en una columna con el tamaño anterior |
evolution.ts tiene tres clientes HTTP de la respuesta de disponibilidad, y
evolution.test.ts les aplica estos cambios a una respuesta real de Kallpa:
▶ qué rompe cada cambio
  ✔ agregar un campo en la respuesta: el cliente tolerante sigue igual
  ✔ agregar un campo en la respuesta: el cliente que exige campos exactos se cae
  ✔ renombrar hour a startHour: el cliente tolerante no se cae, pero devuelve basura
  ✔ envolver el arreglo suelto en un objeto: el cliente se cae
  ✔ pasar un error de 400 a 422: el cliente que comparaba el código ya no lo reconoce
(Salida de node --test, sin los tiempos.)
Hay dos lecciones en esa salida. La segunda línea muestra que “agregar un
campo es compatible” es una regla con una condición: vale si quien llama
ignora los campos que no conoce. Un cliente que valida campos exactos se
rompe, y por la ley de Hyrum alguien lo escribirá así. Conviene poner esa
condición por escrito: “pueden aparecer campos nuevos; ignoren los que no
conozcan”. La tercera línea es la peor falla: un error que no lanza nada.
La app sigue corriendo y muestra una lista de undefined, y nadie se entera
hasta que llama un usuario.
Error común. Renombrar un campo “porque se ve mejor” en una API que ya tiene clientes HTTP. El nombre viejo era feo, pero funcionaba.
Un arreglo suelto no deja crecer
GET /api/courts devuelve { "courts": [...] }, pero GET /api/members/:id/bookings devuelve [...]. Un objeto puede crecer: mañana se
le agrega otro campo y nadie se entera. A un arreglo suelto no se le puede
agregar nada; para hacerlo hay que cambiarle la forma, y eso rompe a todos.
Por eso se recomienda envolver las listas desde el primer día.
Sin embargo, envolver no resuelve todo. AIP-158 pide paginar desde el
inicio, y da el motivo: “Adding pagination to an existing RPC is a
backwards-incompatible change”. Aunque el campo nextPageToken sea un
agregado inofensivo para la forma de la respuesta, cambia el comportamiento:
un cliente HTTP que hoy lee una sola respuesta recibe todas las reservas; con
paginación, recibirá la primera página y no se dará cuenta de que faltan las
demás. El objeto hace posible agregar la paginación sin cambiar la forma
de la respuesta. No la vuelve gratis.
La paginación con token funciona así: la respuesta incluye nextPageToken si
quedan más resultados, y quien llama lo devuelve para pedir la página
siguiente. Se prefiere un token opaco a un número de página para no prometer
cómo está hecha la consulta por dentro.
Convivir: versiones
Cuando un cambio incompatible vale la pena, no se aplica sobre lo que ya existe. Se publica al lado. Hay varias formas de nombrar la versión, y las guías tampoco coinciden aquí:
| Forma | Ejemplo | Quién |
|---|---|---|
| En la ruta | /api/v2/members/2/bookings |
Google pone la versión mayor en la ruta (/v1/...) |
| En un parámetro | ?api-version=2021-06-04 |
Azure lo exige en toda operación, con fechas, y prohíbe el número en la ruta: “DO NOT include a version number segment in any operation path” |
| En una cabecera | X-Api-Version: 2 |
Es común en algunas API; es menos visible para quien lee una URL |
Lo que comparten es la promesa: una versión ya publicada no cambia de forma incompatible. Azure lo dice sin matices: “DO NOT introduce any breaking changes into the service”. Sus excepciones pasan por una junta de revisión.
Deprecar sin sorprender
Deprecar es anunciar que algo va a dejar de existir, mientras sigue funcionando. Son tres pasos, en este orden:
- Publicar lo nuevo y dejar lo viejo igual. Las dos versiones conviven.
- Anunciar, con una fecha, y medir quién sigue usando lo viejo.
- Apagar recién cuando el uso cae, o cuando se cumple el plazo y se avisó a quienes quedan.
Dos RFC dan cabeceras para el segundo paso:
- RFC 9745,
Deprecation: desde cuándo está deprecado el recurso, como@y un tiempo Unix (Deprecation: @1798761600). La fecha puede ser futura. El RFC es claro: “The act of deprecation does not change any behavior of the resource”. - RFC 8594,
Sunset: cuándo dejará de responder, como fecha HTTP (Sunset: Sat, 01 Jan 2028 00:00:00 GMT). RFC 9745 agrega que esa fecha no puede ser anterior a la deDeprecation.
No son las únicas opciones: Azure, por ejemplo, tiene su propia cabecera
azure-deprecating, pensada para que la lea una persona y no un programa.
v2-bookings.diff aplica esto al arreglo
suelto de Kallpa, en una copia. La ruta vieja sigue respondiendo lo mismo,
pero agrega las cabeceras; la nueva devuelve un objeto. Las dos comparten la
consulta:
// GET /api/members/:id/bookings: arreglo suelto, deprecado.
export function memberBookings(deps: AppDependencies): Handler {
  return ({ res, params }) => {
    res.setHeader('Deprecation', `@${MEMBER_BOOKINGS_V1_DEPRECATED_AT}`);
    res.setHeader('Sunset', MEMBER_BOOKINGS_V1_SUNSET);
    res.setHeader('Link', `</api/v2/members/${params.id}/bookings>; rel="successor-version"`);
    sendJson(res, 200, bookingsOfMember(deps, params.id));
  };
}

// GET /api/v2/members/:id/bookings: un objeto, que puede crecer.
export function memberBookingsV2(deps: AppDependencies): Handler {
  return ({ res, params }) => {
    sendJson(res, 200, { bookings: bookingsOfMember(deps, params.id) });
  };
}
make recorrido-v2 las llama (las líneas largas están cortadas por el guion):
$ curl -s -i localhost:3101/api/members/5/bookings
HTTP/1.1 200 OK
Deprecation: @1798761600
Sunset: Sat, 01 Jan 2028 00:00:00 GMT
Link: </api/v2/members/5/bookings>; rel="successor-version"
[{"id":9,"courtId":3,"memberId":5,"date":"2026-11-03","startHour":9,"hours":2,"teamName":"

$ curl -s -i localhost:3101/api/v2/members/5/bookings
HTTP/1.1 200 OK
{"bookings":[{"id":9,"courtId":3,"memberId":5,"date":"2026-11-03","startHour":9,"hours":2,

GET /api/members/5/bookings 200
GET /api/v2/members/5/bookings 200
Las dos últimas líneas son el log del servidor. Es la medición del paso 2, y
también su límite: contando líneas se sabe cuánto se usa la ruta vieja,
pero no quién la usa, porque Kallpa no tiene autenticación. Sin saber
quién, no se le puede avisar a nadie. Las pruebas viejas de Kallpa no
cambiaron, y el diff agrega cuatro en test/v2.test.ts:
ℹ tests 44
ℹ suites 7
ℹ pass 44
ℹ fail 0
La semana 16 retoma la deprecación a mayor escala, cuando el código mismo se vuelve heredado.
Con IA. Un agente al que se le pide “ordena esta API” tiende a hacer el cambio más limpio, que suele ser incompatible: renombra, unifica, pasa de
200a201, y actualiza en el mismo commit los clientes HTTP y las pruebas que encuentra en el repositorio. Las pruebas pasan. Los clientes HTTP que están fuera del repositorio, no. En la revisión, una pregunta lo destapa: ¿este diff cambió alguna prueba de la API que ya existía? Si una prueba de contrato cambió, el contrato cambió.
OpenAPI: el contrato por escrito
Qué es
OpenAPI es un formato estándar para describir una API HTTP en un archivo YAML o JSON: las rutas, los parámetros, los cuerpos, todas las respuestas y sus esquemas. Como lo puede leer un programa, de ese archivo se puede obtener documentación, comprobar respuestas y generar código. La versión 3.1 usa JSON Schema para describir los datos.
Un documento tiene pocas partes. Este es el esqueleto del laboratorio,
code/week-06/openapi.yaml, completo:
openapi: 3.1.0
info:
  title: Kallpa API
  version: 1.0.0
  description: Reservas de canchas.
security: []
servers:
  - url: http://localhost:3000
paths:
  /api/courts:
    get:
      operationId: listCourts
      summary: Lista las canchas
      responses:
        '200':
          description: Las canchas
          content:
            application/json:
              schema:
                type: object
                required: [courts]
                properties:
                  courts:
                    type: array
                    items:
                      $ref: '#/components/schemas/Court'
components:
  schemas:
    Court:
      type: object
      required: [id, name, sport]
      properties:
        id: { type: integer }
        name: { type: string }
        sport: { type: string, enum: [fulbito, voley, basquet] }
    Error:
      type: object
      required: [error]
      properties:
        error:
          type: object
          required: [code, message]
          properties:
            code: { type: string }
message: { type: string }pathstiene las operaciones: una por cada combinación de ruta y método. Los parámetros de ruta se escriben/api/courts/{id}/availability, con llaves.responsestiene una entrada por código de estado, cada una con su esquema.components/schemasguarda los tipos que se repiten, y$reflos usa. Un$refevita copiarCourten cada respuesta y es el DRY de la semana pasada: un solo lugar.security: []dice que ninguna operación pide autenticación. Kallpa no la tiene y la especificación lo dice en voz alta, en lugar de callarlo. Se retoma en la semana 15.
redocly lint: lo que revisa
Redocly CLI, que viene en el contenedor, revisa el documento contra las reglas
de OpenAPI y un conjunto de buenas prácticas (recommended). Sobre el
esqueleto:
$ redocly lint openapi.yaml
No configurations were provided -- using built in recommended configuration by default.

validating openapi.yaml...
[1] openapi.yaml:2:1 at #/info

Info object should contain `license` field.

1 | openapi: 3.1.0
2 | info:
  | ^^^^
3 |   title: Kallpa API
4 |   version: 1.0.0

Warning was generated by the info-license rule.

Reference: https://redocly.com/docs/cli/rules/oas/info-license
(Hay tres avisos más de la misma forma, para no-server-example.com en la
línea 8, operation-4xx-response en la línea 14 y no-unused-components en
la línea 36. La salida termina así.)
openapi.yaml: validated in 18ms

Woohoo! Your API description is valid. 🎉
You have 4 warnings.
Cero errores y cuatro advertencias, con código de salida 0. Una advertencia no
es una orden: es una pregunta que hay que responder. La cuarta se va sola
cuando usen Error con un $ref. La segunda no se puede corregir, porque
Kallpa solo corre en localhost: se justifica con un comentario en el YAML.
La tercera merece pensarla: GET /api/courts no responde ningún 4xx. Si
para callar la regla agregan un 400 que nunca ocurre, la especificación deja
de decir la verdad.
Un error es otra cosa. En
lint-examples/broken-ref.yaml
el $ref apunta a un esquema que no existe:
[1] lint-examples/broken-ref.yaml:20:17 at #/paths/~1api~1courts/get/responses/200/content/application~1json/schema

Can't resolve $ref
Y al final, con código de salida 1:
❌ Validation failed with 1 error and 4 warnings.Lo que redocly lint no revisa
Lint compara el documento con las reglas de OpenAPI, no con el servidor.
lint-examples/wrong-but-valid.yaml
dice que POST /api/bookings responde 201 con { id }. Kallpa responde
otra cosa. Aun así:
$ redocly lint lint-examples/wrong-but-valid.yaml --format=summary
No configurations were provided -- using built in recommended configuration by default.

validating lint-examples/wrong-but-valid.yaml...
warning info-license: 1
warning no-server-example.com: 1

lint-examples/wrong-but-valid.yaml: validated in 13ms

Woohoo! Your API description is valid. 🎉
You have 2 warnings.
Valid quiere decir “es un documento OpenAPI bien escrito”. No quiere decir
“es verdad”. Para saber si es verdad hay que llamar al servidor y comparar.
contract.ts es un validador pequeño que hace
eso: toma el esquema de una respuesta (del documento empaquetado como JSON con
redocly bundle) y lo compara con lo que llegó.
test('GET /api/courts responde lo que dice la especificación', async () => {
  const body = await (await fetch(`${server.url}/api/courts`)).json();
  assert.deepEqual(validate(spec, body, courts), []);
});
Si faltara name en una cancha, o sport valiera tenis, validate
devolvería esas discrepancias, y otra prueba lo comprueba. validate solo
entiende lo que usa la especificación de Kallpa, y no revisa formatos como
date-time. En un proyecto real se usa una biblioteca completa de JSON
Schema. La idea es la misma: una prueba que compara una respuesta real con el
contrato evita que la especificación se vuelva ficción. La revisión de P2 hace
algo parecido: llama a las operaciones GET sin parámetros de ruta de su
especificación y falla si la aplicación responde 404 o 5xx.
Error común. Escribir la especificación de la API que les gustaría tener. Una especificación que promete un
201que el servidor no da es peor que no tener ninguna: alguien va a programar contra ella. En el laboratorio se describe la API como es hoy, con sus defectos a la vista, y las mejoras se proponen aparte.
Con IA. Una especificación OpenAPI sirve de contrato contra el que se comprueba un cliente HTTP generado.
client-example.tses una ilustración escrita para la clase, un cliente como los que suele proponer un agente cuando no tiene la especificación a la vista: compila, corre y usacourt.courtNameycourt.sportType, que suenan razonables y no existen. Como la respuesta se trata comoany,tscno dice nada, y la app muestraundefined (undefined)en las cuatro canchas. Encontract.test.ts,fieldExistscompara los campos que usa con la especificación y los encuentra sin correr el cliente. Denle la especificación al agente como contexto, y después comprueben: los dos pasos juntos valen más que cualquiera de los dos.
Patrones de diseño: qué siguen siendo
Una solución con nombre
Un patrón de diseño (design pattern) es una solución con nombre a un problema que se repite al diseñar software, con sus ventajas y sus costos. No es código para copiar, ni una biblioteca: es una forma de organizar el código, que en cada lenguaje se escribe distinto.
El catálogo clásico es el libro Design Patterns de 1994, de Erich Gamma, Richard Helm, Ralph Johnson y John Vlissides, con 23 patrones y ejemplos en C++ y Smalltalk. Tres décadas después sigue vigente, pero no todo por igual. Lo que se mantiene es:
- El problema. Cambiar un algoritmo sin tocar a quien lo usa, o hacer encajar dos interfaces, son problemas que siguen apareciendo en cualquier lenguaje.
- El vocabulario. Decir “aquí va un adapter” en una revisión de código ahorra un párrafo. Es su uso más barato y quizá el más útil.
Lo que cambia es la forma. Muchos de esos patrones existían para resolver limitaciones de los lenguajes de 1994, y hoy pueden ser una línea.
Lo que dijo Norvig en 1996
Peter Norvig estudió el catálogo en una charla de 1996 y concluyó que 16 de los 23 patrones “are either invisible or simpler” en Dylan o Lisp. En otra lámina precisa el alcance: tienen una implementación “qualitatively simpler […] for at least some uses of each pattern”. Vale la pena leer con cuidado qué midió, porque la cifra se suele repetir sin contexto:
- Es una revisión de un experto, no un experimento: no mide nada en programas reales.
- Es sobre Dylan y Lisp, no sobre cualquier lenguaje dinámico, y mucho menos sobre TypeScript.
- Dice “más simple” y “para algunos usos”. No dice que esos patrones sobren.
- Los 16 no se deben a una sola característica:
| Característica del lenguaje | Patrones | ¿La tiene TypeScript? |
|---|---|---|
| Tipos de primera clase (6) | Abstract Factory, Flyweight, Factory Method, State, Proxy, Chain of Responsibility | En parte: las clases son valores |
| Funciones de primera clase (4) | Command, Strategy, Template Method, Visitor | Sí |
| Macros (2) | Interpreter, Iterator | No, pero tiene iteradores en el lenguaje |
| Combinación de métodos (2) | Mediator, Observer | No |
| Multimétodos (1) | Builder | No |
| Módulos (1) | Facade | Sí |
Dos de los patrones de esta semana, Adapter y Decorator, ni siquiera están entre esos 16. Así que la lección no es “los patrones sobraron”, sino más específica: pregunten qué parte de un patrón resolvía su problema y qué parte solo le daba la vuelta a una limitación del lenguaje.
Veamos ahora los que siguen vigentes, cada uno con un ejemplo de Kallpa y lo que cuesta.
Strategy
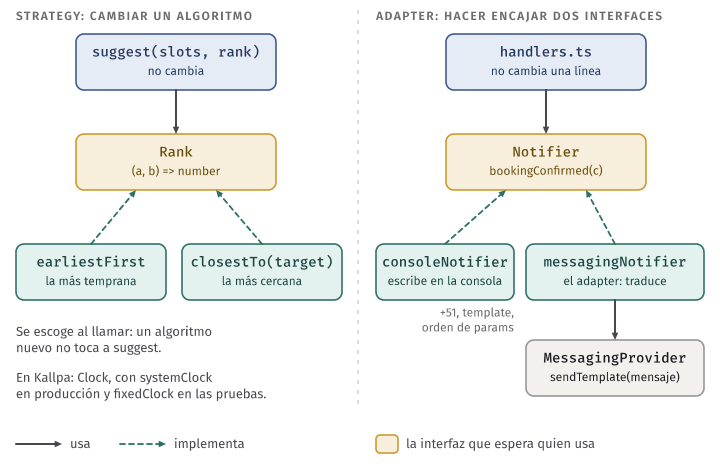
Problema. Hay varias formas de hacer algo y se quiere cambiar de una a otra sin tocar a quien lo usa.
Solución clásica. Una interfaz con un método y una clase por cada
algoritmo; quien usa el algoritmo recibe un objeto de esa interfaz.
patterns/strategy.ts lo escribe así
para ordenar las horas libres que se le sugieren a un vecino:
export interface HourRanker {
  compare(a: number, b: number): number;
}

export class EarliestFirst implements HourRanker {
  compare(a: number, b: number): number {
    return a - b;
  }
}

// ... y ClosestTo, una clase con un campo #target y su propio compare
En TypeScript. Las funciones son valores, así que la interfaz con un solo
método se vuelve el tipo de una función, y Array.prototype.sort ya recibe
justamente eso:
export type Rank = (a: number, b: number) => number;

export const earliestFirst: Rank = (a, b) => a - b;
export const closestTo =
  (target: number): Rank =>
  (a, b) =>
    Math.abs(a - target) - Math.abs(b - target) || a - b;

export function suggest(slots: Slot[], rank: Rank): number[] {
  return slots
    .filter((slot) => slot.available)
    .map((slot) => slot.hour)
    .sort(rank);
}
Las dos versiones ordenan igual, lo comprueba patterns.test.ts. La segunda
tiene menos ceremonia y el patrón sigue ahí: un algoritmo que se cambia sin
tocar a suggest. El dato que en la clase era un campo privado (#target)
ahora lo guarda la clausura.
En Kallpa. Clock es una estrategia para obtener “ahora”, con una forma
un poco más grande que una función porque es un objeto con un método:
export type Clock = {
  now(): Date;
};
systemClock en producción y fixedClock en las pruebas. Si cada función
llamara a new Date(), una prueba que hoy siempre da el mismo resultado
dependería del día en que se corre, y probar “esa hora ya pasó” obligaría a
escribir fechas relativas a hoy.
Cuándo no. Si solo hay un algoritmo, y no hay un motivo concreto para esperar otro, llamen a la función y ya. El costo de una estrategia es una indirección: para saber qué código corre, hay que mirar quién la pasó.
Dependency injection
Problema. Un módulo necesita a otro, y si lo crea él mismo queda atado a esa implementación: no se puede cambiar ni probar por separado.
Solución. Un módulo recibe sus dependencias en lugar de crearlas. El término es de Martin Fowler, en el artículo de 2004 de esta semana. Fowler parte de que “inversión de control” era un nombre demasiado general, y propone dependency injection para algo más preciso: un objeto aparte (el ensamblador) conecta las piezas. Distingue tres estilos:
- Por constructor (constructor injection): las dependencias se pasan al crear el objeto.
- Por setter (setter injection): se asignan con métodos después de crearlo.
- Por interfaz (interface injection): el objeto implementa una interfaz que define cómo inyectarlas.
También compara la inyección con otra alternativa: el service locator, un objeto al que se le piden las dependencias. Y hace una observación que dura hasta hoy: lo central es separar la configuración del uso, más que la herramienta con la que se haga.
En Kallpa. createServer recibe lo que necesita: createServer({ db, clock, notifier, log }). Es inyección por constructor en la forma más simple,
sin clases. En producción, main.ts abre el archivo real y se queda con el
reloj del sistema y el notificador por consola, que son los valores por
omisión. En las pruebas, test/helpers.ts pasa otra cosa en cada lugar:
const db = openDatabase(':memory:');
seedCatalog(db);
const sent: BookingConfirmation[] = [];
const notifier: Notifier = { bookingConfirmed: (confirmation) => sent.push(confirmation) };
const server = createServer({ db, clock: fixedClock(options.now ?? MONDAY_10AM), notifier, log: () => {} });
Sin esto, cada prueba escribiría en un archivo real, dependería de la fecha y llenaría la consola. La semana 9 estudia estos reemplazos con su nombre: test doubles.
Error común. Creer que la dependency injection necesita un contenedor, anotaciones o una biblioteca. Pasar parámetros al construir el objeto es dependency injection. Un contenedor automatiza ese cableado cuando hay cientos de objetos; Kallpa tiene unos pocos y un solo lugar donde se arman, y agregarle uno haría el código más difícil de seguir.
Adapter
Problema. Ya existe algo con una interfaz, y el código espera otra. No se puede cambiar ninguna de las dos, o no se debe.
Solución. Un objeto pequeño que implementa la interfaz que el código espera y por dentro llama a la otra.
En Kallpa. Notifier es la interfaz que Kallpa espera, y hoy la
implementa consoleNotifier. Cuando el complejo contrate un proveedor de
WhatsApp, ese proveedor tendrá su propia interfaz. El proveedor de
patterns/adapter.ts es inventado para
la clase; su forma no copia la API de ninguna empresa, y el ejemplo real
tendría además autenticación y manejo de errores:
export type TemplateMessage = {
  to: string; // con código de país: +51987654321
  template: string;
  params: string[];
};

export type MessagingProvider = {
  sendTemplate(message: TemplateMessage): void;
};

// Lo único que sabe de los dos lados: traduce una llamada en la otra.
export function messagingNotifier(provider: MessagingProvider): Notifier {
  return {
    bookingConfirmed(c: BookingConfirmation) {
      provider.sendTemplate({
        to: `+51${c.phone}`,
        template: 'reserva_confirmada',
        params: [c.memberName, c.courtName, c.date, `${c.startHour}:00`, String(c.hours), String(c.priceCents)],
      });
    },
  };
}
Toda la traducción está en un solo lugar: el +51, el nombre del template,
el orden de los parámetros. La prueba arma el servidor real con este adapter y
hace una reserva por HTTP. El mensaje llega al proveedor con su formato, y
handlers.ts no cambió una línea.
Fíjense en cómo se conectan las ideas: el adapter resuelve el formato, y puede
enchufarse sin tocar nada porque Kallpa ya recibía su Notifier por
dependency injection. También es ocultamiento de información en el sentido de
Parnas (semana 5): la decisión “qué proveedor usamos” queda dentro de un
módulo.
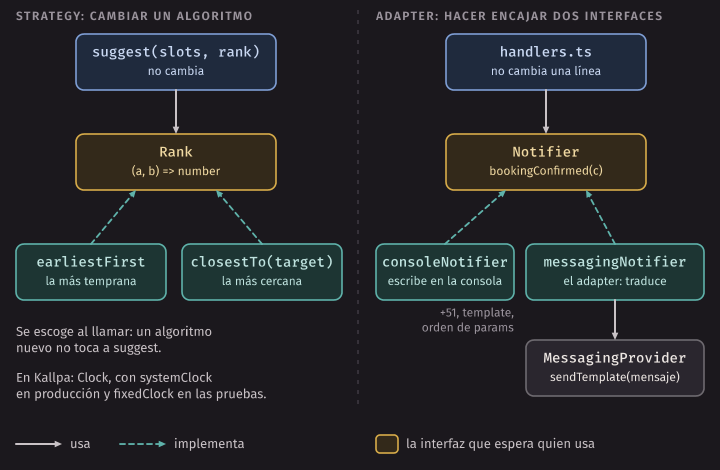
Cuándo no. Un adapter para un proveedor que todavía no existe, “por si
acaso”, es código sin usuarios. Lo que sí conviene desde el inicio es la
interfaz Notifier, que no cuesta casi nada y ya sirve para las pruebas. El
adapter se escribe el día en que hay un proveedor.
En la industria. La semana 7 estudia la arquitectura hexagonal, de Alistair Cockburn, también llamada de puertos y adaptadores. Es esta misma idea llevada a todo un sistema: el núcleo define las interfaces que necesita (los puertos), y cada tecnología externa entra por un adaptador.
Repository
Problema. La lógica del negocio no debería saber cómo se guardan las cosas.
Solución. Fowler, en el catálogo de Patterns of Enterprise Application Architecture, define Repository como algo que “mediates between the domain and data mapping layers using a collection-like interface for accessing domain objects”. Quien lo usa ve una colección de objetos del dominio, y no ve SQL.
En Kallpa. src/store/ tiene tres repositorios. El de canchas se ajusta
bien a la definición:
list(): Court[] {
  return this.#db.prepare('SELECT id, name, sport FROM courts ORDER BY name').all() as Court[];
}
Devuelve Court, un tipo del dominio. BookingRepository, en cambio,
devuelve BookingRow, con los nombres de las columnas (start_hour,
court_id). Tiene el nombre del patrón, pero no esconde del todo lo que el
patrón promete esconder: es la abstracción que se filtra de la semana pasada.
Se parece más a un acceso a una tabla que a una colección de reservas. Poner
Repository en el nombre de una clase no la vuelve un repositorio.
Cuándo no. Una aplicación con tres consultas no necesita una capa aparte
solo para tener el patrón. Y una interfaz CourtRepository con una sola clase
que la implementa, y que no se prueba con otra cosa, es ceremonia: la clase ya
es la interfaz.
Decorator y middleware
Problema. Se quiere agregar algo antes o después de una operación (un log, manejo de errores, una medición de tiempo) sin cambiarla, y poder combinar esos agregados.
Solución. Un decorator envuelve a un objeto con otro de la misma
interfaz: quien lo usa no nota la diferencia, y el de adentro no se entera.
En TypeScript suele ser una función que recibe una función y devuelve otra del
mismo tipo. Ya vieron uno en este capítulo: withIdempotency. Los frameworks
web llaman middleware a esta misma idea aplicada a los handlers de HTTP.
En Kallpa. Hoy, src/http/server.ts hace todo junto dentro de un solo
try/catch/finally: buscar la ruta, convertir errores en JSON y escribir el
log. decorator-server.diff lo
separa en tres funciones, todas con la misma firma:
type RawHandler = (req: IncomingMessage, res: ServerResponse) => Promise<void>;

// Convierte cualquier error en una respuesta JSON.
function withErrors(next: RawHandler): RawHandler {
  return async (req, res) => {
    try {
      await next(req, res);
    } catch (error) {
      if (error instanceof HttpError) {
        sendError(res, error);
      } else {
        console.error(error);
        sendError(res, new HttpError(500, 'INTERNAL_ERROR', 'Ocurrió un error inesperado.'));
      }
    }
  };
}

// Escribe una línea de log al terminar, pase lo que pase. Va por fuera de
// withErrors para ver el código de estado que de verdad se respondió.
function withLog(log: (line: string) => void, next: RawHandler): RawHandler {
  return async (req, res) => {
    try {
      await next(req, res);
    } finally {
      log(`${req.method} ${req.url} ${res.statusCode}`);
    }
  };
}
Y al armar el servidor se leen de afuera hacia adentro:
return http.createServer(withLog(log, withErrors(dispatcher(router))));make decorator aplica el cambio a una copia de Kallpa y corre su make check:
 src/http/server.ts | 65 ++++++++++++++++++++++++++++++++++++------------------
 1 file changed, 44 insertions(+), 21 deletions(-)
ℹ tests 40
ℹ suites 6
ℹ pass 40
ℹ fail 0Las 40 pruebas de Kallpa pasan, y el Makefile comprueba que test/ no cambió,
igual que en el refactoring de la semana pasada. Hay un único detalle fuera de
lo que esas pruebas miran: new URL(...) pasó a estar dentro de withErrors,
y por lo tanto un error al armar la URL ahora responde 500, en lugar de
quedar sin capturar. El tamaño del cambio también es un dato: 44 líneas nuevas
y 21 borradas. En un servidor de este tamaño, con un solo try/catch, no está
claro que convenga. Convendría cuando haya que agregar un tercer y un cuarto
wrapper, por ejemplo una medición de tiempos o una clave de idempotencia.
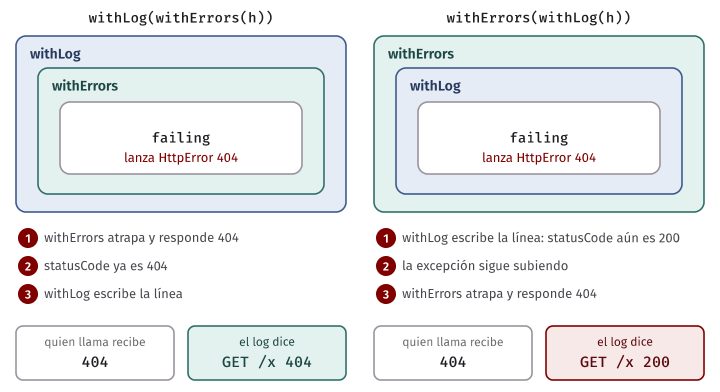
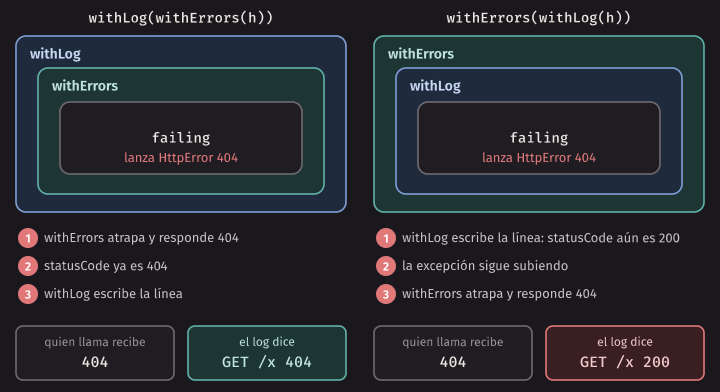
El orden importa. Componer decorators no es conmutativo, y aquí tenemos
una demostración exacta. patterns.test.ts envuelve un handler que lanza un
404 de las dos formas:
✔ decorator: withLog(withErrors(h)) registra el estado que recibió el cliente HTTP
✔ decorator: al revés, withErrors(withLog(h)) registra un 200 que nunca existió
(Salida de node --test, sin los tiempos.)
En el segundo orden, cuando withLog escribe su línea, todavía nadie
convirtió la excepción en una respuesta, y res.statusCode tiene su valor por
omisión, 200. El cliente HTTP recibe un 404 y el log dice 200. El tipo
es el mismo y tsc no se queja: el orden es una decisión de diseño que solo
una prueba puede proteger.
Cuándo no. Si el agregado solo se usa en un lugar y nunca se va a combinar con otro, una llamada directa se lee mejor que un wrapper.
Observer
Problema. Cuando pasa algo, varias partes del sistema tienen que reaccionar, y quien lo hace pasar no debería conocerlas.
Solución. Quien produce el evento mantiene una lista de interesados y les
avisa; se pueden agregar y quitar sin tocar a quien produce. En Node existe
EventEmitter.
En Kallpa. Hoy createBooking llama directamente al notificador. Si
además hubiera que actualizar la caja y registrar una métrica, ese handler
conocería a tres módulos más. Con eventos, sabe solo que debe avisar
(patterns/observer.ts):
export function confirmBooking(
  events: EventEmitter<BookingEvents>,
  saved: BookingConfirmedEvent[],
  booking: BookingConfirmedEvent,
): void {
  saved.push(booking);
  events.emit('booking-confirmed', booking);
}
Quienes reaccionan se registran en otro lugar:
events.on('booking-confirmed', (e) => log.push(`whatsapp ${e.bookingId}`));
events.on('booking-confirmed', (e) => log.push(`caja ${e.priceCents}`));
Lo que cuesta. Se paga por tres lados, y conviene conocerlos antes de elegirlo:
- El flujo ya no se lee de corrido. Para saber qué pasa cuando se confirma una reserva, hay que buscar en todo el proyecto quién escucha ese evento. Esto es la oscuridad de la semana pasada, comprada a cambio de menos acoplamiento.
- El orden es implícito. Los listeners corren en el orden en que se registraron, y ese orden no se ve en ningún lugar del código de reservas.
- Un listener que falla afecta a todos. Este es el menos obvio.
emites síncrono: llama a los listeners uno por uno, dentro de la misma llamada. Si uno lanza una excepción, los siguientes no corren y la excepción le llega a quien emitió:
test('observer: un listener que lanza corta a los siguientes y le llega a quien emitió', () => {
  const events = createBookingEvents();
  const saved: BookingConfirmedEvent[] = [];
  const log: string[] = [];
  events.on('booking-confirmed', () => {
    throw new Error('WhatsApp no responde');
  });
  events.on('booking-confirmed', () => log.push('caja'));
  assert.throws(() => confirmBooking(events, saved, event), /WhatsApp no responde/);
  assert.equal(saved.length, 1); // la reserva ya está guardada...
  assert.deepEqual(log, []); // ...y la caja nunca se enteró
});
La reserva quedó guardada, la caja no se enteró y quien llamó a la API va a
recibir un 500 por una reserva que sí se hizo. Es el mismo problema de la
respuesta perdida, causado esta vez desde adentro. El desacoplamiento era del
código, no de las fallas. Para separar también las fallas hace falta capturar
errores en cada listener o usar una cola de mensajes, que tiene sus propios
costos.
Cuándo no. Con uno o dos reaccionantes que se conocen y no cambian, una
llamada directa dice más. Kallpa hoy tiene uno: el notificador. Un
EventEmitter allí sería prematuro.
Factory Method
Problema. Quien usa un objeto no debería decidir qué clase concreta crear.
Solución clásica. Refactoring.Guru lo define como un método en una superclase para crear objetos, que las subclases pueden redefinir para cambiar el tipo de lo que se crea. Según esa definición, el patrón requiere herencia, y Norvig lo pone entre los que se simplifican cuando los tipos son valores de primera clase.
En TypeScript. Lo que más se ve es algo más simple, y no es exactamente ese patrón: una función que elige y devuelve una implementación. Se le dice factory function. Es útil cuando la decisión depende de un dato:
export function notifierFor(channel: 'console' | 'silent'): Notifier {
  return channel === 'console' ? consoleNotifier : { bookingConfirmed() {} };
}
También fixedClock('2026-03-09T15:00:00Z') es una factory function: da un
objeto listo con un Clock dentro y le esconde a quien llama cómo está hecho.
Cuándo un patrón estorba
Más interfaces sin esconder nada
Aplicar un patrón porque existe es un error frecuente, y se reconoce por la
desproporción entre lo que se agrega y lo que se esconde. Este código es de
patterns/overkill.ts, escrito para
discutirlo:
export interface NotifierFactory {
  create(): Notifier;
}

export class ConsoleNotifierFactory implements NotifierFactory {
  create(): Notifier {
    return consoleNotifier;
  }
}

export class NotifierFactoryProvider {
  getFactory(): NotifierFactory {
    return new ConsoleNotifierFactory();
  }
}
La prueba lo dice en una línea: todo eso devuelve lo mismo que escribir el nombre de la constante.
assert.equal(new NotifierFactoryProvider().getFactory().create(), consoleNotifier);Son módulos superficiales en el sentido de la semana 5: una interfaz tan grande como la implementación. Quien lee tiene que recorrer tres definiciones para llegar a un nombre que ya estaba exportado. Y no abaratan ningún cambio: si mañana hay otro notificador, hay que escribirlo igual y cambiar una línea, con o sin fábrica.
El Singleton
Un Singleton garantiza que una clase tenga una sola instancia, accesible desde cualquier parte. Es estado global con otro nombre, y sus problemas son los del estado global. Quien depende de él no lo dice en su firma, y lo que una prueba le hace le llega a la siguiente:
// El código que depende del Singleton no lo dice en su firma.
export function isMorningWithSingleton(): boolean {
  return GlobalClock.getInstance().now().getUTCHours() < 17; // 12:00 en Lima
}

// El mismo código con el reloj como parámetro.
export function isMorning(clock: Clock): boolean {
  return clock.now().getUTCHours() < 17;
}
Con la segunda versión, cada llamada dice qué hora usa y nada se comparte. La
necesidad de una sola instancia suele resolverse creando una sola, en un solo
lugar, y pasándola: en Kallpa hay una sola conexión a la base de datos, y
nadie necesita una clase especial para eso. main.ts la abre y createServer
la recibe.
Error común. Sumar patrones como si fueran puntos. Un diseño con más patrones no es un diseño mejor. Un diseño mejor esconde más y le pide menos a quien lo lee.
La pregunta
Para cualquier patrón, en su propio código o en una revisión, la pregunta es la misma: ¿qué cambio futuro abarata esto, y qué tan probable es?
| Patrón | Abarata | En Kallpa |
|---|---|---|
| Strategy | Cambiar un algoritmo | Clock: un reloj fijo en cada prueba |
| Dependency injection | Reemplazar una dependencia | createServer: la base de datos, el reloj y el notificador |
| Adapter | Cambiar de proveedor | Notifier: el día en que haya WhatsApp Business |
| Repository | Cambiar cómo se guarda; probar sin base de datos | src/store/, con la filtración de BookingRow |
| Decorator | Agregar y combinar cosas alrededor de una operación | El try/catch/finally de server.ts |
| Observer | Agregar reacciones sin tocar a quien produce | Todavía no: hay un solo reaccionante |
| Factory Method | Cambiar qué se crea | Una función basta |
Si no se puede nombrar el cambio, el patrón probablemente sobra. Y si se puede, pero es poco probable, todavía pueden esperar: agregar una abstracción cuando llega el segundo caso suele costar poco, y con dos casos reales se diseña mejor que con uno imaginado.
Idea clave. Un patrón es una respuesta. Sin una pregunta concreta (qué cambio se quiere abaratar), solo es más código.
Con IA. Los modelos de lenguaje reproducen los patrones que más aparecen en el código con el que se entrenaron, y a veces los traen con más ceremonia de la necesaria: interfaces con una sola implementación, fábricas para todo, capas que solo reenvían. Es una observación de la práctica, no un resultado medido, y varía según la herramienta y el pedido. Lo que no varía es cómo se revisa: para cada abstracción nueva de un diff, pregunten qué cambio facilita y cuántas implementaciones tiene hoy. Un
NotifierFactoryProvidercomo el de arriba pasatsc, ESLint y todas las pruebas. Ninguna herramienta lo va a marcar; tiene que hacerlo quien revisa.
El laboratorio: documentar la API de Kallpa
El laboratorio aplica la primera parte del capítulo, en parejas, en una rama
nueva de su copia de Kallpa. Los pasos completos están en la guía de la
semana; aquí van los puntos que más cuestan. La regla
central: la especificación describe la API como es hoy, no como debería
ser. Las mejoras van aparte, en docs/api-revision.md.
Recorrer antes de escribir (pasos 1 y 2). Con dos terminales en el mismo
contenedor: make seed y make start en una, curl -s -i en la otra. Anoten
en una tabla, por endpoint, el código y la forma del cuerpo de cada
respuesta, también de error. No se la crean al README: revísenla contra lo que
responde el servidor. Pregúntense por cada operación qué entradas darían otra
respuesta. Si su copia ya tiene integrado su issue de P0, puede tener más
endpoints.
Escribir por partes (pasos 3 y 4). Copien
code/week-06/openapi.yaml a
docs/openapi.yaml y agreguen un endpoint a la vez, corriendo redocly lint docs/openapi.yaml cada vez. Los códigos de error van en un enum en el
esquema Error.
Las reglas en el esquema (paso 4). minimum, maximum y maxLength
documentan las reglas del README, pero no reemplazan a lo que hace el
servidor. Si el esquema dice maximum: 3 para hours, el servidor aun así
responde con su propio código cuando llega un 4. Documenten los dos.
Las advertencias (paso 5). El paso pide corregir o justificar cada una con
un comentario en el YAML. No agreguen una respuesta falsa para que desaparezca
una advertencia. Después, redocly build-docs docs/openapi.yaml -o docs/api.html genera una página que pueden abrir en el navegador de su
computadora: es el mejor momento para leer su especificación como la leería
alguien de afuera.
La revisión (paso 6). Comparen su tabla y su especificación con las guías,
y encuentren al menos cuatro inconsistencias. Una ya la vieron en este
capítulo: GET /api/members/:id/bookings devuelve un arreglo suelto y las
otras listas un objeto. Busquen las demás en los temas que menciona la guía:
códigos de estado, forma de las respuestas, nombres de campos, la frontera
entre 400 y 422, y qué pasa al reintentar. Para cada una, respondan las
dos preguntas de la guía: ¿corregirla rompe a quien ya llama a la API? ¿Cómo
la harían convivir con la versión actual? La tabla de compatibilidad de este
capítulo y v2-bookings.diff sirven de modelo. Que algo esté mal no quiere
decir que valga la pena corregirlo: “se queda como está, y lo documentamos”
también es una respuesta válida, si la justifican.
La clave de idempotencia (paso 7). Respondan las preguntas de la sección
Las decisiones que el código no toma por ustedes, ahora para Kallpa. Tengan
en cuenta que Kallpa manda un aviso por WhatsApp al confirmar.
idempotency.ts les da la lógica, pero no la respuesta: guarda en un Map y
envuelve una operación que devuelve un resultado, y los handlers de Kallpa
escriben directamente en res. Si hacen la parte opcional, escriban primero
la prueba del reintento, con un servidor de prueba: la misma clave, dos
solicitudes, una sola reserva y un solo aviso en server.sent.
En la industria. P2 pide esta misma especificación para su proyecto, en
docs/api/openapi.yaml, y la revisión automática correredocly lintcon el conjuntorecommended. Los avisos no hacen fallar esa revisión, pero los errores sí. Verprojects/p2-diseno/.
El código de la semana y make test
La carpeta code/week-06 tiene:
| Archivo | Qué es |
|---|---|
openapi.yaml |
El esqueleto del laboratorio |
api.test.ts |
Lo que el capítulo dice de la API publicada de Kallpa, contra un servidor de prueba |
recorrido.sh |
make recorrido: reservar, reintentar y cancelar dos veces con curl |
lost-response.ts, charges-server.ts, retry-demo.ts, lost-response.test.ts |
La respuesta perdida: en Kallpa y en un servidor de pagos, con y sin clave (make retry) |
idempotency.ts, idempotency.test.ts |
La clave de idempotencia como decorator |
evolution.ts, evolution.test.ts |
Qué cambios rompen a qué clientes HTTP |
v2-bookings.diff, recorrido-v2.sh |
Una versión nueva con Deprecation y Sunset (make v2, make recorrido-v2) |
contract.ts, contract.test.ts, client-example.ts |
Comparar respuestas y clientes HTTP con la especificación |
lint-examples/, lint.test.ts |
Lo que redocly lint encuentra y lo que no |
patterns/, patterns.test.ts |
Los patrones del capítulo |
decorator-server.diff |
withErrors y withLog en server.ts (make decorator) |
make test revisa los tipos, corre ESLint y redocly lint sobre el
esqueleto, corre las pruebas de la carpeta y aplica los dos diffs a copias de
Kallpa, corriendo su make check en cada una. Los ejemplos leen la Kallpa del
curso sin modificarla: se copia a build/kallpa.
Resumen
- Una API es un contrato con quien no está en la sala. No se puede revisar ni actualizar a quien llama, y por la ley de Hyrum todo lo observable termina siendo parte del contrato.
- Diseño orientado a recursos: sustantivos en las rutas y verbos estándar
(List y Get con
GET, Create conPOST, Update conPATCH, Delete conDELETE). Lo que no encaja es un método propio, como cancelar. - Seguro (RFC 9110): quien llama no pide un cambio de estado.
Idempotente: el efecto buscado de N solicitudes iguales es el de una. La
respuesta puede cambiar.
POSTyPATCHno están definidos como idempotentes, pero una operación concreta puede serlo si se diseña y se documenta así. - Una respuesta perdida deja a quien llama sin saber qué pasó. Reintentar
un
POSTpuede duplicar la operación, o fallar sin decir que la primera vez funcionó. - Una clave de idempotencia identifica la intención: el servidor guarda la
clave con la respuesta y, ante un reintento, la repite. El borrador de la
IETF, que aún no es un RFC, recomienda
422si se reusa la clave con otro cuerpo y409si la primera sigue en proceso. La garantía real exige guardar la clave y el efecto en la misma transacción. - Códigos de estado y errores: una frontera entre
400y422escrita y respetada, y una sola forma de error con un código estable. - Compatible es lo que no rompe a quien ya llama. Quitar, renombrar o cambiar el significado o el código de estado no lo es. Agregar un campo lo es si quien llama ignora lo que no conoce. Envolver una lista hace posible la paginación, pero agregar paginación sigue siendo un cambio de comportamiento (AIP-158).
- Deprecar: convivir, anunciar con
DeprecationySunset, medir y recién entonces apagar. Google versiona en la ruta y Azure en un parámetro; lo común es no romper una versión ya publicada. - OpenAPI deja el contrato por escrito.
redocly lintrevisa el documento, no el servidor: para saber si dice la verdad hay que comparar con respuestas reales. - Un patrón de diseño es una solución con nombre y con costos. Siguen vigentes el problema y el vocabulario; la forma cambia. Norvig: 16 de 23 son invisibles o más simples en Dylan o Lisp, para algunos usos. Esa cifra no se traslada tal cual a otros lenguajes.
- Strategy es a menudo solo una función; dependency injection, pasar parámetros; adapter traduce; repository esconde cómo se guarda; decorator envuelve, y el orden importa; observer desacopla el código, no las fallas.
- Antes de aplicar un patrón: ¿qué cambio futuro abarata y qué tan
probable es? Un
NotifierFactoryProviderpasa todas las herramientas, y aun así sobra.
Ejercicios
- Clasifiquen estas solicitudes como seguras, idempotentes o ninguna de las
dos, justificando con la definición de RFC 9110:
GET /api/courts; unGETque registra una visita en un log;PUT /api/courts/1con la cancha entera;PATCH /api/members/2con{ "plan": "socio" };PATCH /api/members/2con{ "balanceDelta": 10 }. - Un compañero dice: “
POST /api/bookings/12/cancelno es idempotente, porquePOSTnunca lo es; además, la segunda vez responde otra cosa”. Respóndanle por escrito, separando el método de la operación, y digan qué le falta a Kallpa para que quien llama pueda contar con ese comportamiento. - Clasifiquen como compatible o incompatible, y digan qué tendría que ser
cierto de quien llama para que no se rompa: agregar
pricea la respuesta de la disponibilidad; cambiarhourporstartHour; pasar un error de400a422; agregar un parámetro opcional?sport=; agregar un valor nuevo alenumdestatus. - Diseñen tres rutas y sus respuestas para una funcionalidad nueva de Kallpa: implementos que se prestan con una reserva (como en la semana 5). Escriban para cada operación el método, la ruta, el código de éxito y al menos dos códigos de error. ¿Alguna es un método propio?
- Agreguen a
idempotency.test.tsuna prueba para esta decisión: una operación que devuelve500(sin lanzar una excepción) no debería quedar guardada. ModifiquenwithIdempotencypara que pase. ¿Qué cambia para quien reintenta? Busquen un caso en el que esta decisión sea peligrosa. - En
lost-response.test.ts, agreguen una prueba de un cliente HTTP con el error común: genera la clave de idempotencia dentro del bucle de reintentos. Comprueben que cobra dos veces y corríjanlo. - Escriban en
evolution.tsun cuarto cliente HTTP y un cambio que lo rompa sin cambiar ningún nombre ni ningún tipo: solo el significado de un campo. ¿Lo detectaría una especificación OpenAPI? ¿Qué lo detectaría? - Extiendan
contract.tspara que reviseformat: date(YYYY-MM-DD) y agreguen una prueba. ¿Por qué se debe distinguir entre “una respuesta no cumple la especificación” y “la especificación no describe el servidor”? ¿Qué harían en cada caso? - Escriban un decorator
withTiming(log, next)con la firma depatterns/decorator.ts, que registre cuántos milisegundos tardó el handler. Reciban el reloj como dependencia para poder probarlo. ¿En qué lugar de la cadena lo ponen, y qué mide en cada posición? - Un compañero propone una interfaz
NotifierFactorycon una sola implementación que devuelveconsoleNotifier. Escriban el comentario que dejarían en la revisión de código: qué pregunta le hacen, qué alternativa proponen y en qué condición futura sí la aceptarían. - Cambien
patterns/observer.tspara que un listener que falla no afecte a los demás ni a quien emite. Ajusten la prueba correspondiente. ¿Qué pasa ahora con el error? ¿Dónde queda registrado, y quién se entera de que el aviso de WhatsApp no salió? - En el proyecto de su equipo, escriban la especificación de tres
operaciones (o revisen la que tienen para P2) y escojan un patrón de este
capítulo que estén usando, o que estén a punto de usar. Respondan por
escrito, para el
docs/diseno.mdde P2: ¿qué cambio futuro abarata y qué tan probable es? Si no pueden nombrarlo, propongan cómo quitarlo.