Apuntes · Capítulo 7Diseño y arquitectura
Arquitectura y decisiones de arquitectura
Arquitectura y decisiones de arquitectura
La semana pasada diseñaron la API de Kallpa: qué recursos expone, qué códigos de estado responde y qué promete a quien la llama. Dos semanas antes discutimos cómo repartir el código en módulos para que esconda decisiones. Esta semana subimos un piso más. La pregunta ya no es cómo se escribe un módulo, sino cuáles son las decisiones de todo el sistema que después cuesta mucho cambiar, cómo se eligen con argumentos y cómo se dejan por escrito para quien llegue después.
Kallpa vuelve a ser el caso de estudio, y esta vez con un problema concreto. El complejo quiere correr dos copias del servidor sobre el mismo archivo de base de datos, para que una caída no deje a los vecinos sin reservar. Parece un cambio de configuración. Con mediciones veremos que no lo es: en la Kallpa publicada, con dos copias, la mitad de las peticiones simultáneas puede terminar en un error 500. Y el arreglo que se le ocurre a casi todos, esperar en vez de fallar, hace que desaparezcan los errores y que aparezca algo peor: canchas reservadas dos veces.
El capítulo sigue las dos sesiones de la semana. En la primera definimos arquitectura, y comparamos la arquitectura en capas, la hexagonal, el monolito, el monolito modular y los microservicios, con la ley de Conway y la estrategia monolith first como criterios para elegir. En la segunda escribimos los atributos de calidad como escenarios que se pueden medir, estudiamos el caso de las dos instancias, aprendemos a documentar una decisión en un ADR y dibujamos el sistema con el modelo C4.
Lectura. Sesión A: Martin Fowler y James Lewis, Microservices (2014), las características de un microservicio y, al final, Are Microservices the Future?; Martin Fowler, MonolithFirst (2015); Alistair Cockburn, Hexagonal Architecture. Complementarias: Fowler, PresentationDomainDataLayering y su guía de arquitectura de software; SQLite, Appropriate Uses For SQLite.
Sesión B: Michael Nygard, Documenting Architecture Decisions (2011); MADR, el template de ADR con alternativas consideradas; Simon Brown, The C4 model, en especial el diagrama de contenedores. Complementarias: Architectural Decision Records (adr.github.io); Fowler, TechnicalDebtQuadrant; Mermaid, C4 diagrams, y GitHub, Creating diagrams.
El código de este capítulo está en code/week-07. Todas las salidas que se muestran son de ejecuciones reales en el contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Qué es arquitectura, Las decisiones caras de cambiar y No todo merece la misma ceremonia; de Arquitectura en capas, La regla; de Arquitectura hexagonal: puertos y adaptadores, El problema que resuelve y Definiciones; de Monolito, monolito modular y microservicios, Monolito y Microservicios; de Atributos de calidad, Qué son y Escenarios: estímulo, entorno, respuesta y medida; y de Decisiones de arquitectura: los ADR, El problema que resuelven y El formato.
- En clase: Sesión A: Qué es arquitectura, Arquitectura en capas, Arquitectura hexagonal: puertos y adaptadores y Monolito, monolito modular y microservicios. Sesión B: Atributos de calidad, El caso: dos instancias sobre un mismo archivo, Decisiones de arquitectura: los ADR y, si hay tiempo, El modelo C4. Laboratorio: Laboratorio: un ADR y un diagrama de contenedores para Kallpa.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Un ejemplo completo de ADR, La deuda técnica como decisión, Qué alternativas hay, Diagramas como texto con Mermaid y las lecturas del recuadro Lectura.
Qué es arquitectura
Las decisiones caras de cambiar
La palabra arquitectura se usa con mucha soltura. El propio Martin Fowler, en su guía, dice que cuando la industria habla de arquitectura se refiere a una noción “definida con vaguedad” de los aspectos más importantes del diseño interno de un sistema. Para este curso usamos una definición de trabajo que sirve para tomar decisiones:
Arquitectura es el conjunto de decisiones de un sistema que son caras de cambiar después: cómo se divide en partes, cómo se comunican esas partes, dónde viven los datos y cómo se despliega.
La definición tiene una consecuencia que conviene ver de una vez: lo que es arquitectura depende del costo de cambiarlo, no del tema ni del tamaño del diagrama. El nombre de una función no es arquitectura, aunque la use todo el mundo, porque un editor la renombra en un segundo. “SQLite en un archivo, en el mismo proceso que el servidor” sí lo es, aunque se escriba en una línea.
Michael Nygard, en el artículo que propuso los ADR, da una lista parecida desde otro ángulo. Él llama arquitectónicamente significativas a las decisiones que afectan la estructura, las características no funcionales, las dependencias, las interfaces o las técnicas de construcción. Las dos miradas se complementan: la lista de Nygard dice dónde buscar, y el costo de cambiar dice cuáles importan.
Una prueba con Kallpa
Veamos varias decisiones de Kallpa y qué costaría cambiar cada una:
| Decisión | ¿Qué cuesta cambiarla? | ¿Arquitectura? |
|---|---|---|
| El puerto por omisión es 3000 | Una variable de entorno | No |
quotePriceCents se llama así |
Un renombre automático | No |
| La página no usa frameworks | Reescribir public/, unos cientos de líneas |
Poco: son pocas y están aisladas |
| Los montos son céntimos enteros | Cada columna, cada cálculo, cada prueba y los datos guardados | Sí |
| Fecha como texto y hora como entero, sin timestamps | El esquema, los datos, las comparaciones y la API | Sí |
| SQLite en el mismo proceso que el servidor | Ver abajo | Sí |
| Todo se despliega como un solo programa | Separar datos, redes, despliegues y fallas | Sí |
La línea entre “poco” y “sí” es de grado. No hay un límite exacto, y no hace falta: lo útil es hacerse la pregunta antes de decidir.
La fila de SQLite merece una mirada de cerca, porque parece que la capa
store la esconde. Veamos quién conoce esta decisión:
$ grep -rl "node:sqlite\|DatabaseSync" src
src/http/server.ts
src/services/booking-service.ts
src/store/member-repository.ts
src/store/court-repository.ts
src/store/seed.ts
src/store/database.ts
src/store/booking-repository.ts
Son solo siete archivos, y el SQL está en store. Se podría pensar que
cambiar a PostgreSQL es reescribir esa carpeta y ya. No es así. node:sqlite
es síncrono: DatabaseSync devuelve el resultado en la misma llamada. Un
cliente de PostgreSQL habla por la red y es asíncrono. Con él, todos los
métodos de store y de services tendrían que devolver una Promise, todos
los handlers tendrían que usar await, y entre revisar que una hora está
libre y guardar la reserva habría un punto donde otras peticiones pueden
correr. Más adelante en el capítulo medimos exactamente qué pasa cuando eso
ocurre.
Es la limitación del ocultamiento de información que vieron en la semana 5: un
módulo esconde sus decisiones hasta donde su interfaz lo permite. Que una
operación sea síncrona o tarde lo que tarda la red es parte de la interfaz, y
por eso “en el mismo proceso” no queda encerrado en store.
Idea clave. Diseño (semana 5) y arquitectura son lo mismo a distinta escala. Los criterios son los mismos: esconder decisiones, reducir dependencias. Lo que cambia es el costo de equivocarse. Por eso a una decisión de arquitectura se le dedica más tiempo, se escribe y se discute con más gente.
No todo merece la misma ceremonia
Una consecuencia práctica: conviene distinguir las decisiones que se pueden revertir fácilmente de las que no. Las primeras se toman rápido y se corrigen si salen mal. A las segundas, como el modelo de datos o el estilo de despliegue, se les dedica un análisis de alternativas. Tratar todas igual es un error en los dos sentidos: un design doc para decidir el nombre de una carpeta hace perder tiempo, y decidir sin pensar dónde viven los datos sale muy caro un año después.
También se puede abaratar una decisión para que deje de ser de arquitectura. Si un módulo esconde cómo se formatea un mensaje, cambiar el formato deja de ser caro. Buena parte del trabajo de arquitectura consiste en eso: reducir la cantidad de decisiones difíciles de revertir.
Arquitectura en capas
La regla
La arquitectura en capas divide el sistema en niveles apilados, donde cada capa usa solo a las de abajo y no sabe nada de las de arriba. La versión más común es la que describe Fowler en PresentationDomainDataLayering: presentación, lógica de dominio y acceso a datos. Su argumento principal es de carga cognitiva: al separarlas, cuando se trabaja en una se puede ignorar casi todo de las otras, y cada una se prueba y se reemplaza por separado.
El README de Kallpa promete esto: http usa services, domain y
notifications; services usa store; y ni store ni domain saben nada
de HTTP. En un dibujo, agregando que casi todos usan los tipos y reglas de
domain:
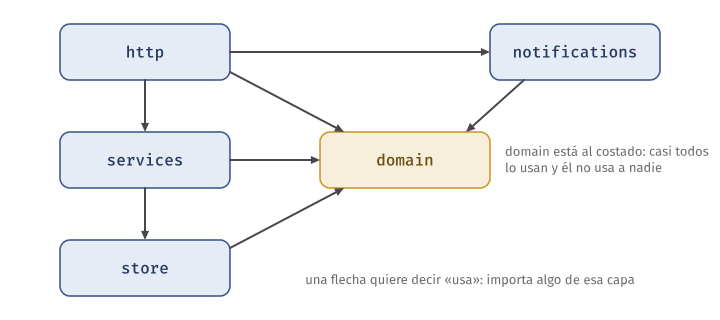
domain está al costado: casi todos lo usan y él no usa a nadie. Por eso no
es una pila estricta, donde cada capa solo conoce a la inmediata inferior. Lo
habitual es una versión relajada, en la que una capa puede saltarse a otra
si la regla lo dice. Lo que importa es que la regla se pueda enunciar y
comprobar.
Medir en vez de creer
La regla vale lo que vale su cumplimiento. En la semana 5 lo medimos con
layers.ts. Esta semana usamos la forma más directa, que es el paso 1 del
laboratorio:
$ make dependencias
== src/http
      6 from '../domain/
      2 from '../notifications/
      2 from '../services/
      1 from '../store/
== src/services
      2 from '../domain/
      3 from '../store/
== src/store
      6 from '../domain/
== src/domain
== src/notifications
      1 from '../domain/
src/domain no tiene líneas: no importa nada de otra capa. Y hay una línea
que llama la atención: http importa algo de store, saltándose a
services. Es esta:
import type { BookingRow } from '../store/booking-repository.ts';“Es solo un tipo”, se podría decir. Y es cierto que en ejecución esa línea no existe: Node quita los tipos al cargar el archivo. Pero el código que la usa es este:
export function toBookingJson(row: BookingRow): Booking {
  return {
    id: row.id,
    courtId: row.court_id,
    memberId: row.member_id,
    // ...
El handler sabe cómo se llaman las columnas de la tabla. Si alguien renombra
court_id, tiene que cambiar http/handlers.ts. La dependencia es real
aunque no aparezca en ejecución: acoplarse es necesitar saber algo del
otro, y un tipo es conocimiento. Es lo que la semana 5 llamó una fuga de
información.
Convertir la regla en una revisión automática
Una regla que depende de que alguien se acuerde de revisarla se rompe. ESLint
tiene una regla que sirve para esto,
no-restricted-imports,
que se puede activar solo para algunos archivos:
{
  // domain no sabe de la base de datos ni de HTTP.
  files: ['src/domain/**/*.ts'],
  rules: {
    'no-restricted-imports': [
      'error',
      { patterns: ['../store/*', '../http/*', '../services/*', 'node:sqlite', 'node:http'] },
    ],
  },
},
{
  // http llega a los datos a través de services.
  files: ['src/http/**/*.ts'],
  rules: {
    'no-restricted-imports': ['error', { patterns: ['../store/*'] }],
  },
},
Corrida sobre una copia de Kallpa, en
capas-eslint.js:
$ make capas
cp capas-eslint.js build/kallpa/capas-eslint.js
cd build/kallpa && eslint -c capas-eslint.js . ; echo "eslint terminó con código $?"

/work/code/week-07/build/kallpa/src/http/handlers.ts
  18:1  error  '../store/booking-repository.ts' import is restricted from being used by a pattern  no-restricted-imports

✖ 1 problem (1 error, 0 warnings)

eslint terminó con código 1
Encontró el import de tipo. Ahora hay que decidir: se corrige el código (la
capa services devuelve un tipo que no es una fila) o se cambia la regla (se
acepta que http conozca el tipo de la fila). Las dos respuestas se pueden
defender, y las dos son mejores que no saberlo. Esa decisión es parte del
laboratorio.
Una regla así también tiene límites, y conviene conocerlos para no confiar de más:
- Revisa lo que se le dijo.
http/server.tsimportaDatabaseSyncdenode:sqlite, y la regla no reclama porque parahttpsolo prohíbe../store/*. - Mira las declaraciones
import, no todo lo que el código puede hacer. Una prueba de esta semana comprueba que unimport('../store/database.ts')dinámico dentro dedomainpasa la regla sin aviso. - Mira los imports, no el SQL. Si un handler recibe la conexión por
parámetro, puede llamar a
db.prepare('SELECT ...')sin importar nada destore. Lo único que se vería es que el tipoDatabaseSyncaparece enhandlers.ts.
Error común. Tratar la arquitectura como un dibujo. Un diagrama de capas que ninguna herramienta comprueba describe la intención del día en que se dibujó. La pregunta útil no es “¿qué dice el diagrama?”, sino “¿qué pasa si alguien lo viola?”. Si la respuesta es “nada”, el diagrama no protege a nadie.
En la industria. Revisar las dependencias entre partes de un sistema con una herramienta es práctica establecida. Software Engineering at Google, cap. 18, describe cómo en Bazel cada módulo declara sus dependencias y usar algo no declarado es un error del build, como vimos en la semana 5. El ejemplo de Kallpa es una versión mínima de lo mismo, con una regla que ya viene en ESLint.
Arquitectura hexagonal: puertos y adaptadores
El problema que resuelve
En un dibujo de capas, la base de datos está abajo y todo apunta hacia ella. Eso sugiere que la lógica del negocio depende de la base de datos, y a menudo es verdad: las reglas terminan mezcladas con el SQL y solo se pueden probar con una base de datos de verdad. Y en la parte de arriba pasa algo parecido: las reglas se filtran a los controladores de la interfaz. Alistair Cockburn escribió el patrón para evitar las dos fugas. Su intención, en sus palabras:
Allow an application to equally be driven by users, programs, automated test or batch scripts, and to be developed and tested in isolation from its eventual run-time devices and databases.
En español: que a la aplicación le dé igual quién la maneja (una persona, otro programa, una prueba automática o un script) y que se pueda desarrollar y probar sin los dispositivos ni las bases de datos con los que va a correr al final.
Definiciones
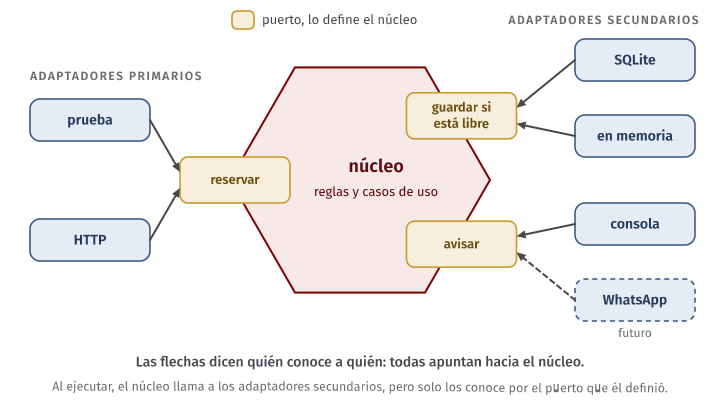
- Núcleo o aplicación: las reglas del negocio y los casos de uso. No conoce ninguna tecnología externa.
- Puerto: una conversación con un propósito, definida por el núcleo en sus propios términos. En código es una interfaz. “Guardar esta reserva si la hora está libre” es un puerto; “ejecutar este INSERT” no lo es.
- Adaptador: el código que conecta un puerto con una tecnología concreta. Para un mismo puerto suele haber varios: el de producción y el de pruebas, por ejemplo.
Cockburn distingue dos lados. Los puertos primarios son por donde alguien maneja a la aplicación (un handler HTTP, una prueba). Los secundarios son por donde la aplicación usa algo de afuera (la base de datos, el envío de avisos). En la literatura también se les dice driving y driven. La regla es una sola y es la que importa:
Las dependencias apuntan hacia el núcleo. El adaptador de SQLite conoce al núcleo; el núcleo no conoce a SQLite.
¿Y por qué un hexágono? Cockburn lo aclara: no porque el número seis importe, sino para tener espacio donde dibujar los puertos que hagan falta y salir del dibujo de una sola dimensión de las capas. Lo que quiere resaltar es la asimetría entre adentro y afuera.
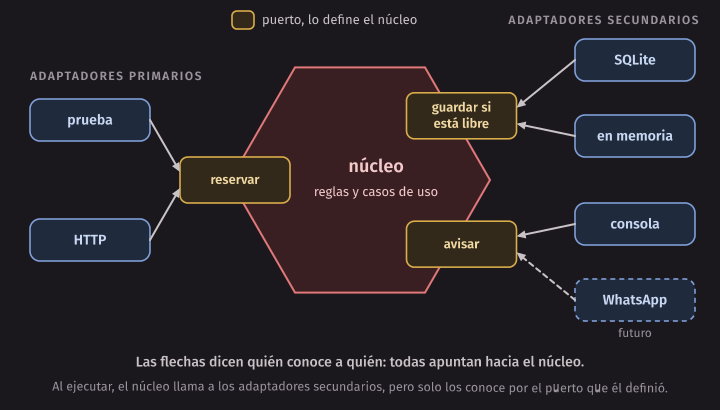
Kallpa como hexágono: la versión honesta
Kallpa tiene dos puertos secundarios bien hechos, y las pruebas ya los aprovechan:
| Puerto | Dónde se define | Adaptadores de hoy | Adaptador futuro |
|---|---|---|---|
Clock |
src/domain/clock.ts |
systemClock, fixedClock |
— |
Notifier |
src/notifications/notifier.ts |
consoleNotifier, el doble de test/helpers.ts |
WhatsApp Business |
Por eso las pruebas de Kallpa fijan la hora en el lunes 9 de marzo a las 10:00
y capturan los avisos sin tocar una línea del código de reservas. El día que
el complejo contrate WhatsApp Business, hará falta un adaptador nuevo de
Notifier, y ni las reglas de precios ni createBooking tienen por qué
cambiar.
Pero Kallpa no es hexagonal en todo, y conviene no contar una historia más bonita que la real:
- Los datos no tienen puerto.
BookingServicerecibe unDatabaseSyncy arma los repositorios de SQLite por su cuenta: la dependencia sigue yendo deserviceshaciastore, no al revés. No hay forma de correrBookingServicesin SQLite. Las pruebas usan SQLite:memory:, lo que funciona bien y es rápido, pero no es un adaptador distinto. - El caso de uso vive en el adaptador primario. Revisar las reglas,
cotizar, guardar y avisar, en ese orden, está en
createBooking, dentro desrc/http. Por esodomainse prueba sin HTTP y reservar no:test/http.test.tslevanta un servidor. Es lo que el laboratorio de la semana 5 empezó a mover hacia un módulo profundo. Notifierno está en el núcleo. Lo definesrc/notifications, junto con su adaptador, yhttplo importa. Funciona porque el archivo no importa nada externo, pero el puerto y el adaptador de consola viven juntos.
Nada de esto es un error grave para un sistema de este tamaño. Es una descripción. La arquitectura real de un sistema casi nunca es un estilo puro, y describirla bien sirve para decidir cuál de esas fugas vale la pena arreglar.
Un puerto de verdad, con dos adaptadores
La carpeta code/week-07/hexagon tiene un ejemplo
mínimo de cómo se vería reservar con un puerto para los datos. El núcleo dice
qué necesita, en palabras del negocio:
export type Reservations = {
  // Promete las dos cosas juntas: revisar que la hora esté libre y guardar. Quien
  // implementa el puerto decide cómo; si devuelve null, la cancha estaba ocupada.
  bookIfFree(booking: NewBooking): SavedBooking | null;
};
Y el caso de uso solo conoce el dominio y los puertos:
export function reserve(deps: ReserveDeps, request: BookingRequest): ReserveResult {
  const violation = checkBookingRules(request, limaTime(deps.clock.now()));
  if (violation) return { ok: false, code: violation.code };

  // Para no alargar el ejemplo, el precio usa una cancha de fulbito y un vecino regular.
  const priceCents = quotePriceCents({
    sport: 'fulbito',
    date: request.date,
    startHour: request.startHour,
    hours: request.hours,
    plan: 'regular',
  });
  const booking = deps.reservations.bookIfFree({ ...request, priceCents });
  if (!booking) return { ok: false, code: 'SLOT_TAKEN' };

  deps.notifier.bookingConfirmed(booking);
  return { ok: true, booking };
}
Hay dos adaptadores: uno en memoria, con un arreglo, y otro de SQLite, con una transacción. Y las mismas pruebas corren contra los dos:
for (const [name, make] of [
  ['memoria', memoryReservations],
  ['SQLite', inSqlite],
] as const) {
  describe(`puerto Reservations: adaptador de ${name}`, () => {
    test('una hora libre se reserva y se avisa', () => { /* ... */ });
    test('un cruce con otra hora de inicio también se rechaza', () => { /* ... */ });
    // ...
▶ puerto Reservations: adaptador de memoria
✔ una hora libre se reserva y se avisa
✔ un cruce con otra hora de inicio también se rechaza
✔ otra cancha a la misma hora está libre
✔ las reglas del dominio no dependen del adaptador
▶ puerto Reservations: adaptador de SQLite
✔ una hora libre se reserva y se avisa
✔ un cruce con otra hora de inicio también se rechaza
✔ otra cancha a la misma hora está libre
✔ las reglas del dominio no dependen del adaptadorUn puerto es un contrato (semana 4), y lo que promete tiene que valer para cualquier adaptador. Por eso se prueba el contrato, no una implementación.
Fíjense en el tamaño de la operación. El puerto no ofrece listBookings e
insert por separado: ofrece bookIfFree. Si fueran dos operaciones, la
regla de “revisar y guardar juntos” quedaría en manos de quien llama, y el
puerto sería un módulo superficial con otro nombre. Más adelante verán por qué
esta diferencia no es de estilo.
Capas o hexágono
Las dos arquitecturas no son rivales: el hexágono también tiene una forma de capas adentro. La diferencia está en quién define la interfaz y hacia dónde apunta la dependencia de los datos:
| En capas (como Kallpa) | Hexagonal | |
|---|---|---|
| ¿Quién define la interfaz de los datos? | store, la capa de abajo |
El núcleo, según lo que necesita |
| ¿De quién depende la lógica de negocio? | Indirectamente, de la base de datos | De nadie |
| Probar un caso de uso | Con base de datos (aunque sea en memoria) | Con un adaptador cualquiera |
| Costo | Menos piezas | Una interfaz y un adaptador más por cada cosa externa |
El costo no es menor. Por cada puerto hay una interfaz más que leer y un salto
más al seguir el código, y una interfaz que refleja uno a uno lo que hay
detrás es justo el método que solo reenvía de la semana 5. Un puerto se
justifica cuando hay de verdad dos adaptadores (producción y pruebas cuenta) o
una tecnología externa que pueda cambiar. Si Kallpa va a usar SQLite y sus
pruebas corren bien en :memory:, un puerto para cada tabla agrega más
complejidad de la que quita.
Error común. Crear una interfaz por cada clase “para que sea hexagonal”. Un
IBookingRepositorycon los mismos ocho métodos que su única implementación no esconde nada ni invierte nada importante: el núcleo sigue pensando en filas. El puerto se escribe en términos de lo que el núcleo necesita.
Monolito, monolito modular y microservicios
Hasta aquí hablamos de cómo se organiza el código. Ahora, de cómo se despliega. Es la decisión más cara de este capítulo.
Monolito
Un monolito es un solo programa que se despliega entero. Kallpa lo es: un proceso de Node.js con la API, los archivos de la página y el acceso a los datos. Que sea uno solo no dice nada de la calidad de su código; dice cómo se ejecuta. Sus ventajas son reales:
- Una sola base de código. Se busca con
grep, se refactoriza con el editor, y una prueba cubre el camino entero. - Llamadas locales. Llamar a una función no falla por la red y tarda nanosegundos o microsegundos.
- Transacciones simples. Guardar la reserva y actualizar otra tabla en una sola transacción es trivial si todo está en la misma base de datos.
- Un solo despliegue. Una sola cosa que construir, publicar y vigilar.
Fowler y Lewis agregan algo que se suele olvidar: un monolito también escala a lo ancho, “running many instances behind a load-balancer”. Lo que no puede es escalar solo una parte. Sus costos, según el mismo artículo, son que los ciclos de cambio están atados (cambiar algo pequeño obliga a publicar todo) y que con los años cuesta mantener una buena estructura de módulos.
Microservicios
Fowler y Lewis no dan una definición formal, sino una lista de características comunes. Las nueve secciones de su artículo son:
- Componentes como servicios, que se despliegan de forma independiente.
- Organizados por capacidades del negocio, no por capas técnicas.
- Productos, no proyectos: el equipo mantiene lo que construye.
- Endpoints inteligentes y canales simples (smart endpoints and dumb pipes).
- Gobierno descentralizado: cada equipo elige sus herramientas.
- Datos descentralizados: cada servicio tiene los suyos.
- Automatización de la infraestructura.
- Diseño para las fallas.
- Diseño evolutivo.
Lo central es esto: servicios que se despliegan por separado, cada uno con sus datos, comunicándose por la red. Lo que se gana: despliegues independientes, escalar solo una parte, fronteras que el lenguaje no deja cruzar y aislamiento de algunas fallas. Lo que se paga es lo que el monolito regalaba:
| Con un monolito | Con microservicios |
|---|---|
| Una llamada a función siempre llega | Una llamada puede fallar, tardar o llegar dos veces |
| Una transacción abarca todo | Sin transacción común: hay que aceptar que la consistencia sea eventual y compensar errores |
| Un log, un proceso | Trazar una petición por varios servicios (tracing) |
| Una prueba de punta a punta | Levantar varios servicios o simular los contratos |
| Una versión | Varias versiones conviviendo: cada API tiene que ser compatible hacia atrás |
| Un despliegue | Un pipeline por servicio, y alguien que opere todo eso |
Consistencia eventual quiere decir que, después de una actualización, no todos ven el dato nuevo enseguida, pero terminan viéndolo si no hay más cambios. Fowler y Lewis son directos sobre el motivo: las transacciones distribuidas son difíciles de implementar, así que las arquitecturas de microservicios prefieren coordinar sin transacciones y reconocer que la consistencia puede ser solo eventual.
Veamos lo que eso significa con Kallpa partida en tres servicios: canchas, reservas y pagos. Hoy, reservar una hora de fulbito hace esto en un solo proceso, sin red, como en la parte de arriba de la figura:
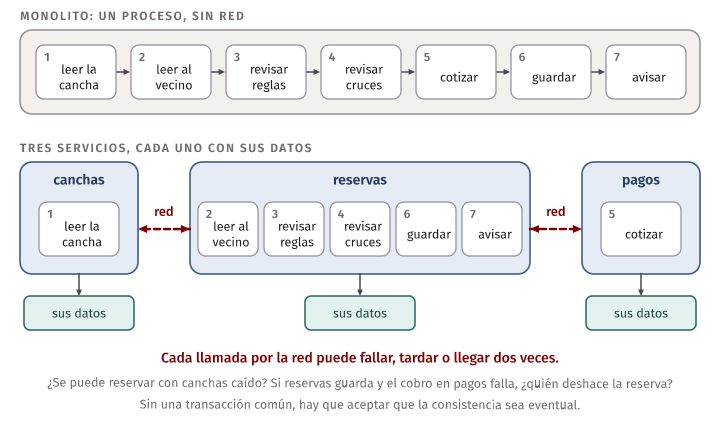
Con tres servicios, leer la cancha y cotizar son llamadas por la red. ¿Qué pasa si el servicio de canchas está caído? ¿Se puede reservar sin saber el deporte? Si reservas guarda y el cobro en pagos falla, ¿quién deshace la reserva, y qué ve el vecino mientras tanto? Son preguntas que hoy no existen. Y Kallpa recibe unas decenas de reservas al día.
Monolito modular
Entre los dos hay una opción que no suele aparecer en las discusiones: un monolito modular, que se despliega como un solo programa, pero con módulos de fronteras claras que se hacen cumplir. Cada módulo expone una interfaz, esconde sus tablas y los demás no entran por la puerta de atrás. Tiene las transacciones y el despliegue único del monolito, y buena parte de la claridad de las fronteras de los microservicios. Si algún día hace falta separar un módulo, la frontera ya está dibujada.
No es gratis: ninguna red impide cruzar la frontera, así que la disciplina tiene que venir de una herramienta. La regla de ESLint de la sección de capas es exactamente este mecanismo, a escala pequeña.
En la industria. Dos casos muy citados, ambos contados por los equipos que los vivieron, así que son experiencia y no comparación controlada. Shopify (Deconstructing the Monolith, 2019) describe una base de código en Ruby on Rails con más de mil desarrolladores y más de una década, y explica que eligieron un monolito modular: un solo código, con fronteras definidas y respetadas entre componentes. Segment (Goodbye Microservices, 2018) cuenta que juntó más de 140 servicios en uno solo porque el costo de operarlos crecía con cada destino nuevo, y lista lo que perdió, como el aislamiento de fallas: un error en un destino puede tumbar el servicio para todos. Ninguno de los dos dice que los microservicios estén mal. Dicen qué pasó con su equipo y su problema.
La ley de Conway
Fowler y Lewis citan a Melvin Conway (1968):
Any organization that designs a system (defined broadly) will produce a design whose structure is a copy of the organization’s communication structure.
En español: la estructura de un sistema tiende a copiar la estructura de comunicación de la organización que lo construye. Si la empresa tiene un equipo de interfaz, uno de lógica y uno de base de datos, un cambio pequeño se vuelve un proyecto entre tres equipos, y la lógica termina donde cada equipo tiene acceso. Es una observación sobre cómo se comportan las organizaciones, no una ley física; pero se ve con frecuencia, y tiene dos consecuencias prácticas:
- Los microservicios se organizan alrededor de capacidades del negocio porque buscan que cada servicio coincida con un equipo que puede decidir solo. El artículo habla de equipos de hasta una docena de personas por servicio, y menciona como extremo pequeño a seis personas con seis servicios.
- Por lo tanto, un equipo de cinco personas con un cliente no tiene la organización que justifica diez servicios. Las cinco personas hablan entre ellas todos los días. Separar el sistema con una red no refleja ninguna frontera de comunicación: la inventa.
Monolith first
Fowler observó en 2015 un patrón en las historias que escuchaba:
Almost all the successful microservice stories have started with a monolith that got too big and was broken up. Almost all the cases where I’ve heard of a system that was built as a microservice system from scratch, it has ended up in serious trouble.
Da dos razones. La primera es que al empezar no se sabe si el producto le servirá a alguien, y hay que moverse rápido (el costo de los microservicios frena). La segunda es técnica: los microservicios solo funcionan con fronteras buenas y estables, y aun los arquitectos con experiencia se equivocan al trazarlas al inicio. Mover una responsabilidad entre servicios es mucho más difícil que moverla entre módulos.
Vale la pena leer también sus reservas. Fowler aclara que son anécdotas y no un estudio, que sus colegas no están de acuerdo por unanimidad, que incluso enlaza a un artículo con la posición contraria y que “cualquier consejo sobre estos temas debe verse como tentativo”. Advierte también que no cualquier monolito se puede partir: la mayoría acumula demasiadas dependencias entre módulos. Por eso monolith first no es excusa para escribir un monolito desordenado. Y Fowler y Lewis, ya en 2014, cerraban su artículo con la misma prudencia: dijeron que todavía no había pasado tiempo suficiente para un juicio completo, porque las consecuencias de una decisión de arquitectura a veces se ven solo años después.
Error común. Elegir microservicios “porque escalan” sin un requisito de escala. Kallpa recibe unas decenas de reservas al día; su problema de escala no es el tráfico. La documentación de SQLite dice que un sitio con menos de 100 mil visitas al día debería funcionar bien, y aclara que es un estimado conservador, no un límite. Y al revés: “es un monolito” no es excusa para que todo dependa de todo. Lo contrario de un microservicio no es un desorden.
Cómo elegir
Para decidir, sirven más estas preguntas que el nombre del estilo:
| Pregunta | Empuja hacia monolito | Empuja hacia separar |
|---|---|---|
| ¿Cuántas personas? ¿Pueden hablar todos los días? | Un equipo | Varios equipos que se estorban |
| ¿Conocemos las fronteras del dominio? | No todavía | Sí, y son estables |
| ¿Alguna parte necesita escalar mucho más que el resto? | No | Sí, con números |
| ¿Hay quien opere varios servicios? | No | Sí, con pipelines y monitoreo listos |
| ¿Hay partes que deben publicarse a ritmos muy distintos? | No | Sí |
Para los proyectos de este curso, con un equipo, un cliente y un semestre, la respuesta casi siempre será un monolito con buenos módulos. Lo importante en P2 no es elegir eso, sino poder explicar por qué.
Con IA. Un agente que agrega una funcionalidad elige el camino más corto, que a menudo cruza capas. El archivo
cruce-de-capas.diffes un cambio escrito para esta clase, como los que suele proponer un agente: para listar las reservas de una cancha, agrega la conexión a las dependencias de los handlers y crea unBookingRepositorydentro del handler. Funciona, y las revisiones habituales no tienen nada que decir:$ make cruce ... ℹ tests 40 ℹ suites 6 ℹ pass 40 ℹ fail 0 ... cd build/cruce && eslint -c capas-eslint.js . ; echo "eslint terminó con código $?" /work/code/week-07/build/cruce/src/http/handlers.ts 19:1 error '../store/booking-repository.ts' import is restricted from being used by a pattern no-restricted-imports ✖ 1 problem (1 error, 0 warnings) eslint terminó con código 1El
make checkde Kallpa pasa. Solo la regla de capas lo detecta, aunque nadie lea esa línea en la revisión. Dos cosas ayudan juntas: la arquitectura escrita (ADRs, un diagrama, el README) le da al agente el contexto para no cruzar, y la regla automática detecta el cruce cuando igual ocurre. Y como vimos arriba, la regla tiene huecos: en este mismo cambio,handlers.tstambién empezó a importarnode:sqlitey eso no se reporta. Por eso la revisión humana sigue haciendo falta.
Atributos de calidad
Qué son
Los atributos de calidad son los requisitos no funcionales de la semana 3, vistos desde la arquitectura. Describen qué tan bien hace el sistema lo que hace:
| Atributo | Pregunta | En Kallpa |
|---|---|---|
| Disponibilidad | ¿Cuánto tiempo responde? | ¿Se puede reservar si el servidor se cae? |
| Rendimiento | ¿Cuánto tarda, cuánto aguanta? | ¿Qué pasa el lunes a las 8:00? |
| Seguridad | ¿Quién puede hacer qué? | Hoy, cualquiera puede reservar a nombre de otro |
| Mantenibilidad | ¿Cuánto cuesta cambiarlo? | Agregar un deporte, cambiar una tarifa |
| Facilidad de prueba | ¿Cuánto cuesta comprobarlo? | Las reglas se prueban sin base de datos |
| Facilidad de despliegue | ¿Cuánto cuesta publicarlo? | Un proceso, un archivo |
| Costo | ¿Cuánto cuesta operarlo? | Lo paga un complejo comunal |
La norma ISO/IEC 25010 los clasifica en un modelo con características y subcaracterísticas, y sirve como lista para no olvidarse de ninguno. Pero una lista no decide nada. Lo que importa en la práctica es que cada atributo que le interesa al cliente se pueda medir.
Escenarios: estímulo, entorno, respuesta y medida
“Kallpa debe ser rápida” no se puede verificar. ¿Rápida para quién, cuándo y comparada con qué? La forma estándar de precisarlo, popularizada por Bass, Clements y Kazman en Software Architecture in Practice, es el escenario de calidad. La versión que usamos en este curso tiene cuatro partes:
- Estímulo: qué pasa.
- Entorno: en qué condiciones.
- Respuesta: qué hace el sistema.
- Medida: con qué número se comprueba.
(El libro agrega dos más, la fuente del estímulo y la parte del sistema afectada. Si hacen falta, se agregan.)
| Parte | “Kallpa debe ser rápida”, reescrito |
|---|---|
| Estímulo | 20 vecinos reservan a la vez |
| Entorno | Operación normal, lunes a las 8:00 |
| Respuesta | Cada uno recibe confirmación o que la hora está ocupada |
| Medida | El 99 % responde en menos de 500 ms, y ninguna cancha queda reservada dos veces |
Otros ejemplos, de mal a bien:
| Vago | Medible |
|---|---|
| “Siempre disponible” | Con el proceso del servidor caído, el servicio vuelve en menos de 1 minuto, y en un mes no está disponible más de 43 minutos en total (99.9 %) |
| “Seguro” | Un vecino que manipula la petición no puede cancelar la reserva de otro: la API responde 403 en el 100 % de los casos |
| “Fácil de mantener” | Agregar un deporte nuevo con su tarifa toca a lo sumo 2 archivos y se publica en menos de un día |
| “Fácil de desplegar” | Una persona nueva levanta el sistema siguiendo el README en menos de 15 minutos |
Fíjense en que la disponibilidad se debe negociar con el cliente. Un complejo que abre de 7:00 a 22:00 quizá no necesite 99.9 % a toda hora, y cada nueve adicional cuesta más. El número sale de lo que le duele al cliente, no de lo que suena bien.
Unas palabras sobre las medidas, porque es fácil engañarse:
- Un percentil dice qué porcentaje de los casos queda por debajo de un valor. Que el p99 sea 500 ms quiere decir que el 99 % tarda eso o menos. Se usa en vez del promedio porque un promedio bueno puede esconder a muchos usuarios mal atendidos.
- Hacen falta suficientes muestras. Con 20 peticiones, el p99 es
simplemente la más lenta (una prueba de
medir.test.tslo comprueba). Por eso medimos con 100 rondas de 20. - Importa dónde y cómo se mide. Un número de una laptop vale para comparar alternativas en esa laptop, no para prometer lo que pasará en producción.
Medir un escenario de verdad
medir-escenario.ts levanta Kallpa de
verdad y manda rondas de 20 reservas simultáneas, cada ronda por una hora
distinta. Probemos el escenario de arriba, con una instancia y con dos:
$ make medir
Una instancia:
  100 rondas, 2000 peticiones: 100×200  1900×409
  latencia: p50 3.7 ms, p99 7.5 ms, máximo 11.1 ms
  horas reservadas dos veces: 0
  rondas sin ninguna reserva: 0
  reservas guardadas sin responder 200: 0
  rondas en que una instancia solo respondió 500: 0
Dos instancias, sobre la Kallpa publicada:
  100 rondas, 2000 peticiones: 100×200  893×409  1007×500
  latencia: p50 2.4 ms, p99 7.3 ms, máximo 11.2 ms
  horas reservadas dos veces: 0
  rondas sin ninguna reserva: 0
  reservas guardadas sin responder 200: 0
  rondas en que una instancia solo respondió 500: 99
Lean bien la segunda parte. Con dos instancias, el escenario se cumple al pie de la letra: el p99 es de 7.3 ms, muy por debajo de los 500 ms, y ninguna cancha quedó reservada dos veces. Y sin embargo, la mitad de las peticiones terminó en un error 500. De hecho, por eso la latencia es menor: fallar es rápido.
Esta es una lección sobre escenarios. Nuestra medida estaba incompleta: decía cuánto tarda una respuesta, pero no qué respuesta. Un escenario mejor agrega lo que acabamos de aprender:
Con 20 vecinos reservando a la vez el lunes a las 8:00, en operación normal, el 99 % de las reservas responde en menos de 500 ms, ninguna responde 5xx y ninguna cancha queda reservada dos veces.
Idea clave. Un escenario de calidad se escribe para poder fallar. Si la medida permite que el sistema “pase” cuando el usuario sale perdiendo, la medida está mal. Medir suele enseñar cuál debió ser la medida.
Los atributos compiten
Casi siempre, mejorar un atributo empeora otro:
| Se mejora | Se empeora | En Kallpa |
|---|---|---|
| Disponibilidad con dos instancias | Consistencia, simplicidad, costo | Hay que coordinar los datos y poner algo delante que reparta las peticiones |
| Seguridad con autenticación | Facilidad de uso | Un vecino ya no reserva en dos clics; hay que recuperar contraseñas |
| Rendimiento con cache | Consistencia | La página puede mostrar libre una hora ya tomada |
| Facilidad de prueba con puertos | Simplicidad | Una interfaz más que leer por cada cosa externa |
Una decisión de arquitectura es elegir qué atributo gana, para este cliente, y dejar escrito qué se pierde. No hay una arquitectura mejor en general; hay una mejor para un conjunto de prioridades. Por eso sin saber qué le importa al cliente (semana 3) no se puede decidir nada aquí.
El caso: dos instancias sobre un mismo archivo
La administración del complejo pide correr dos copias del servidor sobre el mismo archivo, para que una caída no deje a los vecinos sin reservar. Es el caso que resuelven en el laboratorio. Aquí se estudia lo que pasa técnicamente. La decisión será de ustedes.
Lo que dice el código
Este es el corazón de createBooking en src/http/handlers.ts, con los
números de línea reales:
 79    const request = parseBookingRequest(await readJson(req));
 81    const court = deps.service.findCourt(request.courtId);
 92    const sameDay = deps.service.bookingsForCourt(court.id, request.date).filter(...);
 93    if (sameDay.some((b) => overlaps(...))) { throw new HttpError(409, 'SLOT_TAKEN', ...); }
104    const id = deps.service.saveBooking({ ... });
114    const booking = toBookingJson(deps.service.findBooking(id)!);
El invariante “una cancha no tiene dos reservas confirmadas que se crucen” (semana 4) se cumple con dos pasos separados: en la línea 92 se revisa, y en la 104 se guarda. Este patrón se llama revisar y después actuar (check-then-act). Si otro puede actuar entre los dos pasos, lo que se revisó ya no es cierto cuando se actúa. A ese tipo de error, en el que el resultado depende del orden en que se intercalan las operaciones, se le llama condición de carrera (race condition).
Por qué en un solo proceso no pasa
Node.js ejecuta el JavaScript de un proceso en un solo hilo. Una función corre
hasta el siguiente await sin que nadie la interrumpa. En createBooking, el
único await es el de la línea 79, leer el cuerpo de la petición. De la línea
81 a la respuesta todo es síncrono, porque DatabaseSync lo es. Así que entre
revisar y guardar no puede correr ninguna otra petición. Lo comprueba una
prueba de un-proceso.test.ts: con 20
reservas simultáneas por la misma hora hay exactamente un 200 y diecinueve
409.
Es una propiedad valiosa, pero nadie la decidió ni la escribió: es un efecto
de cómo está hecho el código. Y es frágil. El archivo
await-intermedio.diff agrega una
sola espera asíncrona entre revisar y guardar, como la que aparecería al
consultar a un servicio externo:
await new Promise((resolve) => setTimeout(resolve, 10));La segunda prueba de un-proceso.test.ts aplica ese cambio y repite el
experimento, en un solo proceso:
assert.equal(confirmed, 20);
assert.deepEqual(statuses, Array<number>(20).fill(200));
Las 20 peticiones revisan, todas ven la hora libre, todas esperan y todas guardan. Veinte reservas confirmadas para la misma hora de la misma cancha, y las 40 pruebas de Kallpa no se enteran, porque ninguna manda peticiones simultáneas.
Error común. Creer que “Node.js tiene un solo hilo” elimina las condiciones de carrera. Elimina las que ocurrirían dentro de un tramo síncrono. Cada
awaites un punto donde otras peticiones pueden correr. Y con dos procesos no hay un solo hilo que valga.
Con dos procesos: el entrelazado
Con dos instancias, cada una tiene su propio hilo y su propia conexión al archivo. Nada impide este orden, donde el tiempo avanza hacia abajo:
| Instancia A | Instancia B | En la base de datos |
|---|---|---|
| Revisa: las 9:00 están libres | Sin reservas | |
| Revisa: las 9:00 están libres | Sin reservas | |
| Guarda “Equipo A” | 1 reserva | |
| Guarda “Equipo B” | 2 reservas a la misma hora |
No hace falta creer el dibujo ni esperar a tener suerte.
doble-reserva.test.ts abre dos
conexiones a un mismo archivo, con el BookingService real de Kallpa, y
ejecuta exactamente ese orden:
// Los dos revisan antes de que cualquiera guarde: los dos ven la hora libre.
assert.equal(isFree(instanceA), true);
assert.equal(isFree(instanceB), true);
instanceA.saveBooking({ ...row, team_name: 'Equipo A' });
instanceB.saveBooking({ ...row, team_name: 'Equipo B' });

assert.equal(confirmedCount(a), 2);
Pasa: quedan dos reservas. Esta forma de probar una condición de carrera, forzando el orden en vez de lanzar muchas peticiones y esperar, da el mismo resultado siempre.
Lo que pasa cuando se corre de verdad
El script del laboratorio,
dos-instancias.sh, levanta dos
servidores y manda 20 reservas repartidas entre los dos:
$ make dos-instancias
cd build/kallpa && bash ../../dos-instancias.sh
Respuestas (cantidad y código HTTP):
      1 200
     13 409
      6 500
Reservas confirmadas de la cancha 3 el 2026-11-05 a las 9:00:
16|Prueba 2
Logs de los servidores: /tmp/a.log y /tmp/b.log
No hubo doble reserva en esta corrida, sino seis errores 500. En seis corridas seguidas obtuvimos 3, 8, 2, 6, 10 y 3 errores: el número cambia cada vez. El log de uno de los servidores dice por qué:
Error: database is locked
    at CourtRepository.findById (file:///work/code/week-07/build/kallpa/src/store/court-repository.ts:16:80)
    at BookingService.findCourt (file:///work/code/week-07/build/kallpa/src/services/booking-service.ts:25:25)
    at Object.handler (file:///work/code/week-07/build/kallpa/src/http/handlers.ts:81:32)
    at process.processTicksAndRejections (node:internal/process/task_queues:104:5)
    at async Server.<anonymous> (file:///work/code/week-07/build/kallpa/src/http/server.ts:59:7) {
  code: 'ERR_SQLITE_ERROR',
  errcode: 5,
  errstr: 'database is locked'
}
POST /api/bookings 500
Falló un SELECT, la lectura de la cancha, ni siquiera una escritura. Para
entenderlo hace falta saber cómo se coordina SQLite entre procesos.
Los locks de SQLite
SQLite no tiene un servidor que ordene las peticiones. Los procesos se
coordinan con locks sobre el archivo. En el modo por omisión, que es el de
Kallpa (el journal delete), hay varios
niveles, de menor a mayor:
| Lock | Quién lo tiene | Qué permite a los demás |
|---|---|---|
| SHARED | Cualquiera que esté leyendo; pueden ser muchos | Leer |
| RESERVED | Uno solo, que se prepara para escribir | Leer, pero no escribir |
| PENDING y EXCLUSIVE | Uno solo, mientras escribe en el archivo | Nada nuevo: quienes ya leían terminan y nadie más entra |
Por eso una lectura puede fallar: mientras otro proceso confirma su escritura,
tiene el lock exclusivo y nadie puede ni leer. Además, si busy_timeout es
0, como en Kallpa, SQLite no espera: responde database is locked de
inmediato. doble-reserva.test.ts comprueba cada una de estas afirmaciones
con dos conexiones.
Esto también explica un número impactante que vimos antes, los 1007 errores
500. En cada ronda, las 20 peticiones llegan a la vez, y cada proceso atiende
sus 10 una tras otra. Mientras un proceso confirma su INSERT, lo que incluye
esperar al disco, el otro ya atendió todas las suyas y cada una se encontró el
archivo bloqueado en su primera consulta. La última línea de la medición lo
confirma: en 99 de 100 rondas, una de las instancias respondió 500 a todo lo
que recibió. Con el script de curl salen menos errores: cada curl es un
proceso que arranca por su cuenta, y las peticiones llegan más repartidas. El
número depende de cómo llegan las peticiones, y por eso un escenario tiene que
decir cómo se mide.
La casi doble reserva
Si la Kallpa publicada puede reservar dos veces, ¿por qué no lo vimos? En más
de 40 corridas de medir-escenario.ts, más de 4000 rondas, no apareció
ninguna. Pero miren esta otra traza, de otra corrida del mismo script:
Error: database is locked
    at BookingRepository.insert (file:///work/code/week-07/build/kallpa/src/store/booking-repository.ts:54:8)
    at BookingService.saveBooking (file:///work/code/week-07/build/kallpa/src/services/booking-service.ts:53:27)
    at Object.handler (file:///work/code/week-07/build/kallpa/src/http/handlers.ts:104:29)
Línea 104: esta petición ya pasó la revisión de la línea 92, y falló al guardar. Vio la hora libre, y lo único que le impidió guardar una segunda reserva fue el lock. Lo que nos está protegiendo es un error que nadie pidió, no una decisión de diseño.
Ahora viene la parte importante. Al ver database is locked, el arreglo obvio
es que SQLite espere en vez de fallar. node:sqlite lo permite con una línea,
que es todo lo que hace
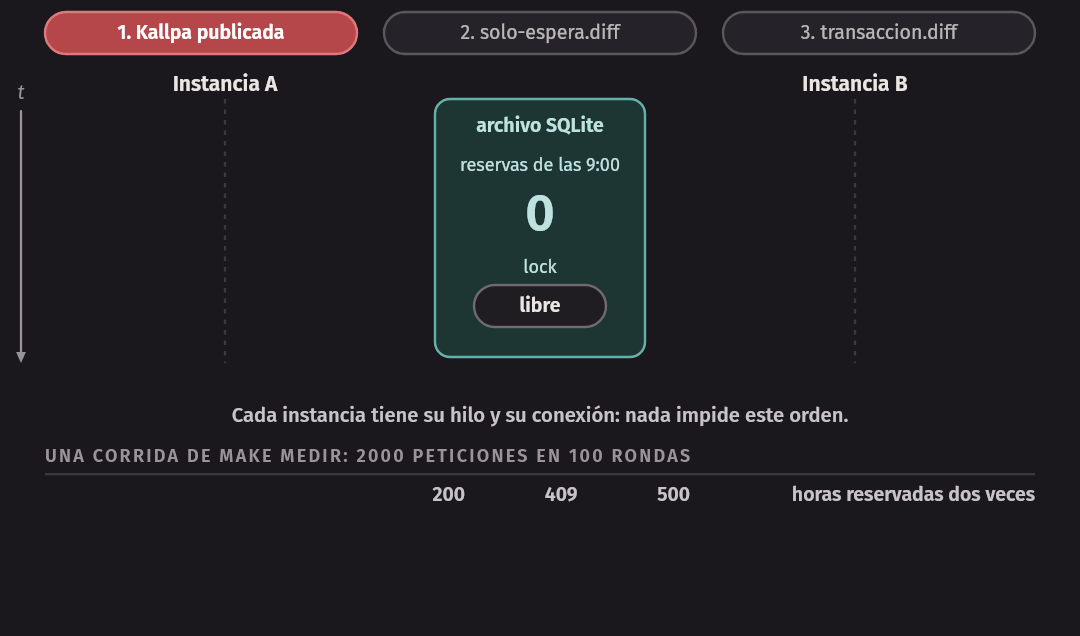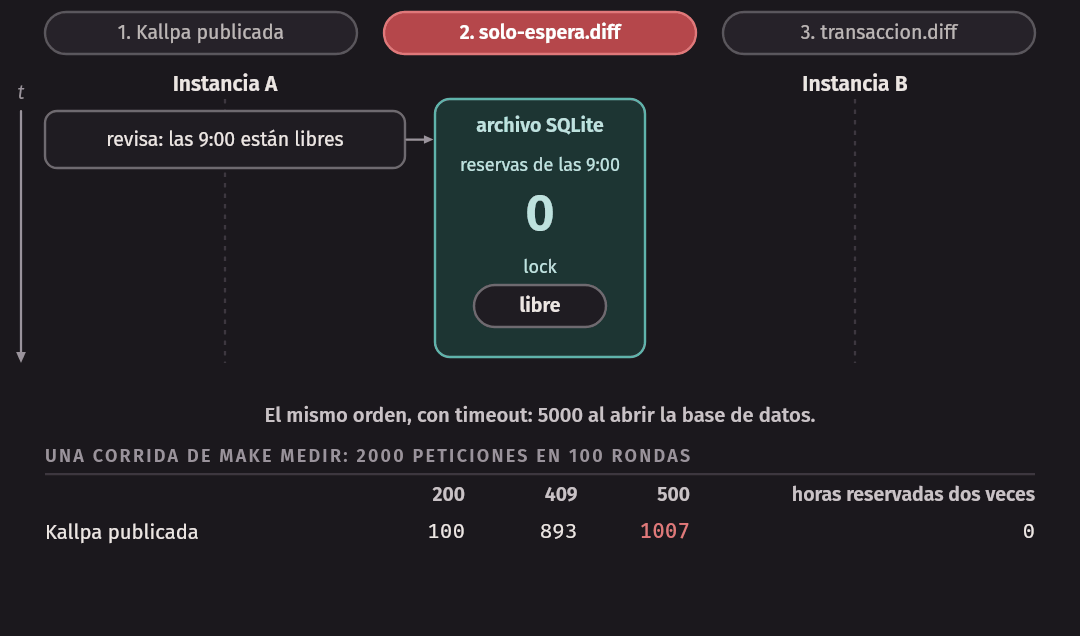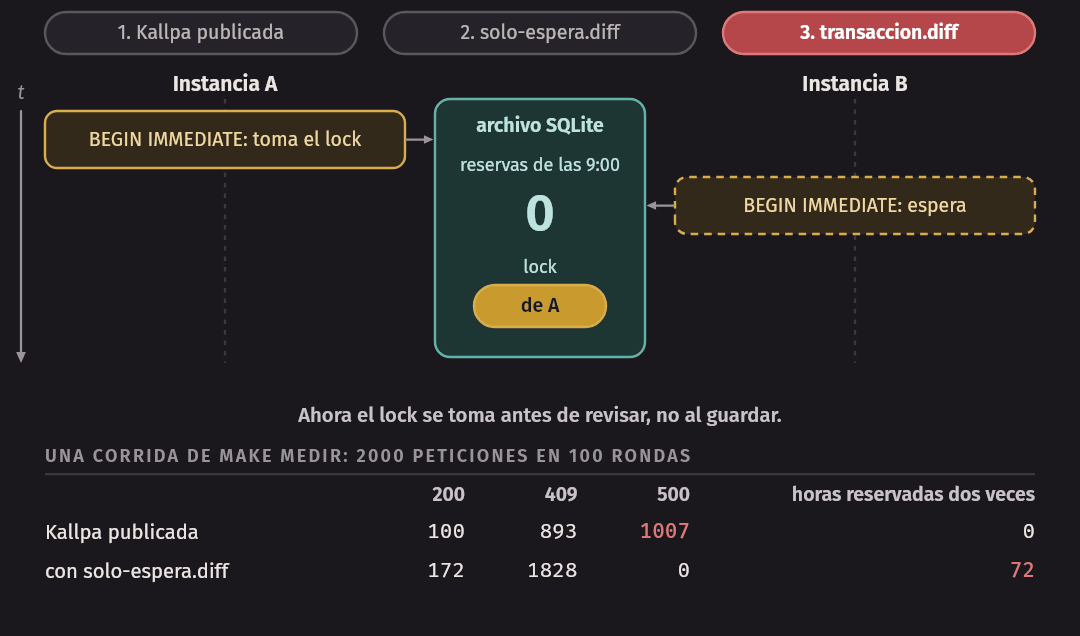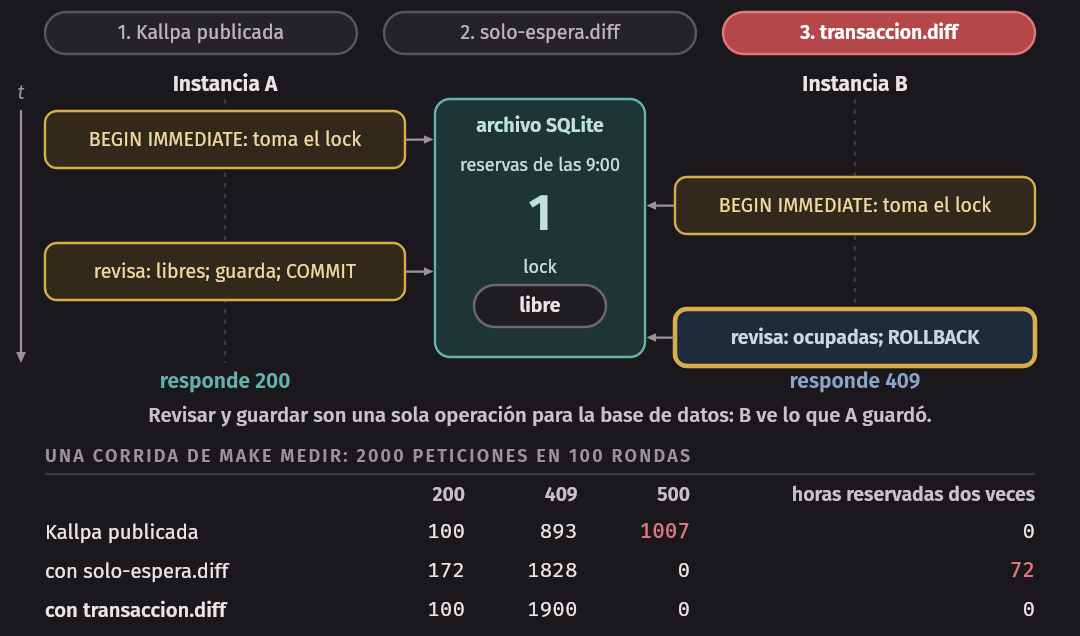
solo-espera.diff:
const db = new DatabaseSync(path, { timeout: 5000 });Midamos:
Dos instancias, con solo-espera.diff:
  100 rondas, 2000 peticiones: 172×200  1828×409
  latencia: p50 5.6 ms, p99 15.1 ms, máximo 17.4 ms
  horas reservadas dos veces: 72
  rondas sin ninguna reserva: 0
  reservas guardadas sin responder 200: 0
  rondas en que una instancia solo respondió 500: 0
Los errores 500 desaparecieron y las pruebas pasan. Quien mire solo los logs dirá que se arregló. Y 72 de las 100 horas quedaron reservadas dos veces, con 172 peticiones que recibieron un 200 y su aviso por WhatsApp. El número varía mucho de una corrida a otra: en veinte corridas salió desde 1 hasta 79. Nunca salió 0.
Este es el centro del capítulo. El error 500 molesta y se ve. La doble reserva es silenciosa y la descubre un equipo que llega a la cancha y la encuentra ocupada. El cambio reemplazó un error visible por uno invisible, y el escenario de calidad, si no hubiera medido las dobles reservas, habría dado por bueno el cambio.
Idea clave. Para que un invariante valga entre procesos, revisar y guardar tienen que ser una sola operación indivisible para la base de datos. Esperar el lock no une los dos pasos: solo hace que el segundo paso espere y después se ejecute igual, con una revisión que ya venció.
Qué alternativas hay
Sin decidir por ustedes, estos son los hechos sobre cada alternativa, con lo que se midió o comprobó.
Una sola instancia, y aceptar el riesgo. Es lo de hoy: sin errores 500,
sin dobles reservas (salvo que alguien agregue un await). Lo que se pierde
es que, mientras el proceso esté caído, nadie reserva. ¿Cuánto es eso? Lo
podemos medir:
$ make reinicio
10 reinicios: mínimo 95 ms, mediana 101 ms, máximo 103 ms
Eso es lo que tarda en volver a responder después de matar el proceso, si algo
lo vuelve a levantar en el acto. No incluye lo que tarde en darse cuenta
quien lo vigila, ni sirve si se cae la máquina o el disco, y es de una laptop
con un archivo pequeño. Aun así, da una referencia para discutir: el problema
que dos instancias resolverían dura muy poco si hay un supervisor. La deuda de
esta alternativa es que el invariante sigue dependiendo de que ningún cambio
agregue un await en ese tramo.
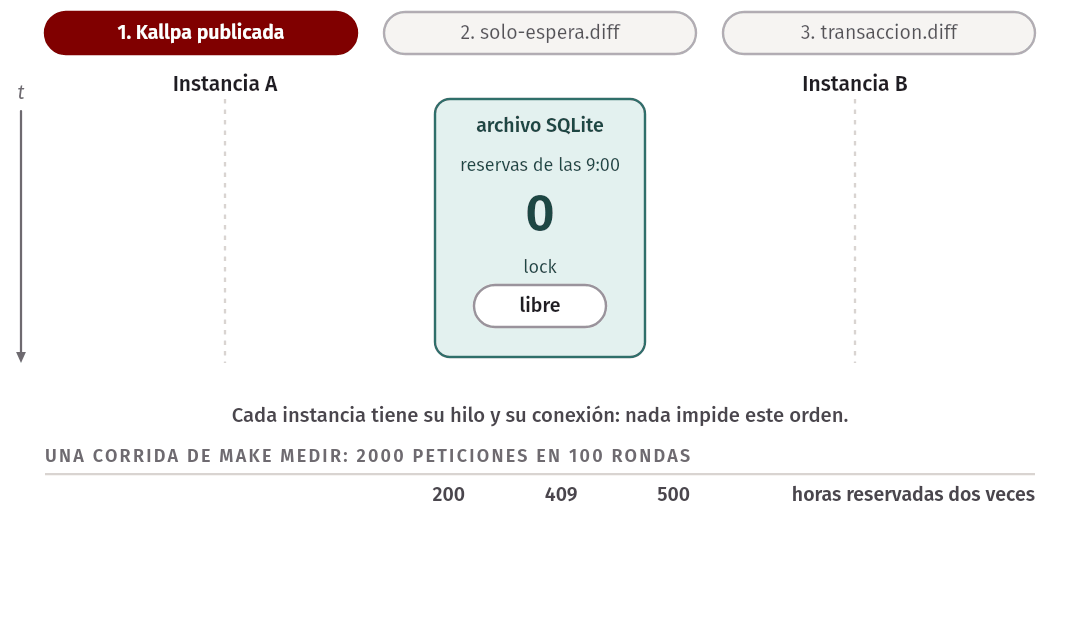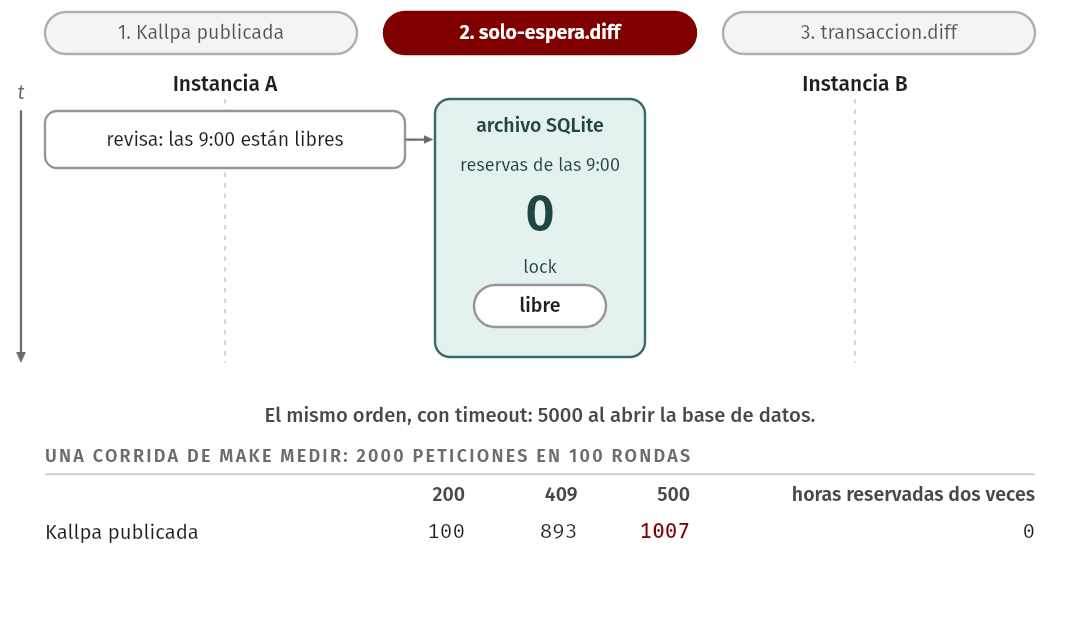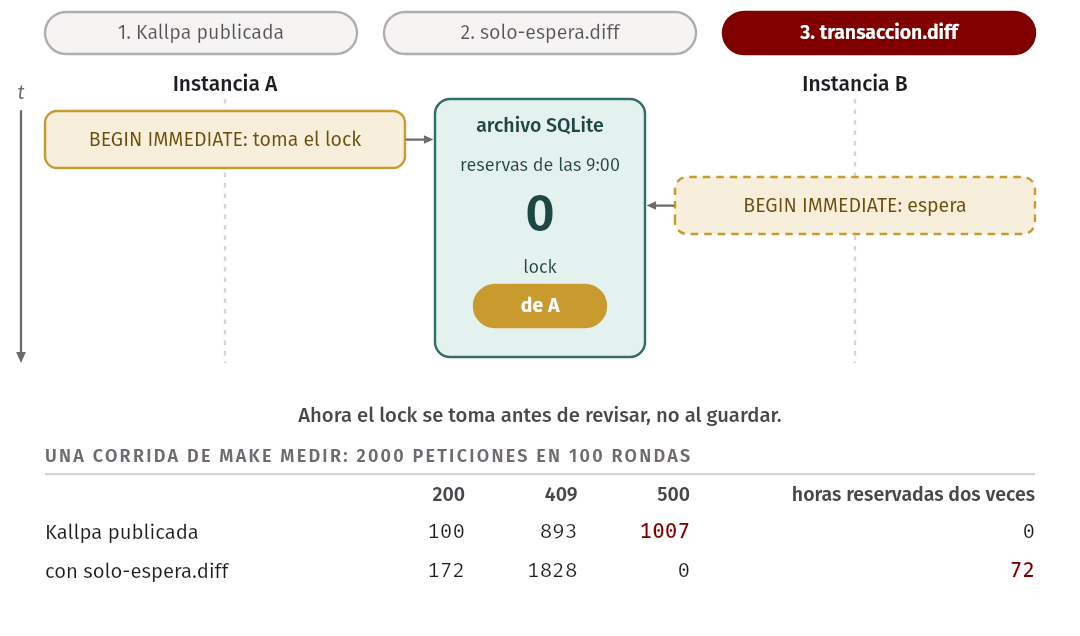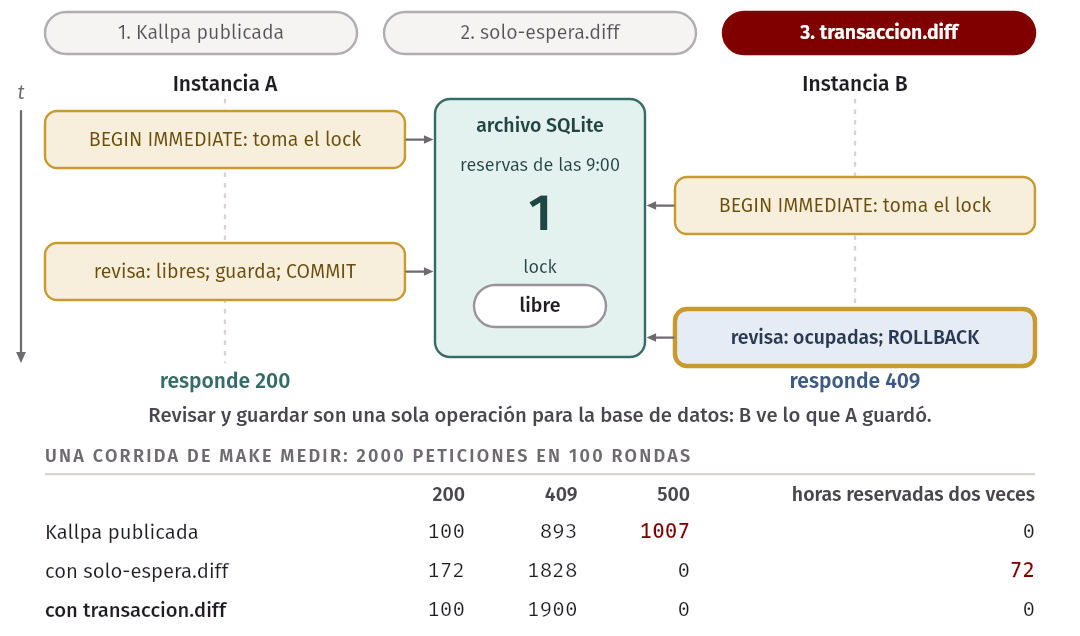
Una transacción que empieza con BEGIN IMMEDIATE. Toma el lock de
escritura antes de revisar, de modo que mientras una instancia revisa y
guarda, la otra no puede ni empezar.
transaccion.diff lo hace en Kallpa,
junto con la espera:
atomically<T>(work: () => T): T {
  this.#db.exec('BEGIN IMMEDIATE');
  try {
    const result = work();
    this.#db.exec('COMMIT');
    return result;
  } catch (error) {
    this.#db.exec('ROLLBACK');
    throw error;
  }
}
Dos instancias, con transaccion.diff:
100 rondas, 2000 peticiones: 100×200 1900×409
latencia: p50 4.8 ms, p99 12.4 ms, máximo 13.9 ms
horas reservadas dos veces: 0
rondas sin ninguna reserva: 0
reservas guardadas sin responder 200: 0
rondas en que una instancia solo respondió 500: 0Exactamente un 200 por ronda, en todas las corridas que hicimos. Las 40
pruebas de Kallpa siguen pasando. Hay tres detalles que se suelen pasar por
alto. Tiene que ser IMMEDIATE: con un BEGIN a secas el lock se toma
recién al escribir, y el segundo en escribir falla con database is locked
(hay una prueba de eso). Mientras SQLite espera, Node está bloqueado,
porque DatabaseSync es síncrono: el proceso no atiende a nadie más durante
esa espera. Y el diff pone la transacción en el handler a través de
atomically, para que el cambio se lea en pocas líneas, lo cual es
discutible: según lo que vieron en la semana 5, el lugar natural es un módulo
profundo con una operación como book.
Una restricción en la base de datos. Aquí hay una trampa. La idea natural es un índice único parcial:
CREATE UNIQUE INDEX one_booking_per_start ON bookings (court_id, date, start_hour)
  WHERE status = 'confirmed';
Detiene dos reservas que empiezan a la misma hora, pero no un cruce. Una
reserva de 9:00 a 11:00 y otra de 10:00 a 11:00 tienen distinta start_hour,
y el índice las deja pasar. Dos pruebas de doble-reserva.test.ts muestran
las dos cosas. Para que una restricción exprese la regla completa, cada hora
ocupada tiene que ser una fila, por ejemplo una tabla booking_hours con
clave primaria (court_id, date, hour). Eso exige una migración, y hay que
mantener esas filas al cancelar. A cambio, la regla la hace cumplir la base de
datos para todo el que escriba, incluso quien entre por otro camino.
Cambiar a una base de datos con servidor, como PostgreSQL. Ordena las
peticiones, admite varias máquinas y además tiene exclusion constraints,
restricciones pensadas para intervalos que se cruzan. Es también la
alternativa que más cuesta: un servidor más que instalar, respaldar, pagar y
vigilar; y como su cliente es asíncrono, todas las capas cambian y aparecen
los await de los que venimos hablando, así que también necesita
transacciones bien puestas.
Modo WAL (PRAGMA journal_mode = WAL). Es una mejora, no una solución:
los lectores ya no se bloquean durante una escritura, pero sigue habiendo un
solo escritor. No une la revisión con el guardado. La prueba correspondiente
lo muestra.
Y dos preguntas que se deben hacer sobre el pedido mismo, sea cual sea la alternativa:
- ¿De qué caída protege? Dos procesos en la misma máquina protegen de que se caiga un proceso, no de que se caiga la máquina o el disco, y en esos casos el archivo también se pierde o queda inaccesible. Con dos máquinas haría falta compartir el archivo por la red, y la documentación de SQLite lo desaconseja: la lógica de locks tiene errores en muchos sistemas de archivos de red, y recomienda evitar SQLite cuando la misma base de datos se accede directamente y a la vez desde muchas computadoras.
- ¿Quién reparte a los vecinos? La página apunta a una sola dirección. Para repartir entre dos instancias hace falta un load balancer, que es una pieza más que puede caerse. El script del laboratorio esquiva este tema mandando a cada puerto a mano.
La documentación de SQLite también dice que solo permite un escritor a la vez, que los escritores hacen cola y que para muchas situaciones eso no es problema. Para unas decenas de reservas al día, no lo es.
En la industria. Los equipos resuelven el check-then-act en la base de datos, no en la aplicación: con una restricción, una transacción con el nivel de aislamiento adecuado o un lock. La regla práctica es que un invariante que cruza varias filas tiene que tener un guardián que vea todas las peticiones, y la base de datos es el único lugar por donde pasan todas. Lo que cambia entre equipos es cuánto de la regla se puede expresar como restricción.
Decisiones de arquitectura: los ADR
El problema que resuelven
Imaginen que en un año entra una persona nueva a Kallpa y ve que solo corre una instancia. Nygard describe sus dos opciones cuando no sabe por qué se decidió así:
- Aceptar a ciegas. Quizá la razón ya no vale, y el equipo le termina teniendo miedo a cambiar cualquier cosa.
- Cambiar a ciegas. Quizá esa decisión sostenía algo que nadie está probando, como la regla de los cruces.
Los documentos largos no resuelven esto, porque nadie los lee ni los mantiene al día. La propuesta de Nygard, de 2011, es un documento corto para cada decisión importante: un ADR (architecture decision record).
El formato
Un ADR, según Nygard:
- Título: una frase corta. ADR 9: LDAP para multi-tenant.
- Estado: propuesto, aceptado, o deprecado o reemplazado, con referencia al que lo reemplaza.
- Contexto: las fuerzas en juego (técnicas, políticas, sociales, del proyecto), descritas como hechos.
- Decisión: lo que se va a hacer, en voz activa y en oraciones completas.
- Consecuencias: todo lo que resulta de la decisión, no solo lo positivo.
Y estas reglas:
- Vive en el repositorio y se revisa en un pull request, igual que el código
(
docs/adr/0001-...md). - Se numera en orden y los números no se reutilizan.
- Tiene una o dos páginas como máximo.
- Se escribe como una conversación con quien lea en el futuro.
- Si la decisión cambia, no se reescribe. Se escribe uno nuevo y el viejo queda marcado como reemplazado. “Sigue siendo relevante saber que esa fue la decisión, aunque ya no lo sea.” En el ADR viejo solo cambia su estado.
MADR (Markdown Architectural Decision Records) es un template que agrega lo que a Nygard le quedaba implícito: las alternativas consideradas con sus pros y contras. Sus secciones principales son el contexto y problema, los factores de decisión (decision drivers), las opciones consideradas, el resultado de la decisión con sus consecuencias, cómo se confirmará, y los pros y contras de cada opción. El proyecto MADR guarda sus propias decisiones en ADR, por si quieren ver ejemplos reales.
En este curso usamos esa idea con títulos en español, los que pide P2 y que su revisión automática comprueba:
| Sección en P2 | Equivalente en MADR |
|---|---|
# ADR-NNNN: título |
Título |
## Estado |
status (en el encabezado del archivo) |
## Contexto |
Context and Problem Statement, Decision Drivers |
## Decisión |
Decision Outcome |
## Alternativas consideradas |
Considered Options, Pros and Cons of the Options |
## Consecuencias |
Consequences |
Un ejemplo completo
Para que no sea el mismo caso del laboratorio, este ejemplo trata otra
decisión de Kallpa: cómo enviar los avisos de verdad.
adr-ejemplo/0002-aviso-por-whatsapp.md
lo tiene completo, y adr.test.ts comprueba
que cumple lo que P2 pide:
# ADR-0002: Avisar por WhatsApp con una tabla de avisos pendientes

## Estado

Propuesta (ejemplo del apunte de la semana 7).

## Contexto

Hoy Kallpa "avisa" escribiendo en la consola: `consoleNotifier` implementa el
puerto `Notifier`. El complejo va a contratar WhatsApp Business y el aviso tiene
que salir de verdad, por una llamada HTTP a un proveedor externo que puede
tardar o caerse.

Las fuerzas en juego:

- El aviso es un complemento: el vecino necesita la reserva, y la ve en la página
  aunque el mensaje no llegue. Un aviso caído no debe impedir reservar.
- El servidor procesa cada reserva sin ceder el control entre revisar que la hora
  esté libre y guardarla. Esa propiedad evita los cruces en un solo proceso, y un
  `await` a un proveedor externo en ese tramo la rompería.
- El equipo son dos personas a tiempo parcial y el complejo no paga más servidores.
  Kallpa recibe unas decenas de reservas al día.

Escenario de calidad: *con el proveedor de WhatsApp caído durante 10 minutos, en
operación normal, el 99 % de las reservas responde en menos de 500 ms y, cuando
el proveedor vuelve, cada aviso sale en menos de 2 minutos.*

## Decisión

Vamos a guardar cada aviso en una tabla `pending_notifications`, en la misma
transacción que la reserva. Un temporizador dentro del mismo proceso del servidor
la revisa cada 30 segundos, llama al proveedor y marca lo que salió.

## Alternativas consideradas

### Llamar al proveedor dentro de la petición

**A favor.** Es lo más simple: un adaptador nuevo del puerto `Notifier` y nada más.
El vecino sabe enseguida si el aviso salió.

**En contra.** Si el proveedor tarda, tarda la reserva; si se cae, hay que decidir
entre fallar la reserva o perder el aviso. No cumple el escenario. Además, el
puerto `Notifier` es síncrono: hacerlo asíncrono invita a poner un `await` en el
handler.

### Tabla de avisos pendientes y temporizador en el mismo proceso (elegida)

**A favor.** Cumple el escenario. La reserva y su aviso se guardan juntos: si el
proceso se cae, el aviso sigue pendiente. No agrega piezas para desplegar ni
operar. Se prueba con un reloj fijo y un doble del proveedor.

**En contra.** El aviso sale hasta 30 segundos después. Si el proceso se cae entre
llamar al proveedor y marcar el aviso, se repite al volver: un vecino puede recibir
dos veces el mismo mensaje. Hay que escribir y mantener el temporizador.

### Una cola de mensajes externa y un proceso aparte que envía

**A favor.** Es la forma habitual cuando hay mucho volumen o varios consumidores.
El envío escala y se despliega por separado del servidor.

**En contra.** Son dos piezas más que desplegar, vigilar y pagar, para unas decenas
de mensajes al día. La reserva y el mensaje ya no se guardan en una sola
transacción, así que aparece el caso de "se guardó la reserva, pero no el mensaje".
Nadie del equipo ha operado una cola.

## Consecuencias

- Lo que se gana: reservar deja de depender del proveedor, y cambiar de proveedor
  toca un solo adaptador.
- Lo que se pierde: el aviso ya no es inmediato, y puede llegar repetido. Lo
  aceptamos porque un mensaje repetido molesta menos que uno perdido. Hay que
  decírselo al complejo.
- Lo que ahora hay que hacer: una migración para la tabla, el temporizador y un
  límite de reintentos, para que un aviso imposible no se reintente para siempre.
- Deuda que queda, a propósito: el temporizador supone una sola instancia. Si dos
  instancias revisan la misma tabla, los dos pueden mandar el mismo aviso. Si el
  complejo decide correr dos instancias (ver ADR-0001), hay que revisar esta
  decisión.
- Cuándo revisarla: si el volumen pasa de unos cientos de avisos al día, o si otro
  sistema también necesita enterarse de las reservas.
Cosas que conviene notar:
- El contexto trae números y un escenario. Quien lea en un año puede comparar: si ya no son decenas al día, sabe que la decisión debe revisarse.
- La alternativa elegida también tiene contras, y la descartada, pros. Si una opción solo tiene ventajas, no se analizó.
- Las consecuencias incluyen lo malo: un vecino puede recibir el mensaje dos veces.
- Dice cuándo revisarla. Esa frase le ahorra a alguien la duda de si la decisión sigue vigente.
- Es corto. Un ADR no explica cómo implementar el temporizador: para eso están el código y, si hace falta, un design doc.
Error común. Un ADR sin alternativas: “Decidimos usar SQLite.” Si no se escribe qué más se consideró y por qué se descartó, quien llegue en un año no sabe si la decisión sigue vigente cuando cambie el contexto. Y otro: escribir el ADR después, para justificar lo que ya se hizo. El valor está en tomar la decisión con el contexto a la vista; un ADR escrito al final solo adorna. P2 lo advierte también: pide decisiones que de verdad hayan tenido alternativas, con consecuencias honestas, incluidas las malas.
ADR y design doc
Se complementan. El design doc de la semana 4 describe cómo se va a construir una cosa, en un momento dado, y envejece. El ADR registra una sola decisión y su motivo, y se conserva aunque cambie. Un design doc enlaza sus ADR, como pide P2. Un cambio mediano suele necesitar un design doc y producir uno o dos ADR.
¿Qué merece un ADR? La prueba del inicio del capítulo: lo que sea caro de cambiar y tenga alternativas reales. La arquitectura y el stack, el modelo de datos, cómo se autentica, dónde se despliega. No hace falta uno para elegir un nombre de variable.
En la industria. El propio artículo de Nygard es un ADR: tiene contexto, decisión, estado (Accepted) y consecuencias. Su formato sobrevive porque es barato. La comunidad en adr.github.io mantiene templates y herramientas, y en MADR se puede ver el formato aplicado a las decisiones de su mismo proyecto. Nygard cuenta que, en los pocos meses que llevaban usándolos, entre seis y diez desarrolladores rotaron por esos proyectos y todos valoraron el contexto que recibían al leerlos. Es un reporte temprano de quien propuso el formato, no una medición.
La deuda técnica como decisión
“Una sola instancia, sin restricción de cruces en la base de datos” es una deuda. La metáfora de la deuda técnica dice que un atajo de diseño se paga como un préstamo: se gana tiempo ahora y cada cambio futuro paga intereses. Fowler la divide en un cuadrante según dos preguntas: ¿se sabía que se estaba contrayendo (deliberada o inadvertida)? ¿Se pensó bien (prudente o imprudente)?
| Imprudente | Prudente | |
|---|---|---|
| Deliberada | “No hay tiempo para diseñar” | “Publiquemos ahora y asumamos las consecuencias” |
| Inadvertida | “¿Qué son las capas?” | “Ahora sabemos cómo debimos hacerlo” |
Según Fowler, la distinción útil no es entre tener deuda y no tenerla, sino entre la prudente y la imprudente. Una deuda prudente puede no valer la pena pagarse si está en una parte que casi no se toca.
Un ADR es lo que convierte la deuda en deliberada y prudente. Si Kallpa decide
quedarse con una instancia y deja escrito “el invariante depende de que el
tramo entre revisar y guardar no tenga await; si alguna vez hace falta una
segunda instancia o una llamada externa ahí, se paga con una transacción”, ya
no es un defecto escondido, sino una apuesta con su condición de pago. El
laboratorio pide exactamente esta frase.
Con IA. Los ADR y los diagramas son parte del contexto que se le da a un agente, para que no “rediseñe” sin querer: si el repositorio dice que hay una sola instancia y por qué, el cambio propuesto puede respetarlo. Y un modelo de lenguaje puede redactar el primer borrador de un ADR, pero las alternativas y las consecuencias tienen que salir del equipo y del cliente. El modelo no sabe cuántas personas mantendrán el sistema ni cuánto puede pagar el complejo por un servidor. Para comprobar un borrador: revisen si cada número del contexto tiene de dónde salir (una entrevista, una medición), si cada alternativa la conoce alguien del equipo y si las consecuencias malas son de este proyecto y no genéricas. Un ADR con consecuencias que servirían para cualquier sistema no dice nada. Y en el caso de este capítulo, un borrador que proponga
timeoutpara resolver eldatabase is lockedse vería razonable: solo la medición muestra que es peor.
El modelo C4
Cuatro niveles de zoom
El modelo C4 de Simon Brown propone dibujar un sistema como se mira un mapa: con distintos niveles de acercamiento, cada uno para un público.
| Nivel | Qué muestra | En Kallpa | ¿Para quién? |
|---|---|---|---|
| 1. Contexto | El sistema como una caja, sus usuarios y los sistemas externos | Vecinos, administración, WhatsApp | Cualquiera, incluido el cliente |
| 2. Contenedores | Las piezas que se ejecutan o guardan datos por separado | Página, servidor Node.js, archivo SQLite | Quien desarrolla u opera |
| 3. Componentes | Las partes de un contenedor | http, services, store, domain, notifications |
Quien desarrolla |
| 4. Código | Clases, funciones | Casi nunca se dibuja a mano | La lee quien la necesite, en el código |
La ventaja frente a un diagrama único, en el que se mezcla de todo, es que cada nivel responde una sola pregunta. La página de C4 recomienda el diagrama de contenedores para todos los equipos.
Contenedor no es Docker
Error común. Confundir el contenedor de C4 con un contenedor de Docker. La página de C4 lo advierte de entrada: “Not Docker!”. En C4, un contenedor representa una aplicación o un almacén de datos: algo que tiene que estar corriendo (o existir) para que el sistema funcione. Puede desplegarse o no en Docker. Kallpa tiene tres contenedores C4, y en el curso todos corren dentro de un solo contenedor Docker o del navegador.
Los de Kallpa:
| Contenedor | Tecnología | Responsabilidad |
|---|---|---|
| Página web | HTML y JavaScript, en el navegador | Mostrar la disponibilidad y reservar |
| API | Node.js 26, node:http |
Reglas de negocio, JSON |
| Base de datos | Un archivo SQLite | Canchas, vecinos, reservas |
Un detalle sutil: la página web y la API son contenedores distintos aunque la API sirva los archivos, porque la página se ejecuta en otro lugar. Y el archivo SQLite es un contenedor aunque viva dentro de la misma máquina y no tenga un proceso propio: guarda datos por separado y sin él nada funciona. El diagrama de contenedores no muestra el despliegue: su página aclara que dice muy poco sobre clusters, load balancers, replicación o failover, y que eso se dibuja en un diagrama de despliegue. Por eso “dos instancias” no agrega un contenedor nuevo a ese diagrama; se ve en el de despliegue.
Diagramas como texto con Mermaid
Mermaid describe diagramas con texto,
y GitHub los
dibuja
al ver un archivo Markdown con un bloque de código mermaid. Eso significa
que el diagrama vive en el repositorio, se revisa en un pull request, y su
historia queda en Git.
El diagrama de contexto de Kallpa:
C4Context
  title Kallpa: diagrama de contexto
  Person(vecino, "Vecino", "Reserva y cancela canchas")
  Person(admin, "Administración", "Consulta la caja del día")
  System(kallpa, "Kallpa", "Reservas de canchas del complejo")
  System_Ext(whatsapp, "WhatsApp", "Por ahora, la consola del servidor")
  Rel(vecino, kallpa, "Reserva y cancela", "navegador")
  Rel(admin, kallpa, "Consulta la caja", "navegador")
  Rel(kallpa, whatsapp, "Avisa la reserva confirmada")
El de contenedores de Kallpa lo dibujan ustedes en el laboratorio. Como modelo de la sintaxis, este es el de otro sistema, un sistema de citas para una posta médica con PostgreSQL y un proveedor de SMS:
C4Container
  title Citas de la posta: diagrama de contenedores
  Person(paciente, "Paciente", "Pide y cancela citas")
  Person(enfermera, "Admisión", "Ve la agenda del día")
  System_Boundary(citas, "Citas de la posta") {
    Container(web, "Página web", "HTML y JavaScript", "Corre en el navegador")
    Container(api, "API", "Node.js", "Reglas de citas y turnos")
    ContainerDb(db, "Base de datos", "PostgreSQL", "Pacientes, médicos y citas")
  }
  System_Ext(sms, "Proveedor de SMS", "Manda recordatorios")
  Rel(paciente, web, "Pide una cita", "HTTPS")
  Rel(enfermera, web, "Revisa la agenda", "HTTPS")
  Rel(web, api, "Citas en JSON", "HTTPS")
  Rel(api, db, "Lee y escribe citas", "SQL/TCP")
  Rel(api, sms, "Texto del recordatorio", "HTTPS")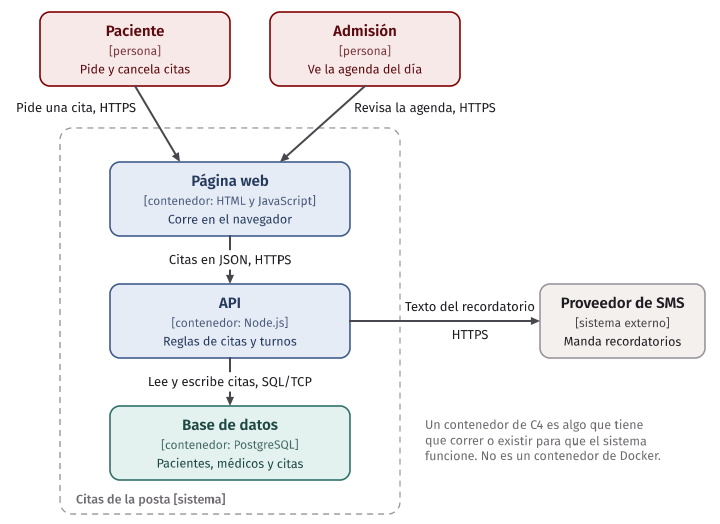
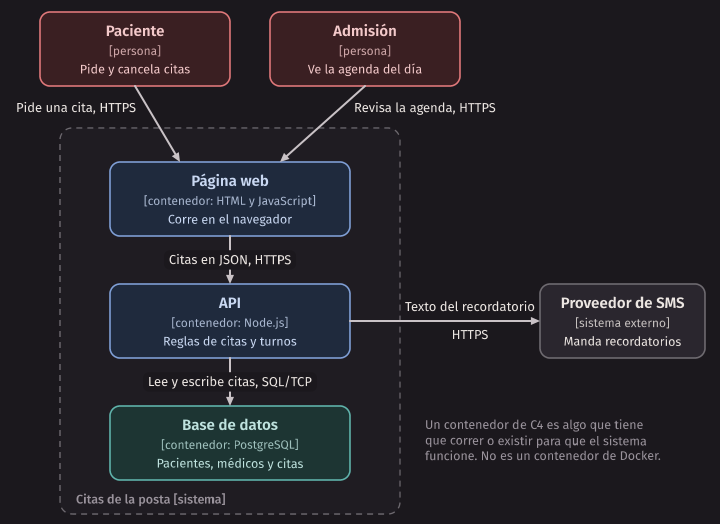
Comprobamos que estos dos bloques son sintaxis válida con el analizador de
Mermaid, pero GitHub puede dibujar distinto de lo que esperan: abran el
archivo en GitHub y mírenlo. Y si el diagrama de C4 de Mermaid queda
amontonado, un flowchart simple con las mismas cajas y flechas también es
válido: C4 es una forma de pensar los niveles, no una notación obligatoria.
Lo más útil de un diagrama está en las flechas: cada una debe decir qué viaja y por qué protocolo. “Usa” no le dice nada a nadie; “Citas en JSON, por HTTPS” sí. Una flecha sin etiqueta suele esconder una decisión que nadie tomó.
Con IA. Un agente puede generar un diagrama de Mermaid en segundos leyendo el código, y lo que dibuja es lo que el código hace hoy, incluidos sus accidentes. Eso sirve para detectar diferencias con lo que el equipo cree, pero no reemplaza la decisión de qué debería ser. Para comprobarlo, comparen las flechas con
make dependencias: si el diagrama no tiene una flecha dehttpastorey el código sí, el diagrama está diciendo una intención.
Laboratorio: un ADR y un diagrama de contenedores para Kallpa
El laboratorio se hace en parejas, en su repositorio de
Kallpa y en una rama nueva desde main. Aquí van las indicaciones para cada
paso, sin las respuestas.
Paso 1: mapear las dependencias. Ya vieron la salida de make dependencias, que corre sobre la Kallpa del curso. Córranla sobre su copia,
con el comando de la guía, y compárenla con lo que promete el README. El
README dice menos de lo que el código hace, y eso no siempre es una violación:
decidan cuáles importan.
Paso 2: la regla de ESLint. Copien los bloques de la sección de capas
dentro de su eslint.config.js (antes del paréntesis final) y corran make lint. El error es el que vimos. Decidan si corrigen el código o cambian la
regla, y escriban en el pull request por qué. Si deciden corregirlo, make check tiene que seguir pasando.
Paso 3: los diagramas. En docs/arquitectura.md: contexto, contenedores y
componentes de la API, en Mermaid. Cada flecha dice qué viaja y por qué
protocolo. Abran el archivo en GitHub para comprobar que se dibuja.
Paso 4: las dos instancias. Detengan make start si está corriendo (el
script se niega a correr si encuentra un servidor en los puertos 3000 o 3001).
Desde la carpeta de Kallpa:
bash /work/code/week-07/dos-instancias.shLa ruta supone que abrieron el contenedor desde la carpeta del curso, con su
repositorio adentro. Si lo abrieron desde su repositorio, /work/code no
existe: copien el script. Corran el script varias veces y anoten cuánto varían
los números. Miren /tmp/a.log y /tmp/b.log, y busquen en qué línea de
handlers.ts falla cada error. Si encuentran una que falla en saveBooking,
ya saben qué significa.
Paso 5: explicar. Respondan las tres preguntas de la guía con los números de línea de su copia.
Paso 6: el ADR. En docs/adr/0001-instancias-y-cruces-de-reservas.md, con
el formato de P2. Se puede defender más de una respuesta: lo que se evalúa es
el razonamiento, no la opción. Pregúntense:
- ¿Qué caída quiere evitar el complejo? ¿Con qué frecuencia y cuánto le cuesta?
- ¿Cuál es el escenario de calidad, con su medida completa?
- ¿Qué números de este capítulo o de su propia medición lo sostienen?
make medir, desdecode/week-07, les da los suyos. Recuerden sus límites: es una máquina y un patrón de llegada. - ¿Qué deuda queda, y qué condición obligaría a pagarla?
Paso 7: el pull request. Con el diagrama, el ADR y el cambio de ESLint. La revisión responde una sola pregunta: ¿alguien que no estuvo en el laboratorio entendería por qué se decidió así?
Sin entregas esta semana, pero P2 se entrega la próxima y pide al menos tres ADR: los de este laboratorio son el modelo.
El código de la semana y make test
La carpeta code/week-07 tiene:
| Archivo | Qué es |
|---|---|
dos-instancias.sh, dos-instancias.test.ts |
El script del paso 4 del laboratorio |
capas-eslint.js, capas.test.ts |
Las reglas de capas sobre una copia de Kallpa |
cruce-de-capas.diff |
Un cambio escrito para la clase que cruza capas |
doble-reserva.test.ts |
El entrelazado, los locks de SQLite y las restricciones |
un-proceso.test.ts, await-intermedio.diff |
Por qué un proceso no reserva dos veces, y cómo un await lo rompe |
medir-escenario.ts, medir.test.ts |
El escenario de calidad medido contra Kallpa |
solo-espera.diff, transaccion.diff |
Dos variantes para medir |
medir-reinicio.ts |
Cuánto tarda Kallpa en volver después de una caída |
hexagon/, hexagon.test.ts |
Un puerto con dos adaptadores y las mismas pruebas para los dos |
adr-ejemplo/, adr.test.ts |
El ADR de este capítulo y su revisión con las reglas de P2 |
Dentro del contenedor del curso:
$ cd code/week-07
$ make test
tsc -p .
eslint .
node --test "*.test.ts"
...
ℹ tests 35
ℹ suites 7
ℹ pass 35
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
make test no afirma cuántos errores 500 salen con dos instancias, porque
cambia entre corridas; una prueba cuyo resultado depende de la suerte es un
flaky test (semana 9). Afirma lo que sí es determinista: el entrelazado
forzado, el comportamiento de los locks y que la transacción no deja dobles
reservas. Los números de este capítulo salen de make medir, make reinicio
y make dos-instancias. Nada modifica kallpa/: todo se hace en copias, y
make clean borra build/.
Resumen
- Arquitectura son las decisiones de un sistema que son caras de cambiar: cómo se divide, cómo se comunican las partes, dónde viven los datos y cómo se despliega. Diseño y arquitectura son lo mismo a distinta escala; cambia el costo de equivocarse.
- En una arquitectura en capas, cada capa usa solo a las de abajo. Un
import de tipo también acopla. La regla vale lo que vale su cumplimiento:
una revisión como
no-restricted-importsla hace cumplir, dentro de lo que sabe mirar. - En la arquitectura hexagonal, el núcleo define puertos en sus
términos, los adaptadores conectan la tecnología y las dependencias
apuntan hacia el núcleo. Kallpa la aplica en
ClockyNotifier, no en los datos. Un puerto se justifica si tiene adaptadores reales. - Un monolito se despliega entero y da transacciones y llamadas simples. Los microservicios dan despliegues y escalado independientes a cambio de fallas parciales, consistencia eventual y mucha más operación. Un monolito modular se queda en el medio.
- La ley de Conway dice que el sistema copia la comunicación de la organización. Monolith first dice que las fronteras se aprenden y que moverlas entre servicios es mucho más caro. Es experiencia acumulada, con la evidencia y las reservas que declara el propio Fowler.
- Un atributo de calidad se escribe como escenario: estímulo, entorno, respuesta y medida. Si la medida deja pasar lo que le duele al usuario, está mal: dos instancias de Kallpa cumplían un escenario con la mitad de las peticiones en 500. Los atributos compiten, y decidir es elegir cuál gana.
- Revisar y después guardar es una condición de carrera si otro puede
actuar entre los dos pasos. En un proceso de Node, lo evita que el tramo sea
síncrono: un
awaitlo rompe. Entre procesos, hay que hacer que sea una sola operación para la base de datos. Esperar el lock sin una transacción cambia los errores 500 por dobles reservas. - Un ADR es un documento corto por decisión, con estado, contexto, decisión, alternativas y consecuencias, también las malas. Vive en el repositorio y, si la decisión cambia, se reemplaza.
- La deuda técnica puede ser deliberada y prudente si se escribe con la condición que obligará a pagarla.
- C4 dibuja el sistema en cuatro niveles. Su contenedor es algo que debe correr o existir para que el sistema funcione, no un contenedor de Docker. En los diagramas, las flechas dicen qué viaja y por qué protocolo.
Ejercicios
- Clasifiquen cada decisión como de arquitectura o no, y digan qué costaría
cambiarla: (a) las horas se guardan como enteros; (b)
formatSolesestá enpricing.ts; (c) los avisos salen por consola detrás de unNotifier; (d) la API responde errores con{ error: { code, message } }; (e) las pruebas usannode:test. ¿Alguna depende de quién usa ya el sistema? - Reescriban como escenario de calidad, con sus cuatro partes y una medida que el usuario reconozca: (a) “la caja del día debe ser confiable”; (b) “el sistema debe ser fácil de usar para los vecinos mayores”; (c) “las reservas deben funcionar aunque haya problemas”. ¿Con qué atributo compite cada uno?
- Dibujen Kallpa como hexágono, con todos sus puertos primarios y secundarios y los adaptadores de hoy. ¿Qué adaptador nuevo haría falta para avisar por WhatsApp de verdad y qué parte del código no cambiaría?
- Agreguen a
capas-eslint.jsun bloque para quesrc/services/**no importe../http/*. Corranmake capas. Después agreguennode:sqlitea lo prohibido ensrc/http/**. ¿Qué archivo reporta? ¿Lo corregirían o dejarían la excepción? Justifíquenlo. - Un compañero propone separar Kallpa en tres microservicios (canchas, reservas y pagos) para el proyecto del curso. Escriban dos argumentos a favor y tres en contra, usando la ley de Conway y monolith first. Después escriban cómo sería un monolito modular con esas mismas tres fronteras y qué regla de ESLint las haría cumplir.
- Qué le falta a este ADR: “Contexto: necesitamos una base de datos. Decisión: usamos SQLite. Consecuencias: es fácil.” Reescríbanlo completo para Kallpa, con tres alternativas. No pueden usar la palabra “fácil”.
- En
doble-reserva.test.ts, escriban una prueba que fuerce este otro entrelazado: A revisa, A guarda, B revisa, B guarda. ¿Cuántas reservas confirmadas quedan? Con el resultado, expliquen qué tiene que pasar exactamente para que haya una doble reserva. - El índice único parcial de este capítulo no detiene los cruces. Una reserva
de 1 hora a las 10:00 pasa si ya hay una de 9:00 a 11:00. Implementen en
una copia de Kallpa la tabla
booking_hours(una migración nueva, nunca editar las anteriores), insértenla junto con la reserva en una transacción y bórrenla al cancelar. Corranmake checkynode medir-escenario.ts <su copia> 2. ¿Qué diferencia encuentran en los errores que ve el vecino, comparado contransaccion.diff? - Lean
createBookingde nuevo: después de guardar, la línea 114 vuelve a leer la reserva. ¿Qué pasaría si esa lectura falla condatabase is locked? ¿Qué recibe el vecino, qué queda en la base de datos y qué pasa con el aviso? ¿Vieron este caso en las mediciones? ¿Por qué el contadorreservas guardadas sin responder 200existe y por qué que salga 0 no prueba que no pueda pasar? - Repitan la medición con otro patrón de llegada: cambien
medir-escenario.tspara que las peticiones de una ronda lleguen separadas por 1 ms. ¿Qué cambia en los 500? ¿Qué aprendieron sobre lo que su escenario debe decir de cómo se mide? - Dibujen el diagrama de contexto y de contenedores del producto de su cliente, en Mermaid, y escriban los tres ADR más importantes de su P2 en una línea cada uno: decisión, alternativa descartada y qué condición los haría cambiar de opinión.
- Tomen una deuda técnica real de su proyecto y ubíquenla en el cuadrante de Fowler. Si es inadvertida o imprudente, escriban lo que haría falta para convertirla en deliberada y prudente. ¿Qué condición obligaría a pagarla, y quién se daría cuenta de que se cumplió?