Apuntes · Capítulo 5Diseño y arquitectura
Complejidad, módulos profundos y conceptos
Complejidad, módulos profundos y conceptos
La semana pasada especificaron una función: qué pide, qué promete y quién responde por cada condición. Con eso escribieron un design doc que dice qué se va a construir y qué alternativas se descartaron. Esta semana empieza la parte del curso dedicada al diseño y la arquitectura. La pregunta cambia: ya no es qué hace una función, sino cómo se reparte el código en módulos para que el sistema se pueda entender y cambiar sin miedo.
Kallpa sirve de punto de partida. Funciona, pasa sus 40 pruebas y hace lo que dice su README. Aun así, algunos cambios cuestan mucho más de lo que deberían, y para hacer otros hay que saber cosas que no están escritas en ninguna parte. Este capítulo da un vocabulario para nombrar ese problema y criterios para decidir dónde poner cada cosa.
El capítulo tiene dos partes, como la semana. En la primera definimos la complejidad como la define John Ousterhout, distinguimos la programación táctica de la estratégica, y estudiamos los módulos profundos y el ocultamiento de información de David Parnas. En la segunda pasamos de los módulos del código a los conceptos que ve el usuario, con Daniel Jackson, y terminamos con el acoplamiento, la cohesión, el principio DRY y la dirección de las dependencias. Al final está el refactoring: cambiar la estructura del código sin cambiar su comportamiento, que es lo que harán en el laboratorio con un módulo de Kallpa.
Lectura. Este capítulo acompaña a John Ousterhout, A Philosophy of Software Design, 2.ª ed., capítulos 2 a 5 (The Nature of Complexity, Working Code Isn’t Enough, Modules Should Be Deep e Information Hiding (and Leakage)). El libro no es gratuito: búsquenlo en la biblioteca o consigan su copia (página del libro). Si no lo tienen, la charla A Philosophy of Software Design (Talks at Google) cubre las mismas ideas. Para la segunda parte, los tutoriales de Daniel Jackson, The Essence of Software: Software = concepts, Concept purposes y Operational principles. Complementarias: David Parnas, On the Criteria To Be Used in Decomposing Systems into Modules (Communications of the ACM, 1972); los capítulos 6, 7 y 9 de Ousterhout; y los tutoriales de Jackson Concept modularity y Concept dependencies and subsets. El código del capítulo está en
code/week-05y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Qué es la complejidad, Una definición que mira los cambios, Tres síntomas y Dos causas: dependencias y oscuridad; de Programación táctica y estratégica, Que funcione no basta; de Módulos profundos, Módulo, interfaz e implementación y Profundidad: lo que da contra lo que cuesta; de Conceptos: el diseño que ve el usuario, Qué es un concepto, El principio operacional y El propósito; y de Acoplamiento y cohesión, Dos medidas de lo mismo.
- En clase: Sesión A: Qué es la complejidad, Programación táctica y estratégica, Módulos profundos y Ocultamiento de información. Sesión B: Conceptos: el diseño que ve el usuario y Acoplamiento y cohesión. Laboratorio: Refactorizar sin cambiar el comportamiento y El laboratorio: refactorizar un módulo superficial de Kallpa.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: El argumento de Parnas, KWIC en TypeScript, de las dos formas, Turnos fijos: ¿concepto nuevo o forma de usar reserva?, DRY es sobre conocimiento, no sobre texto, La dirección de las dependencias y las lecturas del recuadro Lectura.
Qué es la complejidad
Una definición que mira los cambios
Ousterhout define la complejidad en el capítulo 2 de una forma práctica: es todo lo que, en la estructura de un sistema de software, lo hace difícil de entender y de modificar. La definición no habla de líneas de código, de cuántas clases hay ni de qué tan sofisticados son los algoritmos. Habla de lo que le cuesta a una persona hacer un cambio.
De ahí salen tres consecuencias que conviene tener claras desde el inicio:
- La complejidad no es el tamaño. Un sistema grande puede ser simple de cambiar si cada parte se entiende sola, y un programa de 300 líneas puede ser imposible de tocar si todo depende de todo. El código TypeScript de Kallpa, con las pruebas, tiene menos de 1500 líneas; el tamaño no es su problema.
- Lo que cuenta son los cambios que de verdad se hacen. Ousterhout lo resume con una suma: la complejidad de un sistema es la complejidad de cada parte multiplicada por la fracción del tiempo que los desarrolladores pasan trabajando en ella. Una parte enredada que nadie toca en años pesa poco; un archivo que se edita cada semana, aunque sea solo un poco oscuro, pesa mucho.
- La complejidad la nota quien lee, no quien escribe. Quien acaba de escribir un módulo lo entiende, porque tiene todo el contexto en la cabeza. La prueba real es otra persona, o la misma tres meses después. Si el revisor de su pull request dice que algo no se entiende, la complejidad está ahí, aunque al autor le parezca obvio.
Tres síntomas
Ousterhout reconoce la complejidad por tres síntomas.
Amplificación de cambios (change amplification): un cambio que en la
cabeza es simple obliga a tocar muchos lugares. El ejemplo de la guía es el
horario de cierre de Kallpa. Si el número 22 estuviera escrito en cinco
archivos, cerrar a las 23:00 obligaría a encontrar y cambiar los cinco, y
olvidar uno dejaría una página que muestra una hora que la API rechaza.
En Kallpa el horario está en un solo lugar, src/domain/booking.ts:
export const OPENING_HOUR = 7; // la primera reserva empieza a las 7:00
export const CLOSING_HOUR = 22; // a las 22:00 se apagan las luces
¿Basta con cambiar esa línea? En lugar de suponerlo, se puede medir. La
prueba closing-hour.test.ts copia
Kallpa a una carpeta temporal, cambia 22 por 23 en esa única línea y corre
las pruebas de la copia. Hecho a mano en el contenedor:
$ cp -r /work/kallpa /tmp/k23 && cd /tmp/k23
$ sed -i "s/CLOSING_HOUR = 22;/CLOSING_HOUR = 23;/" src/domain/booking.ts
$ node --test "test/**/*.test.ts"
...
ℹ tests 40
ℹ suites 6
ℹ pass 38
ℹ fail 2
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 172.397584

✖ failing tests:

test at test/booking.test.ts:18:3
✖ rechaza una reserva que termina después del cierre (0.554583ms)
...
test at test/http.test.ts:26:3
✖ una cancha sin reservas está libre todo el día (2.865917ms)
  AssertionError [ERR_ASSERTION]: Expected values to be strictly equal:

  16 !== 15
...
El código entero se enteró del cambio: la validación de las reservas, el
mensaje de error (El complejo atiende de ${OPENING_HOUR}:00 a ${CLOSING_HOUR}:00.) y la disponibilidad que ve la página usan la constante.
Fallan dos pruebas, y vale la pena ver por qué.
Una prueba espera 15 horas libres (assert.equal(body.slots.length, 15); // de 7:00 a 21:00) y la otra usa una reserva de 21:00 a 23:00 como ejemplo de
“termina después del cierre”. Las dos escriben el horario a mano. ¿Es eso
amplificación de cambios? En parte. Una prueba es una especificación: cuando la
regla del negocio cambia, es correcto que una prueba falle y que alguien
decida, a conciencia, el valor nuevo. Lo que no debería pasar es que el cambio
se tenga que repetir en código de producción. El README también dice “hasta las
22:00”, y ese tampoco se actualiza solo. Así que el cambio completo es una
constante, dos pruebas y un párrafo de documentación, y las propias pruebas
señalan dónde está el resto.
Carga cognitiva (cognitive load): cuánto tiene que saber quien hace un
cambio para hacerlo sin romper nada. En Kallpa, quien toca precios tiene que
saber que el dinero se maneja en céntimos y como enteros (S/ 112.50 es
11250). El código reduce esa carga de dos formas: los nombres lo dicen
(priceCents, HOURLY_RATE_CENTS) y la conversión a soles está en una sola
función, formatSoles. Más líneas no significan más carga: una función de
diez líneas obvias puede pedir menos que una de tres con un truco.
Incógnitas desconocidas (unknown unknowns): no es evidente qué hay que
cambiar, ni siquiera que hay algo que saber. Es el peor de los tres síntomas,
porque no hay forma de saber que uno se equivocó hasta que aparece el error en
producción. Un ejemplo real de Kallpa: SQLite no revisa las claves foráneas a
menos que cada conexión lo pida con PRAGMA foreign_keys = ON. Quien abra la
base de datos con new DatabaseSync(...) en otro archivo tendrá una conexión
que acepta reservas de canchas inexistentes, y nada le avisará. Kallpa lo evita
con una sola puerta de entrada, openDatabase en src/store/database.ts, que
abre la conexión, activa la revisión y aplica las migraciones:
$ grep -rn "PRAGMA foreign_keys\|new DatabaseSync" src test
src/store/database.ts:41:  const db = new DatabaseSync(path);
src/store/database.ts:43:  db.exec('PRAGMA foreign_keys = ON');
Nadie más crea conexiones. El dato oscuro sigue existiendo, pero solo lo
necesita saber quien mantiene database.ts.
Error común. Medir la complejidad por cómo se ve el código (“está ordenado”, “tiene muchas clases”, “usa patrones”). La medida es lo que cuesta el próximo cambio. Pregúntense: para hacer este cambio, ¿cuántos lugares toco, cuánto tengo que saber y cómo sé que no me falta nada?
Dos causas: dependencias y oscuridad
Según Ousterhout, los tres síntomas tienen dos causas.
Una dependencia existe cuando un trozo de código no se puede entender ni
cambiar solo: para tocarlo hay que mirar otro. Las dependencias no se pueden
eliminar, porque un sistema es un conjunto de partes que colaboran. Lo que se
busca es que sean pocas y evidentes. En Kallpa, los handlers dependen de un
reloj, pero de uno que reciben como parámetro (Clock), no de la hora de la
computadora. La dependencia está a la vista en la firma, y las pruebas la
reemplazan por un reloj fijo.
La oscuridad (obscurity) es información importante que no es evidente.
Una variable llamada time sin unidades; un número mágico; un supuesto que solo
conoce quien escribió el código; dos módulos que tienen que cambiar juntos sin
que nada lo diga. Se combate con nombres precisos, con comentarios que explican
el porqué (como los de clock.ts y database.ts) y, sobre todo, con diseños
que no necesitan tantas explicaciones.
Las dos causas se alimentan entre sí: una dependencia oscura, que nadie ve, es justo lo que produce incógnitas desconocidas.
La complejidad se acumula
Ningún cambio solo vuelve complejo un sistema. Se acumula de a poco: una validación copiada aquí “porque es más rápido”, un parámetro booleano allá, una consulta que devuelve de más y obliga a cada llamador a filtrar. Cada cosa parece inofensiva y el costo aparece meses después, repartido entre todos. Por eso Ousterhout propone cero tolerancia: cada cambio pequeño cuenta, porque la complejidad no se puede quitar después de un solo golpe.
Idea clave. La complejidad es lo que hace difícil entender y cambiar un sistema. Se reconoce por la amplificación de cambios, la carga cognitiva y las incógnitas desconocidas; la causan las dependencias y la oscuridad; y se acumula de a poco. El tamaño no es la medida.
Programación táctica y estratégica
Que funcione no basta
El capítulo 3 de Ousterhout se llama Working Code Isn’t Enough. La programación táctica tiene un objetivo: que la tarea de hoy funcione, cuanto antes. Si para eso hay que copiar una validación o agregar un caso especial, se hace. Cada atajo es pequeño, y por eso la programación táctica parece razonable. Pero es justamente la forma en que la complejidad se acumula.
La programación estratégica parte de otra idea: el código que funciona no es el producto final, porque el sistema va a seguir cambiando. El objetivo principal es un buen diseño que, además, funciona. En la práctica, eso significa invertir un poco en cada cambio: pensar la interfaz antes de escribir, probar dos diseños en lugar de quedarse con el primero, arreglar un problema de diseño cuando se lo encuentra en lugar de esquivarlo.
Ousterhout propone una cifra para esa inversión: entre el 10 y el 20 % del tiempo de desarrollo. Es una recomendación de su experiencia, no el resultado de un estudio, y conviene leerla así: una inversión pequeña y constante, no un proyecto de rediseño cada año. Su argumento es que la inversión se recupera pronto, porque el código mejor diseñado hace más rápidos los cambios siguientes.
El libro describe también al tactical tornado: la persona que entrega funcionalidades más rápido que nadie y deja detrás código que los demás tienen que entender y arreglar. En muchos equipos pasa por la más productiva, porque su velocidad se ve y el costo que deja se reparte entre todos.
Deuda técnica, bien y mal usada
La metáfora de la deuda técnica viene de Ward Cunningham (en un reporte de experiencia de 1992): entregar código que todavía no refleja bien lo que se entendió del problema es como pedir un préstamo, útil para avanzar, siempre que se pague pronto reescribiéndolo. Los intereses son el costo extra de cada cambio mientras la deuda siga ahí.
Bien usada, la metáfora sirve para decidir a conciencia: “lanzamos con esta versión simple para la demo del viernes, y la semana que viene la reemplazamos; está en el issue 42”.
Error común. Llamar “deuda técnica que pagaremos luego” a lo que en realidad es diseño que nadie va a revisar. Una deuda tiene un monto conocido, un responsable y una fecha. Si no hay un issue, una persona a cargo y un momento para pagarla, no es deuda: es la forma en que el sistema se va a quedar.
En la industria. Ousterhout cuenta en el capítulo 3 el caso de Facebook, cuyo lema era Move fast and break things: con el tiempo, la base de código se volvió difícil de cambiar y la empresa cambió el lema a Move fast with solid infrastructure. Lo contrapone con Google y VMware, que crecieron con una cultura técnica que valoraba el buen diseño, y sostiene que esa cultura les ayudó a atraer buenos ingenieros. El libro no presenta datos que comparen la productividad de unas y otras: es un argumento a partir de casos, y así hay que leerlo.
Con IA. Un agente de programación trabaja de forma táctica por omisión: resuelve la tarea pedida y agrega código donde le resulta más cómodo, a veces con una capa nueva que solo reenvía llamadas, a veces con una copia de una función que ya existía. Las pruebas pasan y el diseño empeora un poco. Al revisar lo que propone, no se queden en “¿pasan las pruebas?”: pregunten también qué lugares tocó, si duplicó algo que ya existía y si la interfaz que agregó esconde algo o solo pasa datos de un lado a otro. Pedir el cambio con el criterio escrito (“no agregues una capa nueva; usa
Bookings”) ayuda, pero no reemplaza la revisión.
Módulos profundos
Módulo, interfaz e implementación
Para Ousterhout, un módulo es cualquier unidad de código con una interfaz y una implementación: una función, una clase, un archivo, un paquete, un servicio. La interfaz es lo que necesita saber quien lo usa; la implementación, el código que cumple lo que la interfaz promete.
La interfaz tiene dos partes:
- La parte formal es la que revisa el compilador: los nombres, los tipos
de los parámetros y del resultado, las excepciones que declara. En
TypeScript, la firma
limaTime(instant: Date): LimaTime. - La parte informal es todo lo demás que hay que saber para usarlo bien: qué hace, en qué orden hay que llamar a sus funciones, qué efectos tiene, qué pasa si un argumento no cumple una condición. Es el contrato de la semana 4: las precondiciones y las postcondiciones son interfaz, aunque el compilador no las vea. Suele ser más grande que la parte formal.
Un módulo bien hecho es una abstracción: una vista simplificada que deja fuera los detalles que no importan para usarlo. Una abstracción puede fallar de dos formas. Si incluye detalles que no importan, la interfaz crece y sube la carga cognitiva de quien la usa. Si omite detalles que sí importan, es una abstracción falsa: parece simple, pero quien la usa se equivoca porque le faltaba algo (y eso es oscuridad).
Profundidad: lo que da contra lo que cuesta
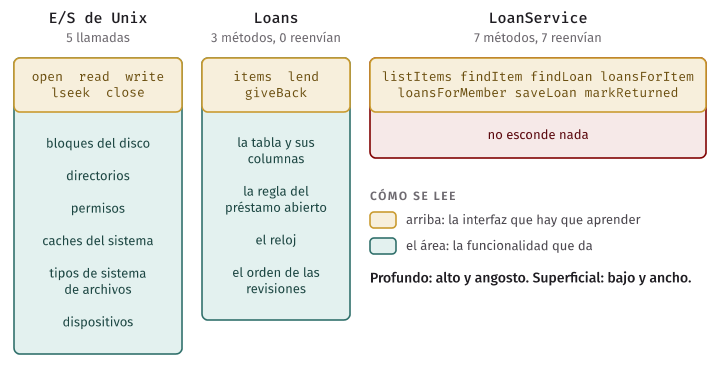
Ousterhout propone mirar cada módulo como un rectángulo. El área es la funcionalidad que da; el borde de arriba, la interfaz que hay que aprender. El beneficio de un módulo es lo que hace por quien lo usa; su costo, la interfaz que esa persona tiene que conocer.
- Un módulo profundo da mucha funcionalidad con una interfaz pequeña: un rectángulo alto y angosto.
- Un módulo superficial tiene una interfaz casi tan grande como lo que hace: un rectángulo bajo y ancho. Usarlo cuesta casi lo mismo que escribir su código.
El ejemplo clásico es la entrada y salida de archivos de Unix. Cinco llamadas
al sistema, open, read, write, lseek y close, esconden cómo se
organiza el disco en bloques, los directorios, los permisos, los caches del
sistema operativo, los distintos tipos de sistema de archivos y los
dispositivos. Las implementaciones cambiaron muchísimo en cincuenta años; la
interfaz casi no. Otro ejemplo del libro es el garbage collector de lenguajes como Java o
Go: su interfaz es casi nula (no hay que hacer nada) y la
funcionalidad, enorme.
La profundidad no se mide en líneas. Una función de 40 líneas puede ser superficial si su interfaz obliga a saber todo lo que hace por dentro, y una de 10 puede ser profunda si esconde una decisión difícil.
Un módulo profundo pequeño en Kallpa
src/domain/clock.ts tiene una función, limaTime, que recibe un instante y
devuelve la fecha y la hora que marca un reloj de pared en Lima:
const LIMA_FORMAT = new Intl.DateTimeFormat('en-CA', {
  timeZone: 'America/Lima',
  year: 'numeric',
  month: '2-digit',
  day: '2-digit',
  hour: '2-digit',
  minute: '2-digit',
  hourCycle: 'h23',
});

export function limaTime(instant: Date): LimaTime {
  const parts = Object.fromEntries(LIMA_FORMAT.formatToParts(instant).map((part) => [part.type, part.value]));
  return {
    date: `${parts.year}-${parts.month}-${parts.day}`,
    hour: Number(parts.hour),
    minute: Number(parts.minute),
  };
}
La interfaz es una línea: un Date entra, un { date, hour, minute } sale.
Lo que esconde es bastante más: que se usa la base de datos de zonas horarias
(America/Lima) en lugar de restar cinco horas a mano; que hourCycle: 'h23'
evita que la medianoche salga como hora 24 en algunos entornos; que la fecha
se arma con formatToParts, tomando cada parte por su tipo (año, mes, día),
en lugar de cortar un texto cuyo orden depende del formato regional. Quien llama a limaTime
no necesita saber nada de eso, y el resto de Kallpa no lo sabe:
$ grep -rn "Intl\|America/Lima" src
src/domain/clock.ts:24:const LIMA_FORMAT = new Intl.DateTimeFormat('en-CA', {
src/domain/clock.ts:25:  timeZone: 'America/Lima',
Si mañana se reemplaza Intl.DateTimeFormat por la API Temporal, cambia un
archivo y nadie más se entera. Eso es lo que la guía de la semana llama
esconder una decisión de diseño.
Un módulo superficial: el préstamo de implementos
Para ver un módulo superficial sin adelantar el laboratorio, la carpeta
code/week-05/loans tiene un ejemplo escrito para
el capítulo: el préstamo de pelotas y redes en la administración del complejo.
Hay tres reglas: un implemento prestado no se puede volver a prestar hasta que
lo devuelvan, un vecino no puede tener dos implementos a la vez, y un préstamo
se devuelve una sola vez. Las dos versiones usan la misma tabla de SQLite
(loans, con una columna returned_at que queda en NULL mientras el
préstamo está abierto) y responden exactamente lo mismo.
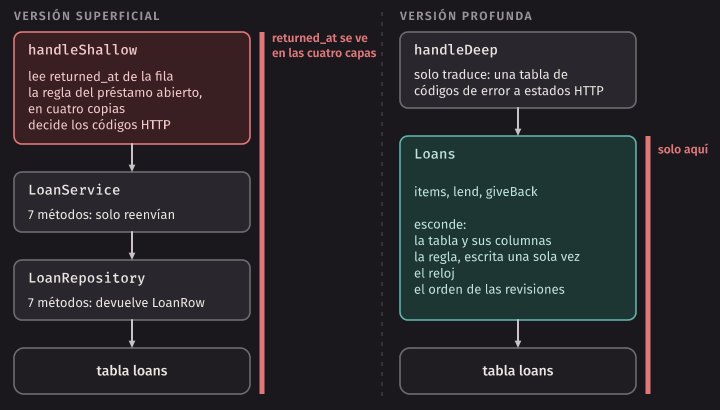
La primera versión, shallow.ts, tiene la
estructura de muchas aplicaciones en capas: un repositorio que habla con
SQLite, un “servicio” y unos handlers. El servicio se ve así:
// La "capa de servicios": cada método reenvía la llamada al repositorio.
export class LoanService {
  #repo: LoanRepository;

  constructor(db: DatabaseSync) {
    this.#repo = new LoanRepository(db);
  }

  listItems(): ItemRow[] {
    return this.#repo.listItems();
  }

  findItem(id: number): ItemRow | undefined {
    return this.#repo.findItem(id);
  }

  // ... cinco métodos más con la misma forma
}
Cada método repite la interfaz del repositorio. La clase no agrega funcionalidad: su interfaz es tan grande como su implementación. Es un módulo superficial, y la señal más clara son los métodos que solo reenvían la llamada (pass-through methods). Ousterhout los trata en el capítulo 7: un método que llama a otro con los mismos parámetros, o casi, y no hace nada más. Quien lee el código tiene que aprender dos interfaces para obtener lo que daba una.
Contar esos métodos a ojo es fácil en una clase de siete métodos y tedioso en
un proyecto real. pass-through.ts lo
hace con el compilador de TypeScript: lee el archivo, recorre las clases y
marca los métodos públicos cuyo cuerpo es una sola llamada a un método de un
campo del objeto (this.#repo.algo(...)):
$ node pass-through.ts loans/shallow.ts loans/deep.ts
shallow.ts: clase LoanRepository, 39 líneas, 7 métodos públicos
  listItems()                          hace algo más
  findItem(id)                         hace algo más
  findLoan(id)                         hace algo más
  loansForItem(itemId)                 hace algo más
  loansForMember(memberId)             hace algo más
  insert(itemId, memberId, lentAt)     hace algo más
  setReturnedAt(id, returnedAt)        hace algo más
  0 de 7 métodos solo reenvían la llamada
shallow.ts: clase LoanService, 35 líneas, 7 métodos públicos
  listItems()                          reenvía a this.#repo.listItems
  findItem(id)                         reenvía a this.#repo.findItem
  findLoan(id)                         reenvía a this.#repo.findLoan
  loansForItem(itemId)                 reenvía a this.#repo.loansForItem
  loansForMember(memberId)             reenvía a this.#repo.loansForMember
  saveLoan(itemId, memberId, lentAt)   reenvía a this.#repo.insert
  markReturned(id, returnedAt)         reenvía a this.#repo.setReturnedAt
  7 de 7 métodos solo reenvían la llamada
deep.ts: clase Loans, 53 líneas, 3 métodos públicos
  items()                              hace algo más
  lend(itemId, memberId)               hace algo más
  giveBack(loanId)                     hace algo más
  0 de 3 métodos solo reenvían la llamada
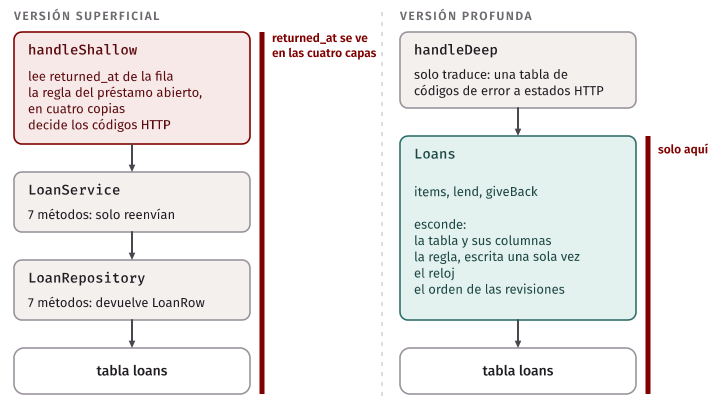
¿Dónde está, entonces, la lógica del préstamo? En el handler, que sabe todo: los nombres de las columnas, la regla de qué préstamo está abierto y los códigos HTTP.
if (req.method === 'POST' && req.path === '/loans') {
  const itemId = Number(req.body?.itemId);
  const memberId = Number(req.body?.memberId);
  const item = service.findItem(itemId);
  if (!item) return error(404, 'ITEM_NOT_FOUND', `No existe el implemento ${itemId}.`);
  if (service.loansForItem(itemId).some((l) => l.returned_at === null)) {
    return error(409, 'ITEM_LENT', 'El implemento está prestado.');
  }
  if (service.loansForMember(memberId).some((l) => !l.returned_at)) {
    return error(409, 'MEMBER_HAS_LOAN', 'Primero hay que devolver el implemento anterior.');
  }
  const id = service.saveLoan(itemId, memberId, now());
  return { status: 200, body: { loan: toLoanJson(service.findLoan(id)!) } };
}
Fíjense en la regla “un préstamo está abierto si no tiene returned_at”.
Aparece aquí dos veces, escrita de dos formas distintas (=== null y
!l.returned_at), una tercera vez en el handler que lista los implementos y
una cuarta, negada, en el que registra la devolución. Las cuatro copias dan lo
mismo con los datos de hoy. Si mañana se agrega un estado “perdido”, alguien
tiene que encontrar las cuatro, y nada le dice que
existen. Es una incógnita desconocida fabricada a mano.
La segunda versión, deep.ts, tiene un
módulo Loans con tres operaciones:
export type LoanResult = { ok: true; loan: Loan } | { ok: false; error: LoanError };

// Interfaz: tres operaciones. Esconde la tabla y sus columnas, la regla de
// qué préstamo está abierto (está escrita una sola vez, en el SQL de abajo),
// el reloj y el orden en que se revisan las reglas.
export class Loans {
  constructor(db: DatabaseSync, now: Now) { /* ... */ }
  items(): ItemStatus[] { /* ... */ }
  lend(itemId: number, memberId: number): LoanResult { /* ... */ }
  giveBack(loanId: number): LoanResult { /* ... */ }
}

// La regla "un préstamo está abierto", en un solo lugar.
const OPEN = 'returned_at IS NULL';
Tres cosas cambiaron. La interfaz es más chica: tres métodos que dicen lo que
quiere quien llama (“presta”, “devuelve”), en lugar de siete que dicen cómo
está guardado. Lo que el módulo esconde es más grande: la tabla, las columnas,
la regla del préstamo abierto, el reloj y el orden de las revisiones. Y los
errores son del negocio, no de HTTP: lend devuelve
{ ok: false, error: { code: 'ITEM_LENT', ... } }, y el handler elige el
código 409 con una tabla. El handler quedó en traducir:
export function handleDeep(loans: Loans, req: Request): Response {
  if (req.method === 'GET' && req.path === '/items') return { status: 200, body: { items: loans.items() } };
  if (req.method === 'POST' && req.path === '/loans') {
    return respond(loans.lend(Number(req.body?.itemId), Number(req.body?.memberId)));
  }
  // ...
}
¿Cómo sabemos que las dos versiones hacen lo mismo? Porque
loans.test.ts les manda el mismo guion de
doce solicitudes, que pasa por cada caso feliz y por cada código de error, y
compara todas las respuestas con assert.deepEqual. Esa idea, comparar el
comportamiento de dos versiones con un guion, la usaremos de nuevo al hablar
de refactoring.
Idea clave. Un módulo es profundo cuando su interfaz es pequeña comparada con lo que hace y con lo que esconde. La señal de un módulo superficial son los métodos que solo reenvían la llamada: cuestan una interfaz más y no esconden nada.
No todo método que reenvía es un error. Un despachador que elige a qué
implementación llamar según un argumento hace algo; un decorator que agrega un
log alrededor de otra interfaz también; una interfaz que tiene varias
implementaciones (como Notifier en Kallpa, que en producción escribe en la
consola y en las pruebas guarda los mensajes) justifica su existencia aunque
cada implementación sea corta. La pregunta es siempre la misma: ¿qué sabe este
módulo que los demás no tienen que saber?
Muchas clases pequeñas no es lo mismo que buen diseño
Ousterhout llama classitis (capítulo 4) a la idea de que las clases deben ser pequeñas por principio, y de que separar más siempre es mejor. Cada clase nueva trae una interfaz nueva, y si la clase no esconde nada, el sistema queda con más interfaces que aprender y la misma funcionalidad.
Su ejemplo es la lectura de objetos desde un archivo en Java: hay que crear un
FileInputStream, envolverlo en un BufferedInputStream para tener un buffer
y envolver eso en un ObjectInputStream. Tres objetos para algo que casi
siempre se quiere igual, y el buffer, que casi todos necesitan, hay que
pedirlo explícitamente; si alguien lo olvida, no hay error, solo un programa
lento. Compárenlo con open y read de Unix.
Error común. Confundir “muchas clases pequeñas” con buen diseño. Separar todo en clases de tres líneas multiplica las interfaces sin esconder nada. Un módulo más grande y profundo suele ser más simple de usar que cinco superficiales. El tamaño de una clase no es un objetivo; lo que esconde, sí.
Con IA. Con módulos profundos, a un agente le basta leer una interfaz pequeña para usar bien un módulo, y lo que entra en su contexto alcanza para más. Con módulos superficiales tiene que leer la implementación de cada capa para saber qué hace, y es más fácil que copie una regla en lugar de encontrar dónde vive. Si ustedes no saben responder “¿qué esconde este módulo?”, el agente tampoco va a poder usarlo bien.
Ocultamiento de información
El argumento de Parnas
En 1972, David Parnas publicó en Communications of the ACM un artículo de seis páginas que sigue siendo la mejor explicación de para qué sirve dividir un programa en módulos. Su pregunta era: dado un programa, ¿con qué criterio se decide qué va en cada módulo?
Parnas usa un ejemplo pequeño a propósito, un índice KWIC (key word in
context). El programa recibe líneas de texto. Cada línea se puede “rotar”
circularmente quitando la primera palabra y poniéndola al final; el programa
imprime todas las rotaciones de todas las líneas, en orden alfabético. Con la
línea Kallpa reserva canchas salen Kallpa reserva canchas,
reserva canchas Kallpa y canchas Kallpa reserva, cada una en su lugar del
orden alfabético junto con las de las otras líneas. Parnas admite que un buen
programador lo haría en una o dos semanas; lo trata como si fuera un sistema
grande para poder discutir el criterio.
Compara dos formas de dividirlo.
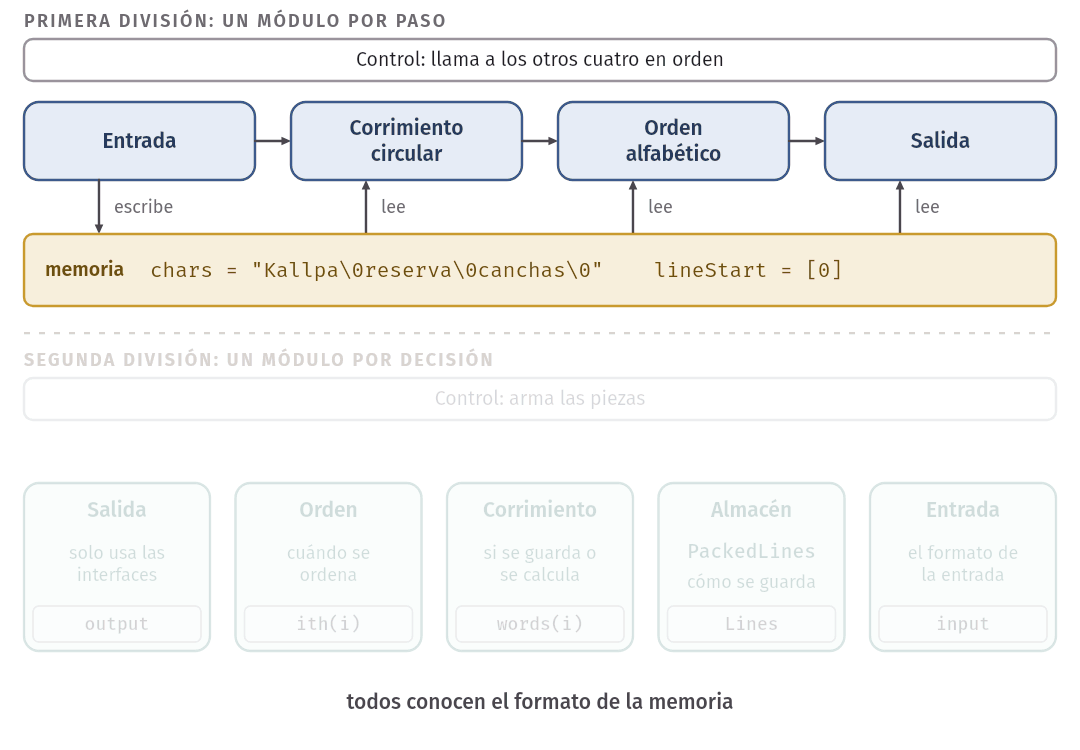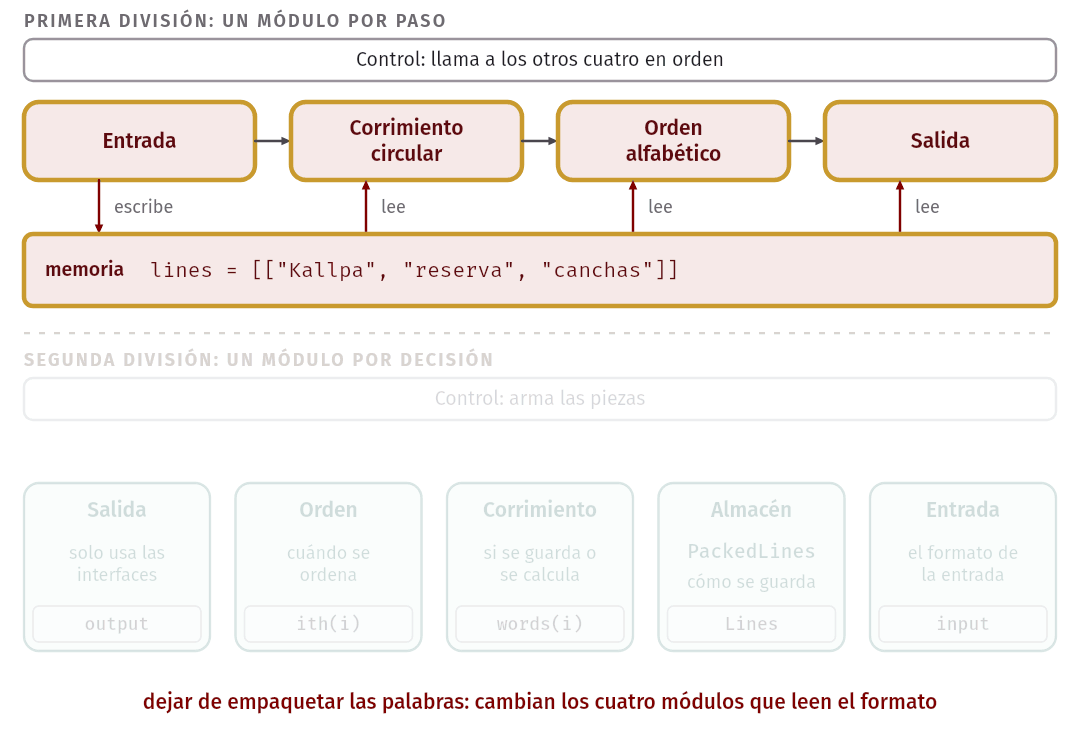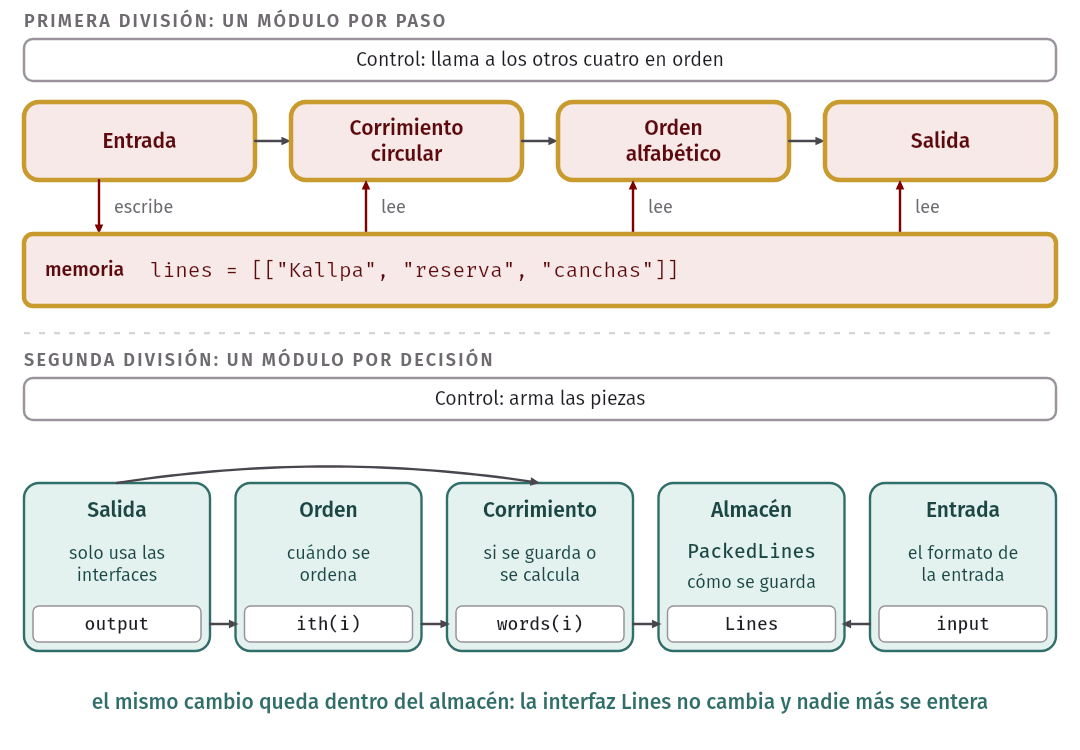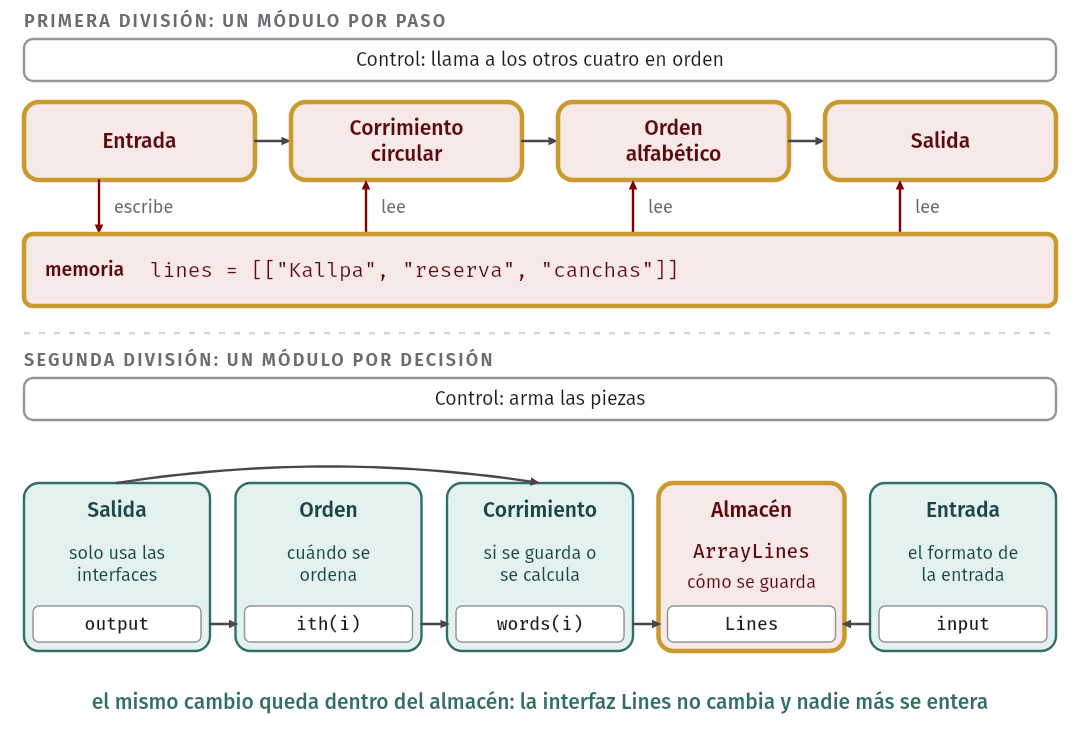
La primera sigue el diagrama de flujo: un módulo por paso del procesamiento. Entrada lee las líneas y las guarda en memoria con un formato compacto (los caracteres empaquetados de a cuatro por palabra de memoria, con un carácter especial al final de cada palabra, y un índice de dónde empieza cada línea). Corrimiento circular arma un índice con un par por rotación: la línea original y la posición donde empieza. Orden alfabético recibe los arreglos de los dos módulos anteriores y produce otro arreglo con los pares ordenados. Salida usa ese arreglo y el de la entrada para imprimir. Control llama a los otros cuatro en orden. Parnas dice que, en experimentos pequeños, esta es aproximadamente la división que propone la mayoría de los programadores.
La segunda divide según las decisiones que cada módulo esconde.
Almacenamiento de líneas ofrece funciones como “el carácter c de la palabra w
de la línea r” y “cuántas palabras tiene la línea r”, y nadie más sabe cómo
están guardadas. Corrimiento circular da la impresión de que existe un
almacén con todas las rotaciones, con las mismas funciones que el de líneas.
Orden alfabético ofrece ITH(i): el índice de la rotación que va en el
lugar i. Entrada, salida y control usan esas interfaces.
Lo primero que dice Parnas al compararlas es que los dos esquemas funcionan. Incluso podrían producir, una vez ensamblado, exactamente el mismo programa: la diferencia no está en el código que corre sino en cómo se reparte el trabajo y en lo que cada módulo necesita saber de los demás. Luego lista cinco decisiones que podrían cambiar:
- El formato de la entrada.
- Guardar todas las líneas en memoria (con muchos datos, no entran).
- Empaquetar los caracteres de a cuatro por palabra de memoria.
- Guardar un índice de las rotaciones en lugar de las rotaciones mismas, o no guardar nada y calcular cada rotación cuando se pide.
- Ordenar todo una vez, en lugar de buscar cada elemento cuando se necesita u ordenar de a poco.
Con la primera división, el cambio 1 queda en un módulo, pero los cambios 2 y 3 obligan a cambiar todos los módulos que leen el formato de la memoria (todos menos el de control, que solo llama a los demás). El cambio 4 toca el corrimiento, el orden y la salida. El cambio 5 es difícil porque la salida espera que el orden esté terminado antes de empezar. Con la segunda división, cada uno de los cinco cambios queda dentro de un solo módulo.
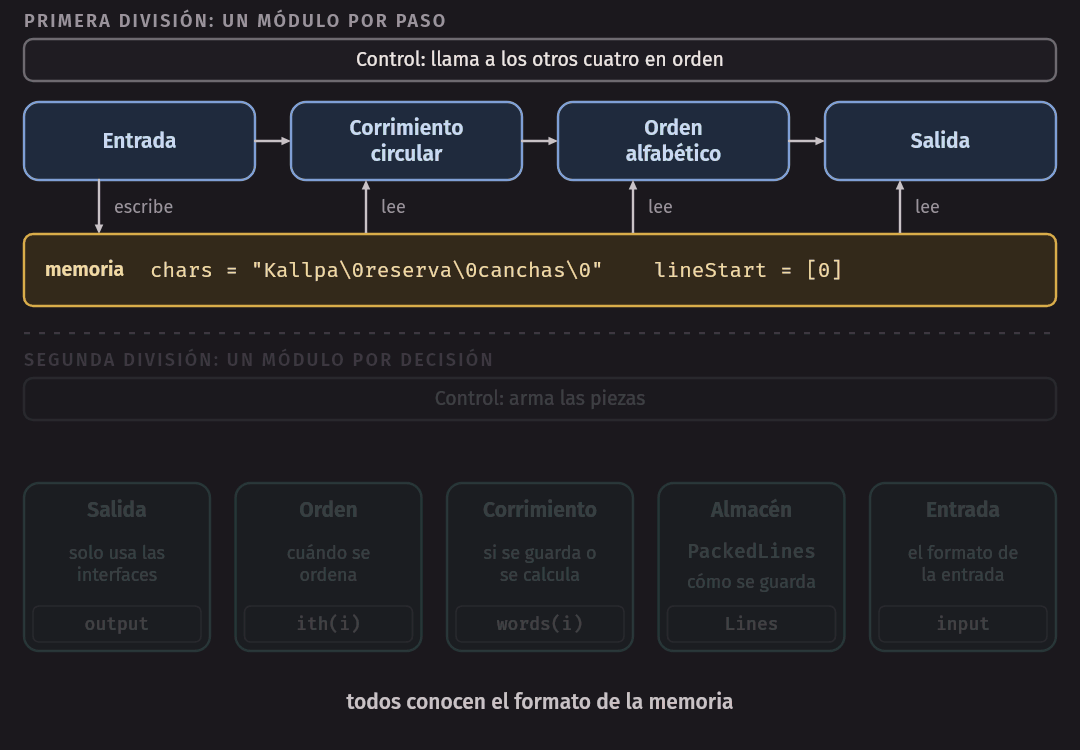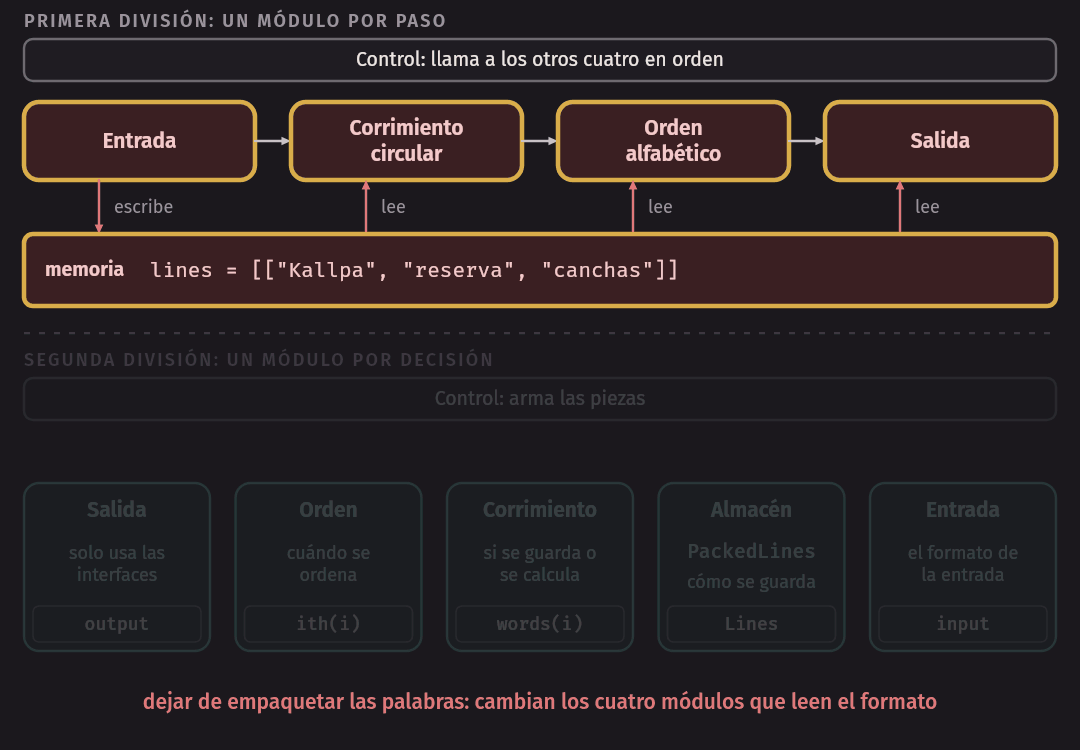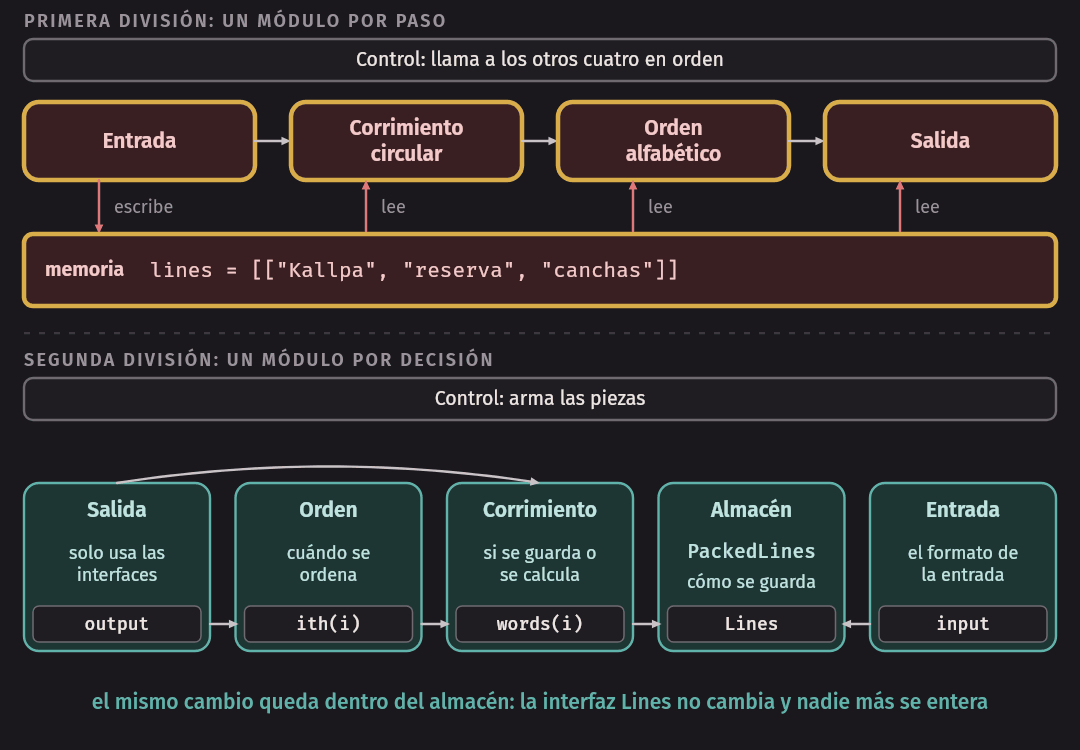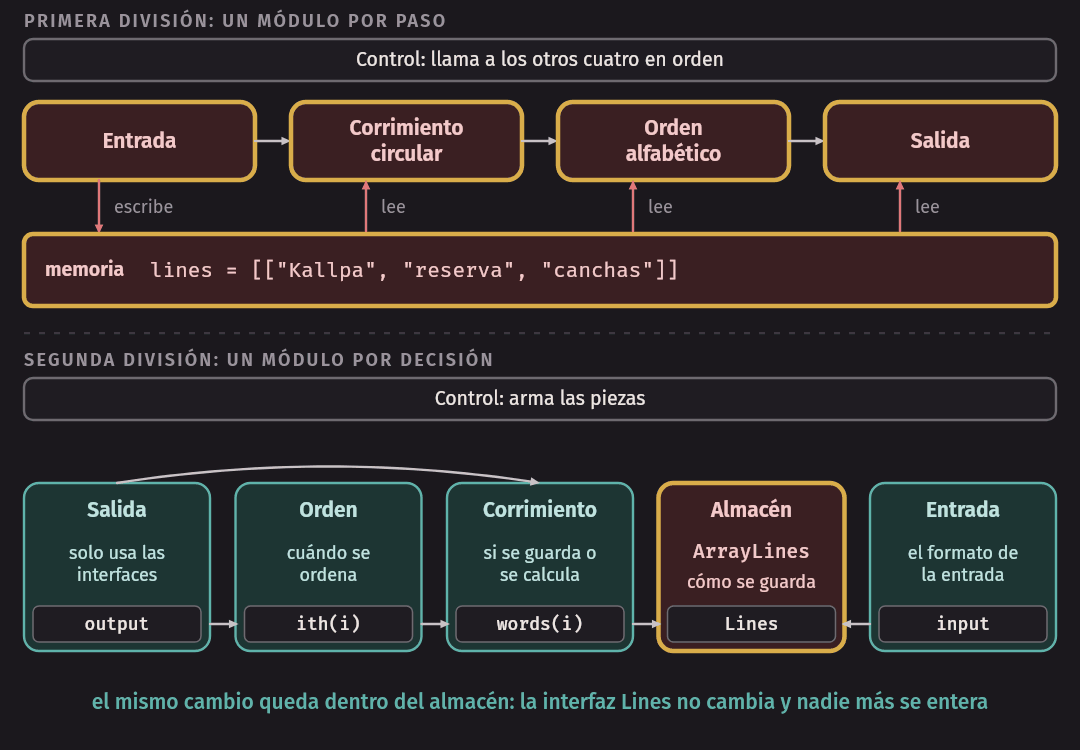
Parnas compara además el desarrollo independiente (en la primera división, los formatos de las tablas son interfaces complejas que todos los equipos tienen que acordar antes de empezar; en la segunda, las interfaces son nombres de funciones y tipos de parámetros) y la comprensibilidad (para entender la salida de la primera división hay que entender algo de todos los demás módulos). Su conclusión es el criterio que se enseña desde entonces (la traducción es nuestra):
casi siempre es incorrecto empezar la descomposición de un sistema en módulos a partir de un diagrama de flujo. Proponemos, en cambio, empezar por una lista de las decisiones de diseño difíciles o que probablemente cambien. Cada módulo se diseña entonces para esconder una de esas decisiones de los demás.
Ese criterio es el ocultamiento de información (information hiding).
KWIC en TypeScript, de las dos formas
La carpeta code/week-05/kwic tiene las dos
divisiones de Parnas en TypeScript, en versión pequeña.
flowchart.ts sigue el diagrama de
flujo: las palabras van en un solo texto, cada una terminada en un carácter
especial END, y un arreglo lineStart dice dónde empieza cada línea. Ese
formato aparece en todo el archivo:
$ grep -n "lineStart\|END" kwic/flowchart.ts
6:// terminada en END; lineStart[i] es dónde empieza la línea i en ese texto.
7:export const END = '\u0000';
9:export type Store = { chars: string; lineStart: number[] };
17:  const lineStart: number[] = [];
19:    lineStart.push(chars.length);
20:    for (const word of line.trim().split(/\s+/)) chars += word + END;
22:  return { chars, lineStart };
28:  store.lineStart.forEach((start, line) => {
29:    const end = store.lineStart[line + 1] ?? store.chars.length;
31:    for (let i = start; i < end - 1; i++) if (store.chars[i] === END) shifts.push([line, i + 1]);
39:  const lineBegin = store.lineStart[line];
40:  const lineEnd = store.lineStart[line + 1] ?? store.chars.length;
42:  return rotated.split(END).filter(Boolean).join(' ');
56:// Módulo 4, salida: vuelve a leer chars y lineStart para imprimir.
La entrada lo escribe (líneas 17 a 22), el corrimiento lo recorre (28 a 31),
y el orden y la salida lo vuelven a leer para rearmar cada rotación (39 a 42).
hiding.ts usa el mismo formato, pero
dentro de una clase:
$ grep -n "u0000\|#chars" kwic/hiding.ts
17:  #chars = '';
23:      starts.push(this.#chars.length);
24:      this.#chars += word + '\u0000';
36:    return this.#chars.slice(start, this.#chars.indexOf('\u0000', start));
Los demás módulos ven solo esto:
// Lo que los demás ven del almacenamiento de líneas.
export type Lines = {
  addLine(words: string[]): void;
  lineCount(): number;
  wordCount(line: number): number;
  word(line: number, w: number): string;
};
Las pruebas de kwic.test.ts comprueban lo
que dice Parnas. Primero, que las dos divisiones dan exactamente la misma
salida, carácter por carácter. Segundo, que cambiar la forma de guardar las
líneas (el cambio 3, dejar de empaquetar las palabras) no cambia la salida:
ArrayLines guarda un arreglo de palabras por línea, implementa la misma
interfaz Lines, y la prueba usa una u otra. Que el cambio quede en un solo
lugar no lo dice la prueba sino el código: ArrayLines es una clase nueva, y
ningún otro archivo cambió para poder usarla. Con flowchart.ts, el mismo cambio obliga a reescribir input,
circularShift y shiftText, la función con la que el orden alfabético y la
salida rearman cada rotación.
▶ índice KWIC
  ✔ lista cada corrimiento circular en orden alfabético (0.774208ms)
  ✔ las dos divisiones en módulos dan exactamente la misma salida (0.460083ms)
  ✔ cambiar cómo se guardan las líneas no cambia la salida (0.357458ms)
✔ índice KWIC (2.896042ms)
Que las dos versiones pasen las mismas pruebas es justamente el punto del capítulo 3 de Ousterhout: el código que funciona no basta. Las pruebas dicen qué hace el programa hoy; no dicen cuánto costará el cambio de mañana.
Idea clave. Para dividir un sistema en módulos, no partan de los pasos del procesamiento (“leer, validar, guardar”). Partan de la lista de decisiones difíciles o que probablemente cambien, y hagan que cada módulo esconda una. Dos divisiones pueden dar el mismo programa y costar muy distinto de cambiar.
¿Qué decisión esconde cada módulo de Kallpa?
La pregunta de Parnas es una buena herramienta para leer código ajeno. Para varios módulos de Kallpa la respuesta es clara:
| Módulo | Decisión que esconde |
|---|---|
domain/clock.ts |
Cómo se pasa de un instante a la fecha y hora de Lima |
domain/calendar.ts |
Que las fechas son texto 'YYYY-MM-DD' y que las cuentas se hacen en UTC |
domain/pricing.ts |
Las tarifas por deporte, cuándo es hora punta y cómo se aplica el descuento |
notifications/notifier.ts |
Por qué canal se avisa (hoy, la consola; mañana, WhatsApp) |
store/database.ts |
El esquema, las migraciones y el PRAGMA de las claves foráneas |
http/router.ts |
Cómo se emparejan las rutas con parámetros como :id |
La tabla no dice que esos módulos sean perfectos, solo que cada uno tiene una
respuesta. Para otros, la respuesta no es tan clara, y ese es el trabajo del
laboratorio: ¿qué esconde el módulo de src/services/? ¿Y handlers.ts, que
debería esconder solo cómo se traduce HTTP?
Abstracción que se filtra
Hay filtración de información (information leakage, capítulo 5 de Ousterhout) cuando la misma decisión de diseño se refleja en varios módulos. Cambiarla obliga a tocarlos todos, y por eso es lo contrario del ocultamiento.
La filtración puede estar a la vista, en una interfaz: si un repositorio
devuelve filas con los nombres de las columnas (returned_at, item_id) y
esas filas llegan hasta el handler, la interfaz del repositorio filtró el
esquema de la base de datos. Renombrar una columna toca el repositorio y cada
lugar que usa la fila. La forma peor es la filtración por la puerta de
atrás: dos módulos que dependen de la misma decisión sin que ninguna interfaz
lo muestre. El lector y el escritor de un formato de archivo que lo conocen
cada uno por su lado son el ejemplo típico: si alguien cambia el escritor, el
compilador no dice nada y el lector falla en producción.
Ejemplos frecuentes:
- Los nombres de las columnas de una tabla que llegan hasta la respuesta HTTP, o hasta el código que la arma.
- Un formato (de archivo, de fecha, de mensaje) que conocen por separado quien lo produce y quien lo consume.
- Una regla del negocio que cada llamador aplica por su cuenta porque la función que consulta los datos devuelve de más: “acuérdense de filtrar las canceladas”.
- Un tipo de error de una capa (por ejemplo, un
HttpError) que se lanza desde otra capa que no debería saber de HTTP.
En el préstamo de implementos de la sección anterior, la versión superficial
filtra el esquema (los handlers leen returned_at) y la regla del préstamo
abierto (cuatro copias). La versión profunda tiene las dos cosas dentro de
Loans.
Error común. Creer que declarar los campos como privados es ocultar información. Si la clase tiene un getter y un setter por cada campo privado, quien la usa sigue conociendo la representación: solo cambió la sintaxis. Ocultar es que la interfaz no deje ver la decisión, no que el campo tenga
#delante.
Descomposición temporal
Una forma muy común de filtración es la descomposición temporal (temporal decomposition): dividir el código según el orden en que pasan las cosas, en lugar de según lo que cada parte sabe. Es la primera división de Parnas otra vez. El ejemplo de Ousterhout es una aplicación que lee un archivo, lo modifica y lo vuelve a escribir, con una clase para cada paso: la clase que lee y la que escribe conocen el formato del archivo, así que el formato se filtra entre dos módulos. La solución es juntar lectura y escritura en un módulo que sepa el formato.
El orden de los pasos importa al escribir una función (“primero se revisa que el implemento exista, después que esté libre”), pero no es un buen criterio para separar módulos. Cuando diseñen, pregúntense qué conocimiento necesita cada paso, no en qué momento corre.
Con IA. Cuando se le pide a un agente “agrega validación del campo X”, lo más probable es que la agregue en el lugar más cercano a donde entra el dato, aunque la regla ya exista en otro lado. El resultado funciona y filtra la regla en un lugar más. Antes de aceptar el cambio, busquen con
grepsi la regla ya estaba escrita (por su nombre o por su valor), y pídanle que use esa.
Conceptos: el diseño que ve el usuario
Hasta aquí hablamos de módulos de código. Daniel Jackson propone mirar un nivel más arriba: antes de decidir los módulos del código, decidir los conceptos de la aplicación. Si la funcionalidad está bien dividida para el usuario, esa división se puede llevar al código; si está enredada para el usuario, ningún diseño interno la desenreda del todo.
Qué es un concepto
Un concepto, para Jackson, es una unidad de funcionalidad que el usuario reconoce y que tiene sentido por sí sola. Su ejemplo es explicarle Twitter a alguien que nunca lo usó: le hablarían de los conceptos tweet, seguidor, hashtag, like. Cada concepto se describe con cuatro cosas:
- Un propósito: para qué existe. Es la justificación del concepto.
- Un estado: lo que el concepto recuerda.
- Unas acciones: lo que se puede hacer, que leen y cambian el estado.
- Un principio operacional: el escenario típico que muestra cómo el concepto cumple su propósito.
Tres aclaraciones de los tutoriales de Jackson evitan malentendidos:
- Un concepto no es una funcionalidad cualquiera (feature). Una funcionalidad suele definirse como un cambio a otra cosa que ya existe y no se puede entender sola. Un concepto es independiente: se entiende sin los demás y se puede llevar de una aplicación a otra. Por eso aprender una aplicación nueva es fácil cuando ya conocemos sus conceptos de otras.
- Un concepto no es una clase. Jackson dice explícitamente que la comparación con las clases lo confunde: una clase define una colección de objetos, mientras que un concepto suele involucrar varias colecciones y las relaciones entre ellas (el concepto seguidor involucra a los usuarios que se siguen y a lo que publican). Su comparación preferida es un servicio muy pequeño, que da valor por sí mismo.
- Los conceptos son genéricos: reserva funciona igual para canchas, mesas de restaurante o salas de reuniones. Las reservas de restaurante, nos recuerda Jackson, son un invento de fines del siglo XIX que el software solo copió.
El principio operacional
El principio operacional se escribe como una pequeña historia con la forma “si se hacen estas acciones, entonces pasa esto, que cumple el propósito”. El ejemplo de Jackson es el servicio de préstamos de su red de bibliotecas: si pido un libro, cuando esté disponible en mi biblioteca me llega un correo avisando que lo puedo recoger.
No es un caso de uso. Los casos de uso buscan especificar todos los caminos, también los de error; un principio operacional describe solo el escenario esencial, el que explica por qué el concepto existe. La papelera de reciclaje, otro ejemplo de Jackson, tiene dos: si borro un archivo, lo puedo recuperar sacándolo de la papelera; si borro un archivo y vacío la papelera, el archivo desaparece y su espacio se puede reusar. El primero muestra el propósito real de la papelera, que no es borrar sino permitir deshacer un borrado.
Para el concepto reserva de Kallpa, la guía de la semana da el principio operacional: si reservo la cancha de 19:00 a 21:00, a esa hora la cancha es mía y nadie más la puede reservar. El propósito es asegurar el uso exclusivo de un recurso durante un tiempo.
El propósito
Jackson da tres criterios para un buen propósito: que esté centrado en una necesidad del usuario (el propósito de un like no es “expresar aprobación”, que no le sirve a nadie, sino ordenar contenido con la aprobación de muchos); que sea específico del concepto (“aumentar los usuarios” vale para cualquier concepto y no dice nada); y que sea evaluable, que sirva para medir si el diseño lo cumple.
Y una regla más fuerte: un concepto debería tener un solo propósito. Su ejemplo es la reacción de Facebook, que sirve a la vez para decidir qué publicaciones mostrar y para mandarle una emoción al autor. Como los dos propósitos están pegados, no se puede hacer uno sin el otro: marcar “me enoja” en una publicación cuenta como un voto a favor de que se muestre más. Un concepto con dos propósitos, o un propósito repartido entre dos conceptos, son señales de mal diseño.
En el tutorial de modularidad, Jackson resume las condiciones en tres: especificidad (un propósito, que da valor de verdad, sin mezclar otros), completitud (el concepto cumple su propósito entero, sin depender de otro para eso) e independencia (se entiende sin hacer referencia a otros conceptos).
Kallpa como conjunto de conceptos
Con esas herramientas se puede describir Kallpa sin hablar de tablas ni de endpoints:
| Concepto | Propósito | Principio operacional |
|---|---|---|
| Reserva | Asegurar el uso exclusivo de una cancha durante unas horas | Si reservo de 19:00 a 21:00, a esa hora la cancha es mía y nadie más la puede reservar |
| Membresía | Premiar con un descuento a quien paga la cuota mensual | Si soy socio, mis reservas cuestan 10 % menos que las de un vecino regular |
| Tarifa con hora punta | Cobrar más las horas que todos quieren | Si reservo una hora de fulbito un martes a las 10:00 pago S/ 90; a las 19:00, S/ 112.50 |
| Cancelación con plazo | Dejar que quien reservó se arrepienta sin que la cancha quede vacía a último momento | Si reservé para las 19:00 y cancelo hasta las 16:00, la cancha vuelve a estar libre; desde las 16:01, ya no puedo cancelar |
| Notificación | Que quien reserva tenga la confirmación sin entrar a la página | Si reservo, me llega un mensaje con la cancha, la hora y el total |
Cada uno se entiende sin los demás. Tarifa con hora punta tiene sentido en un estacionamiento; cancelación con plazo, en una aerolínea; notificación, en cualquier tienda en línea. Se combinan con sincronizaciones: cuando se confirma una reserva, se calcula su precio con la tarifa y la membresía, se registra su plazo de cancelación y se envía una notificación.
El ejercicio también sirve para encontrar problemas. El tipo Member de Kallpa
(src/domain/member.ts) tiene name, phone y plan. El nombre y el
celular sirven para saber quién reserva y cómo avisarle; el plan sirve para el
descuento. Son dos propósitos: un concepto de registro de vecinos y uno de
membresía, juntos en un mismo tipo. Hoy no molesta. Si mañana el complejo
quiere que un vecino sea socio solo de vóley, o que los socios tengan una fecha
de vencimiento, el cambio va a tocar algo que también usa el aviso por
WhatsApp.
Conceptos en código
La carpeta code/week-05/concepts tiene una
implementación posible de tres conceptos, cada uno en su archivo, con el
propósito, el principio, el estado y las acciones como comentario al inicio.
reservation.ts empieza así:
// concepto Reserva [Recurso, Usuario]
//
// propósito  asegurar a alguien el uso exclusivo de un recurso durante un
//            tiempo
// principio  si reservo un recurso para un bloque de horas, en esas horas el
//            recurso es mío: nadie más lo puede reservar; si cancelo, el
//            bloque vuelve a estar libre
// estado     reservas: Id -> (recurso, usuario, día, desde, hasta, activa)
// acciones   reserve(usuario, recurso, día, desde, hasta) -> Id | ocupado
//            cancel(id)
//            holder(recurso, día, hora) -> Usuario | nadie
La clase es genérica en el recurso y en el usuario (Reservation<R, U>): no
sabe qué es una cancha ni qué es un vecino. Los otros dos conceptos,
deadline.ts (el plazo de
cancelación) y notification.ts,
tampoco saben de reservas. Solo app.ts
los conoce a los tres y los sincroniza:
//   cuando Reserva.reserve(u, cancha, bloque) devuelve id
//     entonces Plazo.register(id, inicio del bloque)
//          y   Notificación.notify(u, "reserva confirmada")
//   cuando alguien pide cancelar id
//     si Plazo.stillOpen(id, ahora) entonces Reserva.cancel(id)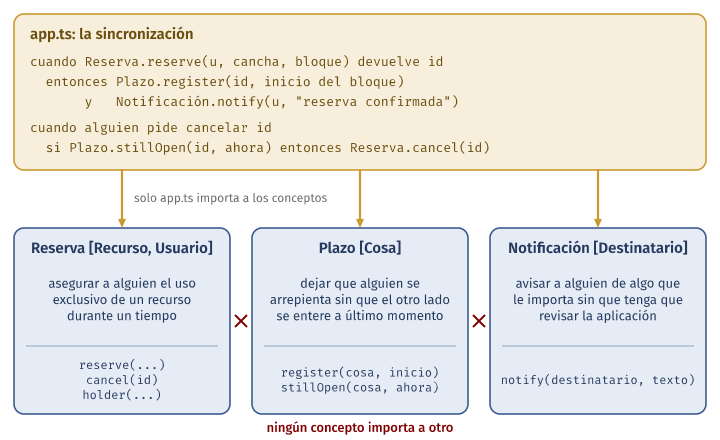
Los principios operacionales son, además, buenas pruebas: describen el
comportamiento esencial con una historia corta.
concepts.test.ts escribe cada uno como
una prueba, y agrega una que revisa la independencia: ningún archivo de
concepto importa nada.
▶ principios operacionales
  ✔ Reserva: si reservo de 19 a 21, a esa hora nadie más puede reservar; si cancelo, queda libre (0.771541ms)
  ✔ Reserva es genérica: sirve igual para la parrilla del club (0.08975ms)
  ✔ Plazo: con 3 horas de aviso, a las 15:00 se deshace algo de las 18:00; a las 15:01, ya no (0.114625ms)
✔ principios operacionales (2.074708ms)
▶ la aplicación: tres conceptos y sus sincronizaciones
  ✔ al reservar se avisa; al cancelar a tiempo se libera la cancha (0.210292ms)
  ✔ ningún concepto importa a otro (1.96175ms)
✔ la aplicación: tres conceptos y sus sincronizaciones (2.286291ms)
Esta división en archivos es una forma de llevar los conceptos al código, no la única. Lo que importa es la propiedad, no la carpeta: cada concepto se entiende y se prueba solo, y las reglas que los combinan están escritas en un lugar visible.
Turnos fijos: ¿concepto nuevo o forma de usar reserva?
En la semana 3 entrevistaron a Doris, de la administración, sobre los turnos fijos: equipos que juegan todas las semanas el mismo día a la misma hora. En la semana 4 vieron dos alternativas para guardarlos: una regla de repetición que calcula las fechas al vuelo, o todas las reservas de la temporada creadas de una vez. Antes de esa decisión hay otra, de concepto: ¿un turno fijo es un concepto nuevo, o solo una forma de usar reserva muchas veces?
Las preguntas de Jackson ayudan a decidir:
- ¿Tiene un propósito propio? Si el propósito es solo “ahorrarse hacer diez reservas”, es una comodidad sobre reserva (un botón “repetir”). Si es “asegurar a un equipo su horario de toda la temporada, aunque otros quieran esa hora”, es otro propósito, y probablemente otro concepto.
- ¿Tiene un principio operacional distinto? Por ejemplo: “si un equipo tiene turno fijo los jueves a las 20:00, cada jueves la cancha es suya sin tener que reservar; si un jueves no viene, avisa y esa fecha queda libre, pero el turno sigue”. Ese “esa fecha queda libre, pero el turno sigue” no es algo que reserva sepa hacer.
- ¿Tiene estado y acciones propios? Un turno fijo tiene una regla (día, hora, cancha, desde cuándo, hasta cuándo), y acciones como crear, saltar una fecha o terminar el turno.
La respuesta cambia el resto del diseño. Si es una forma de usar reserva, el modelo de datos no cambia y cancelar una fecha es cancelar una reserva cualquiera, con el mismo plazo de 3 horas. Si es un concepto nuevo, necesita su propia tabla, sus propios endpoints y sus propias reglas: ¿saltar una fecha también tiene plazo? ¿El precio es el de cada hora o hay un precio por temporada? ¿Qué pasa si alguien ya tenía reservada una de esas fechas cuando se creó el turno? Las respuestas las tiene la cliente, no el código. Por eso conviene decidirlo antes de programar, y escribir la decisión en el design doc del proyecto, con la alternativa descartada.
Idea clave. Un concepto es una unidad de funcionalidad con un propósito, un estado, unas acciones y un principio operacional (“si…, entonces…”). Cada concepto se entiende solo; los conceptos se combinan con sincronizaciones. Un concepto con dos propósitos, o un propósito repartido en dos conceptos, es una señal de mal diseño.
Con IA. Un agente puede ayudar a hacer el inventario de conceptos de una aplicación a partir del código o de la documentación. Lo que conviene revisar es lo que suele salir mal: propósitos que repiten el nombre del concepto (“el propósito de Reserva es reservar”), principios operacionales que en realidad mezclan tres conceptos, y conceptos que son pantallas o tablas en lugar de unidades de funcionalidad. Comparen cada propósito con los tres criterios de Jackson.
Acoplamiento y cohesión
Dos medidas de lo mismo
El acoplamiento (coupling) mide cuánto obliga un cambio en un módulo a cambiar otro. La cohesión (cohesion) mide cuánto pertenecen juntas las partes de un módulo. Los dos términos vienen del diseño estructurado de los años setenta (Stevens, Myers y Constantine los presentaron en 1974, en el IBM Systems Journal) y la recomendación clásica es bajo acoplamiento y alta cohesión.
No son ideas distintas de las de la primera parte. Un módulo profundo que esconde una decisión tiene alta cohesión (todo lo que sabe esa decisión está adentro) y bajo acoplamiento (los demás no dependen de la decisión). La medida es también la misma: ¿cuánto cuesta el cambio que de verdad va a pasar? Dos módulos que nunca cambian pueden estar muy acoplados sin que eso le cueste a nadie.
Para la cohesión se usa mucho una heurística de Robert C. Martin: un módulo debería tener una sola razón para cambiar. No es la definición, pero ayuda a revisarla: si se imaginan los cambios que el cliente va a pedir y un mismo archivo cambia por motivos que no tienen nada que ver (porque cambió una tarifa y porque cambió el formato de una respuesta HTTP), ese archivo junta dos cosas.
Formas de acoplamiento
El diseño estructurado ordenó las formas de acoplamiento de la más dañina a la menos. La guía de la semana usa estas cinco:
-
Depender de los detalles internos de otro módulo (acoplamiento de contenido): leer sus campos, consultar sus tablas, contar con el orden en que hace las cosas por dentro. Cualquier cambio interno lo rompe.
-
Compartir estado global (acoplamiento común): dos módulos leen y escriben la misma variable global, el mismo archivo o la misma tabla. Si uno cambia lo que guarda, el otro falla sin que su código haya cambiado. Llamar a
new Date()en cualquier parte es una forma de depender de un estado global, el reloj de la computadora; Kallpa lo evita pasando unClockcomo dependencia. -
Pasar banderas que deciden qué hace la función que se llama (acoplamiento de control): quien llama tiene que saber cómo está escrita la función por dentro. Un ejemplo escrito para la clase:
// Quien llama decide qué hace la función: tiene que saber que existen
// dos caminos y cuándo usar cada uno.
function bookings(courtId: number, date: string, includeCancelled: boolean): Booking[]
Si casi todos los llamadores pasan
false, lo que hay en realidad son dos operaciones con dos nombres (las reservas que ocupan la cancha, y el historial completo), y la bandera las junta. -
Pasar estructuras enteras cuando se usa un campo (acoplamiento por estampado, stamp coupling): la función depende de la forma completa de la estructura, aunque solo lea una parte. Si la estructura cambia, hay que revisar la función.
-
Pasar solo los datos necesarios (acoplamiento de datos): la forma más débil y la deseable.
Kallpa tiene buenos ejemplos de la última forma en su dominio. La función que decide si una reserva se puede cancelar no recibe una reserva entera, sino solo lo que usa:
export function isCancellableAt(slot: Pick<TimeSlot, 'date' | 'startHour'>, now: LimaTime): boolean {
  return minutesUntilStart(slot, now) >= CANCELLATION_NOTICE_HOURS * 60;
}
Y el cálculo del precio recibe el plan del vecino (plan: MemberPlan), no el
vecino con su nombre y su celular. Por eso esas funciones se prueban con
objetos de dos campos y no cambian si mañana Booking o Member ganan un
campo.
Acoplamiento oculto
El acoplamiento también puede estar oculto: dos módulos que tienen que cambiar
juntos porque comparten un supuesto que no está escrito en ninguna interfaz.
Kallpa tiene uno, y lo documenta. En src/domain/court.ts:
// Deportes que se juegan en el complejo. Estos textos son los que se guardan
// en la base de datos y los que viajan en la API.
export const SPORTS = ['fulbito', 'voley', 'basquet'] as const;
Y en la primera migración de src/store/database.ts:
sport TEXT NOT NULL CHECK (sport IN ('fulbito', 'voley', 'basquet'))La lista de deportes está en dos lugares. ¿Habría que hacer que la migración
use la constante? No, y el porqué es instructivo. Una migración es un registro
histórico: describe cómo era el esquema cuando se aplicó, y Kallpa la protege
con una regla escrita en el mismo archivo (nunca se edita una migración que ya
corrió). Si la migración leyera SPORTS, agregar 'tenis' a la constante
cambiaría lo que hace una migración vieja en las bases de datos nuevas, pero no
en las que ya existen. Agregar un deporte exige una migración nueva de todas
formas. La duplicación es deliberada; el comentario de court.ts hace visible
el acoplamiento para que nadie lo descubra por accidente.
Error común. Tratar todo acoplamiento como un defecto. Un módulo sin dependencias no sirve para nada. El objetivo es que las dependencias sean pocas, evidentes y hacia cosas estables, y que las que tienen que existir (como la de
SPORTSy la migración) estén escritas donde se las vea.
DRY es sobre conocimiento, no sobre texto
Andy Hunt y Dave Thomas formularon el principio DRY (don’t repeat yourself) en The Pragmatic Programmer (1999): cada pieza de conocimiento debe tener una representación única, sin ambigüedad y con autoridad dentro del sistema. La palabra importante es conocimiento. En la edición de 2019 los autores insisten en que muchos lo leyeron como “no copies código”, y que no es eso.
Dos consecuencias, una para cada lado:
-
Código parecido que representa reglas distintas no se junta. En
src/domain/booking.tshay dos constantes que valen lo mismo:export const MAX_HOURS_PER_BOOKING = 3; export const CANCELLATION_NOTICE_HOURS = 3;Son dos reglas del complejo que coinciden hoy por casualidad. Reemplazarlas por una sola constante
THREE_HOURSsería una abstracción falsa: el día que la junta decida que las reservas pueden durar 4 horas, cambiaría también el plazo de cancelación sin que nadie lo pidiera. -
Una regla escrita en varios lugares sí es un problema, aunque cada copia se vea distinta. En el préstamo de implementos,
l.returned_at === null,!l.returned_aty el SQLreturned_at IS NULLson tres textos distintos para un solo conocimiento. En Kallpa,grep -rn "confirmed" srces un buen comienzo para buscar una regla parecida; lo harán en el laboratorio.
Un caso de repetición literal en Kallpa: la validación del parámetro ?date=
está copiada, con el mismo mensaje, en el handler de la disponibilidad y en el
de la caja del día. Es una sola regla (la fecha de una consulta tiene el
formato AAAA-MM-DD), así que juntarla en una función está bien. Lo haremos
como ejemplo de refactoring más adelante.
Error común. Juntar código solo porque se parece. Si dos funciones con el mismo código de tres líneas representan reglas distintas, la función común las acopla: el día que una regla cambie, alguien va a tener que separarlas de nuevo o agregar un parámetro booleano para distinguirlas (y ya vimos qué es eso). Antes de juntar, pregúntense: si cambia la regla de una, ¿tiene que cambiar la otra?
Juntar o separar
El capítulo 9 de Ousterhout (Better Together Or Better Apart?) da criterios para decidir si dos trozos de código van en el mismo módulo:
- Se juntan si comparten información (los dos conocen el mismo formato o la misma regla), si siempre se usan juntos, si se superponen conceptualmente o si es difícil entender uno sin mirar el otro. Juntarlos también se justifica cuando simplifica la interfaz o elimina una duplicación.
- Se separa el código de propósito general del código de un caso
particular. En Kallpa,
overlaps(dos bloques se cruzan si cada uno empieza antes de que el otro termine) es de propósito general y vive en el dominio; la decisión de responderSLOT_TAKENcuando una reserva nueva se cruza con una confirmada es de un caso particular.
El mismo capítulo advierte contra partir funciones solo por su largo: una función larga con una sola responsabilidad clara puede ser más fácil de leer que tres cortas que hay que leer juntas para entender cualquiera de ellas. Ousterhout las llama métodos siameses (conjoined methods): si para entender una hay que leer la otra, no tenía sentido separarlas.
La dirección de las dependencias
El último criterio de la semana es hacia dónde apuntan las dependencias. En
Kallpa, http usa services, services usa store, y domain, donde están
las reglas del negocio, no depende de nada. Gracias a eso, las pruebas de
test/booking.test.ts y test/pricing.test.ts llaman a las reglas
directamente, sin base de datos ni servidor HTTP.
En lugar de creer el diagrama, se puede medir.
layers.ts lee los import de cada archivo de
kallpa/src con el compilador de TypeScript, agrupa por carpeta y avisa si
alguna dependencia va de una capa de abajo a una de arriba:
$ make capas
node layers.ts ../../kallpa/src
(raíz) → http             1 import
(raíz) → store            4 imports
(raíz) → domain           2 imports
http → services           2 imports (1 solo tipos)
http → notifications      2 imports (1 solo tipos)
http → store              1 import (solo tipos)
http → domain             6 imports
services → store          3 imports
services → domain         2 imports (solo tipos)
notifications → domain    1 import
store → domain            6 imports (4 solo tipos)
Ninguna dependencia va hacia arriba.
domain no aparece a la izquierda de ninguna flecha: no importa nada de otra
capa. Ninguna dependencia va hacia arriba. La tabla muestra también cosas que
el resumen de una línea no dice: store usa los tipos del dominio
(Court, Member), http usa domain directamente en seis imports, y hay
una flecha http → store que importa un tipo. ¿Qué tipo es, y qué le dice a
la capa HTTP sobre la base de datos? Esa es una de las preguntas del
laboratorio.
layers.test.ts convierte la propiedad en
prueba: falla si el dominio importa algo de otra capa, si store o domain
importan algo de http, o si alguna dependencia va hacia arriba. Y para
comprobar que la prueba sirve, arma en una carpeta temporal un dominio que
importa HttpError y verifica que lo detecta. Una dependencia al revés, como
un archivo del dominio que lanza un HttpError, rompe justamente la propiedad
que permite probar las reglas sin HTTP.
En la industria. En proyectos grandes, la dirección de las dependencias no se cuida con buena voluntad sino con herramientas que fallan el build. Software Engineering at Google, cap. 18 (Build Systems and Build Philosophy), describe cómo en Bazel cada módulo declara sus dependencias de forma explícita, de modo que usar algo que no se declaró es un error del build y no un comentario en una revisión. En JavaScript y TypeScript hay herramientas que revisan reglas de este tipo sobre los imports;
layers.test.tses una versión mínima de la misma idea.
Refactorizar sin cambiar el comportamiento
Qué es un refactoring
Martin Fowler define el refactoring como una técnica disciplinada para reestructurar un código existente, cambiando su estructura interna sin cambiar su comportamiento externo. Su corazón, dice en refactoring.com, es una serie de transformaciones pequeñas que preservan el comportamiento: cada una hace poco, pero una secuencia de ellas puede reestructurar mucho. Como cada paso es pequeño, es difícil que salga mal, y el sistema sigue funcionando después de cada uno.
Las dos mitades de la definición importan igual. Cambiar la estructura: si nada mejora en el diseño (un módulo más profundo, una regla en un solo lugar, una dependencia menos), no vale la pena el riesgo. Sin cambiar el comportamiento: un refactoring que además corrige un error, agrega un campo o cambia un mensaje ya no es un refactoring, y mezclar los dos cambios hace imposible revisarlos. Fowler cuenta que Kent Beck lo explica con la imagen de dos sombreros: mientras se agrega funcionalidad no se reestructura, y mientras se reestructura no se agrega funcionalidad; se puede cambiar de sombrero muchas veces en una hora, pero hay que saber cuál se tiene puesto.
Qué cuenta como comportamiento
El comportamiento externo de Kallpa es lo que ve quien la usa: las respuestas de la API (códigos, cuerpos, mensajes de error), lo que queda guardado en la base de datos y los avisos por WhatsApp. La forma de las funciones internas no es comportamiento; el texto de un mensaje de error, sí, porque alguien puede estar mostrándolo en su aplicación. Es la ley de Hyrum de la semana 1: con suficientes usuarios, todo lo observable termina siendo una dependencia de alguien.
Un refactoring pequeño, paso a paso
La validación de ?date= está copiada en dos handlers de
src/http/handlers.ts. El refactoring “extraer función” la deja en un solo
lugar. Está en refactor-fecha.diff:
@@ -59,10 +59,7 @@
 export function courtAvailability(deps: AppDependencies): Handler {
   return ({ res, url, params }) => {
     const courtId = Number(params.id);
-    const date = url.searchParams.get('date');
-    if (!isValidDate(date)) {
-      throw new HttpError(400, 'INVALID_DATE', 'Indiquen la fecha con el formato AAAA-MM-DD (?date=2026-03-14).');
-    }
+    const date = requireDate(url);
     const taken = deps.service.bookingsForCourt(courtId, date).filter((b) => b.status === 'confirmed');
El otro handler cambia igual, y al final del archivo aparece la función:
// La fecha de la consulta (?date=AAAA-MM-DD): la piden la disponibilidad y la
// caja del día.
function requireDate(url: URL): string {
  const date = url.searchParams.get('date');
  if (!isValidDate(date)) {
    throw new HttpError(400, 'INVALID_DATE', 'Indiquen la fecha con el formato AAAA-MM-DD (?date=2026-03-14).');
  }
  return date;
}
El mensaje queda idéntico, letra por letra: cambiarlo “aprovechando” sería
cambiar el comportamiento. make refactor aplica el diff a una copia de
Kallpa en build/refactor, corre su make check y revisa que test/ no haya
cambiado:
$ make refactor
...
 src/http/handlers.ts | 20 ++++++++++++--------
 1 file changed, 12 insertions(+), 8 deletions(-)
make --no-print-directory -C build/refactor check
tsc -p .
eslint .
node --test "test/**/*.test.ts"
...
ℹ tests 40
ℹ suites 6
ℹ pass 40
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 170.653917
...
test/ sin cambios
Ese es el ciclo de todo refactoring: un paso pequeño, make check, un commit.
Si make check falla, se deshace el paso (con git restore o git checkout)
en lugar de “arreglar hacia adelante”, porque el paso era pequeño y se puede
volver a intentar mejor.
Pruebas en verde no prueban que nada cambió
La regla del laboratorio es que make check pase al final sin tocar nada en
test/. Es una regla necesaria, pero no suficiente: las pruebas solo
comprueban lo que alguien pensó en comprobar. Si un comportamiento no tiene
prueba, un refactoring lo puede cambiar con todo en verde.
Error común. Concluir “el refactoring no cambió nada porque las pruebas pasan”. Las pruebas de Kallpa no cubren todos los códigos de error de la tabla del README ni todos los órdenes en que se revisan las reglas (por ejemplo, qué error sale si la cancha y el miembro no existen a la vez). Antes de mover una regla, miren qué pruebas la cubren; si no hay ninguna, comparen a mano, con
curl, la respuesta de antes y la de después.
Michael Feathers llama prueba de caracterización (characterization
test, en Working Effectively with Legacy Code, 2004) a una prueba que no
dice qué debería hacer el código, sino qué hace hoy, para poder cambiarlo
sin cambiar eso. loans.test.ts es una: manda el mismo guion a las dos
versiones del préstamo de implementos y exige respuestas idénticas. Para un
refactoring grande en Kallpa, un guion de curl que recorra los casos de error
de la tabla del README y guarde las respuestas en un archivo, corrido antes y
después, es una red de seguridad barata: diff antes.txt despues.txt debería
salir vacío.
Si encuentran un error, no lo corrijan aquí
Al reestructurar un módulo es común encontrar algo que parece un error. La tentación es arreglarlo de paso. No lo hagan en el mismo cambio: abran un issue con la evidencia, terminen el refactoring y arreglen el error en otro pull request, con su propia prueba. Hay dos razones. La primera es que el revisor tiene que poder comprobar que el refactoring no cambia nada, y un arreglo mezclado lo impide. La segunda es que “parece un error” no siempre lo es: a veces es una regla del negocio que nadie documentó, y hay que preguntarle al cliente.
Con IA. Los agentes son rápidos para los refactorings mecánicos (renombrar, extraer una función, mover un archivo) y es justo ahí donde conviene usarlos. Lo que hay que revisar siempre: que no hayan tocado
test/(git diff --stat -- testdebería salir vacío), que no hayan “arreglado” algo de paso, que los mensajes de error sigan idénticos y que el módulo nuevo sea profundo y no una capa más que reenvía. Un cambio como los que suele proponer un agente cuando se le pide “mejorar el diseño” de un servicio superficial es agregar una interfaz y una clase que la implementa, con los mismos métodos: el número de archivos crece y el módulo sigue sin esconder nada.
El laboratorio: refactorizar un módulo superficial de Kallpa
El laboratorio aplica todo el capítulo a Kallpa, en parejas, en una rama nueva de su copia. La guía completa está en la guía de la semana; aquí van los puntos que más cuestan.
Medir antes de cambiar. El paso 1 pide dos números. En la Kallpa
publicada (make medir los saca de una copia en build/kallpa):
$ make medir
...
cd build/kallpa && wc -l src/http/handlers.ts src/services/*.ts
 197 src/http/handlers.ts
  59 src/services/booking-service.ts
 256 total
cd build/kallpa && grep -n "from " src/http/handlers.ts
11:} from '../domain/booking.ts';
12:import { isValidDate } from '../domain/calendar.ts';
13:import { limaTime, type Clock } from '../domain/clock.ts';
14:import { quotePriceCents } from '../domain/pricing.ts';
15:import { dailySummary } from '../domain/report.ts';
16:import type { Notifier } from '../notifications/notifier.ts';
17:import type { BookingService } from '../services/booking-service.ts';
18:import type { BookingRow } from '../store/booking-repository.ts';
19:import { HttpError, readJson, sendJson } from './json.ts';
20:import type { Handler } from './router.ts';
(La línea 11 cierra un import de varias líneas que empieza en la línea 1.) Si su copia ya tiene integrado su issue de P0, sus números pueden ser otros: anoten los de su copia.
Diagnosticar con evidencia. Las herramientas de este capítulo sirven para
el paso 2. Desde code/week-05, node pass-through.ts con la ruta del
archivo de src/services/ de su copia dice qué métodos solo reenvían.
make capas (o node layers.ts <su copia>/src) muestra qué capas importa
http. Para cada cosa que la capa HTTP sabe y no es de HTTP, anoten el
archivo, la función y la línea. Para el conocimiento repetido, busquen la
regla por su texto (grep -rn "confirmed" src) y también por su sentido: una
misma regla puede estar escrita de dos formas distintas.
Diseñar la interfaz antes de implementar. Escriban el tipo del módulo nuevo con un comentario por operación: qué promete y qué esconde. Algunas preguntas para revisar la interfaz de otra pareja:
- ¿Qué tiene que saber un handler para usarla? Si la respuesta incluye “los nombres de las columnas”, “que hay que filtrar las canceladas” o “qué hora es en Lima”, la interfaz todavía filtra.
- ¿Los errores del negocio salen como un resultado tipado (por ejemplo, una
unión discriminada como la
LoanResultdel préstamo de implementos, o como las de la semana 4) o como un error del dominio? Si el módulo lanzaHttpError, sabe de HTTP. - ¿Cuántas operaciones tiene, comparadas con los métodos que reemplaza? Un
módulo con
bookycancelque esconde la base de datos, el reloj, la tarifa y el aviso es profundo; uno con diez métodos que devuelven filas es el mismo módulo superficial con otro nombre.
Conectar sin romper a nadie. createServer es lo que usan las pruebas
(test/helpers.ts): su firma no cambia. Lo que cambia es lo que arma por
dentro.
Pasos pequeños. Un commit por paso, con make check en verde después de
cada uno. Una secuencia razonable: crear el módulo nuevo sin usarlo; pasar un
handler a usarlo; pasar los demás; borrar lo que quedó sin uso; recién
entonces mover reglas repetidas a un solo lugar. Si en algún paso encuentran
un comportamiento que parece un error, abran un issue y sigan.
Medir de nuevo. El pull request lleva los números de antes y de después, lo que el módulo esconde ahora y lo que todavía se filtra. Que el total de líneas suba un poco no es un mal resultado: lo que debería bajar es lo que la capa HTTP necesita saber.
El código de la semana y make test
La carpeta code/week-05 tiene:
| Archivo | Qué es |
|---|---|
loans/shallow.ts, loans/deep.ts, loans.test.ts |
El préstamo de implementos en versión superficial y profunda, y el guion que comprueba que responden igual |
pass-through.ts, pass-through.test.ts |
La herramienta que encuentra métodos que solo reenvían |
kwic/flowchart.ts, kwic/hiding.ts, kwic.test.ts |
Las dos divisiones de Parnas del índice KWIC |
concepts/, concepts.test.ts |
Tres conceptos independientes, su sincronización y sus principios operacionales como pruebas |
layers.ts, layers.test.ts |
Las dependencias entre las capas de Kallpa |
closing-hour.test.ts |
El experimento de cerrar a las 23:00 en una copia de Kallpa |
refactor-fecha.diff |
El refactoring de ejemplo |
Dentro del contenedor del curso:
$ cd code/week-05
$ make test
tsc -p .
eslint .
node --test "*.test.ts"
...
ℹ tests 20
ℹ suites 6
ℹ pass 20
ℹ fail 0
...
make --no-print-directory refactor
...
test/ sin cambios
make test revisa los tipos con tsc y el estilo con ESLint, corre las
pruebas de los ejemplos y aplica el refactoring de ejemplo a una copia de
Kallpa. Nada de esto modifica kallpa/: todo lo que se copia o se genera
queda en build/ o en carpetas temporales. make capas y make medir
muestran las salidas de este capítulo, y make clean borra build/.
Resumen
- La complejidad es lo que hace difícil entender y cambiar un sistema. Sus síntomas son la amplificación de cambios, la carga cognitiva y las incógnitas desconocidas (la peor); sus causas, las dependencias y la oscuridad. Se acumula de a poco, y la medida es el costo de los cambios que de verdad se hacen, no el tamaño.
- La programación táctica busca que la tarea de hoy funcione; la estratégica invierte un poco en cada cambio para que el diseño mejore. Una deuda técnica tiene monto, responsable y fecha; si no, es diseño que nadie va a revisar.
- Un módulo tiene una interfaz (formal e informal) y una implementación. Es profundo si da mucho con una interfaz pequeña, y superficial si su interfaz es casi tan grande como lo que hace. Los métodos que solo reenvían son la señal más clara de un módulo superficial. Muchas clases pequeñas no son buen diseño por sí mismas.
- Ocultamiento de información (Parnas, 1972): cada módulo esconde una decisión difícil o que probablemente cambie. Dividir por pasos del procesamiento (descomposición temporal) reparte las decisiones entre módulos y produce filtración de información.
- Un concepto (Jackson) tiene propósito, estado, acciones y principio operacional (“si…, entonces…”). Se entiende solo, es genérico y se combina con otros por sincronizaciones. Un propósito por concepto.
- Acoplamiento: cuánto obliga un cambio en un módulo a cambiar otro; cohesión: cuánto pertenecen juntas las partes de un módulo. De más a menos dañino: depender de detalles internos, compartir estado global, pasar banderas, pasar estructuras enteras, pasar solo los datos necesarios. El acoplamiento oculto es el más peligroso.
- DRY es sobre conocimiento: una regla, una representación. No se junta código solo porque se parece.
- Las dependencias de Kallpa van en un sentido (
http→services→store, ydomainsin dependencias), y eso se puede comprobar con una prueba. - Un refactoring cambia la estructura sin cambiar el comportamiento, en pasos pequeños con las pruebas en verde. Pruebas en verde no prueban que nada cambió: lo que no tiene prueba se compara con una prueba de caracterización.
Ejercicios
- Den un ejemplo de amplificación de cambios, uno de carga cognitiva y uno de incógnita desconocida en un programa que hayan escrito (de este curso o de otro). Para cada uno, digan cuál fue la causa: una dependencia, oscuridad o las dos.
- Repitan el experimento de
closing-hour.test.tscon la hora de apertura: en una copia de Kallpa, cambienOPENING_HOURde 7 a 6 y corran las pruebas. Antes de correrlas, escriban qué pruebas esperan que fallen y por qué. ¿Acertaron? ¿Qué más habría que cambiar fuera del código? - Corran
node pass-through.tssobre todos los archivos dekallpa/src/store/y dekallpa/src/http/. ¿Encuentra algo? Para cada resultado, decidan si es un problema o un reenvío justificado, con el criterio de la sección de módulos profundos. pass-through.tssolo reconoce métodos cuyo cuerpo es una sola llamada athis.campo.metodo(...). Escriban una clase pequeña con un método que solo reenvía pero que la herramienta no detecta (por ejemplo, porque guarda el resultado en una variable antes de devolverlo). Agreguen una prueba enpass-through.test.tsque lo muestre. ¿Vale la pena que la herramienta lo detecte? ¿Qué riesgo hay de que marque como reenvío algo que no lo es?- En
kwic/hiding.ts, escriban una segunda implementación deShiftsque no guarde ningún índice y calcule cada rotación cuando se pide (el cambio 4 de Parnas). Agreguen una prueba que compruebe que la salida no cambia. ¿Cuántos archivos tocaron? Hagan el mismo cambio enkwic/flowchart.tsy comparen. - Expliquen el argumento de Parnas con un ejemplo de Kallpa distinto de los de este capítulo: elijan una decisión de diseño que podría cambiar (el canal de los avisos, el motor de base de datos, el formato de las fechas…), digan qué módulo la esconde hoy y qué otros módulos tendrían que cambiar si la decisión cambia.
- Describan el concepto cancelación con plazo de Kallpa con propósito,
estado, acciones y principio operacional, en el formato de
concepts/reservation.ts. Luego describan un concepto de otra aplicación que usen todos los días (una billetera digital, una aplicación de delivery…) y revisen su propósito con los tres criterios de Jackson. - El tipo
Memberde Kallpa junta el registro de vecinos y la membresía. Escriban los dos conceptos por separado (propósito, estado, acciones, principio). Después imaginen el pedido “los socios tienen fecha de vencimiento” y digan qué archivos de Kallpa cambiarían con el diseño actual y cuáles con los conceptos separados. - Para los turnos fijos de su backlog de la semana 3, decidan si son un concepto nuevo o una forma de usar reserva. Escriban la decisión como un párrafo de design doc: contexto, las dos alternativas, lo que cambia en el modelo de datos y en las reglas de cancelación con cada una, y la elegida.
- Dos funciones de Kallpa tienen el mismo código de tres líneas. Den un ejemplo (real o inventado) de cuándo conviene juntarlas en una y otro de cuándo no. Usen el criterio de DRY: ¿representan el mismo conocimiento?
- Clasifiquen cada uno de estos casos según las formas de acoplamiento de
la sección: (a)
quotePriceCentsrecibe el plan del vecino y no el vecino; (b) un handler que ejecutaSELECT * FROM bookingspor su cuenta; (c) una funciónlistBookings(courtId, date, onlyConfirmed); (d) un módulo que guarda la hora actual en una variable global que leen otros tres. Para los que sean dañinos, propongan cómo cambiarlos. - Agreguen a
layers.test.tsuna prueba que exprese una regla más estricta: quehttpno importe nada destore. Córranla contra la Kallpa publicada. ¿Pasa? Si no pasa, ¿qué import la rompe y qué dice eso del diseño? (Pueden volver a correrla al terminar el laboratorio, contra su copia.)