Apuntes · Capítulo 3Proceso y requisitos
Requisitos: entrevistas, historias de usuario y criterios de aceptación
Requisitos: entrevistas, historias de usuario y criterios de aceptación
La semana pasada armamos un backlog, lo estimamos con story points y vimos cómo un equipo planifica un sprint. Dimos por hecho algo que no es nada obvio: que cada ítem del backlog dice lo que el cliente necesita. El caso del Boeing 737 MAX mostró lo que pasa cuando eso falla. El MCAS hizo exactamente lo que estaba especificado. Lo que estaba mal era la especificación: un supuesto sobre cuánto tarda un piloto en reaccionar, un cambio de alcance que nadie volvió a evaluar y un requisito (“que no haga falta entrenar en simulador”) que venía del contrato y no de la seguridad.
Esta semana estudiamos de dónde salen los ítems del backlog. En la primera parte vemos qué es un requisito y cómo se descubre: la diferencia entre el problema del cliente y la solución que trae pensada, las técnicas de elicitación y, sobre todo, cómo preparar, conducir y documentar una entrevista. En la segunda parte escribimos lo que aprendimos en una forma que un equipo puede planificar y comprobar: historias de usuario con criterios de aceptación dado, cuando, entonces, revisadas con INVEST, divididas cuando son demasiado grandes y priorizadas con MoSCoW y por valor, costo y riesgo.
La idea que recorre todo el capítulo es una sola: un requisito tiene que poder rastrearse hasta algo que el cliente dijo o aprobó, y tiene que poder comprobarse. Lo primero lo garantizan unas buenas notas de entrevista; lo segundo, unos criterios de aceptación concretos. Al final del capítulo convertimos esos criterios en pruebas que corren contra Kallpa, para ver que “comprobable” no es una forma de hablar.
En el laboratorio, el docente hace de Doris Chumpitaz, la administradora del complejo, y toda la clase la entrevista sobre un pedido nuevo: los turnos fijos de los equipos. Lo que Doris sabe solo sale si se pregunta bien. Con lo que averigüen escriben historias, las priorizan y las validan con ella. Es el ensayo de P1, donde harán lo mismo con un cliente de verdad.
Lectura. Para la Sesión A, Nielsen Norman Group, User Interviews 101, Interviewing Users y Open-Ended vs. Closed Questions in User Research; como complemento, Field Studies y Paper Prototyping. Para la Sesión B, Mountain Goat Software, User Stories; Agile Alliance, INVEST, y Martin Fowler, GivenWhenThen; como complemento, Mountain Goat Software, SPIDR: Five Simple but Powerful Ways to Split User Stories; Cucumber, Gherkin Reference (la usaremos en la semana 9); Martin Fowler, UserStory, y el artículo sobre el método MoSCoW. El código del capítulo está en
code/week-03y se prueba conmake testdentro del contenedor del curso.
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): de Qué es un requisito, La definición y Funcionales y no funcionales; de El problema y la solución, El cliente llega con una solución; de Elicitación, Las técnicas; de Durante la entrevista, Preguntas abiertas y cerradas y Preguntas que inducen la respuesta; de Historias de usuario, Una promesa de conversación y Las tres C; y de Criterios de aceptación, Dado, cuando, entonces.
- En clase: Sesión A: El problema y la solución, Elicitación, Preparar una entrevista, Durante la entrevista y Después de la entrevista. Sesión B: Historias de usuario, Criterios de aceptación, INVEST: revisar una historia antes del sprint, Dividir historias y Priorizar. Laboratorio: En el laboratorio.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Rastrear cada requisito hasta su origen, Los criterios, ejecutados, Un revisor automático, y lo que no puede revisar, Con IA: encontrar huecos sin inventar requisitos y las lecturas del recuadro Lectura.
Qué es un requisito
La definición
Un requisito (requirement) es una condición que el sistema tiene que cumplir para que el cliente resuelva su problema o logre su objetivo. La definición clásica, la del glosario de ingeniería de software del IEEE (IEEE 610.12, 1990), tiene tres partes: una condición o capacidad que alguien necesita para resolver un problema; una condición que el sistema debe cumplir para satisfacer un contrato, una norma u otro documento; y la representación escrita de cualquiera de las dos. La tercera parte importa más de lo que parece: el requisito que vive solo en la cabeza de Doris no es un requisito del sistema. Es un requisito del cliente que el equipo todavía no conoce.
Tres palabras de la definición merecen atención.
- Condición. Un requisito se cumple o no se cumple. “Que las reservas funcionen bien” no es una condición; “una cancha no puede tener dos reservas confirmadas que se crucen” sí.
- Sistema. Un requisito habla de lo que el sistema hace o de cómo lo hace, visto desde fuera. “Usar SQLite” puede ser una decisión razonable, pero no es algo que el cliente necesite.
- Problema del cliente. El requisito existe porque alguien tiene un problema. Si nadie puede decir qué problema resuelve, probablemente sobra.
Kallpa ya tiene requisitos escritos. Están en la sección Reglas del negocio de su README, que empieza con una frase que vale la pena copiar en cualquier proyecto: “Así funciona el complejo, según su administración. Si el código hace otra cosa, el código está mal”. Esa frase dice quién manda: los requisitos vienen del cliente, y el código se ajusta a ellos, no al revés.
Funcionales y no funcionales
Un requisito funcional (functional requirement) dice qué hace el sistema: una entrada, un comportamiento, un resultado.
- Se puede cancelar una reserva hasta 3 horas antes de que empiece.
- Una reserva tiene de 1 a 3 horas seguidas en la misma cancha.
- Los socios tienen 10 % de descuento sobre el total de la reserva.
Un requisito no funcional (non-functional requirement) dice cómo de bien lo hace: una cualidad medible del sistema mientras cumple sus funciones. Los modelos de calidad, como el de la norma ISO/IEC 25010, los agrupan en características como la eficiencia de desempeño, la fiabilidad, la seguridad y la mantenibilidad. En Kallpa:
- La disponibilidad de una cancha aparece en menos de 1 segundo en un celular con una conexión 4G.
- La página se puede usar entera solo con el teclado.
- La aplicación está disponible de 7:00 a 22:00, que es cuando se reserva y se cobra.
La frontera no siempre es nítida. “Solo el personal de la caja ve los ingresos del día” se puede leer como funcional (quién puede hacer qué) o como no funcional (seguridad). No pierdan tiempo en clasificar: lo que importa es que el requisito esté escrito y que se pueda comprobar.
Idea clave. Un requisito no funcional sin número todavía no es un requisito. “La página es rápida” no se puede cumplir ni incumplir: para Doris en la oficina, con fibra, siempre es rápida; para un vecino con datos prepago en el paradero, quizás nunca. “La disponibilidad aparece en menos de 1 s en un celular con 4G” sí se puede medir.
Cómo se le pone número a una cualidad
Para que un requisito no funcional se pueda comprobar hacen falta cuatro cosas: qué se mide, dónde o en qué condiciones, cuánto es aceptable y cómo se mide. Compárenlo:
| Vago | Medible |
|---|---|
| La página es rápida. | Desde que se elige la fecha hasta que aparecen las horas pasa menos de 1 s, en un celular con la red limitada a 4G en el navegador, en 9 de cada 10 intentos. |
| Es fácil de usar. | Un vecino que nunca usó la página hace su primera reserva en menos de 2 minutos, sin ayuda, en una prueba con 5 vecinos. |
| Es accesible. | Todas las acciones se pueden hacer solo con el teclado (WCAG 2.2, criterio 2.1.1). |
| Es confiable. | Ninguna reserva confirmada se pierde si el servidor se reinicia. |
El “9 de cada 10” de la primera fila no es un detalle. Un tiempo de respuesta no es un número sino una distribución: casi siempre rápido, a veces lento. “En promedio menos de 1 s” deja pasar a un vecino de cada diez que espera 5 segundos. Por eso los equipos suelen fijar un percentil (“el 95 % de las cargas en menos de 1 s”); lo verán con los SLO en la semana 13.
Error común. Creer que todo requisito no funcional se mide con un número. Algunos son restricciones: condiciones que el sistema tiene que respetar y que no se negocian por grados. “Los datos personales de los vecinos se tratan según la Ley N.° 29733, de Protección de Datos Personales” o “la aplicación corre en la computadora de la oficina, que tiene Windows 10” no tienen percentil. Se cumplen o no. La regla del número vale para las cualidades (velocidad, facilidad, disponibilidad), no para las restricciones.
Requisitos, reglas del negocio y decisiones de diseño
Conviene separar tres cosas que en una conversación salen mezcladas.
- Una regla del negocio es una política del cliente que existe aunque no haya software: “en hora punta la hora cuesta 25 % más”. Kallpa la implementa, pero la regla es de la junta directiva del complejo. Si la junta la cambia, el código tiene que cambiar.
- Un requisito es lo que el sistema tiene que hacer, muchas veces para aplicar una regla: “el precio que muestra la página es el que se cobra en la caja, con la tarifa de cada hora”.
- Una decisión de diseño es cómo lo hace el equipo: “el dinero se guarda en céntimos, como enteros”. El cliente no la pidió; la tomó el equipo para cumplir el requisito sin errores de redondeo.
Mezclarlas tiene costo. Si una decisión de diseño se escribe como requisito
(“se agrega una columna recurring a la tabla”), nadie puede cambiarla sin
“incumplir un requisito”. Si una regla del negocio se toma como decisión del
equipo, alguien la “optimiza” y el sistema deja de hacer lo que el
complejo necesita.
El problema y la solución
El cliente llega con una solución
Casi ningún cliente llega diciendo “tengo este problema”. Llega diciendo “quiero esto”. Un mensaje real de Doris podría ser:
“¿Pueden poner un botón para bloquear la cancha? Lo necesito para la otra semana.”
Es una solución: un botón, que bloquea, una cancha. El equipo podría construirla tal cual en una tarde. Antes de hacerlo hay que preguntar por qué. Una conversación posible:
—¿Para qué necesitaría bloquearla? ¿Qué pasó la última vez?
—El martes vino el técnico a cambiar los reflectores de la cancha de vóley. Llegó a las cuatro y las chicas de Las Matadoras ya tenían reservado de cuatro a seis. Tuve que llamarlas para que no vinieran y se molestaron, con razón.
—¿Cada cuánto viene el técnico?
—Más o menos una vez al mes. Avisa con dos o tres días.
Ahora el problema está claro: el mantenimiento choca con reservas ya hechas y los equipos se enteran tarde. Con el problema a la vista aparecen otras soluciones, algunas mejores que el botón:
- Separar la cancha para mantenimiento con fecha y hora, como si fuera una reserva, para que la página muestre esas horas ocupadas.
- Antes de separarla, ver qué reservas chocan y a quién hay que avisar.
- Avisar por WhatsApp a esos equipos, como ya se hace al confirmar.
- O, quizás, pedirle al técnico que venga siempre en una hora de poca demanda, como las 8:00, y no tocar el software.
El “botón para bloquear la cancha”, construido tal cual, no habría resuelto el problema del martes: Las Matadoras ya tenían la reserva y un bloqueo nuevo no les avisa nada.
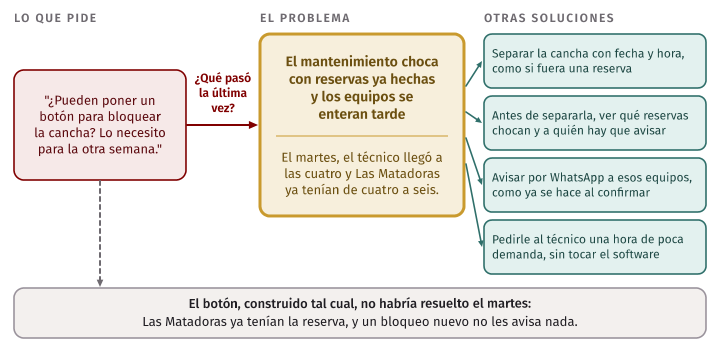
Idea clave. El trabajo de quien levanta requisitos es pasar de la solución que trae el cliente al problema que tiene. No para ignorar su idea, sino para poder compararla con otras. La pregunta que más ayuda es “¿qué pasó la última vez?”.
Por qué el cliente no puede simplemente decirlo
Si preguntar el problema es tan útil, ¿por qué el cliente no lo dice de entrada? Por varias razones que conviene conocer, porque van a aparecer en cada entrevista.
- El cliente es experto en su trabajo, no en software. Doris sabe todo sobre el complejo, pero no sabe qué es fácil o difícil de construir. Pide lo que imagina que se puede hacer.
- Lo obvio no se dice. Para Doris es evidente que los domingos no viene el técnico o que la caja cierra a las 22:00. Nadie menciona lo que da por sabido; hay que preguntarlo o verlo.
- La gente recuerda mal y predice peor. En Interviewing Users, Jakob Nielsen lo resume así: lo que la gente dice y lo que hace son cosas distintas. Al recordar, la gente completa los huecos con una historia que suena lógica; al imaginar el futuro, no sabe cómo usaría algo que nunca vio.
- Opinar es gratis. Nielsen llama query effect (efecto de la pregunta) a que la gente fabrica una opinión sobre cualquier cosa si se le pregunta, aunque nunca lo hubiera pensado. Una respuesta entusiasta a “¿le gustaría…?” no dice nada sobre si lo va a usar.
Nielsen cuenta una anécdota que lo ilustra. Antes de diseñar Office 2007, Microsoft pidió a sus clientes que propusieran funciones nuevas; la mayoría de los “pedidos nuevos” ya existían en Office 2003. El problema real no era que faltaran funciones, sino que la gente no encontraba las que había. Es una anécdota, no un estudio, pero muestra el punto: lo que el cliente pide es un dato, no la conclusión.
Elicitación
Las técnicas
Elicitación es el trabajo de descubrir los requisitos. La palabra viene de elicit, sacar a la luz: los requisitos no están esperando a que alguien los anote, hay que hacerlos salir. Ninguna técnica sola alcanza, porque cada una ve cosas distintas.
| Técnica | Qué encuentra | Qué se le escapa |
|---|---|---|
| Entrevista | Objetivos, problemas, reglas, el vocabulario del cliente, cómo cree que trabaja | Lo que hace sin darse cuenta; lo que da por obvio |
| Observación del trabajo | Lo que de verdad pasa: cómo cobra la caja, qué anota Doris en su cuaderno, qué atajos usa | Por qué lo hace; lo que pasa en otros días u horas |
| Revisión de documentos | Reglas escritas: el reglamento del complejo, los acuerdos de la junta, el cuaderno de reservas | Las reglas que nadie escribió; las que ya nadie cumple |
| Prototipo | Si la solución tiene sentido para el cliente; lo que falta en una pantalla | El problema de fondo, si el prototipo ya supone una solución |
| Encuesta | Cuántos piensan algo, una vez que se sabe qué preguntar | Lo inesperado: solo responde lo que se preguntó |
La lectura de Nielsen Norman Group sobre estudios de campo (Field Studies) explica la observación: ir a donde ocurre el trabajo y mirar. En Kallpa sería pasar una tarde en la caja, de 17:00 a 21:00, viendo cómo se cobra, qué preguntan los vecinos y cuándo se usa el cuaderno. En una entrevista, la persona de la caja quizás diga “todos reservan por la página”; en la caja, uno ve que la mitad llega y pregunta “¿hay cancha?”.
El prototipo en papel (Paper Prototyping, en las lecturas complementarias) es la técnica para validar: dibujar a mano las pantallas y pedirle al cliente que “use” el dibujo mientras alguien del equipo hace de computadora. Cuesta minutos y encuentra errores que en código costarían días. Lo usarán en el paso 6 del laboratorio.
A quién preguntarle
Un sistema tiene varios stakeholders: personas o grupos a los que el sistema afecta o que pueden afectarlo. En Kallpa, al menos:
- La administración (Doris): organiza las canchas, atiende los reclamos, responde a la junta.
- La junta directiva: decide tarifas, descuentos y reglamento.
- La caja: cobra, cuadra el dinero del día, atiende a quien llega sin reserva.
- Los vecinos que reservan: regulares y socios, con celulares y conexiones muy distintas.
- Los equipos de siempre, que juegan cada semana a la misma hora.
- El técnico, que necesita la cancha libre para trabajar.
Cada uno ve un pedazo y tiene intereses que pueden chocar. Un vecino quiere encontrar cancha libre en hora punta; un equipo de siempre quiere tener asegurada su hora; la junta quiere que la hora punta se alquile entera. Si solo se entrevista a Doris, el sistema va a reflejar lo que Doris cree que quieren los demás.
¿A cuántas personas? Un estudio clásico, el de Griffin y Hauser (The Voice of the Customer, Marketing Science, 1993), se hizo justamente esa pregunta, con entrevistas a clientes de una categoría de productos de consumo, y estimó que entre 20 y 30 entrevistas encontraban entre el 90 y el 95 % de las necesidades. Hay que leer ese resultado con sus límites: es una sola categoría de productos, con muchos clientes parecidos, y la cifra sale de un modelo ajustado a esos datos. Para un cliente pequeño como el complejo, con pocos stakeholders, lo que sí se puede llevar es la forma de la curva: cada entrevista nueva encuentra menos cosas nuevas, pero la primera sola encuentra bastante menos que todas juntas.
En la industria. El manual de servicios del gobierno del Reino Unido (GOV.UK Service Manual) pide entender a todos los usuarios, no solo a los “típicos”, e incluir a quienes prestan el servicio (en su ejemplo, los agentes de un call center). Agrega una regla que conviene adoptar tal cual: las opiniones o sugerencias que no vienen de los usuarios se tratan como supuestos que hay que comprobar con investigación. En Kallpa, “los vecinos quieren pagar por Yape” es un supuesto hasta que alguien lo averigüe con vecinos.
Preparar una entrevista
El objetivo
Una entrevista de requisitos no es una conversación informal ni una venta. Es, como dice User Interviews 101, un pequeño estudio: tiene una pregunta que responder. El objetivo se escribe antes, en una oración, y es concreto:
- Mal: “conocer a Doris”.
- Mal: “ver qué funciones quiere en la página”.
- Bien: “entender cómo se organiza hoy el mantenimiento de las canchas, cada cuánto choca con reservas y qué se hace cuando pasa”.
El objetivo bueno no menciona la solución. Si dijera “validar el botón de bloqueo”, la entrevista entera giraría alrededor del botón y nadie preguntaría por el técnico.
La guía de preguntas
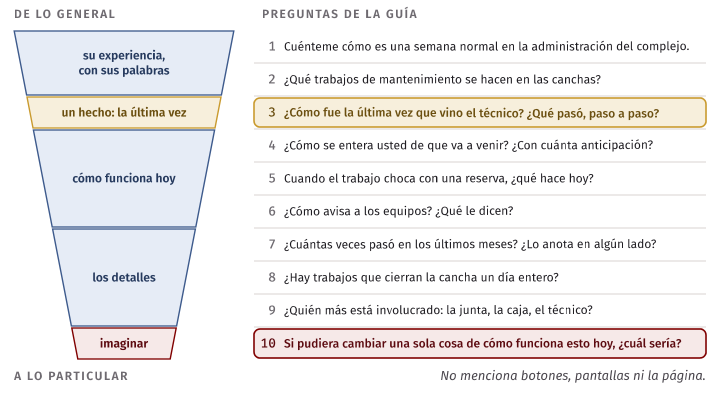
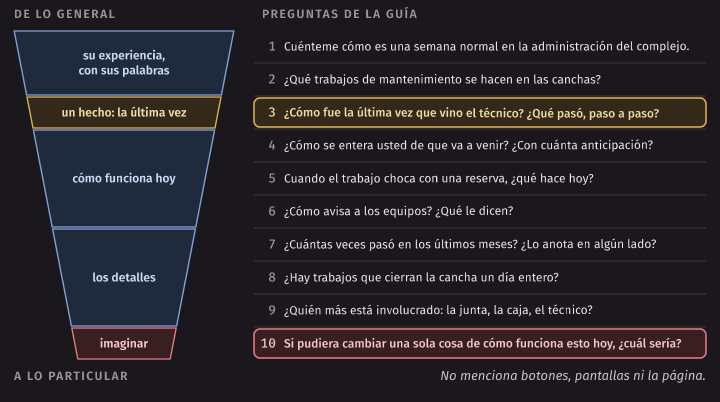
La guía es la lista de preguntas que el equipo lleva preparada, de lo general a lo particular. Esa forma se llama de embudo: se empieza amplio, para que la persona cuente su experiencia con sus palabras, y se va cerrando hacia los detalles que el equipo necesita. Si se empieza por los detalles, la persona responde lo que se le pregunta y nada más.
Una guía para el objetivo anterior, con 10 preguntas:
- Cuénteme cómo es una semana normal en la administración del complejo.
- ¿Qué trabajos de mantenimiento se hacen en las canchas?
- ¿Cómo fue la última vez que vino el técnico? ¿Qué pasó, paso a paso?
- ¿Cómo se entera usted de que va a venir? ¿Con cuánta anticipación?
- Cuando el trabajo choca con una reserva, ¿qué hace hoy?
- ¿Cómo avisa a los equipos? ¿Qué le dicen?
- ¿Cuántas veces pasó en los últimos meses? ¿Lo anota en algún lado?
- ¿Hay trabajos que cierran la cancha un día entero?
- ¿Quién más está involucrado: la junta, la caja, el técnico?
- Si pudiera cambiar una sola cosa de cómo funciona esto hoy, ¿cuál sería?
Fíjense en lo que no tiene: no menciona botones, pantallas ni la página. La pregunta 10 es la única que invita a imaginar, y va al final, cuando ya se conoce el problema.
User Interviews 101 recomienda además probar la guía antes con alguien (un piloto), para descubrir preguntas confusas o en mal orden, y empezar con preguntas fáciles que le den confianza a la persona.
Los roles
Una persona sola no puede preguntar, escuchar y anotar a la vez. En el equipo se reparten:
- Quien pregunta conduce la conversación, sigue la guía sin leerla como un formulario y repregunta.
- Quienes anotan escriben lo que dice el cliente con sus palabras, sin resumir ni traducir a vocabulario técnico. Si son dos, mejor: uno se distrae cuando el otro no.
- Quien controla el tiempo avisa cuando quedan diez minutos, para que las preguntas importantes no queden sin hacer.
Si el cliente acepta que se grabe, la grabación ayuda, pero no reemplaza a quien anota: una hora de audio es una hora más de trabajo, y la mayoría de los equipos nunca la vuelve a escuchar entera.
Error común. Llegar a la entrevista sin guía, “para que fluya”. La conversación fluye, sí, hacia lo que el cliente tiene ganas de contar, y el equipo sale con una hora de anécdotas y sin respuesta a lo que necesitaba saber. La guía no es un guion: se puede salir de ella cuando aparece algo importante, y se vuelve a ella después.
Durante la entrevista
Preguntas abiertas y cerradas
Una pregunta abierta deja que la persona responda con sus palabras y con el detalle que quiera: “cuénteme cómo fue la última vez que vino el técnico”. Una pregunta cerrada limita la respuesta a unas pocas opciones: “¿el técnico viene los martes?” (sí o no), “¿cuántas veces vino este mes?” (un número).
La lectura de Nielsen Norman Group sobre preguntas abiertas y cerradas resume la diferencia: las abiertas llevan a descubrir cosas que el equipo no esperaba; las cerradas aclaran y precisan, pero no traen sorpresas, porque solo se responde lo que se preguntó. Las dos sirven. Lo que cambia es cuándo.
- Primero, abiertas. Para que aparezca lo que el equipo no sabe que no sabe.
- Después, cerradas. Para confirmar un dato concreto que salió en la respuesta abierta: “dijo que avisa con dos o tres días; ¿alguna vez avisó el mismo día?”.
Así se ve la diferencia con Doris:
| Pregunta | Respuesta típica | Qué aprendió el equipo |
|---|---|---|
| ¿Le sirve poder bloquear la cancha desde la página? | “Sí, claro.” | Nada. |
| ¿El técnico viene en la tarde? | “A veces.” | Casi nada. |
| Cuénteme cómo fue la última vez que vino el técnico. | “El martes llegó a las cuatro, las de vóley ya estaban reservadas, tuve que llamarlas, una se molestó porque ya había pedido permiso en el trabajo…” | El choque, el aviso tardío, el costo para el equipo, que Doris llama por teléfono. |
El último caso concreto
La pregunta más útil de una entrevista de requisitos tiene esta forma: “¿Cómo fue la última vez que…?”. Pide un hecho, no una opinión ni una generalización.
- “¿Cómo manejan los choques con el mantenimiento?” invita a describir cómo debería ser: “llamamos a los equipos con anticipación”.
- “¿Cómo fue la última vez?” obliga a contar lo que pasó: “me enteré el mismo día y las llamé a las tres”.
User Interviews 101 da la misma razón: preguntar por un evento concreto ayuda a recordar con detalle, mientras que preguntar por el proceso en general produce la versión idealizada. Y el último caso es el que mejor se recuerda.
Del caso concreto salen las preguntas que siguen: “¿y la vez anterior?”, “¿siempre es así?”, “¿qué pasó después?”. Así se separa lo que pasa siempre de lo que pasó una vez.
Preguntas que inducen la respuesta
Una pregunta inductora (leading question) sugiere la respuesta que el equipo quiere oír. Es el error más común de una primera entrevista, y es difícil de ver desde dentro.
| Inductora | Por qué falla | Mejor |
|---|---|---|
| ¿No sería mejor que pudieran pagar por Yape? | Presenta una idea y pide aprobación. Casi todos dicen que sí a una idea que se les presenta, y eso no prueba que la vayan a usar. | ¿Cómo pagan hoy los vecinos? ¿Qué problemas hay con eso? |
| El cuaderno debe ser muy incómodo, ¿no? | Dice qué tiene que sentir. | ¿Cómo usa el cuaderno? Muéstreme la última página. |
| ¿Le molesta cuando el técnico llega sin avisar? | Supone que llega sin avisar. | ¿Cómo se entera de que va a venir el técnico? |
| ¿Quiere que le avisemos por WhatsApp a los equipos afectados? | Propone la solución del equipo. | Cuando cancela una hora por mantenimiento, ¿cómo se enteran los equipos? |
La regla práctica: si la pregunta se puede responder con “sí, claro” y esa respuesta haría feliz al equipo, está mal formulada. Recuerden el efecto de la pregunta de Nielsen: la gente fabrica una opinión si se le pide. En el laboratorio, Doris va a responder “sí, claro” a todas las preguntas inductoras, como haría un cliente real que quiere ser amable.
Repreguntar y repetir con sus palabras
Dos herramientas sencillas que separan una entrevista buena de una regular:
- Repreguntar. Cuando aparece algo interesante, seguir con “cuénteme más”, “¿por qué eso es importante?”, “¿qué pasó después?”. User Interviews 101 las llama probing questions y dice que no se preparan: se usan cuando hacen falta.
- Repetir lo que entendieron. “A ver si entendí: el técnico avisa con dos o tres días, usted revisa en la página si hay reservas en esa hora y, si hay, llama a quien reservó. ¿Es así?”. Si el equipo entendió mal, el cliente lo corrige en el momento. Si entendió bien, el cliente muchas veces agrega algo: “sí, aunque a veces no tengo el número y tengo que esperar a que vengan”.
Lo que el cliente no sabe
Doris no sabe todo. No sabe, por ejemplo, si la junta pagaría el costo de enviar mensajes de WhatsApp, ni cuánto se demora el técnico en cada tipo de trabajo. Cuando el cliente responde “no sé” o “eso lo ve la junta”, no hay que adivinar ni dejarlo pasar: se anota qué no sabe y a quién habría que preguntarle. Esa lista es tan valiosa como las respuestas; es la agenda de la siguiente entrevista.
También pasa lo contrario: el cliente responde con seguridad algo que no sabe, porque le da vergüenza decir “no sé”. Una señal es que la respuesta sea general (“siempre”, “todos”, “nunca”). La repregunta es la de siempre: “¿cómo fue la última vez?”.
Error común. Hablar más que el cliente. Explicar cómo funcionaría la solución, mostrar lo que el equipo ya sabe, completar las frases del cliente. Cada minuto en que el equipo habla es un minuto en que no aprende nada. Un silencio de cinco segundos después de una respuesta incomoda, y casi siempre el cliente lo llena con lo que no había dicho.
Después de la entrevista
Las notas, el mismo día
Las notas se ordenan el mismo día, cuando todavía se recuerda qué quiso decir cada frase. Una semana después, “técnico martes 4 pm vóley” ya no dice nada. Se ordenan en tres listas separadas:
- Lo que el cliente dijo, con sus palabras y entre comillas cuando importa.
- Lo que el equipo supone: interpretaciones, conclusiones, ideas de solución.
- Lo que falta preguntar, y a quién.
La separación es lo que da valor a las notas. Un mes después, cuando alguien pregunte “¿de dónde sacamos que los mantenimientos duran dos horas?”, las notas tienen que poder responder: lo dijo Doris, lo suponemos nosotros o no lo sabemos.
Así quedarían las notas de la entrevista sobre el mantenimiento:
## Datos
2026-03-09, oficina del complejo, 30 min. Doris Chumpitaz (administración).
Pregunta: Ana. Notas: Bruno y Carla. Tiempo: Diego.
Objetivo: entender cómo se organiza hoy el mantenimiento de las canchas,
cada cuánto choca con reservas y qué se hace cuando pasa.

## Lo que dijo Doris
- "El martes vino el técnico a cambiar los reflectores de la cancha de
  vóley. Llegó a las cuatro y Las Matadoras ya tenían reservado de cuatro
  a seis."
- El técnico viene "más o menos una vez al mes" y avisa "con dos o tres días".
- Cuando hay choque, ella revisa la página y llama por teléfono a quien
  reservó. "A veces no tengo el número y tengo que esperar a que vengan."
- Una vez al año se pintan las líneas de todas las canchas: "ese día no se
  juega".
- Lo anota en su cuaderno, en la página del día.

## Lo que suponemos
- Que un mantenimiento dura unas dos horas (solo tenemos un caso).
- Que los equipos preferirían enterarse por WhatsApp.
- Que el técnico podría aceptar horas de poca demanda.

## Lo que falta preguntar
- ¿Cuántos choques hubo en los últimos tres meses? (Doris: revisar el cuaderno)
- ¿Quién decide cuándo viene el técnico? (Doris no sabe: preguntar a la junta)
- ¿Qué hacen los equipos afectados: reprograman, otra cancha, nada?
  (preguntar a un equipo, por ejemplo Las Matadoras)
La frase “a veces no tengo el número” llama la atención. Kallpa sí guarda el celular de cada vecino registrado (lo usa para el aviso por WhatsApp). O Doris no sabe dónde verlo en la página, o se refiere a otra cosa. Es una pregunta para la próxima vez, no una conclusión.
El glosario
Un glosario es una tabla con las palabras del cliente y lo que quieren decir para él. Parece burocracia y es una de las herramientas más útiles del capítulo, por dos razones.
Primero, porque las palabras del cliente no significan lo que el equipo cree. Para el equipo, “bloquear” puede ser quitar un permiso; para Doris es que nadie reserve. Para un programador, “turno” puede ser cualquier franja de tiempo; para la caja puede ser la jornada de quien atiende.
Segundo, porque si el equipo usa otras palabras, el cliente deja de reconocer su propio problema. Si las historias dicen “slot inhabilitado” y Doris dice “cancha separada para mantenimiento”, ella no va a poder validar nada. Las historias, los criterios y, desde P2, el código usan las palabras del glosario.
| Término | Qué quiere decir para el complejo |
|---|---|
| Mantenimiento | Trabajo del técnico en una cancha (luces, redes, piso) durante el cual no se puede jugar. Dura unas horas. |
| Separar la cancha | Que nadie pueda reservarla en un horario. Doris dice “bloquear” para lo mismo. |
| Socio | Vecino que paga la cuota mensual y tiene 10 % de descuento. |
| La caja | El lugar y la persona que cobra en el complejo, y el dinero del día. |
| Hora punta | De lunes a viernes desde las 18:00, y sábados y domingos todo el día. |
Rastrear cada requisito hasta su origen
Rastreabilidad (traceability) es poder seguir un requisito hacia atrás, hasta quien lo pidió, y hacia adelante, hasta lo que lo implementa y lo comprueba. En este curso la cadena es:
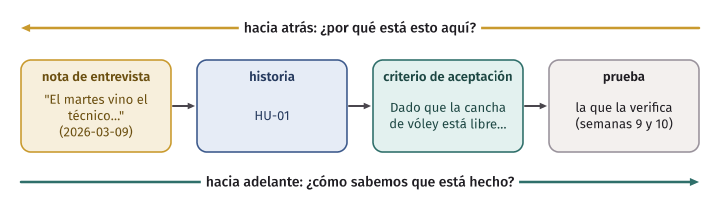
Hacia atrás, la cadena responde “¿por qué está esto aquí?”. Si una historia no se puede rastrear a ninguna nota, o la inventó el equipo o salió de alguna parte que nadie anotó. En P1, el docente compara las notas de las entrevistas con las historias, y puede llamar al cliente.
Hacia adelante responde “¿cómo sabemos que está hecho?”. Un criterio sin prueba es una promesa; una prueba sin criterio puede estar probando algo que nadie pidió.
Con IA. Un modelo de lenguaje sirve para preparar y para ordenar. Puede proponer preguntas que al equipo no se le ocurrieron, revisar si la guía tiene preguntas inductoras o resumir una transcripción, si el cliente aceptó que se grabe y que la grabación pase por esa herramienta (son sus datos y los de su negocio). Lo que no puede hacer es saber qué quiere este cliente. Si se le pide “los requisitos de un sistema de reservas de canchas”, devuelve una lista larga, plausible y segura de sí misma, con reglas que suenan razonables y que nadie del complejo dijo. Dos reglas sirven para comprobar. Primero, todo lo que entra a las historias tiene que poder rastrearse a una nota o a una aprobación del cliente. Segundo, si la herramienta resumió una transcripción, se coteja el resumen con la transcripción en los puntos que van a usarse: un resumen puede omitir un “a veces” o convertir un “no sé” en un dato.
Historias de usuario
Una promesa de conversación
Con las notas ordenadas, el equipo tiene que convertir lo que aprendió en trabajo que se pueda planificar. La forma más usada en equipos ágiles es la historia de usuario (user story): una descripción corta de algo que alguien quiere poder hacer con el sistema, contada desde su punto de vista. Kent Beck introdujo el término en Extreme Programming (XP), justamente para reemplazar las especificaciones largas por una forma de levantar requisitos más informal y conversada.
El template más común tiene tres partes:
Como <rol>, quiero <acción> para <beneficio>.
Como vecino que reserva, quiero ver cuánto voy a pagar antes de confirmar para no llevarme sorpresas en la caja.
Cada parte obliga a decir algo que una lista de funciones calla.
- El rol dice quién gana. No “el usuario”, sino alguien concreto: vecino que reserva, socio, administradora del complejo, persona de la caja. Si el rol es “el usuario”, el equipo no sabe a quién preguntarle si la historia está bien hecha.
- La acción dice qué quiere poder hacer, en sus palabras, sin decir cómo se construye.
- El beneficio dice para qué. Es la parte más importante, y la que más se omite. La lectura de Mountain Goat Software lo muestra con un ejemplo malo: “como usuario, quiero reportes para ver información” tiene las tres partes y no dice nada. El manual de GOV.UK sobre historias de usuario (Writing user stories) agrega una señal útil: si al equipo le cuesta escribir el beneficio, tiene que preguntarse por qué cree que necesita esa función.
Lo más importante de una historia no está en la tarjeta. Mountain Goat Software lo dice así: la oración es un recordatorio de que hay que conversar, y el requisito completo sale de la conversación que sigue. Por eso una historia no es una especificación completa, ni pretende serlo: deja los detalles para cuando el equipo esté por construirla, porque antes de eso pueden cambiar o no hacer falta nunca.
Las tres C
Ron Jeffries, uno de los creadores de XP, describió en 2001 las tres partes de una historia con tres palabras que empiezan con C (Essential XP: Card, Conversation, Confirmation):
- Card (la tarjeta): el texto corto que identifica la historia y sirve para planificar. Lleva la estimación y la prioridad. Hoy suele ser un issue en GitHub o en otra herramienta, como los del tablero de la semana 2.
- Conversation (la conversación): el intercambio entre el cliente y el equipo donde se aclara qué se necesita. Ocurre varias veces: al estimar, al planificar el sprint, al construir.
- Confirmation (la confirmación): cómo se va a comprobar que la historia está hecha. Para Jeffries, son las pruebas de aceptación que define el cliente, mejor si son ejemplos que se pueden ejecutar.
La tercera C es la que convierte una buena intención en algo verificable. La vemos en detalle en la sección siguiente.
Idea clave. Una historia sin conversación es una orden mal escrita; una historia sin confirmación es una conversación que nadie puede dar por terminada. Las tres partes van juntas.
Historias buenas y malas
Algunas historias para Kallpa, con lo que les falta:
| Historia | Problema |
|---|---|
| Como usuario, quiero un botón para bloquear la cancha. | Rol genérico; la acción es una solución (un botón); no hay beneficio. |
| Como administradora, quiero un CRUD de mantenimientos. | Habla de la implementación; no dice para qué. |
| Como administradora del complejo, quiero bloquear la cancha para bloquearla. | El beneficio repite la acción. |
| Como administradora del complejo, quiero separar una cancha para mantenimiento en un horario para que ningún vecino la reserve mientras trabaja el técnico. | Bien: rol concreto, acción en palabras del cliente, beneficio que explica el problema. |
La última sale directo de la nota de entrevista: “llegó a las cuatro y Las Matadoras ya tenían reservado”. Eso es lo que hace que se pueda rastrear.
Error común. Escribir una historia por pantalla, por tabla o por endpoint: “como usuario, quiero la pantalla de mantenimientos”, “como sistema, quiero la tabla de bloqueos”. Ninguna dice qué logra el cliente. Una historia describe un resultado que alguien puede usar, no una pieza del sistema.
No todo trabajo es una historia
Hay trabajo necesario que no tiene un usuario que lo pida: actualizar una
dependencia, configurar el pipeline, investigar si node:sqlite aguanta dos
procesos a la vez. Forzarlo al template (“como developer, quiero
actualizar Node para…”) no aporta nada. Ese trabajo va al backlog como lo
que es, una tarea técnica o un spike (una investigación con tiempo
limitado), y se prioriza junto con las historias, explicando al product
owner qué riesgo reduce.
Criterios de aceptación
Dado, cuando, entonces
Un criterio de aceptación (acceptance criterion) es una condición concreta que la historia tiene que cumplir para darla por terminada, y que se puede comprobar con un sí o un no. Es la tercera C hecha texto.
La forma más usada es dado, cuando, entonces (Given-When-Then), que desarrollaron Daniel Terhorst-North y Chris Matts como parte del desarrollo guiado por comportamiento (BDD, behavior-driven development), según cuenta Martin Fowler en la lectura:
- Dado (given): el estado del mundo antes de la acción. Las precondiciones del ejemplo: qué día y hora es, qué reservas hay, quién es la persona.
- Cuando (when): la acción que se especifica. Una sola.
- Entonces (then): el resultado observable que se espera.
Un ejemplo con datos de Kallpa:
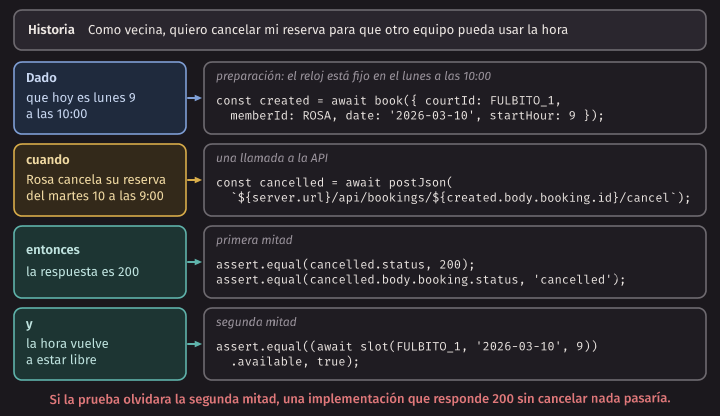
Dado que hoy es lunes 9 de marzo a las 10:00, cuando Rosa cancela su reserva del martes 10 a las 9:00, entonces la respuesta es
200y la hora vuelve a estar libre.
Fowler señala que es la misma estructura de cualquier buena prueba: lo que Gerard Meszaros llama four-phase test (preparar, ejercitar, verificar, limpiar) y lo que Bill Wake llamó Arrange, Act, Assert. No es casualidad: un criterio de aceptación bien escrito es una prueba que todavía no está automatizada.
Los issues de P0 están escritos así. Miren por ejemplo los criterios de Con dos reservas seguidas se pasa el límite de 3 horas: cada uno dice quién, cuándo, en qué cancha, qué pide y qué responde el sistema, con el código de error exacto. Úsenlos de modelo.
Verificable quiere decir que dos personas harían la misma prueba
El enunciado de P1 da una definición práctica: un criterio es verificable si dos personas, leyéndolo, harían la misma prueba. Comparen:
| Criterio | ¿Dos personas harían la misma prueba? |
|---|---|
| Entonces la reserva es fácil de hacer. | No. ¿Fácil para quién? ¿Cómo se mide? |
| Entonces el sistema responde bien. | No. ¿Qué es “bien”? |
| Entonces se muestra un error. | Casi. ¿Qué error? ¿Con qué código? |
Entonces la respuesta es 422 con el código TOO_LATE_TO_CANCEL y la reserva sigue confirmada. |
Sí. |
Para llegar ahí, los criterios usan datos concretos: una fecha, una hora, una cancha, una persona, un monto. “Dado una reserva” obliga a quien prueba a inventar la reserva; “dado que Rosa tiene la cancha 1 el martes 10 de 9:00 a 10:00” no. Los datos de ejemplo de Kallpa están pensados para esto: la cancha 1 es de fulbito, la 3 de vóley, Rosa Quispe (miembro 1) es regular y Luis Huamán (miembro 2) es socio, y las pruebas usan un reloj fijo en el lunes 9 de marzo de 2026 a las 10:00.
Cuántos criterios y cuáles
Una historia importante lleva varios criterios: el caso normal, los casos límite y los casos de error. Para “cancelar mi reserva”:
- Dado que hoy es lunes 9 a las 10:00, cuando Rosa cancela su
reserva del martes 10 a las 9:00, entonces la respuesta es
200y la hora vuelve a estar libre. (El caso normal.) - Dado que hoy es lunes 9 a las 10:00, cuando Rosa cancela su
reserva de hoy a las 12:00, entonces la respuesta es
422con el códigoTOO_LATE_TO_CANCELy la reserva sigue confirmada. (Un error: faltan 2 horas.) - ¿Y si faltan exactamente 3 horas? La regla del README dice “hasta 3 horas antes”. El criterio tiene que decidir si “hasta” incluye el borde, y esa decisión es del cliente. (El caso límite; queda como ejercicio.)
Los casos límite son donde viven los errores: justo a las 3 horas, justo a las 18:00 cuando empieza la hora punta, justo 14 días después. Las semanas de pruebas vuelven a ellos. Si el criterio no dice qué pasa en el borde, cada developer decide por su cuenta, y lo más probable es que decidan distinto.
Comportamiento, no implementación
Un criterio describe lo que se observa desde fuera: lo que ve el vecino en la página, lo que responde la API, lo que queda en la caja del día. No describe cómo se construye.
- Mal: “Dado un mantenimiento nuevo, cuando se guarda, entonces se agrega
una fila a la tabla
blockscon la columnareason”. - Bien: “Dado ese mantenimiento, cuando Rosa intenta reservar la cancha de
vóley el martes 10 a las 17:00, entonces la respuesta es
409con el códigoSLOT_TAKEN”.
El primero ata el requisito a un diseño que todavía no existe y que el
cliente no puede validar: Doris no sabe qué es una columna. El segundo lo
puede leer ella, y lo puede cumplir cualquier diseño. Un código de error de
la API como SLOT_TAKEN sí está bien en un criterio: es parte del
comportamiento observable, el contrato que la página y cualquier otro
cliente HTTP usan (el README de Kallpa lo llama “un código estable que los
clientes HTTP pueden comparar sin leer el mensaje”).
Error común. Criterios que no se pueden verificar (“la reserva es fácil de hacer”, “el sistema responde bien”) o que describen la implementación (“se agrega una columna
recurringa la tabla”). Los dos tienen el mismo defecto: nadie puede usarlos para decidir si la historia está terminada. El primero no tiene una prueba posible; el segundo tiene una prueba que no le importa al cliente.
Los criterios, ejecutados
Un criterio bien escrito se puede convertir en una prueba casi palabra por
palabra. En criterios.test.ts están
los criterios de este capítulo sobre las reglas que Kallpa ya cumple,
escritos como pruebas con node:test contra el servidor de prueba de
Kallpa. Cada describe es una historia y cada test es un criterio:
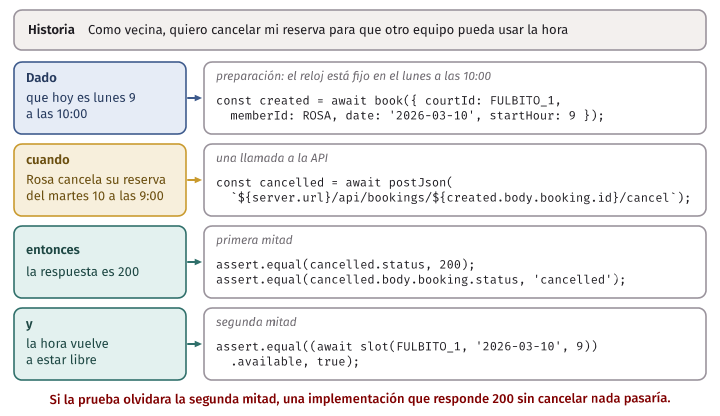
describe('Como vecina, quiero cancelar mi reserva para que otro equipo pueda usar la hora', () => {
  test('dado que hoy es lunes 9 a las 10:00, cuando Rosa cancela su reserva del martes 10 a las 9:00, entonces la respuesta es 200 y la hora vuelve a estar libre', async () => {
    const created = await book({ courtId: FULBITO_1, memberId: ROSA, date: '2026-03-10', startHour: 9 });
    assert.equal(created.status, 200);
    assert.equal((await slot(FULBITO_1, '2026-03-10', 9)).available, false);

    const cancelled = await postJson(`${server.url}/api/bookings/${created.body.booking.id}/cancel`);
    assert.equal(cancelled.status, 200);
    assert.equal(cancelled.body.booking.status, 'cancelled');
    assert.equal((await slot(FULBITO_1, '2026-03-10', 9)).available, true);
  });
El dado se vuelve la preparación (crear la reserva de Rosa con el reloj
fijo en el lunes a las 10:00), el cuando es una llamada a la API y el
entonces son las verificaciones. Fíjense en que la prueba comprueba las
dos mitades del entonces: el 200 y que la hora vuelve a estar libre. Si
se olvidara de la segunda, una implementación que responde 200 sin
cancelar nada pasaría.
Corridas en el contenedor, las doce pruebas de criterios pasan:
$ node --test criterios.test.ts
...
✔ Como vecino, quiero saber cuánto voy a pagar para no llevarme sorpresas en la caja (6.972125ms)
ℹ tests 12
ℹ suites 3
ℹ pass 12
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 171.108208
Hay dos cosas que este ejemplo no muestra y que conviene tener presentes. La primera: estas pruebas pasan porque Kallpa ya cumple esas reglas. Con una historia nueva, los criterios se escriben antes del código, y sus pruebas fallan hasta que alguien implementa la historia; eso es lo que harán en la semana 4 con una especificación y en la semana 9 con TDD. La segunda: la historia del precio pide ver el monto antes de confirmar, y Kallpa hoy lo muestra recién después, en el mensaje “Reserva confirmada”. Las pruebas fijan los montos que la página tendría que mostrar, pero no comprueban el “antes”: esa parte de la historia todavía no está construida. Un criterio puede ser perfectamente verificable y, aun así, no cumplirse.
Requisitos no funcionales como criterios
Un requisito no funcional también se puede escribir como criterio, con las condiciones en el dado:
Dado un celular con la red limitada a 4G en las herramientas de desarrollo del navegador, cuando se abre la disponibilidad de la cancha 1, entonces las horas aparecen en menos de 1 s.
Si el requisito vale para todas las historias, no tiene sentido repetirlo en cada una: va en la Definition of Done de la semana 2. Por ejemplo, “toda pantalla nueva se puede usar solo con el teclado” o “ninguna respuesta de la API tarda más de 500 ms con los datos de ejemplo” son condiciones que cada historia tiene que cumplir para estar terminada.
Un revisor automático, y lo que no puede revisar
Algunos defectos de una historia se pueden encontrar con un programa:
palabras vagas, un entonces que falta, un criterio sin ningún dato
concreto. En revisar-historias.ts
hay un revisor pequeño que lee un archivo Markdown con el formato de P1
(## HU-NN · Título, la frase “Como…, quiero… para…” y criterios que
empiezan con Dado) y marca esos defectos. Pasado por un primer borrador
de las historias del mantenimiento
(historias-con-problemas.md):
$ node revisar-historias.ts historias-con-problemas.md
HU-01: el rol es genérico: «usuario»
HU-01 · criterio 1: palabra vaga «rápido»: ¿cómo se comprueba?
HU-01 · criterio 1: palabra vaga «bien»: ¿cómo se comprueba?
HU-01 · criterio 1: no tiene datos concretos: ni una hora, ni una fecha, ni un monto
HU-01 · criterio 2: habla de la implementación («tabla»), no del comportamiento
HU-01 · criterio 2: habla de la implementación («columna»), no del comportamiento
HU-01 · criterio 2: no tiene datos concretos: ni una hora, ni una fecha, ni un monto
HU-02: no tiene criterios de aceptación
HU-03 · criterio 1: le falta el "entonces"
3 historias, 3 criterios, 9 observaciones
Y por la versión corregida
(historias-ejemplo.md):
$ node revisar-historias.ts historias-ejemplo.md
3 historias, 8 criterios, 0 observaciones
Cero observaciones no quiere decir que las historias sean buenas. El
revisor no ve que “como administradora del complejo, quiero bloquear la
cancha para bloquearla” tiene un beneficio que repite la acción (hay una prueba en
revisar-historias.test.ts
que lo comprueba: esa historia pasa sin observaciones). Tampoco ve si la
historia resuelve el problema de Doris, si el monto del criterio es el
correcto o si falta un caso. Esas preguntas solo las puede responder alguien
que estuvo en la entrevista. La revisión automática de P1 funciona igual:
el enunciado dice que “no juzga si las historias son buenas: eso lo revisan
el docente y el cliente”.
INVEST: revisar una historia antes del sprint
Las seis letras
Bill Wake propuso en 2003 una lista para revisar si una historia está lista para llevarla a un sprint, con la sigla INVEST; Mike Cohn la difundió en User Stories Applied (2004). La definición del glosario de Agile Alliance, que es una de las lecturas, dice que una buena historia es:
- Independiente (independent) de las demás: se puede entregar en cualquier orden.
- Negociable (negotiable): no es un contrato cerrado; los detalles se acuerdan entre el cliente y el equipo mientras se construye.
- Valiosa (valuable) para alguien concreto: el cliente o quien usa el sistema. Agile Alliance agrega “o vertical”: atraviesa todas las capas necesarias para que alguien la pueda usar.
- Estimable (estimable): el equipo puede darle una estimación razonable.
- S de pequeña (small): cabe en un sprint, y mejor si caben varias.
- Testeable (testable): se puede comprobar si está hecha, “en principio, aunque todavía no exista la prueba”.
Aplicada a historias de Kallpa:
| Historia | Letra que falla | Por qué |
|---|---|---|
| Como administradora, quiero ver con qué reservas choca un mantenimiento… | I (en parte) | Depende de que exista el mantenimiento (HU-01). Se puede vivir con eso: se ordena HU-01 primero. |
| Como vecino, quiero pagar por Yape al reservar… | E | Nadie en el equipo sabe todavía cómo se conectaría la página con un medio de pago. Primero un spike. |
| Como administradora, quiero que la página sea más moderna. | V, T | ¿Para qué? ¿Cómo se sabe que está hecho? |
| Como organizador, quiero manejar los torneos del barrio en la página. | S, E | Es una épica: inscripciones, fixture, resultados, cobros. Hay que dividirla. |
Como administradora, quiero separar una cancha con el ID de la tabla courts. |
N | Fija un detalle de diseño que no le importa al cliente y deja al equipo sin margen. |
No es una ley
INVEST es una lista de revisión, no un examen que una historia aprueba o desaprueba. Las letras a veces tiran en sentidos opuestos: dividir una historia para que sea pequeña suele crear dependencias entre las partes, y eso va contra la I. La glosa de Agile Alliance lo dice con suavidad: si una historia no cumple un criterio, el equipo puede querer reescribirla. Lo útil de INVEST es la conversación que provoca: “esta no la podemos estimar, ¿qué nos falta saber?” es una pregunta mucho mejor que “esta historia tiene una E en rojo”.
En la industria. El manual de GOV.UK pide que todo el equipo escriba historias de usuario y las use para seguir el trabajo, pensarlo desde la perspectiva de quien usa el servicio, conversarlo con colegas y priorizarlo. Llama épicas a las historias que tomarían más de unas semanas en desarrollarse y probarse, y pide dividirlas, si se puede, en historias que quepan en una iteración (Writing user stories).
Dividir historias
Por qué dividir
Una historia que no cabe en un sprint no se puede terminar en un sprint: se arrastra, nadie sabe cuánto falta y el cliente no ve nada hasta el final. Es la cascada de la semana 2 metida dentro de un ítem del backlog. Una historia de 13 puntos o más, decíamos la semana pasada, se divide.
La pregunta es cómo. La división correcta produce partes que cada una le sirve a alguien por sí sola: se puede mostrar al cliente, usar y validar. Cada parte es un corte vertical que atraviesa la página, la API y la base de datos, aunque sea delgado.
Error común. Dividir por capas técnicas: “HU-07a: la tabla de torneos”, “HU-07b: el endpoint”, “HU-07c: la pantalla”. Ninguna de las tres le sirve sola al cliente; recién las tres juntas hacen algo. El cliente no puede validar la tabla, y si al final la pantalla revela que el modelo de datos estaba mal, ya se construyeron las dos capas de abajo. Son tareas del equipo dentro de una historia, no historias.
SPIDR
Mike Cohn propone cinco formas de dividir, con la sigla SPIDR (en las lecturas complementarias). Tomemos una épica que podría pedir la junta:
Como organizador de un campeonato del barrio, quiero inscribir equipos y programar los partidos en las canchas del complejo para no armar el fixture a mano en un cuaderno.
- Spike (investigar primero). Cuando el equipo no sabe lo suficiente para estimar, separa la investigación: “averiguar, en un día, cómo se genera un fixture de todos contra todos para 8 equipos y cuántas horas de cancha ocupa”. El spike no entrega una función; entrega lo que el equipo necesita saber para estimar las demás. Cohn dice que es una técnica esencial, pero no la primera que uno usa.
- Path (por caminos). Si hay varias formas de hacer algo, cada camino puede ser una historia. Primero el camino feliz (inscribir un equipo y que aparezca en el fixture); después los alternativos (un equipo que se retira a mitad del campeonato, un partido que se reprograma).
- Interface (por interfaces). Primero una versión sencilla de la interfaz, después la completa: el fixture lo arma la administración desde la computadora de la oficina y se publica como una lista; más adelante, una página para ver el fixture desde el celular, con filtros por equipo.
- Data (por datos). Primero solo un tipo de dato o de caso: un campeonato solo de fulbito, todos contra todos; después vóley y básquet, y el formato con eliminatorias.
- Rules (por reglas). Primero sin una regla del negocio, después con ella: inscripción sin cobro; luego con cobro de inscripción y el descuento de socio.
No hace falta usar las cinco. Se busca la división que deja una primera parte pequeña y útil, y que deja para después lo más incierto o lo menos valioso.
Lo que se pierde al dividir
Dividir tiene costo: más tarjetas, más dependencias, más criterios que mantener coherentes. Si “inscribir un equipo” y “retirar un equipo” quedan en sprints distintos, alguien tiene que acordarse de que la segunda cambia el fixture que armó la primera. Por eso se divide lo necesario para que quepa y para aprender pronto, no hasta llegar a historias de un punto.
Priorizar
MoSCoW
Un backlog siempre tiene más trabajo que tiempo. La priorización (prioritization) es decidir qué se hace primero y, sobre todo, qué no se hace. Una técnica sencilla y muy usada es MoSCoW, que propuso Dai Clegg en 1994 para el desarrollo rápido de aplicaciones (RAD) y que después adoptó el método DSDM. Clasifica cada requisito en una de cuatro categorías, siempre respecto de una entrega concreta:
- Must (debe): sin esto la entrega no sirve. Si falta un solo Must, la entrega fracasó. Hay quien lee MUST como Minimum Usable SubseT, el mínimo subconjunto usable.
- Should (debería): importante, pero hay forma de seguir sin él por ahora, por ejemplo con un trabajo manual.
- Could (podría): deseable; entra si sobra tiempo.
- Won’t (esta vez no): se acordó que no entra en esta entrega, y se dice explícitamente.
Las palabras importan más que en una escala de alta, media y baja. Decirle al cliente “esto es un Should” lo obliga a pensar: ¿hay forma de seguir sin esto? Si la respuesta es sí, no es Must.
Un backlog de la primera entrega del mantenimiento, de una semana:
| Prioridad | Historia | Por qué |
|---|---|---|
| Must | HU-01 · Separar una cancha para mantenimiento | Es el problema del martes: sin esto, el mantenimiento sigue chocando con reservas nuevas. |
| Should | HU-02 · Ver con qué reservas choca un mantenimiento | Doris puede revisar la disponibilidad a mano mientras tanto, como hoy. |
| Could | HU-04 · Avisar por WhatsApp a los equipos afectados | Útil, pero Doris ya llama por teléfono. Y hoy Kallpa escribe el aviso solo en la consola del servidor. |
| Won’t | HU-05 · Mantenimientos que se repiten cada mes | El técnico no tiene fecha fija: avisa con dos o tres días. Se revisa si eso cambia. |
El Won’t de la última fila es tan útil como el Must de la primera: deja escrito que se habló, por qué se decidió no hacerlo y qué tendría que cambiar para reconsiderarlo. Sin él, el pedido vuelve en cada reunión.
Error común. Que todo sea Must. Si todo es Must, nada lo es, y la priorización no sirve para decidir nada cuando el tiempo se acaba. Una forma de comprobarlo: “si mañana solo pudiéramos entregar esto, ¿el cliente lo usaría?”. Lo que no pasa esa pregunta no es Must.
MoSCoW tiene límites conocidos. No ayuda a ordenar dentro de una misma categoría (¿cuál de los cinco Should va primero?), no dice por qué algo es Must y no Should, y el Won’t se presta a confusión: ¿no entra en esta entrega, o no entra nunca? Por eso P1 pide, además de las cuatro secciones, que dentro de cada una el orden sea el orden de trabajo, y que el Won’t diga por qué.
Valor, costo y riesgo
Para ordenar, MoSCoW se complementa con tres preguntas.
- Valor: ¿cuánto le sirve al cliente? Lo dice el cliente, con su problema: el martes del técnico, los reclamos en la caja.
- Costo: ¿cuánto trabajo es? Lo dice el equipo, con la estimación de la semana 2.
- Riesgo: ¿qué tan incierto es? ¿Qué no sabemos todavía?
Las dos primeras dan una regla simple: primero lo de mucho valor y poco costo; lo de poco valor y mucho costo, quizás nunca. La tercera corrige la regla: lo más incierto se hace temprano, aunque no sea lo más valioso, porque es donde más se aprende y porque descubrir tarde que algo no se puede hacer es lo más caro. Si el cliente considera esencial avisar por WhatsApp de verdad (no solo en la consola), conviene un spike en el primer sprint para averiguar qué hace falta, aunque la historia completa quede para después.
Quién decide
En Scrum, el product owner ordena el backlog; es una de sus
responsabilidades en la Scrum Guide. El equipo informa el costo y los
riesgos; el cliente y los stakeholders dicen el valor. En P1, el product
owner trabaja con el cliente: el backlog priorizado se acuerda con él, y
docs/cliente.md registra cuándo y cómo lo aprobó. Un backlog que el
equipo priorizó solo es una hipótesis sobre lo que el cliente quiere.
Con IA: encontrar huecos sin inventar requisitos
Una herramienta de IA es buena revisora de historias: lee rápido, conoce miles de sistemas parecidos y no se cansa de preguntar “¿y si…?”. Esa misma cualidad es el riesgo. Sabe cómo suelen ser los sistemas de reservas, no cómo es este complejo, y presenta lo que sabe de los sistemas en general con la misma seguridad que lo que se desprende de las historias.
Supongan que le piden a una herramienta que revise HU-01, la de separar la cancha para mantenimiento. Una respuesta como las que suelen dar estas herramientas, escrita para la clase, podría traer:
- ¿Qué pasa si el mantenimiento choca con una reserva ya confirmada?
- ¿Un mantenimiento puede durar más de 3 horas, que es el máximo de una reserva?
- Los vecinos afectados por un mantenimiento reciben automáticamente un reembolso del 100 %.
- El mantenimiento se puede programar con hasta 60 días de anticipación.
- ¿Qué pasa si el mantenimiento cae en un feriado?
- Agregar un calendario mensual de mantenimientos para el técnico.
Cada ítem se clasifica antes de usarlo:
| Ítem | Qué es | Qué se hace |
|---|---|---|
| 1 | Una pregunta que ya se respondió: es HU-02. | Nada nuevo. Confirma que HU-02 tiene sentido. |
| 2 | Una buena pregunta: el límite de 3 horas es de las reservas, y no sabemos si vale para el mantenimiento. Pintar las líneas toma el día entero. | Pregunta para Doris. |
| 3 | Una regla inventada. Nadie habló de reembolsos, y las devoluciones son una decisión de dinero que toma la junta. | No entra. Si parece importante, pregunta para la junta. |
| 4 | Un número inventado con apariencia de dato. Doris dijo que el técnico avisa con dos o tres días; nadie dijo 60. | No entra. La pregunta real es si hace falta un límite. |
| 5 | Una buena pregunta. | Pregunta para Doris. |
| 6 | Una historia nueva sin nadie que la haya pedido. | A la lista de ideas por validar; no al backlog. |
Idea clave. Cada caso nuevo que propone una herramienta es una pregunta para el cliente, no un requisito. Los ítems 3 y 4 son los peligrosos: están escritos como reglas, con números concretos, y si se copian a una historia nadie recordará después que no los dijo nadie. La prueba es la de la rastreabilidad: ¿a qué nota de entrevista se puede rastrear? Si a ninguna, no es un requisito.
Lo que se hace con el resultado también se registra. En P1, el archivo
docs/registro-ia.md lleva una fila por cada uso que influyó en la entrega,
con lo que se aceptó y lo que se rechazó y por qué:
| Fecha | Herramienta | Qué se pidió | Qué se aceptó | Qué se rechazó y por qué |
|---|---|---|---|---|
| 2026-03-10 | (la que usaron) | Revisar HU-01 y proponer casos que falten | Preguntas 2 y 5, para la siguiente entrevista | Reembolso automático y límite de 60 días: nadie del complejo los dijo |
En el laboratorio
El laboratorio es el capítulo entero en dos horas, con un pedido nuevo. Doris escribe:
“Los equipos de siempre quieren tener su hora fija todas las semanas, como la liga de vóley de los jueves. ¿Se puede hacer en la página?”
Fíjense en que es, otra vez, una solución (“en la página”) con un problema detrás que todavía no conocemos. El docente hace de Doris con una tarjeta de personaje que ustedes no leen: sabe muchas cosas sobre cómo funcionan hoy las horas fijas de los equipos, y solo las cuenta si se le pregunta bien. Como un cliente real, tiene poco tiempo, responde con generosidad a las preguntas abiertas y con un “sí, claro” a las que inducen la respuesta.
Los pasos están en la guía de la semana. Algunas recomendaciones, con lo visto en este capítulo:
- Al preparar, escriban un objetivo que no mencione la solución y una guía en embudo, con al menos tres preguntas del tipo “¿cómo fue la última vez que…?”. Al revisar la guía de otro grupo, marquen las preguntas que se responden con “sí, claro”.
- Al entrevistar, como hay una sola entrevista para toda la clase, escuchen las respuestas a las preguntas de los demás grupos: muchas veces la mejor pregunta es la repregunta de lo que acaba de decir Doris. Anoten también lo que no sabe y a quién habría que preguntarle.
- Al ordenar las notas, las tres listas (dijo, suponemos, falta preguntar) y un glosario donde quede claro qué es para Doris un turno fijo y una temporada. No asuman que lo saben.
- Al escribir las historias, usen los datos de Kallpa (canchas, vecinos, códigos de error del README) y pregúntense cómo encaja lo que dijo Doris con las reglas que Kallpa ya tiene: ¿qué pasa con las que no encajan?
- Al priorizar, la primera entrega es de una semana. Un Won’t bien justificado vale más que un Must que no cabe.
- Al validar, anoten lo que Doris corrige en las historias de los demás grupos: también vale para las suyas.
Al final, cada historia va como issue al tablero de la semana 2, con la
etiqueta turnos-fijos, sus puntos y la prioridad. Desde la terminal de su
computadora, o dentro del contenedor después de gh auth login:
gh label create turnos-fijos --color 0E8A16 --description "Horas fijas de los equipos"
gh issue create --title "HU-01 · ..." --body-file hu-01.md --label turnos-fijos
Las historias no se implementan. En la semana 4 escribirán un design doc para esta funcionalidad, y en la semana 5 tendrán que decidir si un turno fijo es un concepto nuevo o una forma de usar la reserva que ya existe; las historias y el glosario de hoy son la entrada de esas dos decisiones.
Esta semana también se entrega P0 (el pull request de su issue, con
make check ISSUE=NN en verde) y se publica
P1, que pide hacer todo lo de este
capítulo con un cliente real: proponer el cliente al docente es la primera
tarea.
El código de la semana y make test
make copia el código de Kallpa en build/kallpa, y las pruebas de
aceptación corren contra esa copia, con la base de datos en memoria y el
reloj fijo de las pruebas de Kallpa. make test corre todas las pruebas de
la carpeta:
$ make test
...
✔ las historias de ejemplo del capítulo no tienen observaciones (2.061542ms)
✔ el borrador con problemas tiene las 9 observaciones del capítulo (0.852667ms)
✔ "bien" dentro de "también" no es una palabra vaga (0.131ms)
✔ un criterio puede seguir en las líneas siguientes, con sangría (0.986791ms)
✔ no detecta un beneficio que repite la acción: eso lo ve una persona (0.151416ms)
✔ las secciones que no son historias se ignoran (0.087958ms)
ℹ tests 18
ℹ suites 3
ℹ pass 18
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 183.007417| Archivo | Qué muestra |
|---|---|
criterios.test.ts |
Los criterios de aceptación del capítulo sobre reglas que Kallpa ya cumple (cancelar, horas ocupadas, horas que ya pasaron, los 14 días, el máximo de 3 horas y los precios de una hora), como pruebas contra el servidor de prueba de Kallpa |
revisar-historias.ts |
El revisor de historias: la frase, el rol, las tres partes de cada criterio, palabras vagas y de implementación, datos concretos |
revisar-historias.test.ts |
Lo que el revisor encuentra y lo que no puede encontrar |
historias-ejemplo.md |
Las historias del mantenimiento y del precio, con sus criterios |
historias-con-problemas.md |
El primer borrador, con los defectos que marca el revisor |
make revisar pasa el revisor por los dos archivos de historias, y make typecheck revisa los tipos con tsc. El revisor sirve también para sus
historias de P1: desde la carpeta de su repositorio, dentro del
contenedor, node /work/code/week-03/revisar-historias.ts docs/historias.md.
No reemplaza a la
revisión automática de P1 (make -f /work/projects/p1-requisitos/Makefile check) ni a la revisión del docente y del cliente.
Resumen
- Un requisito es una condición que el sistema tiene que cumplir para que el cliente resuelva su problema, y que está escrita. Los funcionales dicen qué hace el sistema; los no funcionales, cómo de bien lo hace, y necesitan un número (qué, dónde, cuánto y cómo se mide). Las restricciones se cumplen o no, sin grados.
- Las reglas del negocio son del cliente, los requisitos son lo que el sistema hace para cumplirlas y las decisiones de diseño son del equipo. Mezclarlas ata el requisito a un diseño o deja una regla sin owner.
- El cliente suele llegar con una solución; el trabajo es encontrar el problema, porque con él aparecen otras soluciones. La pregunta que más ayuda es “¿cómo fue la última vez que…?”.
- Elicitar es descubrir los requisitos con varias técnicas, porque cada una ve cosas distintas: en una entrevista la gente cuenta lo que cree que hace; observando se ve lo que hace. Se entrevista a varios stakeholders.
- Una entrevista se prepara con un objetivo que no menciona la solución, una guía en embudo y roles. Durante la entrevista: preguntas abiertas antes que cerradas, el último caso concreto, nada de preguntas inductoras, repreguntar y repetir lo entendido. Después: notas el mismo día en tres listas (dijo, suponemos, falta preguntar) y un glosario.
- Cada requisito se rastrea hasta una nota o una aprobación del cliente, y hacia adelante hasta el criterio y la prueba que lo comprueban.
- Una historia de usuario (“Como…, quiero… para…”) es una promesa de conversación, con un rol concreto y un beneficio real. Tiene tres C: card, conversation y confirmation.
- Un criterio de aceptación dado, cuando, entonces es verificable si dos personas harían la misma prueba: datos concretos, el caso normal, los límites y los errores, y comportamiento observable, no implementación. Un buen criterio es una prueba que todavía no está automatizada.
- INVEST es una lista para revisar una historia antes de un sprint, no una ley. Las historias grandes se dividen en cortes verticales, con SPIDR, y nunca por capas técnicas.
- MoSCoW clasifica respecto de una entrega (Must, Should, Could, Won’t), y se complementa con valor, costo y riesgo: lo incierto, temprano. El product owner ordena el backlog con el cliente.
- Una herramienta de IA encuentra huecos en las historias; cada caso que propone es una pregunta para el cliente, no un requisito.
Ejercicios
- Clasifiquen como requisito funcional, no funcional o restricción, y reescriban los que no se puedan verificar: (a) “la página carga rápido”; (b) “los socios ven su descuento antes de confirmar”; (c) “la aplicación guarda los datos en el Perú”; (d) “la caja del día cuadra con lo cobrado”; (e) “la página funciona en celulares viejos”.
- Doris pide: “quiero que la página mande un recordatorio a los equipos un día antes”. Escriban cinco preguntas para encontrar el problema detrás del pedido, al menos dos del tipo “¿cómo fue la última vez que…?”. ¿Qué otras soluciones podrían aparecer?
- Reescriban como preguntas abiertas que no induzcan la respuesta: (a) “¿Les gustaría poder pagar por Yape?”; (b) “¿No es un problema que la página no tenga app?”; (c) “¿Los vecinos prefieren reservar por WhatsApp, verdad?”; (d) “¿Le serviría un reporte mensual?”.
- Estas son notas tomadas en una entrevista con la persona de la caja: “dice que el sistema es lento, que la mayoría paga en efectivo, hay que agregar Yape, el cuadre lo hace a las 22:30, a veces no cuadra por 10 o 20 soles”. Ordénenlas en las tres listas (dijo, suponemos, falta preguntar). ¿Qué falta para que “el sistema es lento” sirva de algo?
- La regla de Kallpa dice que una reserva se puede cancelar “hasta 3 horas antes de que empiece”. Escriban el criterio dado, cuando, entonces para el caso límite: hoy es lunes 9 a las 10:00 y la reserva es hoy a las 13:00. ¿Qué tendrían que preguntarle a Doris antes de escribirlo? ¿Qué otros bordes tiene la misma regla?
- Escriban tres criterios de aceptación (el caso normal, un límite y un error) para “Como socio, quiero ver el precio con mi descuento antes de reservar, para saber cuánto llevar a la caja”. Usen datos concretos de Kallpa y montos de una sola hora. ¿Qué letra de INVEST cumple peor esta historia?
- Revisen con INVEST estas historias y digan qué letra falla y cómo la arreglarían: (a) “Como usuario, quiero un sistema de puntos para premiar a los vecinos frecuentes”; (b) “Como administradora, quiero la tabla de feriados”; (c) “Como vecino, quiero que la página sea intuitiva”; (d) “Como persona de la caja, quiero ver la caja del día por cancha, por hora, por medio de pago, con gráficos y exportable a Excel”.
- Dividan con SPIDR la épica “Como junta directiva, quiero ver reportes del uso de las canchas para decidir las tarifas del próximo año”. Den al menos tres historias, digan qué técnica usaron en cada una y cuál iría primero.
- Prioricen con MoSCoW, para una primera entrega de una semana, las historias del ejercicio 8 junto con HU-01 a HU-05 de este capítulo. Justifiquen al menos un Won’t. ¿Hay algo que harían primero por riesgo, aunque no sea lo más valioso?
- Pídanle a una herramienta de IA que revise las historias de
historias-ejemplo.mdy clasifiquen cada sugerencia como en la tabla de la sección Con IA: pregunta para el cliente, regla o número inventado, ya respondida o historia nueva sin fuente. Escriban la fila del registro de uso de IA. - Pasen el revisor por sus historias del laboratorio
(
node revisar-historias.ts). Para cada observación, decidan si es un defecto real o un falso positivo. Después escriban una historia que tenga un defecto grave y pase el revisor sin observaciones. ¿Qué tipo de defectos no puede ver ningún revisor automático? - Para el proyecto: escriban el objetivo y la guía de su primera entrevista con el cliente de P1 (10 a 12 preguntas en embudo). Intercambien la guía con otro equipo y marquen las preguntas inductoras y las que suponen una solución.