Apuntes · Capítulo 2Proceso y requisitos
Procesos, planificación y estimación
Procesos, planificación y estimación
La semana pasada definimos la ingeniería de software como programación integrada en el tiempo: código que va a vivir años, que van a cambiar muchas personas y cuyas decisiones tienen costos. En el laboratorio trabajaron con Git en parejas: ramas, pull requests, un conflicto de merge. Eso resuelve cómo dos personas cambian el mismo código sin pisarse. No resuelve otra pregunta igual de importante: qué cambia el equipo, en qué orden, y cómo sabe si va bien.
Esta semana estudiamos los acuerdos con que un equipo organiza su trabajo. En la primera parte comparamos los procesos más conocidos: la cascada, el desarrollo iterativo e incremental, Scrum y Kanban. No buscamos el proceso correcto, porque no existe en abstracto. Buscamos entender qué supone cada uno sobre los requisitos, el riesgo y la retroalimentación, para elegir con criterio. Leeremos Scrum tal como lo define su guía oficial de 2020, porque mucho de lo que se dice de Scrum en internet no está en ella.
En la segunda parte pasamos a la planificación: qué es una estimación y en qué se diferencia de un compromiso, cómo se estima con story points y planning poker, qué mide la velocity y cómo se planifica un sprint con ella. Cerramos con un caso que no es de software de reservas sino de aviación: el Boeing 737 MAX. Dos accidentes, 346 muertos, y un informe del Congreso de Estados Unidos que muestra cómo la presión de calendario y costo, unos supuestos equivocados y la información ocultada pueden más que cualquier buena práctica de programación.
En el laboratorio, el grupo convierte el backlog de partida de Kallpa en issues de GitHub, arma un tablero, escribe su Definition of Done, estima con planning poker y planifica un sprint. Es un ensayo de lo que harán con su cliente real desde la semana 5.
Lectura. Para la Sesión A, la Scrum Guide de 2020, completa (también está en español), y el Manifiesto por el Desarrollo Ágil de Software con sus doce principios. Complementarias: The Kanban Guide (Vacanti y Coleman), y Atlassian, Scrum y Kanban. Para la Sesión B, el resumen ejecutivo (págs. 4–33) del informe del House Committee on Transportation and Infrastructure, Final Committee Report: The Design, Development & Certification of the Boeing 737 MAX (septiembre de 2020), y su comunicado de prensa; Mountain Goat Software, Planning Poker y What Are Story Points?. Complementarias: Software Engineering at Google (SWEG), cap. 7, Measuring Engineering Productivity; Martin Fowler, StoryPoint, y Agile Alliance, Velocity. El código del capítulo y el backlog del laboratorio están en
code/week-02y se prueban conmake testdentro del contenedor del curso (./env/run.sh).
Ruta de lectura.
- Antes de clase (obligatorio, unos 20 minutos): Qué es un proceso de desarrollo; de La cascada, Cuándo funciona y cuándo no; de Desarrollo iterativo e incremental, Dos ideas que suelen ir juntas; de El Manifiesto Ágil, Cuatro valores; de Scrum según la Scrum Guide 2020, El Scrum Team y sus tres responsabilidades, Los cinco eventos y Los tres artefactos y sus compromisos; y de las secciones de estimación, Estimación, compromiso y objetivo y Una medida relativa.
- En clase: Sesión A: La cascada, Desarrollo iterativo e incremental, El Manifiesto Ágil, Scrum según la Scrum Guide 2020, Kanban con la ley de Little y ¿Cuál elegir?. Sesión B: Estimar no es prometer, Story points, Planning poker, Dividir un pedido grande, Velocity y planificación de un sprint y Caso: el Boeing 737 MAX. Laboratorio: En el laboratorio.
- Después de clase: el Resumen y los Ejercicios. Para profundizar: Doce principios, Lo que la Scrum Guide no dice, La velocity no es una meta, El código de la semana y
make testy las lecturas del recuadro Lectura.
Qué es un proceso de desarrollo
Una definición
Un proceso de desarrollo es el acuerdo de un equipo sobre cómo pasa el trabajo de una idea a software en uso. Todo proceso, escrito o no, responde cuatro preguntas:
- Quién decide qué se construye. ¿El cliente, una persona del equipo, un comité, quien grita más fuerte?
- En qué orden. ¿Lo más valioso primero, lo más riesgoso primero, lo que pidió el último que llamó?
- Cada cuánto se entrega. ¿Una vez al final, cada mes, cada vez que algo está listo?
- Cómo se corrige el rumbo. ¿Cuándo y con qué información se decide que el plan cambió?
Un equipo que dice “nosotros no tenemos proceso” también responde esas cuatro preguntas, solo que sin haberlo conversado: decide quien está más cerca del teclado, el orden es el de los mensajes de WhatsApp, se entrega cuando alguien se acuerda y el rumbo se corrige cuando el cliente se queja. Eso también es un proceso. Uno malo, porque nadie lo puede inspeccionar ni mejorar.
Cada proceso es una apuesta
No hay un proceso correcto en abstracto. Cada proceso hace una apuesta sobre dos cosas:
- Qué tan estables son los requisitos. Si lo que hay que construir se conoce bien desde el inicio y casi no cambia, conviene planificarlo todo y ejecutarlo. Si se va a descubrir en el camino, conviene avanzar en pasos cortos y mirar el resultado.
- Qué tan caro es cambiar. Cambiar el diseño de un puente cuando ya está construido cuesta muchísimo; cambiar el texto de un botón en una página web cuesta minutos. Cuando corregir tarde es carísimo, se invierte más en decidir bien al principio. Cuando es barato, se gana más aprendiendo rápido.
Detrás de las dos está el riesgo: la probabilidad de construir algo que no sirve, de llegar tarde o de gastar más de lo previsto, por el daño que eso causaría. Y la herramienta para bajar el riesgo es la retroalimentación: información sobre si vamos bien, que llega a tiempo para cambiar algo. Un proceso se puede describir por cada cuánto produce retroalimentación y de quién: de las pruebas, de una revisión de código, del cliente que usa el software.
Idea clave. Un proceso es el acuerdo de un equipo sobre quién decide qué se construye, en qué orden, cada cuánto se entrega y cómo se corrige el rumbo. Elegirlo es apostar sobre qué tan estables son los requisitos y qué tan caro es cambiar. La pregunta útil no es “¿cuál es el mejor proceso?” sino “¿cada cuánto y de quién recibimos retroalimentación, y a qué costo?”.
La cascada
Las fases
En la cascada (waterfall) el trabajo pasa por fases, una después de otra:
- Requisitos. Se escribe qué tiene que hacer el sistema, completo, y el cliente lo aprueba.
- Diseño. Se decide cómo: la arquitectura, los módulos, la base de datos.
- Implementación. Se escribe el código según el diseño.
- Verificación. Se prueba que el sistema cumpla los requisitos.
- Mantenimiento. Se corrige y se ajusta lo que ya está en uso.
Entre una fase y la siguiente pasa un documento: la especificación de requisitos, el documento de diseño, el código, el informe de pruebas. Cada documento se aprueba antes de empezar la fase siguiente, y volver atrás es una excepción que se trata como un problema.
Imaginen Kallpa hecha así. Durante dos meses el equipo entrevista a la administración y escribe un documento de cuarenta páginas con todas las reglas: horario, precios, cancelaciones, la caja del día. Doris lo firma. Un mes de diseño. Dos meses de programación. Un mes de pruebas. Al sexto mes, Doris ve por primera vez una pantalla y dice: “¿Y dónde se ve quién tiene la cancha? Eso es lo primero que preguntan los vecinos”. Ese requisito no estaba en el documento porque a nadie se le ocurrió preguntarlo, y a Doris no se le ocurrió decirlo: para ella era obvio.
Cuándo funciona y cuándo no
La cascada funciona cuando se cumplen dos condiciones:
- Los requisitos se conocen y casi no cambian. Por ejemplo, adaptar un sistema de facturación a un formato que fija una norma tributaria: el formato está publicado, la fecha de vigencia también, y el cliente no va a cambiar de opinión porque la norma no es suya.
- Corregir tarde tiene un costo aceptable, o corregir temprano no es posible de todas formas. En sistemas donde cada versión pasa por una certificación larga, entregar algo a medias cada dos semanas puede no tener sentido.
Su riesgo principal es el que vimos con Doris: el cliente ve el producto al final, cuando cambiar es lo más caro. Todas las suposiciones del equipo sobre lo que el cliente quería se ponen a prueba juntas, el último mes. Si una estaba mal, lo que hay que rehacer puede incluir el diseño entero.
Error común. Creer que la cascada nació como una recomendación. El artículo que se suele citar como su origen es el de Winston Royce, Managing the Development of Large Software Systems (1970). Royce dibuja el modelo secuencial, dice que cree en la idea pero que esa forma de llevarla a cabo es riesgosa y propensa a fallar, porque las pruebas llegan al final y es ahí donde aparecen los problemas que obligan a rehacer el diseño. El resto del artículo propone cambios: un diseño preliminar antes del análisis, documentar el diseño, construir una primera versión piloto y luego la definitiva (“hacerlo dos veces”), planificar las pruebas e involucrar al cliente durante el proyecto. Royce no usa la palabra “cascada”, y tampoco describe un proceso ágil: describe una cascada con retroalimentación.
Desarrollo iterativo e incremental
Dos ideas que suelen ir juntas
En el desarrollo incremental, el sistema se entrega por partes: cada entrega agrega funcionalidad que se puede usar. En el desarrollo iterativo, el trabajo avanza en ciclos y cada ciclo revisa y mejora lo que ya existe con lo que se aprendió en el anterior. Son ideas distintas: se puede construir por partes sin volver nunca sobre lo hecho (incremental sin iterar), o rehacer el mismo prototipo varias veces antes de entregarlo (iterar sin entregar por partes). En la práctica casi siempre se combinan: ciclos cortos, al final de cada uno software que funciona y que agrega algo, y lo aprendido cambia el plan del ciclo siguiente.
Kallpa hecha así se ve de otra forma:
| Ciclo | Lo que se entrega | Lo que se aprende |
|---|---|---|
| 1 | Reservar una hora de una cancha | Que los vecinos quieren ver quién tiene la cancha ocupada |
| 2 | La disponibilidad con el nombre del equipo; reservas de 1 a 3 horas | Que hay que poder cancelar, y hasta cuándo |
| 3 | Las cancelaciones, con la regla de las 3 horas | Que la caja suma a mano lo del día |
| 4 | La caja del día para la administración | … |
Cada entrega es una pregunta al cliente: “¿esto es lo que necesitaban?”. Si la respuesta es no, se perdió un ciclo, no seis meses. El orden también importa: lo primero que se entrega es lo que más valor tiene o lo que más riesgo encierra, para aprender cuanto antes.
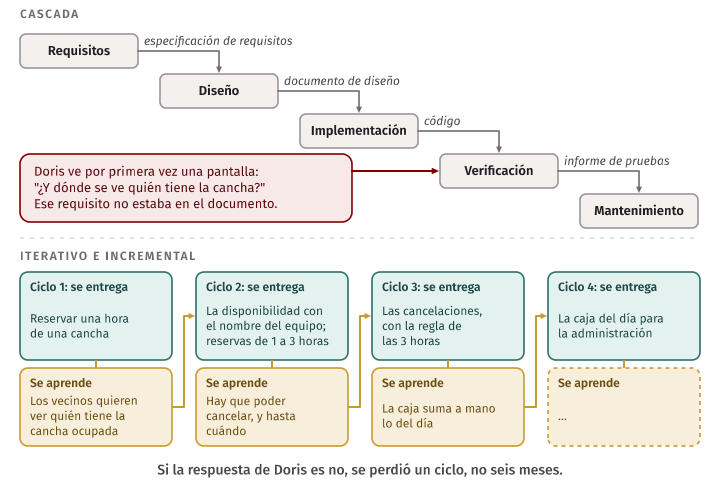
Idea clave. Iterativo quiere decir que se vuelve sobre lo hecho con lo aprendido; incremental, que se entrega por partes que funcionan. Juntos convierten cada entrega en retroalimentación del cliente. Lo que cuesta es un poco de trabajo repetido (rehacer, ajustar); lo que se gana es no descubrir todos los errores juntos al final.
Lo que no es iterativo
Dividir la cascada en meses no la vuelve iterativa. Si el primer mes es “requisitos”, el segundo “diseño” y el tercero “la base de datos”, el cliente igual no ve nada que pueda usar hasta el final. Un ciclo incremental termina con algo que una persona real puede probar, aunque sea pequeño: reservar una hora de fulbito sin precios ni cancelaciones ya es algo que Doris puede usar y criticar.
El Manifiesto Ágil
Cuatro valores
En febrero de 2001, diecisiete personas que trabajaban con métodos “livianos” (Extreme Programming, Scrum y otros) se reunieron en Utah y escribieron una declaración de una página: el Manifiesto por el Desarrollo Ágil de Software. En su traducción oficial al español dice:
Estamos descubriendo formas mejores de desarrollar software tanto por nuestra propia experiencia como ayudando a terceros. A través de este trabajo hemos aprendido a valorar:
- Individuos e interacciones sobre procesos y herramientas
- Software funcionando sobre documentación extensiva
- Colaboración con el cliente sobre negociación contractual
- Respuesta ante el cambio sobre seguir un plan
Esto es, aunque valoramos los elementos de la derecha, valoramos más los de la izquierda.
La última frase es la que más se olvida. El manifiesto no dice que los procesos, la documentación, los contratos o los planes no sirvan. Dice que, cuando hay que elegir, se prefiere lo de la izquierda. Kallpa tiene un README con todas las reglas del negocio y una tabla de códigos de error: eso es documentación, y es útil. Lo que el manifiesto cuestiona es el documento de cuarenta páginas que se escribe en lugar de mostrarle al cliente algo que funciona.
Doce principios
El manifiesto viene con doce principios. Varios vuelven a aparecer en este curso; estos son algunos, en la traducción oficial:
- “Nuestra mayor prioridad es satisfacer al cliente mediante la entrega temprana y continua de software con valor.”
- “Aceptamos que los requisitos cambien, incluso en etapas tardías del desarrollo.”
- “Entregamos software funcional frecuentemente, entre dos semanas y dos meses, con preferencia al periodo de tiempo más corto posible.”
- “El software funcionando es la medida principal de progreso.”
- “Los procesos Ágiles promueven el desarrollo sostenible. […] debemos ser capaces de mantener un ritmo constante de forma indefinida.”
- “La atención continua a la excelencia técnica y al buen diseño mejora la Agilidad.”
- “La simplicidad, o el arte de maximizar la cantidad de trabajo no realizado, es esencial.”
- “A intervalos regulares el equipo reflexiona sobre cómo ser más efectivo para a continuación ajustar y perfeccionar su comportamiento en consecuencia.”
El principio de que “el software funcionando es la medida principal de progreso” es el que vamos a usar esta semana para juzgar la velocity: un ítem a medio hacer no es progreso, por mucho trabajo que tenga encima. El penúltimo conecta con la semana 1: menos código que resuelve lo mismo es mejor.
Error común. Entender “ágil” como “sin plan, sin documentación y sin disciplina”. El manifiesto pide responder al cambio, no improvisar, y uno de sus principios pide “atención continua a la excelencia técnica”. Un equipo que no escribe pruebas ni documenta su API porque “somos ágiles” está usando la palabra como excusa. Y al revés: el manifiesto no es un método. No dice cuánto dura un ciclo ni quién ordena el trabajo. Eso lo definen métodos concretos como Scrum.
Scrum según la Scrum Guide 2020
Scrum es uno de los métodos ágiles más usados, y también uno de los que más se comentan sin haberlos leído. Su definición oficial es la Scrum Guide, escrita por Ken Schwaber y Jeff Sutherland, que presentaron Scrum por primera vez en la conferencia OOPSLA de 1995. La versión vigente es la de noviembre de 2020: menos de 13 páginas, gratuitas y en varios idiomas. Lo que sigue es lo que dice esa guía. Cuando algo que se suele asociar con Scrum no está en ella, lo vamos a decir.
La teoría: empirismo
La guía funda Scrum en el empirismo, la idea de que el conocimiento viene de la experiencia y de decidir con lo que se observa, y en el lean thinking, que busca reducir el desperdicio y concentrarse en lo esencial. El empirismo se apoya en tres pilares, que la guía explica en cadena:
- Transparencia. El trabajo y su estado tienen que estar a la vista de quien lo hace y de quien lo recibe. Sin transparencia, inspeccionar engaña.
- Inspección. Los artefactos y el avance hacia los objetivos se revisan con frecuencia, para detectar a tiempo lo que se desvía.
- Adaptación. Si algo se desvía, se ajusta cuanto antes. La guía es explícita: inspeccionar sin adaptar “se considera inútil”.
Scrum es iterativo e incremental en el sentido de la sección anterior: el trabajo avanza en ciclos de duración fija, los sprints, y cada uno produce al menos un incremento que se puede usar.
El Scrum Team y sus tres responsabilidades
El Scrum Team es un equipo pequeño, “típicamente de 10 personas o menos”, sin subequipos ni jerarquías. Es multifuncional (entre todos tienen las habilidades para producir valor en cada sprint) y autogestionado (decide internamente quién hace qué, cuándo y cómo). La guía de 2020 define tres responsabilidades (accountabilities), no “roles”:
- El product owner es responsable de maximizar el valor del producto. Lo hace manejando el product backlog: define y comunica el product goal, crea y explica los ítems del backlog, los ordena y se asegura de que el backlog sea transparente y se entienda. Es una persona, no un comité: puede representar a muchos interesados, y quien quiera cambiar el backlog tiene que convencerlo.
- El Scrum master es responsable de que Scrum se use como lo define la guía y de la efectividad del equipo: enseña la teoría y la práctica, ayuda a quitar impedimentos, cuida que los eventos ocurran y respeten su tiempo. No es el jefe del equipo ni quien asigna tareas.
- Los developers son las personas que se comprometen a crear, en cada sprint, cualquier parte de un incremento que se pueda usar. Son responsables de crear el plan del sprint, de cuidar la calidad cumpliendo la Definition of Done, de adaptar el plan cada día hacia el sprint goal y de exigirse unos a otros como profesionales. “Developer” no quiere decir solo “programador”: incluye a quien diseña, prueba o escribe la documentación.
La palabra “responsabilidades” es un cambio de 2020. Las versiones anteriores hablaban de un “equipo de desarrollo” dentro del equipo Scrum, y según la página de cambios de la guía eso producía un “nosotros y ellos” entre el product owner y el resto. Desde 2020 hay un solo equipo con un solo objetivo, el product goal.
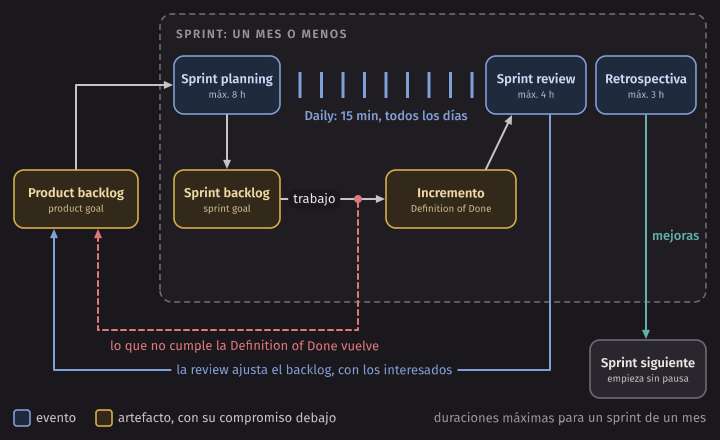
Los cinco eventos
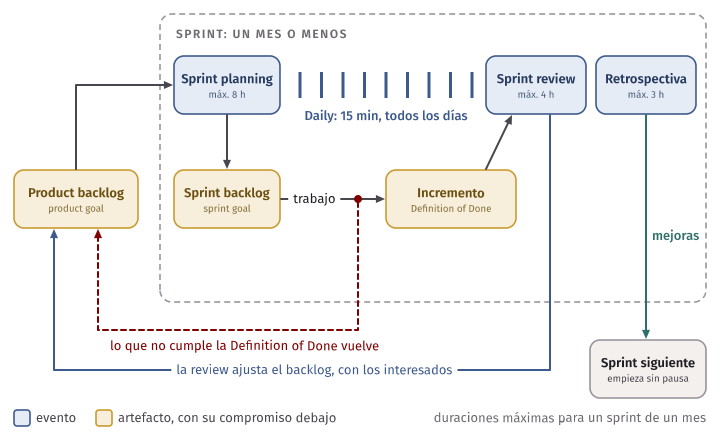
El sprint es un evento de duración fija, un mes o menos, que contiene a los otros cuatro. Un sprint empieza apenas termina el anterior. Durante el sprint no se hacen cambios que pongan en riesgo el sprint goal, la calidad no baja, el backlog se refina cuando hace falta y el alcance se puede aclarar y renegociar con el product owner. Solo el product owner puede cancelar un sprint, y solo si su sprint goal quedó obsoleto.
| Evento | Para qué | Duración máxima (sprint de un mes) |
|---|---|---|
| Sprint planning | Decidir por qué vale la pena el sprint (sprint goal), qué se va a hacer y cómo | 8 horas |
| Daily | Inspeccionar el avance hacia el sprint goal y ajustar el plan del día | 15 minutos, todos los días |
| Sprint review | Mostrar el resultado a los interesados y decidir con ellos qué sigue | 4 horas |
| Retrospectiva | Ver cómo fue el sprint y decidir cambios para mejorar la calidad y la efectividad | 3 horas |
Para sprints más cortos, la guía dice que la planning, la review y la retrospectiva “suelen” ser más cortas, sin fijar una proporción. La daily dura 15 minutos siempre.
Tres detalles de la guía que se suelen olvidar:
- La daily es de los developers. Ellos eligen su formato, siempre que se concentre en el avance hacia el sprint goal y termine con un plan para el día siguiente. Las tres preguntas (“¿qué hice ayer?, ¿qué haré hoy?, ¿qué me lo impide?”) eran parte de la guía antes; la versión de 2020 las quitó.
- La sprint review no es una presentación. La guía la describe como una sesión de trabajo en la que el equipo y los interesados revisan lo logrado y lo que cambió en su entorno, y ajustan el backlog.
- La retrospectiva termina con cambios. El equipo identifica las mejoras más útiles; las más importantes se atienden cuanto antes, incluso agregándolas al sprint backlog del sprint siguiente.
Los tres artefactos y sus compromisos
Un artefacto representa trabajo o valor. Scrum tiene tres, y desde 2020 cada uno tiene un compromiso (commitment): el objetivo o el criterio contra el que se mide su avance.
| Artefacto | Qué es | Compromiso |
|---|---|---|
| Product backlog | La lista ordenada y emergente de lo que hace falta para mejorar el producto; la única fuente de trabajo del equipo | Product goal: el objetivo de largo plazo del equipo |
| Sprint backlog | El sprint goal (por qué), los ítems elegidos (qué) y el plan para entregarlos (cómo); es de los developers y cambia durante el sprint | Sprint goal: el único objetivo del sprint |
| Incremento | Un paso concreto hacia el product goal, que se suma a los anteriores, está verificado y se puede usar | Definition of Done |
Algunas precisiones de la guía:
- El product backlog es emergente: crece y cambia con lo que se aprende. Refinarlo es dividir y precisar sus ítems (descripción, orden, tamaño), una actividad continua. Quienes van a hacer el trabajo, los developers, son los responsables de estimar el tamaño; el product owner puede ayudarlos a entender los trade-offs.
- El sprint goal es un compromiso de los developers, pero deja flexibilidad sobre el trabajo exacto. Si el trabajo resulta distinto de lo esperado, los developers negocian el alcance con el product owner sin tocar el objetivo. Por eso un buen sprint goal es una frase sobre un resultado (“que los vecinos puedan cancelar desde la página”), no una lista de tickets.
- El equipo debe cumplir un product goal (o abandonarlo) antes de pasar al siguiente.
La Definition of Done
La Definition of Done es la descripción formal del estado que tiene que tener el incremento para cumplir las medidas de calidad del producto. En el momento en que un ítem del backlog la cumple, nace un incremento. Si un ítem no la cumple al final del sprint, no se puede entregar ni mostrar en la sprint review: vuelve al product backlog para considerarlo más adelante. No existe “terminado al 90 %”.
Para un equipo que trabaja en Kallpa, una Definition of Done razonable sería:
make checkpasa: tipos, linter y todas las pruebas.- Hay pruebas para cada criterio de aceptación del ítem.
- El pull request tiene al menos una revisión aprobada de otra persona.
- Si cambió una regla del negocio o la API, el README está al día.
- Está en
main.
Si la organización tiene una Definition of Done como estándar, todos los equipos la usan como mínimo; si no, cada equipo escribe la suya. Lo importante es que esté escrita, que todos la conozcan y que se cumpla. Una Definition of Done que nadie revisa es decorativa.
Idea clave. Scrum, según su guía de 2020, es un equipo con tres responsabilidades (product owner, Scrum master y developers), cinco eventos (el sprint, que contiene a la sprint planning, la daily, la sprint review y la retrospectiva) y tres artefactos con sus compromisos (product backlog y product goal, sprint backlog y sprint goal, incremento y Definition of Done). Todo está diseñado para inspeccionar y adaptar con frecuencia.
Lo que la Scrum Guide no dice
Busquen en la guía las palabras story points, velocity, user story, planning poker o Definition of Ready: no aparecen. Los burn-downs aparecen una vez, como una de varias prácticas para pronosticar el avance, con una advertencia: son útiles, pero “no reemplazan la importancia del empirismo”; en entornos complejos, lo que va a pasar no se sabe, y solo lo que ya pasó sirve para decidir hacia adelante.
Todo eso son prácticas complementarias que muchos equipos usan dentro de Scrum. Son útiles, y las vamos a estudiar en la Sesión B. Pero conviene saber de dónde viene cada cosa: si alguien dice “en Scrum los ítems se estiman en story points con la serie de Fibonacci”, está describiendo la costumbre de su equipo, no Scrum. La guía cierra con una frase que vale la pena recordar: Scrum es “inmutable”; se pueden usar solo partes, pero “el resultado no es Scrum”.
Error común. Hacer las reuniones de Scrum sin que nada cambie. Una daily que es un informe de cada persona al jefe, una sprint review que es una presentación con diapositivas sin interesados, una retrospectiva que termina sin ninguna acción concreta para el sprint siguiente: tienen todo el costo de Scrum (horas de reunión) y nada de su beneficio (inspeccionar y adaptar). Una retrospectiva útil termina con dos o tres acciones, cada una con responsable, y la siguiente retrospectiva empieza revisando si se hicieron.
En la industria. El nombre viene del rugby. Hirotaka Takeuchi e Ikujiro Nonaka lo usaron en 1986, en un artículo de Harvard Business Review sobre desarrollo de productos (The New New Product Development Game), para describir equipos que avanzan juntos “como un scrum” en lugar de pasarse el trabajo como en una carrera de postas. Schwaber y Sutherland tomaron la imagen para el método. Hoy es común que una organización diga que “hace Scrum” y tenga sprints y dailies, pero un product owner que es un comité o un sprint backlog que el jefe llena por el equipo. La Scrum Guide sirve justamente para eso: para comparar lo que se hace con lo que se dice que se hace.
Scrum en el proyecto del curso
El proyecto del curso usa una versión de Scrum. Después de los requisitos
(P1), cada equipo trabaja tres sprints de unas tres semanas: P2 cierra el
sprint 1 en la semana 8, P3 el sprint 2 en la semana 11 y P4 el sprint 3 en
la semana 14. Cada sprint termina con una demo al cliente, que hace las veces
de sprint review, y se documenta en docs/sprints/sprint-N.md con tres
secciones: la planificación (el objetivo del sprint en una frase, las
historias comprometidas, quién toma cada una y la capacidad estimada), la
revisión con el cliente y la retrospectiva con acciones concretas y
responsables. Su cliente real es el interesado principal, y conviene que
alguien del equipo asuma la responsabilidad del product owner: ordenar el
backlog con lo que el cliente dijo. El laboratorio de esta semana
ensaya todo eso sobre Kallpa.
Kanban
La guía y sus tres prácticas
Kanban viene del sistema de producción de Toyota, donde una tarjeta (kanban en japonés) autoriza a producir o reponer solo lo que se consumió más adelante en la línea: nada se produce sin esa señal. Las prácticas para trabajo de conocimiento, como el software, empezaron en un equipo de la empresa Corbis en 2006. La referencia actual es The Kanban Guide de Daniel Vacanti y John Coleman (versión de mayo de 2025), que define Kanban como una estrategia para optimizar el flujo de valor a través de un proceso, con tres prácticas:
- Definir y visualizar el flujo de trabajo. El equipo acuerda una Definition of Workflow que dice, como mínimo, qué es un ítem de trabajo, cuándo se considera empezado y cuándo terminado, por qué estados pasa, cómo se controla el trabajo en curso, qué políticas explícitas rigen el paso de un estado a otro, y una service level expectation (SLE): un pronóstico de cuánto debería tardar un ítem, con su probabilidad (por ejemplo, “el 85 % de los ítems se termina en 8 días o menos”). La visualización de todo eso es el tablero Kanban.
- Gestionar activamente los ítems. Controlar el trabajo en curso, cuidar que los ítems no envejezcan sin necesidad y desbloquear lo bloqueado.
- Mejorar el flujo. Revisar el sistema y cambiarlo cuando haga falta, sin esperar una reunión con fecha fija.
Kanban no tiene sprints, ni responsabilidades fijas, ni eventos obligatorios. Se puede aplicar sobre el proceso que el equipo ya tiene, incluido Scrum.
Limitar el trabajo en curso
El trabajo en curso (WIP, work in progress) son los ítems empezados y no terminados. La guía exige controlarlo explícitamente, y desde 2025 es deliberadamente flexible sobre cómo. La forma más común es un límite por columna en el tablero. Supongamos este tablero para el soporte de Kallpa:
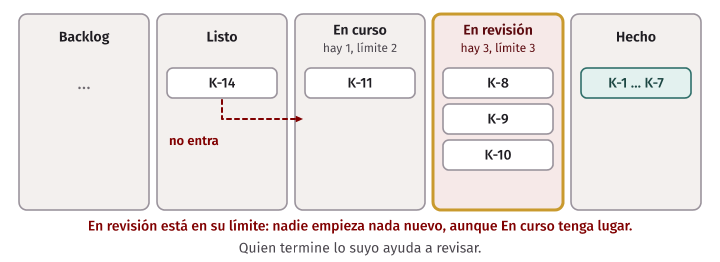
“En revisión” tiene un límite de 3 y ya hay 3 tarjetas. La regla dice que
nadie empieza nada nuevo: quien termine lo suyo ayuda a revisar. Así el
control de WIP crea un sistema pull: el trabajo nuevo entra cuando hay
una señal clara de capacidad, no cuando alguien lo empuja. La intuición es
que terminar vale más que empezar: tres pull requests esperando
revisión no le sirven a nadie, y uno revisado y en main sí.
En la industria. En GitHub Projects se le puede poner un límite a cada columna de una vista de tablero, pero la documentación aclara que el límite no impide agregar más tarjetas: solo muestra el conteo y lo resalta cuando se pasa. La herramienta comunica la regla; quien la hace cumplir es el equipo. Lo mismo pasa en casi todas las herramientas de seguimiento.
Las cuatro métricas de flujo
La Kanban Guide pide medir, como mínimo, cuatro métricas de flujo:
- WIP: el número de ítems empezados y no terminados.
- Throughput: el número de ítems terminados por unidad de tiempo. Se cuentan ítems, no puntos.
- Work item age: el tiempo transcurrido desde que empezó un ítem que todavía no termina.
- Cycle time: el tiempo transcurrido entre que un ítem empezó y terminó.
“Empezado” y “terminado” son los que definió el equipo en su Definition of
Workflow. En el ejemplo de abajo, un ítem empieza al pasar a En curso y
termina al llegar a Hecho, y contamos días completos: un ítem que empieza
y termina el mismo día tiene un cycle time de 1 día. Es una convención
común, y la que usa
flow.ts.
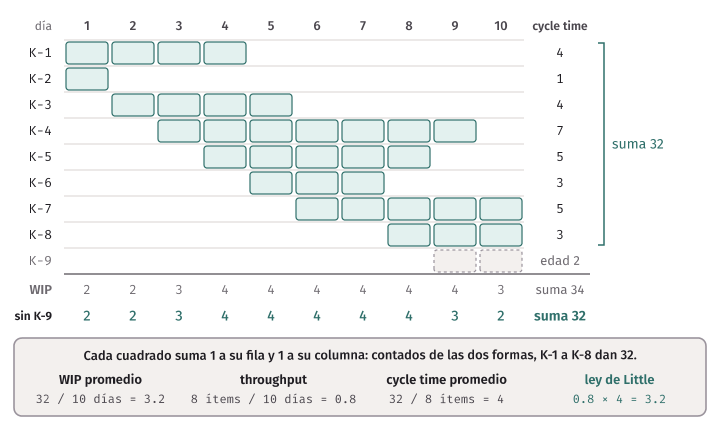
Este es el historial de diez días de un tablero de Kallpa
(examples.ts); cada # es un día en que
el ítem estuvo en curso:
$ node flow-demo.ts
Tablero de Kallpa, días 1 a 10
día  1  2  3  4  5  6  7  8  9 10
K-1   #  #  #  #  .  .  .  .  .  .   cycle time 4
K-2   #  .  .  .  .  .  .  .  .  .   cycle time 1
K-3   .  #  #  #  #  .  .  .  .  .   cycle time 4
K-4   .  .  #  #  #  #  #  #  #  .   cycle time 7
K-5   .  .  .  #  #  #  #  #  .  .   cycle time 5
K-6   .  .  .  .  #  #  #  .  .  .   cycle time 3
K-7   .  .  .  .  .  #  #  #  #  #   cycle time 5
K-8   .  .  .  .  .  .  .  #  #  #   cycle time 3
K-9   .  .  .  .  .  .  .  .  #  #   edad 2
WIP   2  2  3  4  4  4  4  4  4  3
Leámoslo por columnas y por filas. La fila de abajo es el WIP de cada día:
cuántos # hay en esa columna. Cada fila de arriba da el cycle time de un
ítem terminado (cuántos # tiene) o, para K-9, que sigue en curso el día 10,
su edad. Las métricas responden preguntas distintas: el WIP dice cuánto
tenemos abierto, el throughput cuánto terminamos, el cycle time cuánto tardó
lo que ya terminó y la edad cuánto lleva lo que todavía no termina. La edad
es la única que avisa antes de que algo tarde demasiado: si la SLE del
equipo es “el 85 % en 6 días o menos”, un ítem con edad 5 merece atención
hoy, no cuando ya terminó con cycle time 9.
La ley de Little
Las tres primeras métricas están relacionadas. Para un sistema estable, la ley de Little (John Little, 1961, de la teoría de colas) dice que, en promedio:
WIP promedio = throughput promedio × cycle time promedioo, despejando, cycle time = WIP / throughput. La ley no está en la Kanban Guide, que solo dice que Kanban se apoya en la teoría de colas, pero es la razón por la que limitar el WIP importa. Tiene condiciones: habla de promedios sobre un periodo, y supone que lo que entra al sistema termina saliendo, de modo que al final del periodo no queda trabajo abandonado ni acumulado de más. Con la ventana vacía al inicio y al final, la igualdad es exacta. En el tablero de ejemplo, los ítems K-1 a K-8 empiezan y terminan dentro de los diez días:
Solo los ítems terminados (K-1 a K-8):
  WIP promedio 3.20 | throughput 0.80 por día | cycle time promedio 4.00 días
  throughput × cycle time = 3.20
Con K-9, que sigue en curso:
  WIP promedio 3.40 | throughput 0.80 por día
Ocho ítems terminados en diez días dan un throughput de 0.8 por día; sus cycle times suman 32 días, un promedio de 4; y 0.8 × 4 = 3.2, el WIP promedio de esos ocho. No es casualidad: cada día que un ítem pasa en curso suma 1 al WIP de ese día y 1 a su cycle time, así que la suma de los WIP diarios es igual a la suma de los cycle times. Si contamos también K-9, que sigue abierto, el WIP promedio sube a 3.4 sin que cambie el throughput: la igualdad ya no es exacta porque hay trabajo que entró y no salió. En un periodo largo con poco trabajo abierto en los bordes, la diferencia es pequeña.
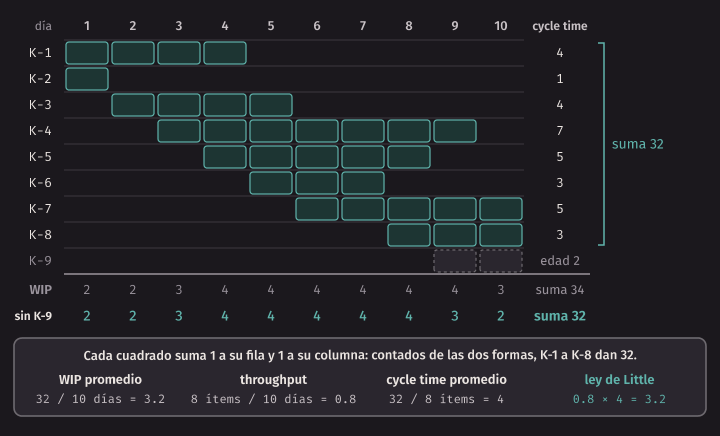
La consecuencia práctica es la que dice la guía de la semana: con el mismo
throughput, más WIP significa más cycle time. La simulación de
simulateBoard lo muestra con un equipo que termina siempre 2 ítems por día
y empieza ítems nuevos hasta llegar a su límite:
Simulación: el equipo termina 2 ítems por día; días 11 a 30
  límite  4: WIP promedio 4.00 | throughput 2.00 | cycle time promedio 2.00 días
  límite  6: WIP promedio 6.00 | throughput 2.00 | cycle time promedio 3.00 días
  límite 10: WIP promedio 10.00 | throughput 2.00 | cycle time promedio 5.00 días
El equipo no trabaja más rápido ni más lento en ninguno de los tres casos: termina 2 ítems por día. Lo único que cambia es cuánto tiene abierto. Con 10 ítems empezados, cada uno espera su turno más tiempo, y quien pidió algo lo recibe en 5 días en lugar de 2. La simulación supone, para aislar el efecto, que la capacidad no depende del WIP. En un equipo real, tener muchas cosas empezadas suele costar además cambios de contexto, así que el efecto no es menor.
Idea clave. Kanban optimiza el flujo: visualiza el trabajo, controla cuánto hay en curso y mide WIP, throughput, work item age y cycle time. Por la ley de Little, que vale para promedios de un sistema estable, si el throughput no cambia, bajar el WIP baja el cycle time: se termina antes lo que se empieza.
Error común. Confundir throughput con velocity. El throughput cuenta ítems terminados por unidad de tiempo, sin estimar nada; la velocity, que veremos en la Sesión B, suma puntos de los ítems terminados en un sprint. Son medidas distintas, de prácticas distintas. Y otro error: poner límites de WIP y no mirar la edad. Un tablero que respeta sus límites pero tiene un ítem detenido hace tres semanas en En revisión no está fluyendo.
¿Cuál elegir?
Pongamos los cuatro lado a lado:
| Cascada | Iterativo e incremental | Scrum | Kanban | |
|---|---|---|---|---|
| Supuesto sobre los requisitos | Se conocen y casi no cambian | Se descubren en el camino | Se descubren; el product owner los ordena | Llegan de forma continua |
| Cada cuánto se entrega | Al final | Al final de cada ciclo | Al menos un incremento por sprint (un mes o menos) | Cada vez que un ítem termina |
| Cómo se corrige el rumbo | Con un cambio formal de requisitos | Con lo aprendido en cada ciclo | Sprint review y retrospectiva, en cada sprint | Revisando el flujo, cuando haga falta |
| Qué se mide | Avance contra el plan | Lo entregado | El incremento contra la Definition of Done | WIP, throughput, edad y cycle time |
| Conviene cuando | Hay un estándar fijo y corregir tarde es aceptable | Casi siempre que hay un cliente que puede probar | Hay un cliente que revisa cada cierto tiempo y un objetivo por ciclo | El trabajo llega sin aviso y con prioridades que cambian |
Dos casos de Kallpa muestran la diferencia. El proyecto del curso tiene un cliente que se reúne con el equipo al final de cada sprint y un objetivo por sprint: Scrum encaja bien, y por eso lo usamos. El soporte de Kallpa en producción es otra cosa: un vecino reporta que la página no carga, la administración pide cambiar un mensaje, hay que actualizar una dependencia con una vulnerabilidad. Nada de eso puede esperar al sprint siguiente, y armar un sprint goal con eso es forzado. Un tablero Kanban con límites de WIP encaja mejor.
Muchos equipos mezclan: trabajan en sprints con un tablero de columnas y límites de WIP, o usan Kanban con una retrospectiva cada dos semanas. Eso está bien mientras sepan qué parte viene de dónde y por qué la usan. Lo que no funciona es copiar los rituales de un método sin entender qué problema resolvían.
Con IA. Una herramienta que escribe código rápido acorta la parte de escribirlo. No acorta entender qué construir, revisar lo escrito, probarlo ni desplegarlo, y con frecuencia ese trabajo crece: hay más código que leer, y la herramienta no sabe lo que el cliente quiso decir. Por eso un proceso con retroalimentación frecuente importa más, no menos: si el equipo produce más rápido algo que nadie validó, solo llega más rápido al error. Para Kanban, la consecuencia es concreta: si la columna que se llena es En revisión, el límite de WIP está ahí para recordarles que el cuello de botella ya no es escribir.
Estimar no es prometer
Estimación, compromiso y objetivo
La segunda mitad del capítulo trata de planificar: decidir cuánto trabajo cabe en un sprint y cuándo podría estar listo algo. Para eso hay que estimar, y la primera dificultad es de vocabulario. Steve McConnell, en Software Estimation: Demystifying the Black Art (2006), separa tres cosas que en una reunión se confunden todo el tiempo:
- Una estimación es lo que creemos que cuesta un trabajo, con su incertidumbre: “esto son unos 5 puntos”, “entre dos y tres sprints”. Es una predicción, y puede estar equivocada.
- Un compromiso es lo que el equipo acepta entregar: “para el viernes de la demo, los vecinos van a poder ver el precio antes de reservar”. Es una promesa, y se decide mirando la estimación y el riesgo que el equipo está dispuesto a correr.
- Un objetivo es lo que el negocio quisiera: “la junta quiere el campeonato funcionando para el 5 de enero”. Es un deseo, a veces con buenas razones detrás.
Las tres son legítimas. El problema empieza cuando se mezclan. Si Don Teodoro pregunta “¿cuánto se demoran?” y el equipo contesta “dos meses”, Don Teodoro escucha un compromiso; si la junta ya había anunciado el campeonato para enero, va a presionar para que la “estimación” baje a un mes. Pero una estimación no baja porque alguien la necesite más baja: lo que se puede negociar es el alcance (qué entra en la primera versión) o el riesgo (comprometerse a algo con menos margen). Cambiar el número sin cambiar el trabajo es fabricar una fecha imposible.
Las estimaciones tienen incertidumbre
Una estimación honesta dice cuánto sabemos. “Dos meses” esconde la incertidumbre; “entre seis y diez semanas, si las inscripciones se pagan en la caja y no por la página” la muestra, y además dice qué supuesto la mueve. La incertidumbre es mayor al principio, cuando el pedido es vago, y baja a medida que se conversa con el cliente y se construye. Por eso un plan se revisa: lo que se estimó en la semana 1 con lo que se sabía entonces no tiene por qué valer en la semana 6.
Error común. Convertir una estimación en una fecha sin decirlo. “El equipo estimó 21 puntos y hace 10 por sprint, así que termina en dos sprints” convierte un promedio en una promesa y borra la incertidumbre. Con los mismos datos, la frase honesta es “entre dos y tres sprints, si el equipo y el alcance no cambian”. Más abajo vamos a calcular ese rango.
Story points
Una medida relativa
Un story point es una unidad para estimar el tamaño de un ítem del backlog en relación con otros. Mike Cohn, en la lectura de Mountain Goat Software, lo define como una estimación del esfuerzo que lleva terminar el ítem, en la que entran tres cosas a la vez:
- La cantidad de trabajo. Una página con un campo y otra con cien campos iguales no son más complejas una que otra, pero la segunda da más trabajo.
- La complejidad. Cien campos que dependen unos de otros dan más trabajo que cien campos independientes.
- El riesgo y la incertidumbre. Si el cliente no tiene claro lo que quiere, o si hay que tocar código frágil sin pruebas, la estimación tiene que reflejarlo.
Y una cuarta condición, que Cohn subraya: la estimación incluye todo lo necesario hasta cumplir la Definition of Done, no solo escribir el código. Si la Definition of Done de Kallpa pide pruebas para cada criterio de aceptación y una revisión aprobada, escribir esas pruebas y atender esa revisión es parte del esfuerzo.
Lo que importa son los valores relativos. Tomemos dos issues de P0. Si el equipo acuerda que “filtrar las canchas por deporte” es un 2, entonces “cobrar los feriados como fin de semana” podría ser un 3: hay que conocer la lista de feriados, tocar el cálculo del precio y probar más casos, pero no es el doble de trabajo. Martin Fowler describe así el procedimiento: para estimar un ítem nuevo, se busca uno ya estimado que parezca del mismo tamaño y se le da el mismo número.
Por qué no horas
Si los puntos miden esfuerzo, y el esfuerzo al final es tiempo, ¿por qué no estimar directamente en horas? Por tres razones:
- Las horas dependen de quién. Lo que a una persona que conoce
pricing.tsle toma una hora, a alguien que llega nuevo le puede tomar cuatro. Discutir horas termina en discutir quién lo va a hacer. Decir “esto es el doble que aquello” es algo en lo que personas con experiencias distintas sí pueden ponerse de acuerdo. - Comparar es más fácil que medir en absoluto. Es difícil decir cuántas horas lleva un pedido nuevo; es más fácil decir si es más grande o más chico que otro que ya se hizo. Fowler cuenta que los equipos de Extreme Programming estimaban mal en horas-persona y les fue mejor comparando historias entre sí.
- La conversión a calendario se mide, no se adivina. Cuántos puntos termina el equipo por sprint (la velocity) se observa después de cada sprint, e incluye todo lo que las horas estimadas olvidan: reuniones, revisiones, interrupciones, el día en que nadie entendía un error.
Por eso un punto no equivale a ninguna cantidad fija de horas, y un equipo no debería tener una tabla de conversión.
Una escala con huecos
Los equipos estiman con pocas cartas, separadas cada vez más: este curso usa 1, 2, 3, 5, 8 y 13, y la carta ? para “no sé”. La baraja de planning poker que describe Mountain Goat Software es 0, 1, 2, 3, 5, 8, 13, 20, 40 y 100; Fowler menciona también 1, 2, 4, 8. Los huecos son a propósito: nadie puede distinguir un ítem de 6 puntos de uno de 7, y la escala no deja fingir esa precisión. Cuanto más grande el ítem, más incierto, y más grande el salto a la carta siguiente.
La carta más alta de la escala tiene un significado especial. En este curso, un ítem que sale 13 o ”?” es demasiado grande o demasiado incierto para un sprint, y se divide (o se pregunta más al cliente) antes de planificarlo. Fowler explica por qué conviene decirlo así en lugar de tratar el 13 como un número más: si la carta más alta quiere decir “13 o más”, usarla en un pronóstico es engañoso, porque cuando ese ítem se divide puede convertirse en cualquier cantidad.
Error común. Fijar una equivalencia (“1 punto = 1 día”) y estimar en días con otro nombre. Se pierde lo que tienen los puntos (la comparación entre ítems y la conversión medida por la velocity) y se conservan los problemas de las horas. Otro error: sumar story points de equipos distintos. Cada equipo tiene su propia escala: el 5 de un equipo no es el 5 de otro.
Planning poker
Cómo se juega
El planning poker es una técnica para estimar en grupo, que la lectura de Mountain Goat Software describe así:
- El product owner presenta un ítem del backlog.
- El equipo hace preguntas y aclara qué tiene que ser cierto para darlo por terminado.
- Cada persona elige una carta en secreto.
- Todos muestran su carta a la vez.
- Si las cartas están cerca, se anota la estimación y se pasa al siguiente. Si están lejos, quienes tienen la carta más alta y la más baja explican su razón, y se vuelve a votar.
Estiman las personas que van a hacer el trabajo: en Scrum, los developers. El product owner participa explicando y respondiendo, pero no estima por el equipo; si la estimación sale más alta de lo que esperaba, puede decidir que una parte del ítem no hace falta, o pedir que se divida.
En el laboratorio, la regla para decidir si las cartas están “lejos” es
concreta: a más de un salto de la escala. Un 3 y un 5 están a un salto,
y el equipo puede quedarse con la carta más votada. Un 3 y un 8 están a dos
saltos: hay que conversar. poker.ts escribe
esa regla como código, y sus pruebas la ejemplifican.
Por qué funciona
Elegir en secreto y mostrar a la vez evita el anclaje: si la primera persona en hablar dice “esto es un 3”, las demás tienden a acercarse a ese número aunque estuvieran pensando en un 8. También les da voz a quienes hablan menos: con las cartas sobre la mesa, la persona que estaba pensando en las pruebas de regresión o en una migración de la base de datos no necesita interrumpir a nadie para que su 8 se vea.
Lo que se gana es la conversación, no el número. Si salen un 2 y un 8,
casi siempre una persona sabe algo que la otra no: “hay que tocar la base de
datos”, “eso ya existe en calendar.ts”, “el cliente dijo que solo para
socios”. Por eso no se promedia: promediar 2 y 8 da 5, un número que
nadie votó y que esconde justo la diferencia que valía la pena entender.
Un ejemplo
El equipo estima una historia de un pedido nuevo de la administración, del que hablaremos más abajo: “V2 Inscribir a un niño en una clase de vóley”. Primera votación:
| Ana | Beto | Carla | Diego |
|---|---|---|---|
| 2 | 3 | 3 | 8 |
El 2 y el 8 están a tres saltos. Ana, que votó 2, explica: “Es un
formulario con el nombre del niño y el celular del apoderado; la clase ya
existe”. Diego, que votó 8: “Las inscripciones no existen en la base de
datos. Hay que agregar una tabla con una migración al final de
database.ts, una ruta nueva, sus errores en el README y las pruebas HTTP.
Y el cliente no dijo qué pasa si inscriben dos veces al mismo niño”. Ana no
había pensado en la base de datos; Diego no sabía que la validación del
celular ya estaba escrita para otro pedido. Segunda votación:
| Ana | Beto | Carla | Diego |
|---|---|---|---|
| 5 | 5 | 5 | 8 |
Ahora la carta más baja y la más alta están a un salto, y el equipo anota 5, la más votada. Además anota, en el issue, la pregunta para el cliente sobre las inscripciones repetidas: la conversación encontró un hueco en el requisito, que vale más que el número.
Idea clave. Un story point es una estimación relativa del esfuerzo hasta cumplir la Definition of Done: cantidad de trabajo, complejidad e incertidumbre juntas. No se convierte en horas. En el planning poker cada persona elige en secreto, todos muestran a la vez, y si las cartas difieren mucho explican primero la más alta y la más baja. No se promedia: lo valioso es lo que el equipo descubre al conversar.
Dividir un pedido grande
Doris trae un pedido de la junta: “En enero y febrero queremos hacer vacaciones útiles: clases de vóley y básquet para niños, con inscripción y mensualidad”. En la primera votación salen dos 13 y dos ”?”. No hay nada que discutir sobre el número: el ítem es demasiado grande para un sprint y tiene demasiadas preguntas abiertas. Hay que dividirlo.
Una buena división produce partes que se pueden entregar y probar por separado y que le sirven a alguien: no “la base de datos”, “la API” y “la página”, sino slices verticales que atraviesan todas las capas. Después de una conversación con Doris, el equipo arma estas siete historias y las estima con planning poker:
| Historia | Puntos | |
|---|---|---|
| V1 | Publicar los horarios y cupos de las clases | 2 |
| V2 | Inscribir a un niño en una clase | 5 |
| V3 | Cerrar la inscripción cuando se llena el cupo | 2 |
| V4 | Lista de inscritos para el profesor | 1 |
| V5 | Cobrar la mensualidad y verla en la caja del día | 5 |
| V6 | Descuento por hermanos | 3 |
| V7 | Avisar al apoderado si se suspende una clase | 3 |
Las partes suman 21 puntos. El pedido original había salido 13 o ”?”. ¿Por qué no coinciden? Porque dividir es una forma de conversar: al separar las partes aparecen trabajos que en el pedido entero no se veían (el descuento por hermanos, el aviso de suspensión), y cada parte se estima con su propio margen de incertidumbre. Es lo normal que las partes sumen más. A veces también suman menos, cuando al dividir el cliente decide que una parte no hacía falta. Lo que no conviene es usar el 13 original para planificar: como advierte Fowler, ese 13 quería decir “demasiado grande para estimar”, no “13”.
La división también abre la puerta a la priorización. Doris podría decidir que el descuento por hermanos (V6) y el aviso de suspensión (V7) esperan, y que la primera versión se cobra igual en la caja aunque no esté en el sistema. En la semana 3 verán técnicas para dividir historias de forma sistemática y para priorizar un backlog.
Velocity y planificación de un sprint
Qué es la velocity
La velocity es la suma de los puntos de los ítems terminados en un sprint, según la Definition of Done. El glosario de la Agile Alliance precisa cuatro consecuencias de esa definición:
- Es una medición hecha después, no una meta ni un presupuesto. “Fijar la velocity” no tiene sentido.
- Solo hay dos estados: 0 % o 100 %. Un ítem a medio hacer no suma nada, ni siquiera la mitad.
- Es del equipo. La “velocity individual” no significa nada.
- No se compara entre equipos, porque cada uno estima con su propia escala.
Este es el sprint 3 de un equipo, al cierre
(plan-demo.ts):
$ node plan-demo.ts
Sprint 3 al cierre:
  hecho     1  Mostrar el reglamento en la página
  hecho     3  Preguntas frecuentes en la página
  hecho     5  Calendario de la semana de una cancha
  no hecho  3  Avisar por WhatsApp si el complejo cierra un día
  velocity: 9 puntos
El equipo había planificado 12 puntos. El aviso por WhatsApp estaba casi listo, pero le faltaba la revisión del pull request: no cumple la Definition of Done, no suma, y vuelve al product backlog. La velocity del sprint es 9, no 10.5 ni 12. Es el principio del manifiesto escrito como regla de cálculo: lo que cuenta es el software que funciona.
Pronosticar con un rango
Con la velocity de varios sprints se puede pronosticar cuánto falta. Este equipo tuvo 8, 11 y 9 puntos en sus tres sprints. Si mañana le piden las vacaciones útiles completas (21 puntos), ¿cuántos sprints harían falta?
Velocity de los sprints cerrados: 8, 11, 9 (promedio 9.3)
Vacaciones útiles: 21 puntos -> entre 2 y 3 sprints
forecastSprints divide los puntos que faltan entre la mejor y la peor
velocity observadas y redondea hacia arriba: 21 / 11 da 1.9, o sea 2
sprints; 21 / 8 da 2.6, o sea 3. El resultado es un rango, y lo honesto
es comunicarlo así: “entre dos y tres sprints”. El promedio (9.3) da una
cifra única, 21 / 9.3 = 2.3, que parece más precisa y no lo es. El
pronóstico supone además que el futuro se parece al pasado: el mismo
equipo, la misma escala, la misma Definition of Done y un alcance que no
crece. Si cualquiera de esas cosas cambia, hay que volver a medir. La
Agile Alliance lo resume así: el pronóstico con velocity suele ser acertado,
pero rara vez preciso.
La sprint planning
Según la Scrum Guide, la sprint planning responde tres preguntas:
- ¿Por qué vale la pena este sprint? El product owner propone cómo podría aumentar el valor del producto, y todo el equipo acuerda un sprint goal, que tiene que quedar definido antes de terminar la reunión.
- ¿Qué se puede terminar? Los developers eligen ítems del backlog, conversando con el product owner. Cuanto más sepan de su desempeño pasado, su capacidad para este sprint y su Definition of Done, más confiable será su pronóstico.
- ¿Cómo se va a hacer? Los developers planifican el trabajo de cada ítem, a menudo descomponiéndolo en tareas de un día o menos. Cómo lo hacen lo deciden solo ellos.
Supongamos que el product owner ordenó las historias de las vacaciones
útiles así: V1, V2, V3, V5, V4, V6, V7. Con una capacidad de 10 puntos (la
que fija el laboratorio, un poco por encima del promedio de 9.3; un equipo
prudente podría tomar menos), fillSprint recorre el backlog en ese orden y
toma lo que cabe:
Primera propuesta para un sprint de 10 puntos:
  entra    2  V1 Publicar horarios y cupos de las clases
  entra    5  V2 Inscribir a un niño en una clase
  entra    2  V3 Cerrar la inscripción al llenarse el cupo
  queda    5  V5 Cobrar la mensualidad y verla en la caja
  entra    1  V4 Lista de inscritos para el profesor
  queda    3  V6 Descuento por hermanos
  queda    3  V7 Avisar al apoderado si se suspende una clase
  total: 10 puntos
V5 no cabe (serían 14 puntos), así que queda, y V4 (1 punto) sí entra. Esa es solo una primera propuesta, hecha por un algoritmo que solo mira números. La planning de verdad empieza con el sprint goal. Para esta selección podría ser: “Que los apoderados puedan ver las clases e inscribir a sus hijos hasta llenar el cupo”. Con ese objetivo, las cuatro historias elegidas tienen sentido juntas, y la lista de inscritos para el profesor (V4) completa el ciclo: alguien inscribe, el cupo se cierra, el profesor ve la lista. Si el algoritmo hubiera propuesto historias sin relación entre sí, el equipo tendría que cambiar la selección para que el objetivo fuera coherente, aunque sobrara un punto. Lo que se deja afuera también se justifica: V5, V6 y V7 esperan porque el cobro sigue siendo en la caja, como hoy.
El burndown chart
Un burndown chart muestra, día a día, los puntos que faltan para terminar el sprint. Se compara con una línea ideal que baja lo mismo cada día. Para un sprint de 10 puntos y cinco días de trabajo:
Burndown (puntos que faltan al final de cada día):
  día                0  1  2  3  4  5
  ideal             10  8  6  4  2  0
  todo terminado    10 10  8  8  7  0
  V2 sin terminar   10 10  8  8  7  5
La curva real no se parece a la ideal, y eso es normal: un ítem baja la curva solo el día en que cumple la Definition of Done, no un poco cada día. En la fila “todo terminado”, V1 termina el día 2, V4 el día 4 y V2 y V3 el día 5. Las mesetas (días en que la curva no baja) no son una mala noticia en sí; sí lo es una curva plana hasta el último día, porque dice que todo se terminó (o no) a la vez, sin tiempo para reaccionar. La última fila muestra el mismo sprint si V2 no llega a cumplir la Definition of Done: el sprint termina con 5 puntos sin hacer, la velocity es 5, y V2 vuelve al backlog.
El burndown sirve para que el equipo vea a mitad del sprint si va a llegar y converse con el product owner a tiempo, por ejemplo para negociar el alcance sin tocar el sprint goal. Como dice la Scrum Guide de todas las prácticas de pronóstico, no reemplaza el empirismo: lo que decide es lo que el equipo observa y conversa.
La velocity no es una meta
Error común. Usar la velocity como meta de desempeño: premiar al equipo que más puntos hace, o exigir que la velocity suba cada sprint. Lo que pasa es predecible. Los puntos son una estimación del propio equipo, así que la forma más fácil de “subir la velocity” es estimar más alto: lo que antes era un 3 pasa a ser un 5, y la velocity sube sin que se entregue nada más. Peor aún: se pierde la medida que servía para planificar. Este fenómeno se conoce como ley de Goodhart. El economista Charles Goodhart lo observó en 1975 sobre indicadores de política monetaria, y la antropóloga Marilyn Strathern le dio en 1997 la forma con que se suele citar: “cuando una medida se convierte en meta, deja de ser una buena medida”.
¿Qué medir entonces? El capítulo 7 de SWEG propone empezar por la pregunta, no por la métrica, con el marco Goals/Signals/Metrics (GSM):
- Un goal (objetivo) es el resultado que se quiere, dicho sin mencionar cómo se mide.
- Una signal (señal) es cómo sabríamos que lo logramos. Puede que no se pueda medir directamente.
- Una metric (métrica) es lo que sí se puede medir, como aproximación de la señal. Nunca es la señal misma.
Lo importante, dice el capítulo, es la trazabilidad: cada métrica tiene que poder rastrearse hasta la señal y el objetivo que representa. Para no mejorar una cosa a costa de otra, Google divide la productividad en cinco componentes que se equilibran entre sí, con la sigla QUANTS: calidad del código, atención de los ingenieros, complejidad intelectual, tempo y velocidad, y satisfacción. (El “tempo and velocity” de QUANTS es la rapidez con que se completan tareas y salen las versiones, no la velocity de story points.) Un ejemplo para el equipo de Kallpa:
| Goal | Signal | Metric |
|---|---|---|
| Lo que pide la administración llega rápido a producción | Los pedidos se terminan poco después de empezarse | Cycle time de los issues, de En curso a Hecho |
| Lo que se entrega funciona | Pocos errores llegan a los vecinos | Issues bug abiertos por semana; pruebas que fallan en main |
| El equipo trabaja a un ritmo sostenible | Nadie trabaja de madrugada para cerrar el sprint | Encuesta breve en cada retrospectiva |
Ninguna de esas métricas es la velocity, y ninguna sirve para comparar personas. El mismo capítulo advierte contra las métricas que se usan solo porque están disponibles, como las líneas de código: si el dato no mide la señal, cualquier conclusión que se saque de él es ininterpretable.
En la industria. El capítulo 7 de SWEG cuenta cómo Google decidió si valía la pena el readability, un proceso caro en el que ingenieros experimentados certifican que otros escriben bien un lenguaje. Antes de medir, el equipo responsable se comprometió a una decisión: si los costos superaban los beneficios, eliminarían el proceso. Midieron con tres fuentes (una encuesta al terminar el proceso, una encuesta trimestral y los logs de las herramientas) y encontraron que valía la pena: quienes tenían readability veían sus cambios revisados y aceptados más rápido, y decían haber aprendido. Además salieron mejoras al proceso. La lección del capítulo es que solo vale la pena medir cuando una decisión concreta depende del resultado, y cuando quien decide confía en el tipo de dato que se le va a dar.
Con IA. Al estimar un ítem que piensan hacer con ayuda de una herramienta de IA, estimen el trabajo completo hasta la Definition of Done, no el tiempo de escribir el código. Si la herramienta escribe la función en un minuto pero ustedes tardan una hora en entender qué hizo, escribir las pruebas de los criterios de aceptación y atender la revisión, el ítem cuesta esa hora. El reporte de DORA de 2025 sobre desarrollo asistido por IA describe el papel de la IA como el de un amplificador que magnifica las fortalezas y debilidades que la organización ya tiene. Es un estudio basado en encuestas a profesionales: describe asociaciones, no prueba que la IA cause cada efecto. Pero la conclusión práctica es consistente con la semana 1: un equipo sin pruebas ni revisión no se vuelve mejor porque escribe más código.
Caso: el Boeing 737 MAX
Qué pasó
El 29 de octubre de 2018, el vuelo 610 de Lion Air cayó al mar trece minutos después de despegar de Yakarta, Indonesia; murieron las 189 personas a bordo. El 10 de marzo de 2019, el vuelo 302 de Ethiopian Airlines cayó seis minutos después de despegar de Adís Abeba, Etiopía; murieron las 157 personas a bordo. Los dos aviones eran Boeing 737 MAX, un modelo nuevo certificado por la FAA, la autoridad aeronáutica de Estados Unidos, en marzo de 2017. En total, 346 muertos. Días después del segundo accidente, la FAA prohibió volar a los 737 MAX en Estados Unidos, como ya habían hecho otros países.
En los dos accidentes intervino el MCAS (Maneuvering Characteristics Augmentation System), un software diseñado para bajar automáticamente la nariz del avión en ciertas condiciones de vuelo. El MCAS decidía con la lectura de un solo sensor de ángulo de ataque, aunque el avión tiene dos. Cuando ese sensor dio un dato equivocado, el MCAS empujó la nariz hacia abajo una y otra vez, y los pilotos, que en su mayoría no sabían que el sistema existía, no lograron recuperar el control.
El informe del Congreso
Después del segundo accidente, el Comité de Transporte e Infraestructura de la Cámara de Representantes de Estados Unidos investigó durante 18 meses el diseño, el desarrollo y la certificación del 737 MAX. Su informe final, de septiembre de 2020, identifica cinco temas centrales:
- Presión de producción. Una enorme presión financiera para competir con el nuevo A320neo de Airbus, que llevó a recortar costos, mantener el calendario y no frenar la línea de producción.
- Supuestos de diseño y desempeño equivocados. Sobre todo en el MCAS: dejar que se activara con un solo sensor, suponer que los pilotos podrían manejar una falla de un sistema que no conocían, y no clasificarlo como un sistema crítico para la seguridad, lo que habría atraído más escrutinio de la FAA.
- Cultura de ocultamiento. Boeing ocultó información a la FAA, a sus clientes y a los pilotos: la existencia misma del MCAS, que la alerta AOA Disagree no funcionaba en la mayoría de los aviones, y datos de sus propias pruebas en simulador.
- Representación con conflicto de interés. Empleados de Boeing autorizados a actuar en nombre de la FAA para validar diseños no le transmitieron información importante.
- Influencia de Boeing sobre la supervisión de la FAA. Casos en que la gerencia de la FAA desautorizó a sus propios expertos técnicos a pedido de Boeing.
Conviene saber qué es esta fuente y qué no. Es el informe de una investigación legislativa, preparado por el personal de la mayoría del comité, basado en documentos internos de Boeing y de la FAA, entrevistas y audiencias públicas. No es la investigación técnica de los accidentes: esas las hicieron las autoridades de Indonesia y Etiopía, y hubo otras revisiones, como la del Joint Authorities Technical Review que cita el mismo informe. Lo que el informe documenta bien es cómo se tomaron las decisiones del programa, que es lo que nos interesa en un curso de ingeniería de software.
Cuatro decisiones que se reconocen en cualquier proyecto
Un objetivo de negocio convertido en requisito. En diciembre de 2011, Boeing firmó un contrato con Southwest Airlines, su cliente de lanzamiento en Estados Unidos, que la obligaba a descontar al menos un millón de dólares por cada avión entregado si la FAA exigía entrenamiento en simulador a los pilotos que pasaran del 737 anterior al MAX. Southwest tenía 200 pedidos firmes. Evitar el entrenamiento en simulador se volvió una directiva del programa, y el informe documenta cómo esa directiva influyó en decisiones técnicas, por ejemplo en cómo se describió el MCAS ante la FAA. Es la confusión entre objetivo y compromiso de la primera parte de esta sesión, con consecuencias mucho más graves que una fecha imposible.
Un cambio de alcance sin reevaluar el riesgo. En marzo de 2016, la dirección del programa aprobó un rediseño del MCAS para que actuara también a baja velocidad y con más autoridad sobre el estabilizador. Horas después, Boeing pidió y la FAA aprobó quitar las referencias al MCAS del manual de operación de los pilotos. Las personas de la FAA que aprobaron ese pedido no supieron del rediseño hasta después del accidente de Lion Air. El ingeniero jefe del programa, que aprobó el rediseño, declaró al comité que entonces no sabía que el MCAS funcionaba con un solo sensor, que podía activarse repetidamente, ni que había datos de una prueba en simulador como la que sigue.
Un supuesto sobre las personas. Las guías de la FAA suponen que un piloto reacciona en cuatro segundos ante una activación no ordenada del sistema. En noviembre de 2012, en un simulador de Boeing, un piloto de pruebas tardó más de diez segundos, y calificó la situación de “catastrófica”. Boeing no compartió ese dato con la FAA ni con sus clientes (el informe reconoce que no estaba obligada a hacerlo, y lo considera inexcusable de todas formas).
Una alerta que no funcionaba y no se informó. La alerta AOA Disagree avisa a la tripulación cuando los dos sensores de ángulo de ataque no coinciden. Tenía que ser estándar en todos los 737 MAX, pero el software que la mostraba quedó atado a un indicador opcional, y en más del 80 % de los aviones no funcionaba. Boeing probó ese software en julio de 2015 y no detectó el problema; lo supo en agosto de 2017 y siguió entregando aviones sin informar a la FAA ni a los pilotos hasta después del accidente de Lion Air.
Error común. Resumir el caso como “un bug de software”. El MCAS hizo lo que su diseño decía: actuar con la lectura de un sensor, y volver a actuar. El problema estaba en ese diseño, que además contradecía los propios requisitos internos de Boeing (que el sistema no tuviera “interacción objetable” con el pilotaje del avión y no interfiriera con la recuperación de una picada). Sí hubo un defecto de software en el caso, el de la alerta AOA Disagree, y se escapó de las pruebas. Pero la causa de los accidentes no fue un error de programación del MCAS: fallaron los requisitos, el análisis de riesgo, la revisión independiente y la honestidad sobre lo que se sabía. Corregir “el bug” no habría arreglado nada de eso.
Lo que el caso le dice a este curso
Casi todos los temas del semestre aparecen en el caso:
- Requisitos y especificaciones (semanas 3 y 4): un supuesto sobre los pilotos que nadie verificó con datos, y un requisito de alto nivel (“no interferir con el pilotaje”) que el diseño detallado contradecía sin que nadie lo notara.
- Revisión (semana 11): un rediseño importante que no pasó por quienes tenían que revisarlo, y revisores con conflicto de interés.
- Pruebas (semanas 9 y 10): un defecto que estaba en el software probado y se siguió entregando durante casi dos años.
- Ética (semana 15): saber algo grave y no decirlo.
- Planificación (esta semana): un objetivo comercial, evitar el entrenamiento en simulador, que se impuso sobre lo que los datos decían.
Kallpa no es un avión, y nadie se va a morir porque una reserva se cobre mal. Pero las decisiones del caso son reconocibles en un proyecto de software común: un cliente que exige una fecha y un equipo que deja de probar para cumplirla; un cambio “pequeño” que se aprueba sin mirar qué más toca; un supuesto sobre los usuarios (“van a leer el mensaje”) que nadie comprobó; un problema conocido que no se reporta porque reportarlo trae problemas.
Idea clave. En el 737 MAX, el software hizo lo que su diseño decía. Lo que falló fue todo lo de alrededor: la presión de calendario y costo convertida en requisito, un cambio de alcance sin reevaluar el riesgo, un supuesto sobre los pilotos contradicho por datos que se ocultaron, una revisión que no fue independiente. Son fallas de proceso y de ética, y por eso son temas de un curso de ingeniería de software.
En el laboratorio
El laboratorio ensaya todo lo anterior sobre Kallpa, en grupos de 4 o 5 (de
preferencia, el futuro equipo del proyecto) y en el repositorio de Kallpa de
una persona del grupo. La guía completa, con los ocho pasos, está en
weeks/week-02.md; aquí van los puntos donde se
aplica lo del capítulo.
El backlog de partida.
code/week-02/backlog.md tiene 15 pedidos de
la administración y de los vecinos, tal como llegaron: con quién lo pidió,
por dónde llegó y sus palabras. Hay pedidos claros y vagos, pequeños y
enormes, y al menos uno que parece un error del sistema sin serlo. Ninguno
repite un issue de P0.
Etiquetas e issues con gh. El contenedor no guarda credenciales, así
que primero gh auth login. Luego las etiquetas y los issues se crean desde
la terminal (o en la web):
gh label create precios --color FBCA04 --description "Tarifas y descuentos"
gh issue create --title "Ver el precio antes de reservar" \
  --body-file pedido.md --label funcionalidad --label precios
El título del issue puede usar las palabras del cliente; el cuerpo, en
pedido.md, copia el pedido y agrega el contexto. Si el pedido es vago, el
issue lo dice, y las preguntas para el cliente van como comentario. Para
agregar issues a un proyecto desde la terminal, gh necesita un permiso que
gh auth login no da por omisión; lo dice su ayuda:
$ gh issue create --help | head -4
Create an issue on GitHub.

Adding an issue to projects requires authorization with the `project` scope.
To authorize, run `gh auth refresh -s project`.
El tablero. Un proyecto de GitHub con vista de tablero, columnas Backlog, Listo, En curso, En revisión y Hecho, límites de 2 en En curso y de 3 en En revisión, y un campo numérico Puntos. Recuerden que GitHub muestra los límites pero no los hace cumplir: la regla es del grupo.
La Definition of Done. En un issue fijado. Usen la lista de la sección
sobre Scrum como punto de partida y ajústenla; lo importante es que cada
punto se pueda comprobar (“make check pasa”), no que suene bien (“código
de calidad”). La Agile Alliance tiene una buena explicación en su
glosario.
Planning poker. Cartas 1, 2, 3, 5, 8, 13 y ”?”. Si las cartas difieren en más de un salto, explican primero la más alta y la más baja, y se vuelve a votar. Anoten en el issue la razón que cambió la estimación: es más útil que el número. Lo que salga 13 o ”?” se divide en historias más pequeñas; comparen la suma de las partes con el original.
El sprint. Capacidad supuesta de 10 puntos, una semana. Primero el sprint goal en una frase; después los issues que lo cumplen, a Listo; y por escrito, qué quedó afuera y por qué.
El cierre. ¿Qué cambiaría si trabajaran con Kanban en lugar de sprints? Piensen en qué columnas y límites tendrían, qué medirían y qué pasaría con el sprint goal.
Con IA. Es tentador pedirle a una herramienta que convierta los 15 pedidos en issues bien redactados, con criterios de aceptación. Si lo hacen, revisen cada uno contra el pedido original: una herramienta tiende a completar los huecos con suposiciones razonables que el cliente nunca dijo (“el recordatorio se envía a las 10:00”, “la lista de espera tiene 5 lugares”), y las escribe con la misma seguridad que lo que sí dijo. Un issue que inventa requisitos es peor que uno vago, porque nadie va a preguntar lo que ya parece decidido. Lo vago se marca como pregunta para el cliente, no se rellena. Y anoten en su registro de uso de IA qué se pidió y qué se corrigió.
El código de la semana y make test
Esta semana el código no es una aplicación sino una forma de comprobar las
afirmaciones del capítulo. En code/week-02/:
flow.ts: WIP, throughput, work item age y cycle time a partir del historial de un tablero, ysimulateBoard, la simulación de un equipo con límite de WIP.velocity.ts: velocity, el pronóstico por rangos,fillSprint(la primera propuesta de sprint) y el burndown.poker.ts: las cartas del laboratorio y la regla de “más de un salto”.examples.ts: los datos de los ejemplos (el tablero de diez días, el sprint 3, las vacaciones útiles).flow-demo.tsyplan-demo.ts: imprimen las salidas que aparecen en el capítulo.backlog.md, el backlog del laboratorio, ybacklog.test.ts, que revisa que tenga exactamente 15 pedidos, numerados, con quién los pide, y que no repita los temas de los issues de P0.
Dentro del contenedor del curso:
$ cd code/week-02
$ make test
tsc -p .
eslint .
node --test "*.test.ts"
✔ hay exactamente 15 pedidos, numerados del 1 al 15 (0.7075ms)
✔ los títulos no se repiten (0.218625ms)
✔ cada pedido dice quién lo pide, cómo llegó y trae sus palabras (0.215916ms)
✔ ningún pedido repite un issue de P0 (0.356917ms)
✔ un ítem que empieza y termina el mismo día tiene cycle time 1 (0.555666ms)
...
✔ ley de Little: con la ventana vacía al inicio y al final, WIP = throughput × cycle time (0.189375ms)
✔ con un ítem todavía en curso al final, la igualdad ya no es exacta (0.095458ms)
✔ con el mismo throughput, más WIP significa más cycle time (2.188458ms)
...
✔ burndown: un ítem sin terminar no baja la curva (0.133958ms)
ℹ tests 26
ℹ suites 0
ℹ pass 26
ℹ fail 0
ℹ cancelled 0
ℹ skipped 0
ℹ todo 0
ℹ duration_ms 98.716625
node flow-demo.ts
Tablero de Kallpa, días 1 a 10
...
make revisa los tipos con tsc y el estilo con ESLint; make test hace
lo mismo, corre las pruebas con node --test y después los dos ejemplos
(make demo corre solo los ejemplos). No hay nada que generar, así que
make clean solo borra build/ si existe. Las pruebas son la versión
ejecutable de varias afirmaciones del capítulo: que la velocity no cuenta lo
que no cumple la Definition of Done, que la ley de Little es exacta cuando
la ventana empieza y termina vacía, que con el mismo throughput más WIP da
más cycle time, que con un 2 y un 8 no hay estimación todavía.
Resumen
- Un proceso de desarrollo es el acuerdo de un equipo sobre quién decide qué se construye, en qué orden, cada cuánto se entrega y cómo se corrige el rumbo. Cada proceso apuesta sobre qué tan estables son los requisitos y qué tan caro es cambiar.
- La cascada pasa por fases con documentos entre ellas. Sirve cuando los requisitos son fijos y corregir tarde es aceptable; su riesgo es que el cliente ve el producto al final. Royce (1970) la presentó como riesgosa y propuso cambios.
- Iterativo es volver sobre lo hecho con lo aprendido; incremental, entregar por partes que funcionan. Juntos convierten cada entrega en retroalimentación.
- El Manifiesto Ágil (2001) valora más individuos e interacciones, software funcionando, colaboración con el cliente y respuesta ante el cambio, sin descartar lo de la derecha. No es un método.
- Scrum (Scrum Guide 2020): empirismo con transparencia, inspección y adaptación; tres responsabilidades (product owner, Scrum master, developers); cinco eventos (sprint de un mes o menos, sprint planning, daily, sprint review, retrospectiva); tres artefactos con sus compromisos (product backlog y product goal, sprint backlog y sprint goal, incremento y Definition of Done). Un ítem que no cumple la Definition of Done vuelve al backlog. Story points, velocity y planning poker no son parte de la guía.
- Kanban optimiza el flujo: visualizar, controlar el WIP, mejorar. Sus métricas mínimas son WIP, throughput, work item age y cycle time. Por la ley de Little, en promedio y en un sistema estable, WIP = throughput × cycle time: con el mismo throughput, más WIP es más cycle time.
- Una estimación predice, un compromiso promete y un objetivo desea. Lo que se negocia es el alcance o el riesgo, no la estimación.
- Un story point es una estimación relativa del esfuerzo hasta la Definition of Done (trabajo, complejidad, incertidumbre). Escala con huecos; 13 o ”?” se divide; no se convierte en horas.
- En el planning poker se elige en secreto y se muestra a la vez; si las cartas difieren mucho, explican la más alta y la más baja. No se promedia.
- La velocity es una medición después del sprint, del equipo, solo con lo terminado; no se compara entre equipos. Se pronostica con rangos. Usarla como meta la arruina (ley de Goodhart); para medir, primero la pregunta (Goals/Signals/Metrics).
- 737 MAX: el MCAS hizo lo que su diseño decía con un dato equivocado de un solo sensor. El informe del Congreso identifica presión de producción, supuestos equivocados, ocultamiento, conflictos de interés e influencia sobre la FAA. No fue “un bug”: fallaron requisitos, análisis de riesgo, revisión y honestidad.
Ejercicios
- Para cada proyecto, digan si usarían cascada, Scrum o Kanban y por qué, en función de qué tan estables son los requisitos y qué tan caro es cambiar: (a) el software que calcula una planilla de sueldos según una ley que entra en vigencia en seis meses; (b) una app para que una bodega del barrio reciba pedidos por WhatsApp; (c) la atención de problemas que reportan los usuarios de Kallpa ya en producción.
- Un equipo divide su proyecto de seis meses en “mes 1: requisitos; mes 2: diseño; meses 3 a 5: programación; mes 6: pruebas”, y lo llama “iterativo porque tiene entregas mensuales”. ¿Es iterativo e incremental? ¿Qué tendría que cambiar para serlo?
- Elijan dos de los doce principios del Manifiesto Ágil y den, para cada uno, una práctica concreta de Kallpa o del laboratorio que lo cumpla y otra que lo contradiga.
- Un equipo dice que “hace Scrum”: tiene sprints de seis semanas, el gerente llena el sprint backlog y asigna las tareas, la daily dura 45 minutos y cada persona le informa al gerente lo que hizo, y el product owner es un comité de tres jefes. Señalen cada diferencia con la Scrum Guide 2020 y expliquen qué se pierde con cada una.
- Al final de un sprint, una historia de 5 puntos tiene el código escrito y las pruebas pasando, pero el pull request no tiene revisión aprobada, y la Definition of Done del equipo la exige. ¿Cuánto suma a la velocity? ¿Se muestra en la sprint review? ¿Qué pasa con ella? Citen la Scrum Guide.
- Agreguen a
BOARD_HISTORYenexamples.tsun ítemK-10que empieza el día 2 y termina el día 10. Antes de corrernode flow-demo.ts, calculen a mano el nuevo throughput, el cycle time promedio y el WIP promedio de los ítems terminados, y comprueben la ley de Little. Después corran el ejemplo ymake test: ¿qué pruebas fallan y por qué? (Devuelvan el archivo a como estaba.) - Un equipo de soporte tiene en promedio 12 issues abiertos y termina 3 por
día. ¿Cuál es su cycle time promedio, según la ley de Little? Si bajan el
límite de WIP a 6 y el throughput no cambia, ¿cuál sería? ¿Qué supuestos
hacen falta para que el cálculo valga? Comprueben su respuesta con
simulateBoarden una prueba nueva. - En un planning poker salen 2, 3, 3 y 13 para el pedido 2 del backlog (la lista de espera). Escriban dos razones plausibles que podría tener quien sacó el 13 y una que podría tener quien sacó el 2. ¿Por qué el equipo no anota 5? Escriban las preguntas que le harían a Kevin, el vecino que lo pidió.
- Dividan el pedido 4 del backlog (el campeonato de verano) en al menos cinco historias que se puedan entregar y probar por separado, cada una con valor para alguien. Para cada historia, digan quién la usaría. ¿Cuáles dejarían para después si el campeonato empieza en tres semanas?
- Un equipo tuvo velocities de 6, 13 y 8 en sus tres sprints, y le quedan
40 puntos en el backlog. Calculen el rango de sprints con
forecastSprints. ¿Qué le dirían al cliente? ¿Qué dice la diferencia entre 6 y 13 sobre la forma en que este equipo estima o trabaja? - La gerencia de una empresa decide premiar cada mes al equipo con la mayor velocity. Expliquen qué va a pasar usando la ley de Goodhart, y propongan, con el marco Goals/Signals/Metrics, un objetivo, una señal y una métrica para lo que la gerencia de verdad quiere saber.
- Lean el resumen ejecutivo del informe sobre el 737 MAX y elijan dos decisiones del caso distintas de las de este capítulo. Para cada una, describan una decisión análoga que podría tomarse en un proyecto como Kallpa o el de su cliente, y qué práctica del curso la habría hecho visible a tiempo.